Mistral pubblica i pesi di «Le Chonk»: contesto da 1 milione di token, licenza MIT modificata, 0,70 $ in entrata via API. Benchmark, limiti, hardware e cosa cambia per le aziende.
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
di Andrea Pirazzini

Fonte primaria
Mistral AI, Mistral Large 4
mistral.ai
Vittorio e Matteo
Il Narratore a due voci · 2 min 49 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Mistral AI, Mistral Large 4.
Il 29 ottobre 2026, poco dopo le 15 ora italiana, Mistral AI ha pubblicato i pesi di Mistral Large 4, soprannominato «Le Chonk»: il suo modello più grande, con circa 1.000 miliardi di parametri e 52 miliardi attivi. A inizio mese era uscita una versione preview usabile solo via API; ora il modello si può scaricare da Hugging Face, modificare e usare anche a fini commerciali. Secondo i test pubblicati da Mistral è il primo tra i modelli aperti nel codice, con un margine minimo.
Parametri totali circa, di cui 52 miliardi attivi
Token di contesto, il testo che tiene a mente in una volta
Su Terminal-Bench 4.0, contro il 28% della preview
Prezzo API per milione di token in entrata, 2,10 $ in uscita
Perché se ne parla#
Mistral AI è l'azienda francese dei modelli Mistral, e Large 4 è il suo modello di punta. La preview era stata annunciata all'inizio di ottobre; secondo il blog ufficiale, la versione con i pesi aperti arriva dopo tre settimane di addestramento aggiuntivo con rinforzo, e i risultati sono saliti in quasi tutti i test.
Il punto, per un'azienda, è il formato. Un modello a pesi aperti si può far girare sui propri server, senza mandare i dati a un fornitore esterno, e si può adattare ai propri casi. Nei confronti pubblicati da Mistral, i rivali aperti sono soprattutto cinesi: GLM, DeepSeek e Kimi. Large 4 è stato addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei datacenter di Mistral in Europa.
In parole semplici: com'è fatto#
Large 4 è un modello Mixture of Experts: dentro ha 128 «esperti» specializzati più uno condiviso, e per ogni parola ne usa solo quattro. Per questo, pur avendo circa mille miliardi di parametri, ne attiva una piccola parte a ogni passaggio, e costa meno farlo girare di quanto la taglia faccia pensare.
Legge testo e immagini, risponde con testo.
Contesto da 1 milione di token: può lavorare su documenti, contratti o codebase molto lunghi in una sola richiesta.
Oltre 160 lingue, comprese tutte le lingue ufficiali dell'Unione europea, quindi anche l'italiano.
Tre livelli di ragionamento: low, medium e high (quello predefinito). Più ragionamento significa risposte migliori ma più token, quindi più costo e più attesa.
Strumenti e dati strutturati: chiamata di funzioni, risposte in JSON e rispetto rigoroso di uno schema JSON, utili per collegarlo a gestionali e automazioni.
I pesi sono pubblicati in FP8 e in NVFP4, un formato compresso pensato per le GPU NVIDIA Blackwell. La community ha già preparato versioni ancora più compresse per llama.cpp.
Il codice: primo tra i modelli aperti, di poco#
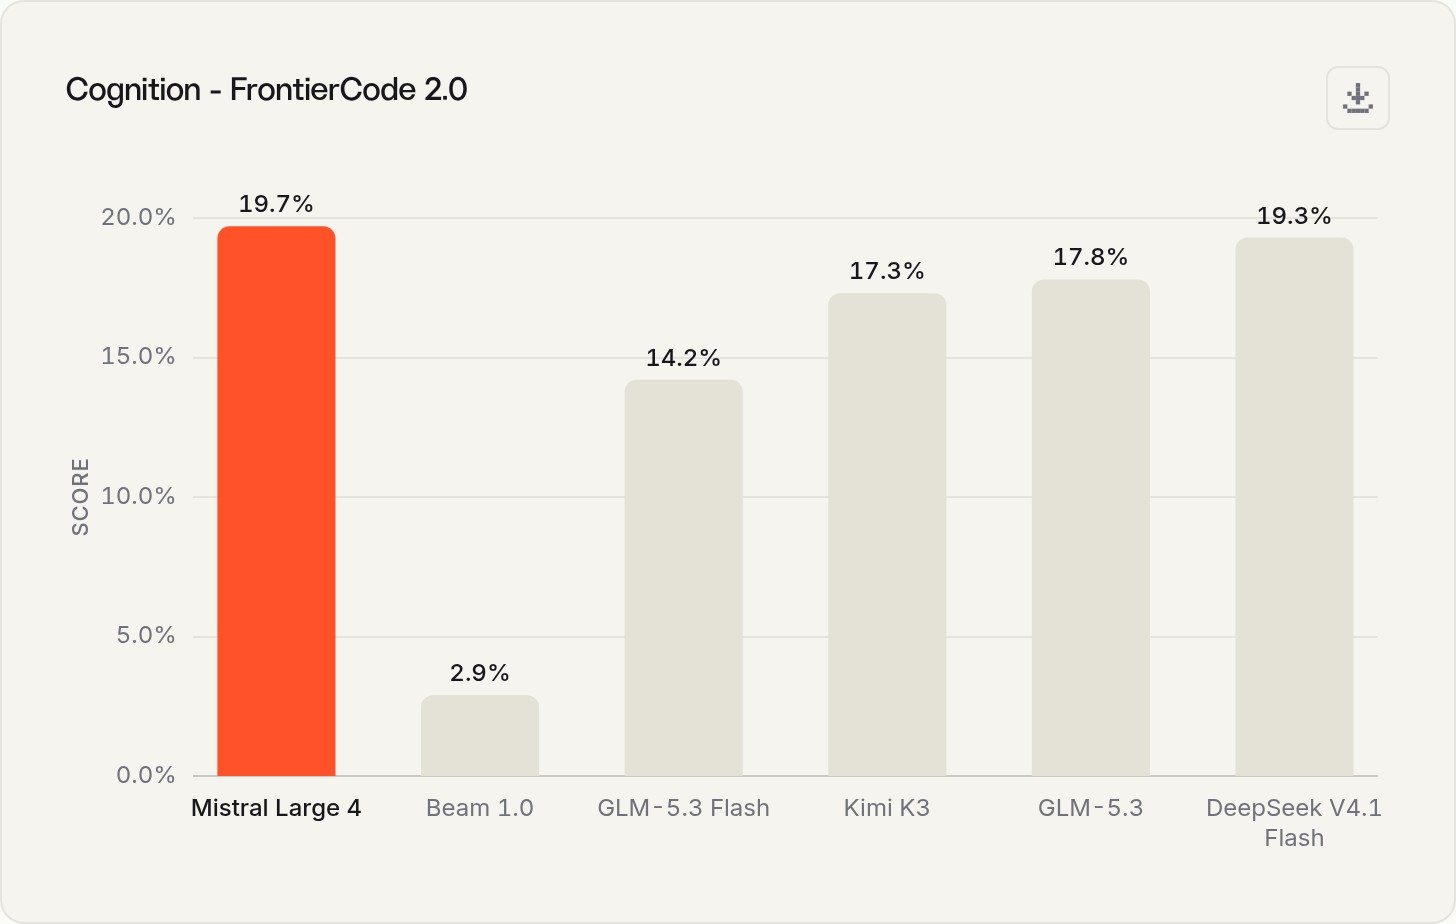
Mistral presenta il codice come il punto più forte. Su FrontierCode 2.0, il test di Cognition sulla programmazione avanzata, Large 4 segna 19,7%: il valore più alto tra i modelli aperti del grafico, ma con soli 0,4 punti su DeepSeek V4.1 Flash.
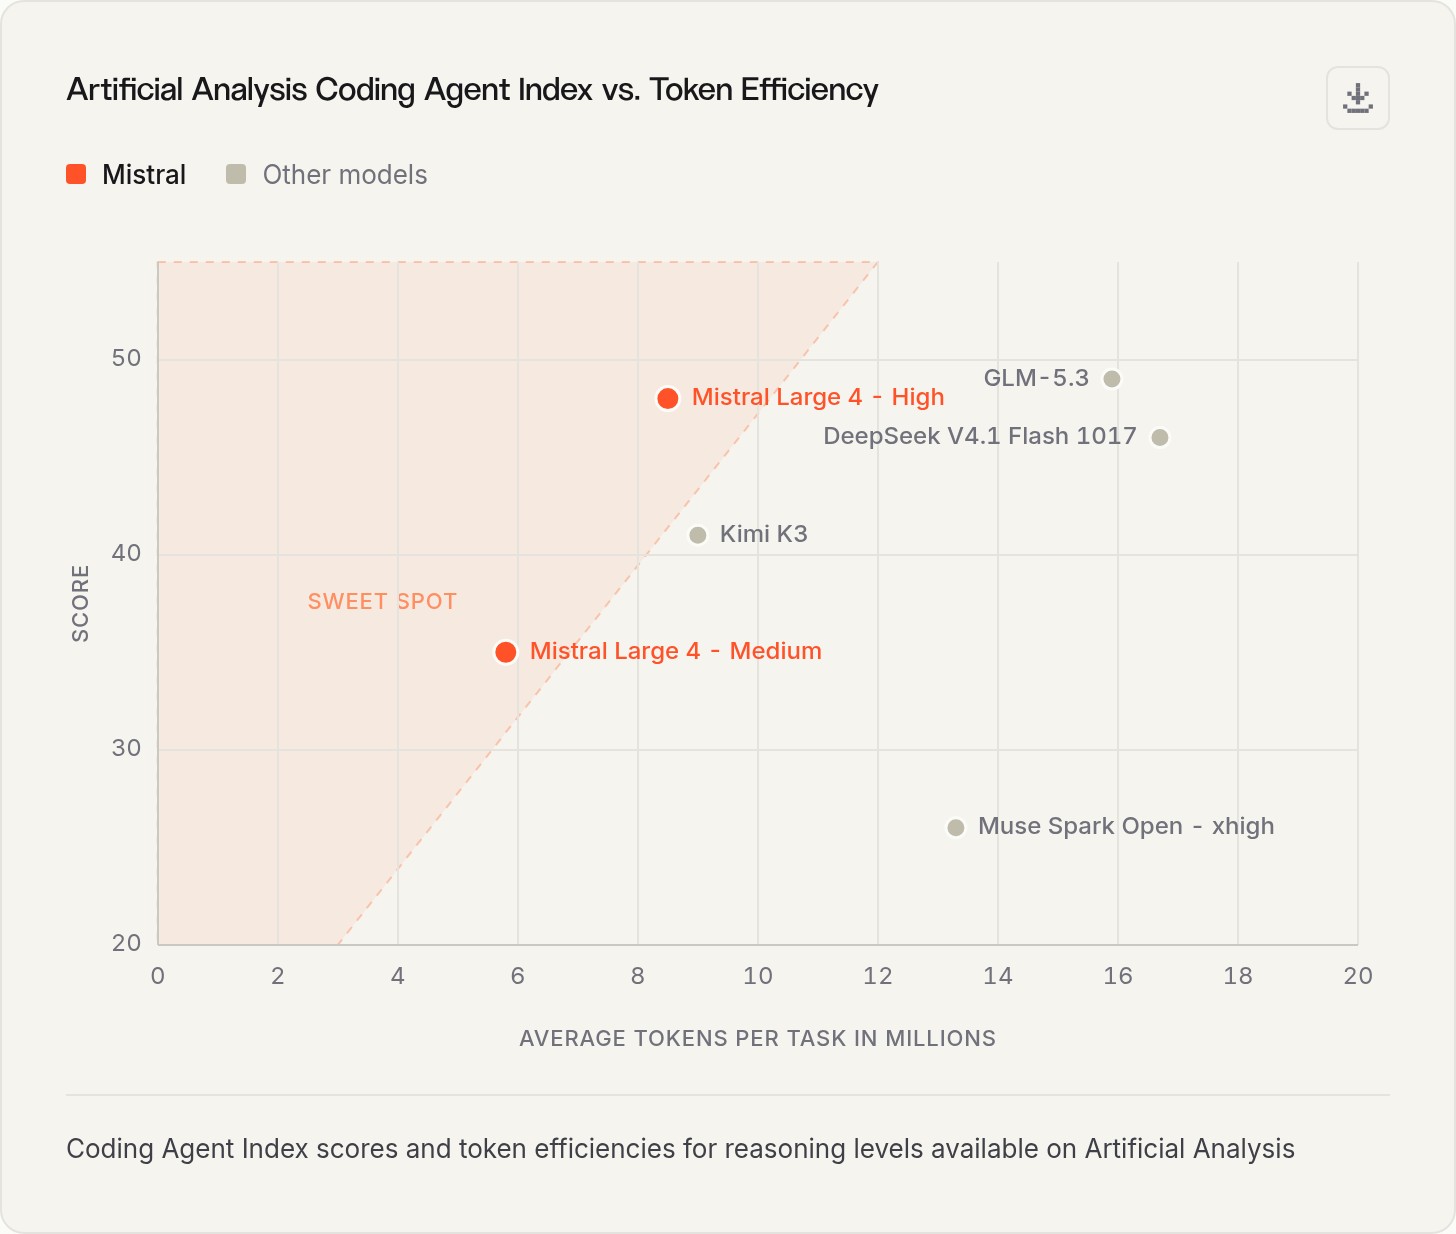
Il dato più interessante è un altro: l'efficienza. Nel Coding Agent Index di Artificial Analysis, che misura i modelli come agenti di programmazione, Large 4 al livello high ottiene il 48%, contro il 49% di GLM-5.3. Ma per arrivarci usa in media 8,5 milioni di token per compito, contro 15,9 milioni. Secondo Mistral è un pareggio di fatto, con il 47% di token in meno. Meno token vuol dire bollette più basse e risposte più rapide.
Su Terminal-Bench 4.0, che misura il lavoro al terminale, il salto rispetto alla preview è il più netto: da 28% a 41,4%, con il 30% di token in uscita in meno secondo Mistral.
Terminal-Bench 4.0
Percentuale di compiti risolti al terminale, più alto è meglio
Fonte: Blog ufficiale di Mistral, grafico Artificial Analysis, 29/10/2026
C'è anche una prova con persone vere. Su Surge Code, valutatori umani hanno confrontato alla cieca le risposte di due modelli sullo stesso problema. Large 4 viene preferito nel 64% dei casi contro GLM-5.3 e Kimi K3 e nel 56% contro DeepSeek V4.1 Flash. Contro Claude Opus 5.5 però vince solo nel 22% dei casi: il modello chiuso di Anthropic resta nettamente avanti.
Sicurezza: sa dire di no#
Mistral dedica una parte dell'annuncio alla sicurezza informatica, perché un modello aperto non si può ritirare dopo averlo pubblicato.
Test | Cosa misura | Mistral Large 4 | Preview | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
Rifiuto di richieste cyber dannose | Quante richieste malevole rifiuta | 96,6% | 95,3% | 87,1% | 93,6% |
B3 Agent Security | Resistenza agli attacchi quando lavora da agente | 97,1% | 93,3% | 93,3% | 88,1% |
Cyber Index di Artificial Analysis | Capacità offensive e difensive | 51% | n.d. | 36% | 41% |
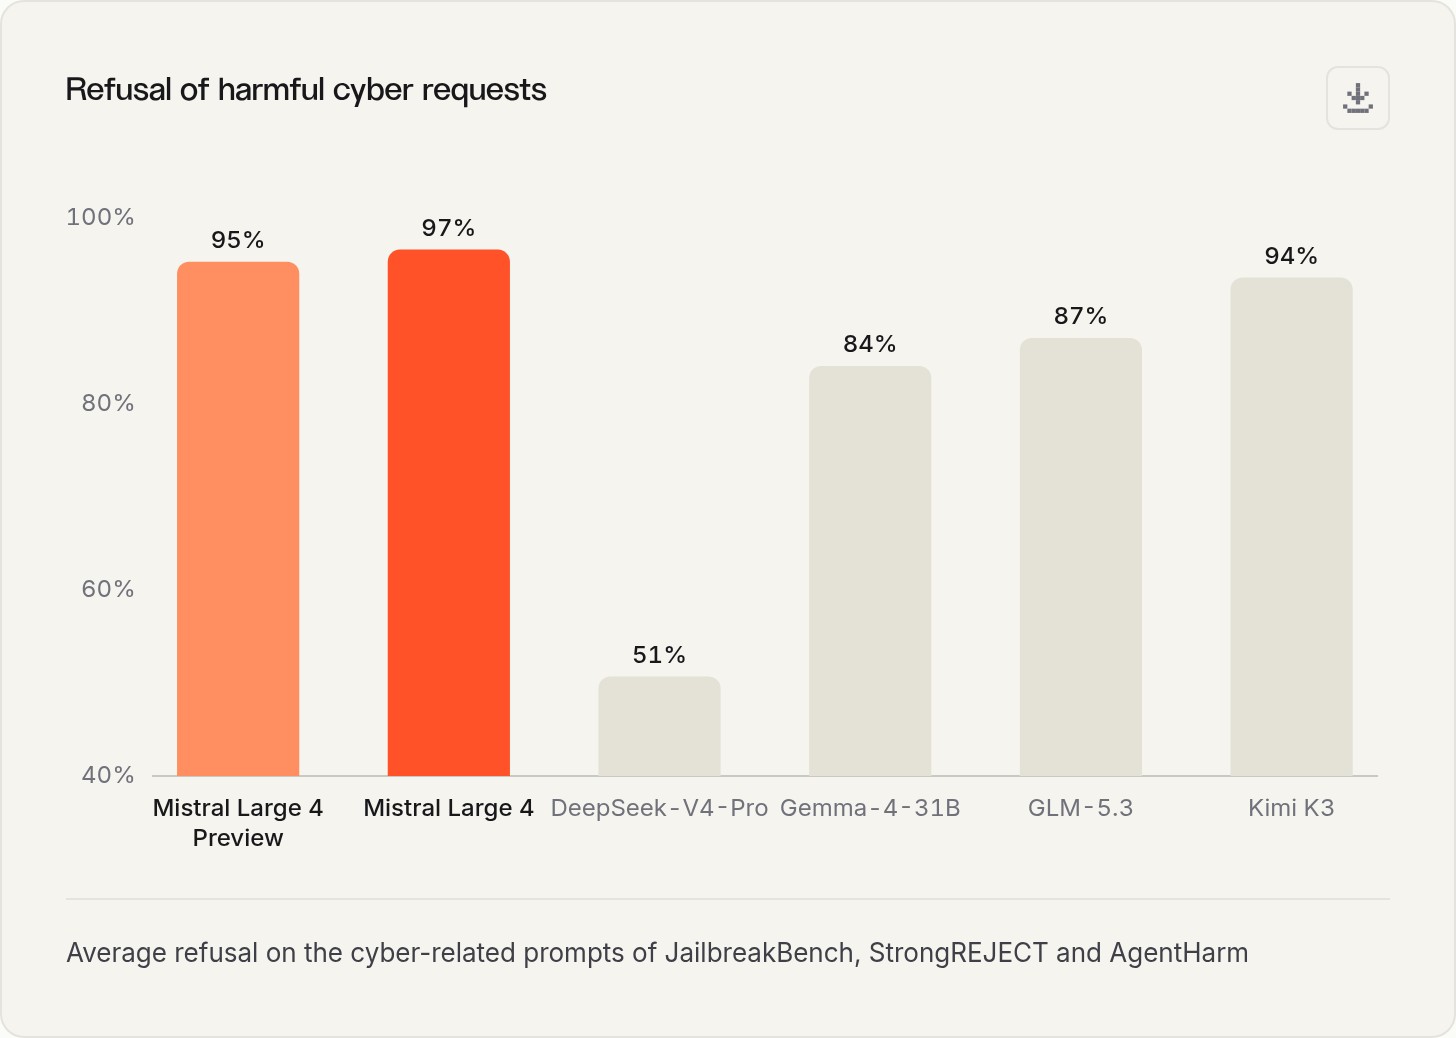
Sul Cyber Index Large 4 è terzo, dietro DeepSeek V4.1 Flash 1017 (57%) e MiMo-V2.6-Pro (56%). Mistral stessa riconosce che il modello ha un potenziale per aiutare attacchi reali e scrive che sta adattando le protezioni; una variante specializzata per la cybersicurezza è in anteprima per partner selezionati, tra cui Orange Cyberdefense.
Non solo codice: finanza e ricerca sul web#
Per il lavoro d'ufficio Mistral cita due test. Su FinWorkBench (Finch), compiti di finanza aziendale, passa dal 67,4% della preview al 73,3%, sotto Kimi K3 (77,3%). Su BrowseComp, la ricerca di informazioni difficili sul web, segna 84,5, davanti a DeepSeek V4.1 Flash (83,4) e GLM-5.3 (82,5) ma dietro Kimi K3 (91,2).
I limiti da tenere presenti#
Limite | Cosa significa |
|---|---|
Dati del produttore | Tutti i grafici sono pubblicati da Mistral, anche quando i test sono di terzi come Artificial Analysis o Cognition |
Margini piccoli | Su FrontierCode il vantaggio è di 0,4 punti; nel Coding Agent Index è un punto sotto GLM-5.3 |
Non è il più forte in assoluto | Contro Claude Opus 5.5 viene preferito solo nel 22% dei confronti |
Indice generale | Nell'Intelligence Index v5 di Artificial Analysis ha 26 punti: il più alto tra i modelli aperti occidentali, ma sotto i migliori aperti cinesi |
Hardware | Gli esempi ufficiali per farlo girare usano 8 GPU di fascia data center |
Licenza | Chi vuole rivenderlo come servizio deve chiedere una licenza commerciale separata |
Pagina docs | La pagina della documentazione era ancora quella della preview al 29/10/2026 |
Dove si usa e quanto costa#
Ci sono tre strade:
Via API, senza gestire hardware: Mistral Studio e Mistral API (con il nome
mistral-large-4), OpenRouter, l'assistente di programmazione Vibe Code e Microsoft Foundry, il primo cloud a offrirlo. Con Forge di Mistral si può anche personalizzare.Sui propri server, scaricando i pesi da Hugging Face e servendoli con vLLM o SGLang. Gli esempi ufficiali usano 8 GPU; la ricetta di Hugging Face Inference Endpoints su 8 GPU H200 indica circa 65 token al secondo per una singola richiesta. Secondo Hugging Face, le versioni compresse a 2 bit girano anche su un solo Mac Apple Silicon Ultra con 512 GB di memoria.
Per provarlo, NVIDIA offre un endpoint gratuito su build.nvidia.com con i termini di prova di NVIDIA, e Hugging Face ospita la «Le Chonk Gallery» con demo gratuite a budget limitato nella prima settimana. Mistral cita anche un container NVIDIA NIM per installarlo in casa: sulla pagina NVIDIA, per ora, c'è solo l'endpoint di prova.
Prezzo API | Per milione di token |
|---|---|
Input | 0,70 $ |
Input già in cache | 0,07 $ |
Output | 2,10 $ |
I prezzi sono in dollari e Mistral non indica l'IVA.
La licenza è la Mistral Ecosystem Open-Weight License, una MIT modificata: uso, modifica, fine-tuning e uso commerciale sono liberi. Serve una licenza commerciale separata solo a chi lo offre a terzi come servizio, cioè come «model as a service».
Cosa cambia in pratica per un'azienda#
Se i dati non possono uscire, ora c'è un'opzione europea di fascia alta. Studi professionali, sanità, pubblica amministrazione e manifattura con segreti industriali possono valutarlo su server propri o su un cloud di fiducia.
Fate i conti con l'hardware, non solo con il prezzo. Otto GPU da data center sono un investimento serio: per molte PMI la strada sensata è partire dall'API e passare in casa solo se i volumi o la riservatezza lo giustificano.
Scegliete il livello di ragionamento. High dà i risultati migliori ma consuma molti più token di medium: misuratelo sui vostri compiti.
Preparate tre prove vostre. Un bug reale del vostro codice, un documento lungo da riassumere in italiano, un'estrazione in JSON da collegare al gestionale. Confrontate Large 4 con il modello che usate oggi, su costo e qualità.
Leggete la licenza se rivendete servizi. Se il vostro prodotto è un'AI offerta ai clienti, la licenza separata vi riguarda.
Domande frequenti#
Che cos'è Mistral Large 4?
È il modello più grande di Mistral AI: circa mille miliardi di parametri, di cui 52 miliardi attivi, contesto da un milione di token, testo e immagini in ingresso. Dal 29 ottobre 2026 i pesi sono pubblici su Hugging Face.
Cosa vuol dire pesi aperti?
Che il modello si può scaricare e far girare sui propri server, modificare e adattare, invece di usarlo solo tramite il servizio del produttore.
Si può usare a fini commerciali?
Sì. La licenza è una MIT modificata che permette uso commerciale, modifica e fine-tuning. Serve una licenza separata solo per offrirlo ad altri come servizio di modello.
Quanto costa via API?
0,70 dollari per milione di token in entrata, 0,07 per quelli già in cache e 2,10 per quelli in uscita. Mistral non indica l'IVA.
Che hardware serve per farlo girare in casa?
Gli esempi ufficiali usano 8 GPU da data center. Secondo Hugging Face le versioni compresse a 2 bit girano anche su un solo Mac Apple Silicon Ultra con 512 GB di memoria, con qualità e velocità da verificare.
È il modello migliore per programmare?
Secondo i test pubblicati da Mistral è il primo tra i modelli aperti su FrontierCode 2.0, ma con un margine minimo, e resta dietro a Claude Opus 5.5 nei confronti con valutatori umani.
Fonti#
Blog di Mistral AI: Mistral Large 4, 29/10/2026.
Scheda del modello Mistral-Large-4-1T-A52B su Hugging Face, letta il 29/10/2026.
Blog di Hugging Face: Welcome Le Chonk, 29/10/2026.
Scheda di Mistral Large 4 su build.nvidia.com, letta il 29/10/2026.
Post di Mistral AI su X, 29/10/2026.
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Valutazione della notizia e del suo impatto per le aziende: un modello europeo di fascia alta che si può tenere in casa, forte nel codice ma con margini piccoli e hardware impegnativo.
Mistral Large 4 porta pesi aperti, contesto da un milione di token e una licenza che permette l'uso commerciale, con risultati da primo della classe tra i modelli aperti nel codice nei test di Mistral. L'efficienza è il dato più utile: quasi lo stesso punteggio di GLM-5.3 con molti meno token. I vantaggi però sono piccoli, i modelli chiusi come Claude Opus 5.5 restano avanti e farlo girare in casa richiede 8 GPU da data center. Per molte aziende conviene partire dall'API e valutare il passaggio in casa con test propri.
Punti di forza
- Pesi aperti con uso commerciale libero, licenza MIT modificata.
- Primo tra i modelli aperti su FrontierCode 2.0 con 19,7%, secondo Mistral.
- Efficiente: 48% nel Coding Agent Index con 8,5 milioni di token, contro i 15,9 milioni di GLM-5.3.
- Contesto da 1 milione di token, testo e immagini, oltre 160 lingue.
- Alto tasso di rifiuto delle richieste cyber dannose (96,6%) e 97,1% su B3.
- Prezzo API contenuto: 0,70 $ in entrata e 2,10 $ in uscita per milione di token.
Limiti
- Vantaggi minimi sui rivali aperti, e dati tutti pubblicati da Mistral.
- Dietro a Claude Opus 5.5: preferito solo nel 22% dei confronti umani.
- Terzo nel Cyber Index e sotto i migliori aperti cinesi nell'Intelligence Index.
- Gli esempi ufficiali per l'uso in casa richiedono 8 GPU da data center.
- Licenza separata per chi lo rivende come servizio; container NIM non ancora visibile su NVIDIA.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
5- 1.Mistral AI, Mistral Large 4mistral.ai
Annuncio ufficiale del 29/10/2026: pesi aperti, grafici dei benchmark (FrontierCode, Coding Agent Index, Terminal-Bench, Surge, sicurezza, Finch, BrowseComp), disponibilità e prezzi API.
- 2.Hugging Face, scheda Mistral-Large-4-1T-A52Bhuggingface.co
Architettura, parametri, contesto, lingue, livelli di ragionamento, licenza, esempi di serving con vLLM e SGLang, Intelligence Index di Artificial Analysis.
- 3.Hugging Face, Welcome Le Chonkhuggingface.co
Blog di Hugging Face del 29/10/2026: formati FP8 e NVFP4, ricetta su 8 GPU H200, versioni a 2 bit su Mac con 512 GB.
- 4.NVIDIA, scheda di Mistral Large 4 su build.nvidia.combuild.nvidia.com
Scheda del modello ed endpoint di prova gratuito con i termini NVIDIA API Trial. Il container NIM è citato solo da Mistral.
- 5.Mistral AI su X, annuncio dei pesi apertix.com
Post del 29/10/2026 alle 15:21 ora di Roma con l'immagine ufficiale di Le Chonk.
Continua a leggere.
 NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min RicercaDisponibile in podcast
Anche Anthropic dichiara falsa l'ETH: l'algoritmo per 3-SAT trovato da Claude
Il 27 ottobre 2026 Anthropic ha pubblicato un paper firmato da Claude che dichiara falsa l'Exponential Time Hypothesis. L'algoritmo, trovato da un modello interno il 16 ottobre, ha una prova Lean scritta da AI ma nessuna verifica umana o revisione esterna.
6 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.