Ricursive Intelligence rilascia un LLM denso da 65B con claim 80,52 su TerminalBench 2.1, licenza Apache 2.0 e API su OpenRouter a 0,20/0,60 dollari. Contesto 1M sul modello, 16K su OpenRouter.
Il 4 novembre 2026 Ricursive Intelligence ha rilasciato Ripple-65B Preview: 65B densi, claim SOTA USA open-weight su TerminalBench 2.1 (80,52 self-reported), pesi Apache 2.0 e API su OpenRouter a 0,20/0,60 dollari con contesto 16K.
di Andrea Pirazzini
Fonte primaria
Ricursive Intelligence, pagina Ripple
ricursive.com
Carlo
Il Narratore · 2 min 15 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Ricursive Intelligence, pagina Ripple.
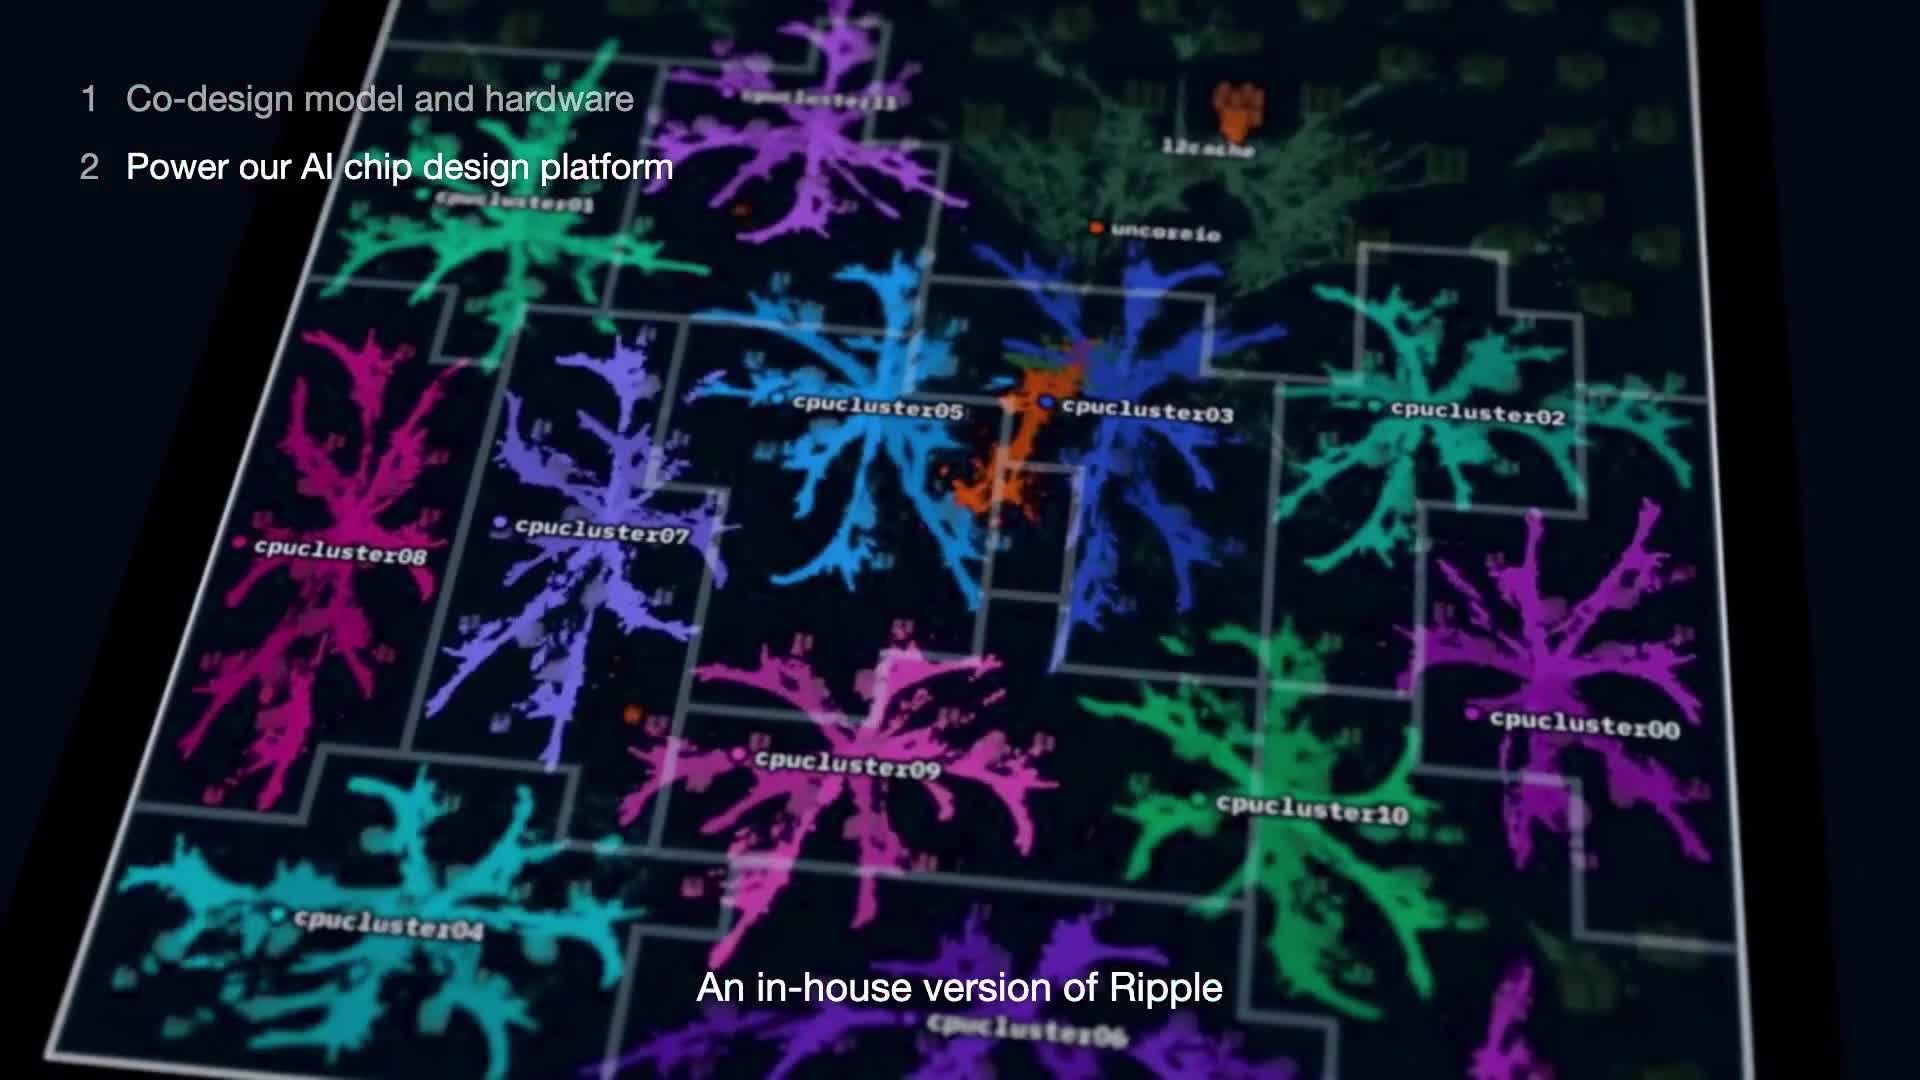
Il 4 novembre 2026 Ricursive Intelligence ha rilasciato Ripple-65B Preview, un modello di linguaggio denso da 65 miliardi di parametri. È la variante general-purpose del modello che alimenta la loro piattaforma di progettazione chip. I pesi sono pubblici su Hugging Face con licenza Apache 2.0, e il modello è già disponibile via API su OpenRouter, Together AI e GMI Cloud.
Parametri, modello denso (non Mixture of Experts)
Token di preaddestramento dichiarati da Ricursive
TerminalBench 2.1, claim SOTA USA open-weight (self-reported)
Licenza dei pesi su Hugging Face
Perché se ne parla#
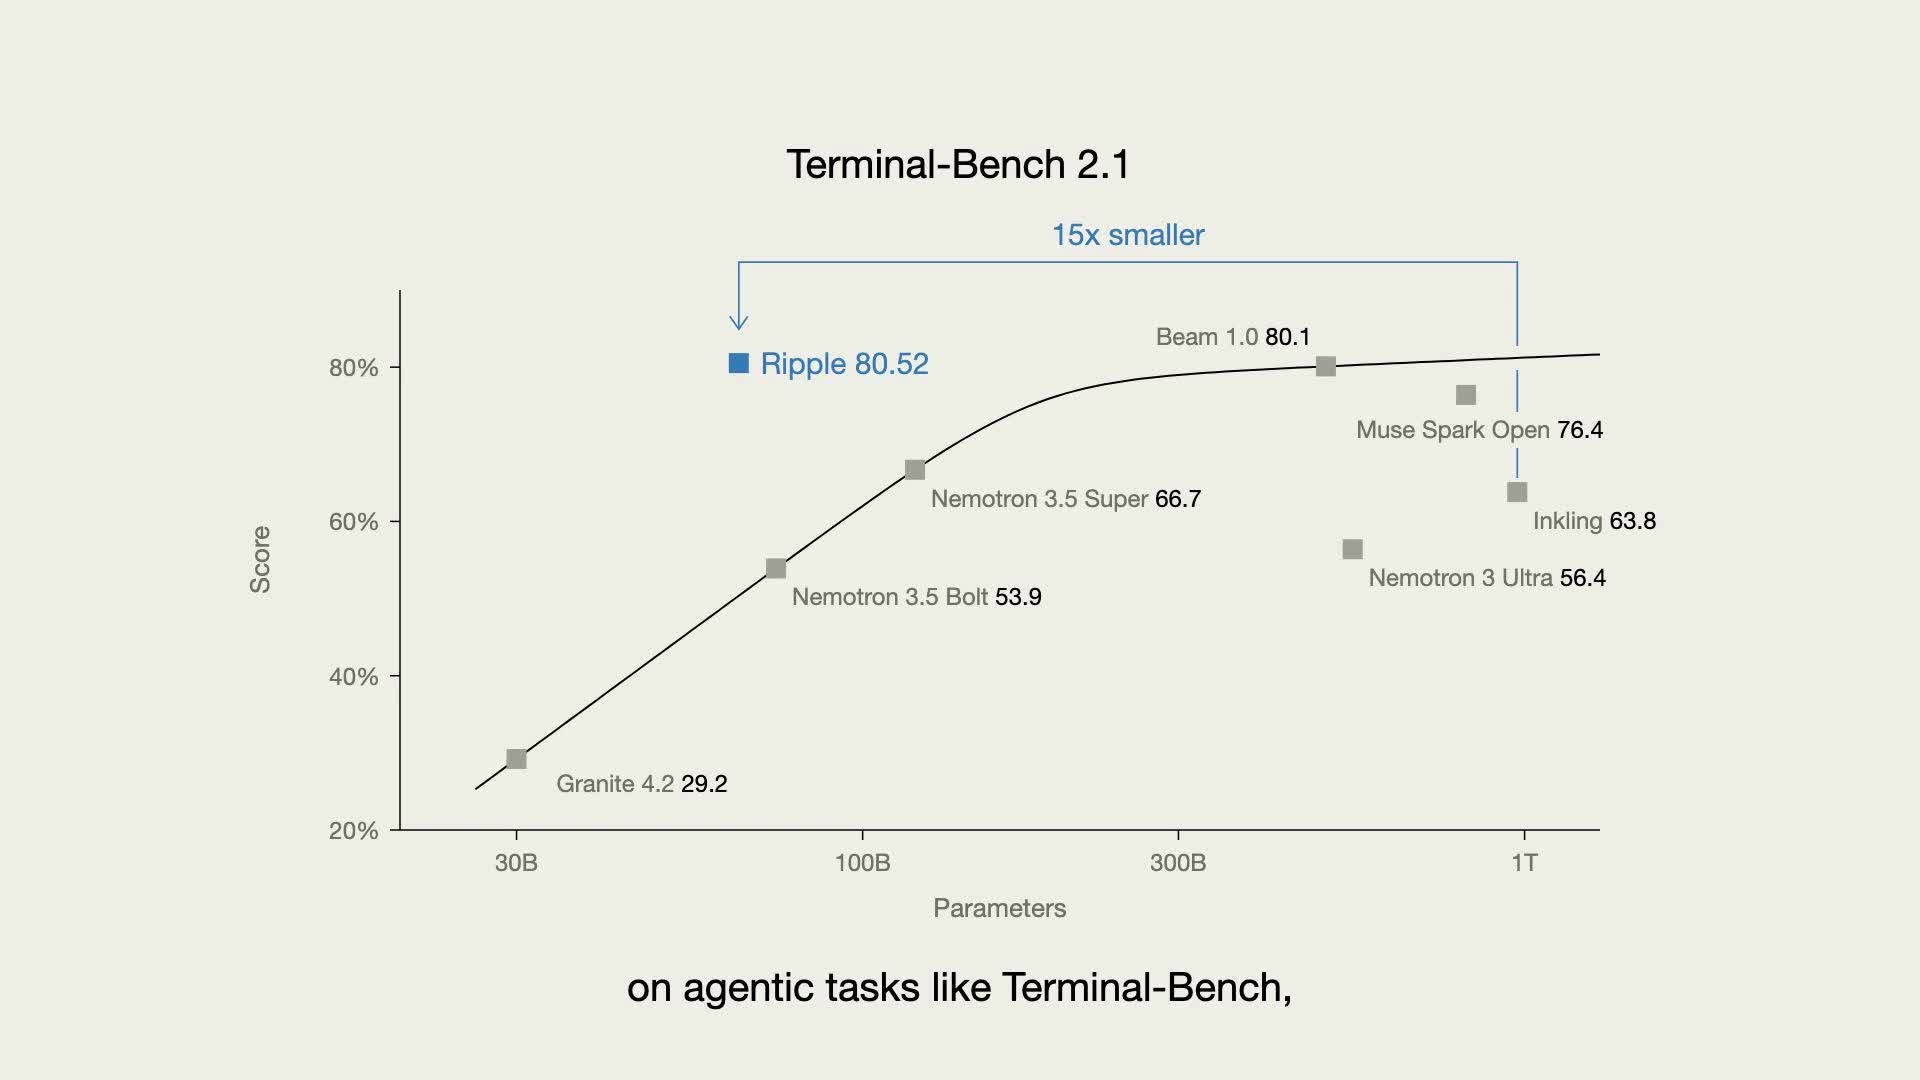
Il claim è ambizioso: secondo Ricursive, Ripple-65B Preview è il nuovo SOTA USA open-weight sull'agentic coding, con 80,52 su TerminalBench 2.1. Nella tabella ufficiale supera Reflection Beam 501B (80,1), Meta Muse Spark Open 816B (76,4), Thinking Machines Inkling 975B (63,8) e NVIDIA Nemotron 3 Ultra 550B (56,4).
Sono numeri del produttore. Al 4 novembre 2026 non risultano verifiche indipendenti. Il modello è comunque scaricabile e usabile via API, quindi i numeri si potranno rifare.
Un altro punto: il contesto dichiarato del modello arriva a 1 milione di token, ma su OpenRouter oggi è esposto solo a 16.384. Vale la pena dirlo subito, perché cambia molto cosa si può fare in pratica via quel canale.
https://x.com/RicursiveAI/status/2118046765857546733
Cos'è, in parole semplici#
Ripple-65B Preview è un LLM denso: non è un Mixture of Experts. Ricursive lo descrive come architettura thin-and-deep: 80 layer, dimensione interna 5120. Tra le scelte dichiarate ci sono FFN activation clipping, gated attention, global NoPE e value residuals.
Preaddestrato da zero su 12 trilioni di token, secondo la pagina ufficiale.
Focus agentic coding: è una preview release, con post-training descritto come «relatively light».
Costo R&D dichiarato: circa 32 milioni di dollari, presentato come circa un decimo del precedente SOTA open-weight su agentic coding (stima loro). Sul reinforcement learning parlano di circa 1,4 milioni di rollout, circa 70 volte meno di Reflection Beam.
Hardware: Ricursive indica che gira in modo efficiente su dispositivi come NVIDIA DGX Spark (alto FLOPs, bassa bandwidth di memoria). Hugging Face scrive che può stare su hardware consumer come il DGX Spark. Throughput dichiarato: 250 token al secondo su 2×B200 con batch 8, prima di quantizzazione e kernel custom.
Il claim su TerminalBench 2.1#
Nella tabella pubblicata da Ricursive i rivali sono modelli molto più grandi. Ripple, a 65B densi, si colloca in cima al claim USA open-weight sul TerminalBench 2.1.
TerminalBench 2.1, claim Ricursive
Punteggi pubblicati dal produttore, più alto è meglio
Fonte: ricursive.com/ripple e scheda Hugging Face ricursiveAI/Ripple-65B-Preview, 04/11/2026
Modello | Parametri | TerminalBench 2.1 |
|---|---|---|
Ripple-65B Preview | 65B denso | 80,52 |
Reflection Beam 501B | 501B | 80,1 |
Meta Muse Spark Open 816B | 816B | 76,4 |
Thinking Machines Inkling 975B | 975B | 63,8 |
NVIDIA Nemotron 3 Ultra 550B | 550B | 56,4 |
Come si prova oggi#
I pesi sono su Hugging Face: ricursiveAI/Ripple-65B-Preview, repository pubblico, senza gate. La licenza è Apache 2.0. Sul sito ufficiale risultano anche Together AI, GMI Cloud e OpenRouter; Fireworks era annunciato come in arrivo lo stesso giorno del lancio. I prezzi di Together, GMI e Fireworks non risultano nelle fonti salvate per questo articolo.
Su OpenRouter il modello si chiama ricursiveai/ripple-65b-preview. Provider indicato: GMI Cloud. Prezzi letti il 4 novembre 2026:
Voce | Valore |
|---|---|
Input | 0,20 $ per milione di token |
Output | 0,60 $ per milione di token |
Cache read | 0,05 $ per milione di token |
Contesto esposto | 16.384 token |
Contesto dichiarato del modello | fino a 1 milione di token |
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="la-vostra-chiave",
)
risposta = client.chat.completions.create(
    model="ricursiveai/ripple-65b-preview",
    messages=[{"role": "user", "content": "Sistema questo bug e spiega i passi"}],
)I limiti da tenere presenti#
Limite | Cosa significa |
|---|---|
Numeri del produttore | TerminalBench 80,52 è self-reported; nessuna verifica indipendente al 4 novembre |
Preview release | Post-training descritto come relativamente leggero, focus agentic coding |
Contesto su OpenRouter | 16K esposti, non 1M |
Prezzi incompleti | Together / GMI / Fireworks non letti da fonti salvate |
Hardware locale | Riferimento ufficiale: DGX Spark / hardware consumer di quel tipo, non laptop generici |
Confusione di nome | Ricursive Intelligence (ricursive.com) non è Recursive Superintelligence / Flint |
Cosa cambia in pratica per un'azienda#
Per una prova rapida, partite da OpenRouter con un compito di coding agentico e dati non sensibili. Costa 0,20 / 0,60 $ per milione di token.
Confrontate sul vostro backlog, non sul claim. Un set di ticket o di script da sistemare dice più di un unico benchmark del produttore.
Se i dati non possono uscire, scaricate i pesi Apache 2.0 e valutate l'hosting interno: il riferimento hardware di Ricursive è il DGX Spark.
Non progettate ancora flussi da 1M token su OpenRouter: oggi quel canale espone 16K.
Documentate la fonte dei numeri se li usate in una presentazione interna: sono claim ufficiali, non misurazioni di terzi.
Domande frequenti#
Ripple-65B Preview è davvero open weight?
Sì. I pesi sono pubblici su Hugging Face nella pagina ricursiveAI/Ripple-65B-Preview, senza gate, con licenza Apache 2.0.
Ha davvero 1 milione di token di contesto?
Ricursive e Hugging Face dichiarano supporto fino a 1 milione di token. Su OpenRouter, al 4 novembre 2026, il contesto esposto è 16.384 token.
Quanto costa su OpenRouter?
0,20 dollari per milione di token in ingresso, 0,60 in uscita, 0,05 per la cache read. Provider indicato: GMI Cloud. IVA non indicata sulla scheda letta.
È lo stesso di Recursive / Flint?
No. Ricursive Intelligence (ricursive.com, @RicursiveAI) è un soggetto diverso da Recursive Superintelligence / Flint (recursive.com).
Si può far girare su un laptop qualunque?
Nelle fonti ufficiali il riferimento è NVIDIA DGX Spark e hardware consumer di quel tipo. Il MacBook Pro non compare nelle fonti ufficiali lette per questo articolo.
I 80,52 su TerminalBench sono verificati?
Sono self-reported da Ricursive. Al 4 novembre 2026 non risultano verifiche indipendenti pubbliche.
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Valutazione della notizia e del suo impatto per le aziende: un open-weight USA con claim forte sul coding agentico, licenza ampia e API subito usabile, ma con numeri ancora solo del produttore.
Ripple-65B Preview mette sul tavolo un modello denso americano a pesi aperti, con licenza Apache 2.0 e un claim alto su TerminalBench 2.1. Per un'azienda la prova sensata parte dall'API OpenRouter a 0,20/0,60 dollari, su un pezzo di backlog reale e senza dati sensibili. Restano tre freni concreti: i benchmark sono self-reported, su OpenRouter il contesto è 16K e non 1M, e l'hosting locale punta a hardware tipo DGX Spark. Se i numeri reggono a una verifica interna, diventa un candidato serio per coding agentico open-weight; altrimenti resta una preview da monitorare.
Punti di forza
- Pesi pubblici su Hugging Face con Apache 2.0, senza gate.
- Claim 80,52 su TerminalBench 2.1 come SOTA USA open-weight (dato produttore).
- API subito disponibile su OpenRouter a 0,20/0,60 dollari per milione di token.
- Modello denso da 65B, più semplice da ragionare rispetto a MoE enormi.
- Contesto dichiarato fino a 1 milione di token sul modello.
- Canali multipli: HF, Together AI, GMI Cloud, OpenRouter.
Limiti
- Benchmark self-reported, senza verifiche indipendenti al 4 novembre 2026.
- Su OpenRouter il contesto esposto è 16K, non 1M.
- Preview release con post-training descritto come relativamente leggero.
- Prezzi Together/GMI/Fireworks non disponibili nelle fonti salvate.
- Hardware locale riferito a DGX Spark, non a laptop generici.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
5- 1.Ricursive Intelligence, pagina Ripplericursive.com
Annuncio ufficiale: architettura 65B densa, 12 T token, claim TerminalBench 2.1, costo R&D ~32M, canali di accesso e hardware DGX Spark.
- 2.Hugging Face, ricursiveAI/Ripple-65B-Previewhuggingface.co
Scheda pubblica gated false, licenza apache-2.0, architettura 80 layer / d_model 5120, contesto fino a 1M, tabella rivali TerminalBench.
- 3.
- 4.@RicursiveAI su X, annuncio Ripple-65Bx.com
Post ufficiale del 4 novembre 2026 con video di lancio (~74 secondi).
- 5.OpenRouter, ricursiveai/ripple-65b-previewopenrouter.ai
Prezzi 0,20/0,60 dollari per 1M token in/out, cache 0,05, contesto esposto 16.384, provider GMI Cloud, released 4 Nov 2026.
Continua a leggere.
 NewsDisponibile in podcast
Gemini Omni 1.2 Flash: video da 15 secondi, editing a conversazione, −30% di prezzo
Il 5 novembre 2026 Gemini Omni 1.2 Flash è GA su API e Google Cloud: fino a 15 s, editing multi-turn, 0,07 $/s a 720p (−30%). Caveat su sport, fisica e Ultra per i 15 s in app.
4 min NewsDisponibile in podcast
GPT-6 Cyber di OpenAI: +51% su ExploitGym, Critical, solo Daybreak Red
Il 5 novembre 2026 OpenAI ha presentato GPT-6 Cyber: +51% relativo su ExploitGym, classificazione Critical, Linux 948 e Firefox 81. Disponibile in API/Codex per Daybreak Red, non in ChatGPT pubblico.
4 min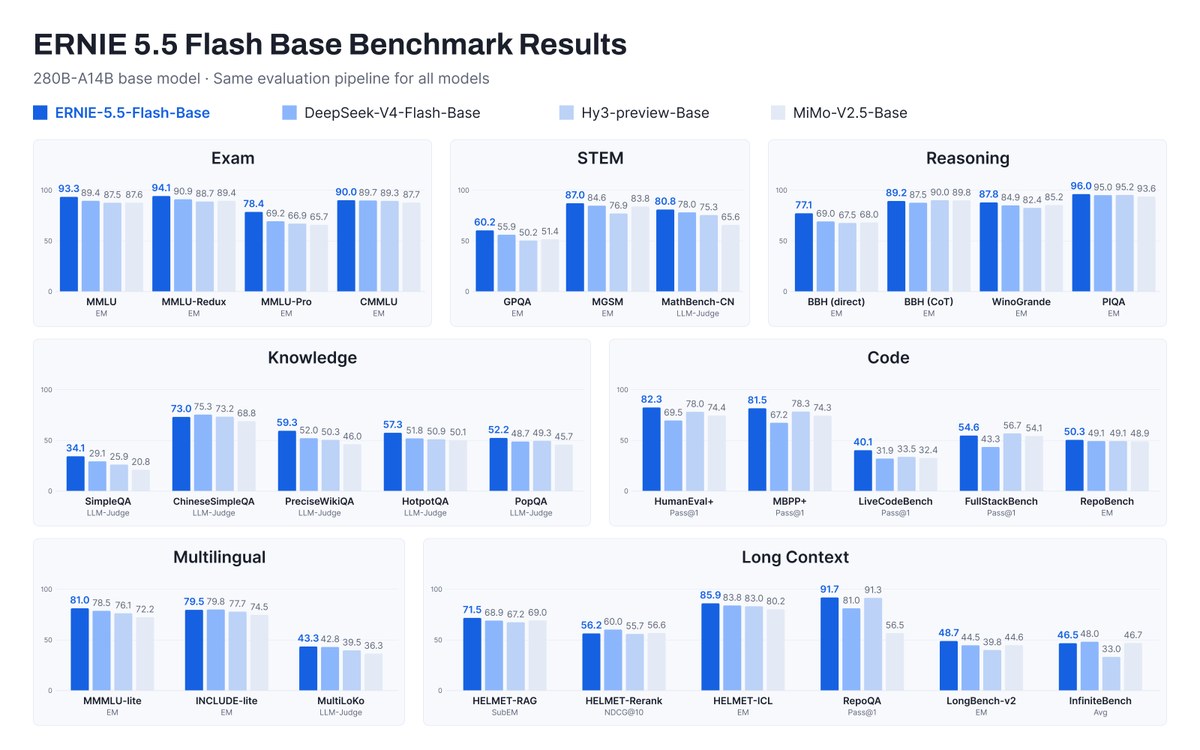 NewsDisponibile in podcast
ERNIE-5.5-Flash-Base di Baidu: 280B open weights, ma la licenza esclude UE
Il 5 novembre 2026 Baidu ha rilasciato ERNIE-5.5-Flash-Base: MoE 280B con 14B attivi, pesi FP8/BF16 aperti. Per l'Italia conta la Territory: la licenza esclude UE, UK e Corea del Sud.
5 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.