Un modello che fa tutto l'agente vocale, dall'ascolto alla risposta. I numeri di Artificial Analysis, i prezzi al minuto e a token, le due strade per usarlo e i limiti del rilascio.
Eleven Realtime di ElevenLabs: agenti vocali v1 Mini e v1 Max, primo audio in 0,57 s, 98,8% su Big Bench Audio, 90+ lingue con italiano. Prezzi, stime al minuto e limiti del rilascio graduale.
di Andrea Pirazzini
Fonte primaria
ElevenLabs, Introducing Eleven Realtime
elevenlabs.io
Giulio
Il Narratore · 2 min 33 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: ElevenLabs, Introducing Eleven Realtime.
Perché se ne parla#
Il 20 ottobre 2026 ElevenLabs ha presentato Eleven Realtime, che l'azienda descrive come una nuova classe di modelli speech to speech: voce in ingresso, voce in uscita. Ogni modello è un agente vocale completo, con riconoscimento del parlato, rilevamento della voce e dei turni, modello linguistico e sintesi vocale scelti e regolati da ElevenLabs perché lavorino come un solo sistema.
Il problema che vuole risolvere è noto a chiunque abbia provato a costruire un centralino con AI: oggi bisogna scegliere e far funzionare insieme cinque componenti diversi, e decidere a mano quanto aspettare dopo una pausa o come comportarsi quando chi chiama interrompe. Con Eleven Realtime queste scelte le fa ElevenLabs.
Lo stesso giorno anche Mistral ha presentato il suo kit per agenti vocali: trovate il confronto nell'articolo su Voxtral 3. Per il contesto su ElevenLabs, leggete anche come ElevenAgents riconosce le voci AI nelle chiamate.
Risposte corrette a voce di v1 Max in Big Bench Audio
Tempo medio al primo audio di v1 Max
Lingue supportate, italiano compreso
Al minuto di audio collegato, più i token
Due modelli: Mini e Max#
Eleven Realtime v1 Mini | Eleven Realtime v1 Max | |
|---|---|---|
Pensato per | Conversazioni naturali a basso costo | Compiti complessi in più passaggi |
Esempi d'uso | Assistenti, tutor, personaggi interattivi, interviste | Assistenza clienti, qualificazione dei contatti, flussi di lavoro |
Ragionamento | Risponde subito | Ragiona prima di rispondere, usa gli strumenti |
ID nell'API | eleven_realtime_v1_mini | eleven_realtime_v1_max |
Residenza dei dati in UE | Disponibile | Disponibile |
Zero Retention e HIPAA | Non disponibile | Disponibile negli Stati Uniti e in UE |
Secondo ElevenLabs Mini basta per la maggior parte dei casi ed è il modello predefinito. Max serve quando l'agente deve seguire una procedura e ragionare tra un passaggio e l'altro. Entrambi supportano oltre 90 lingue, compreso l'italiano, e possono usare tutte le oltre 17.000 voci della libreria ElevenLabs.
Il video di lancio#
Nel video ufficiale si vedono due demo. Mini conduce un'intervista a un'utente sul suo primo mese con un'app e rilancia le domande in base alle risposte. Max gestisce l'assistenza di un operatore telefonico inventato per la demo: il cliente dice che internet non funziona, l'agente chiama lo strumento che controlla la rete, trova un guasto in zona e comunica che il servizio rientra entro un'ora.
In parole semplici: catena o modello unico?#
Un agente vocale classico è una catena: un modello trascrive, un altro ragiona, un terzo parla. Ogni anello aggiunge ritardo e va configurato. Eleven Realtime si presenta come un unico modello, ma la documentazione è chiara: dentro, v1 Mini e v1 Max usano ancora un'architettura a cascata, ottimizzata da un capo all'altro, e i modelli interni non sono pubblici.
La differenza per voi non sta nell'architettura ma in chi la regola. Pause, turni, interruzioni e scelta dei componenti sono gestiti da ElevenLabs; voi scegliete il modello, la voce, il prompt e gli strumenti.
Come vanno: i numeri#
ElevenLabs pubblica una valutazione indipendente di Artificial Analysis su tre test pubblici: Big Bench Audio per il ragionamento a voce (1.000 domande), Full-Duplex-Bench per pause, turni e interruzioni, e la Speech Agent Arena, dove persone reali confrontano due modelli in conversazioni alla cieca.
Test | v1 Mini | v1 Max |
|---|---|---|
Big Bench Audio (ragionamento a voce) | 75,9% | 98,8% |
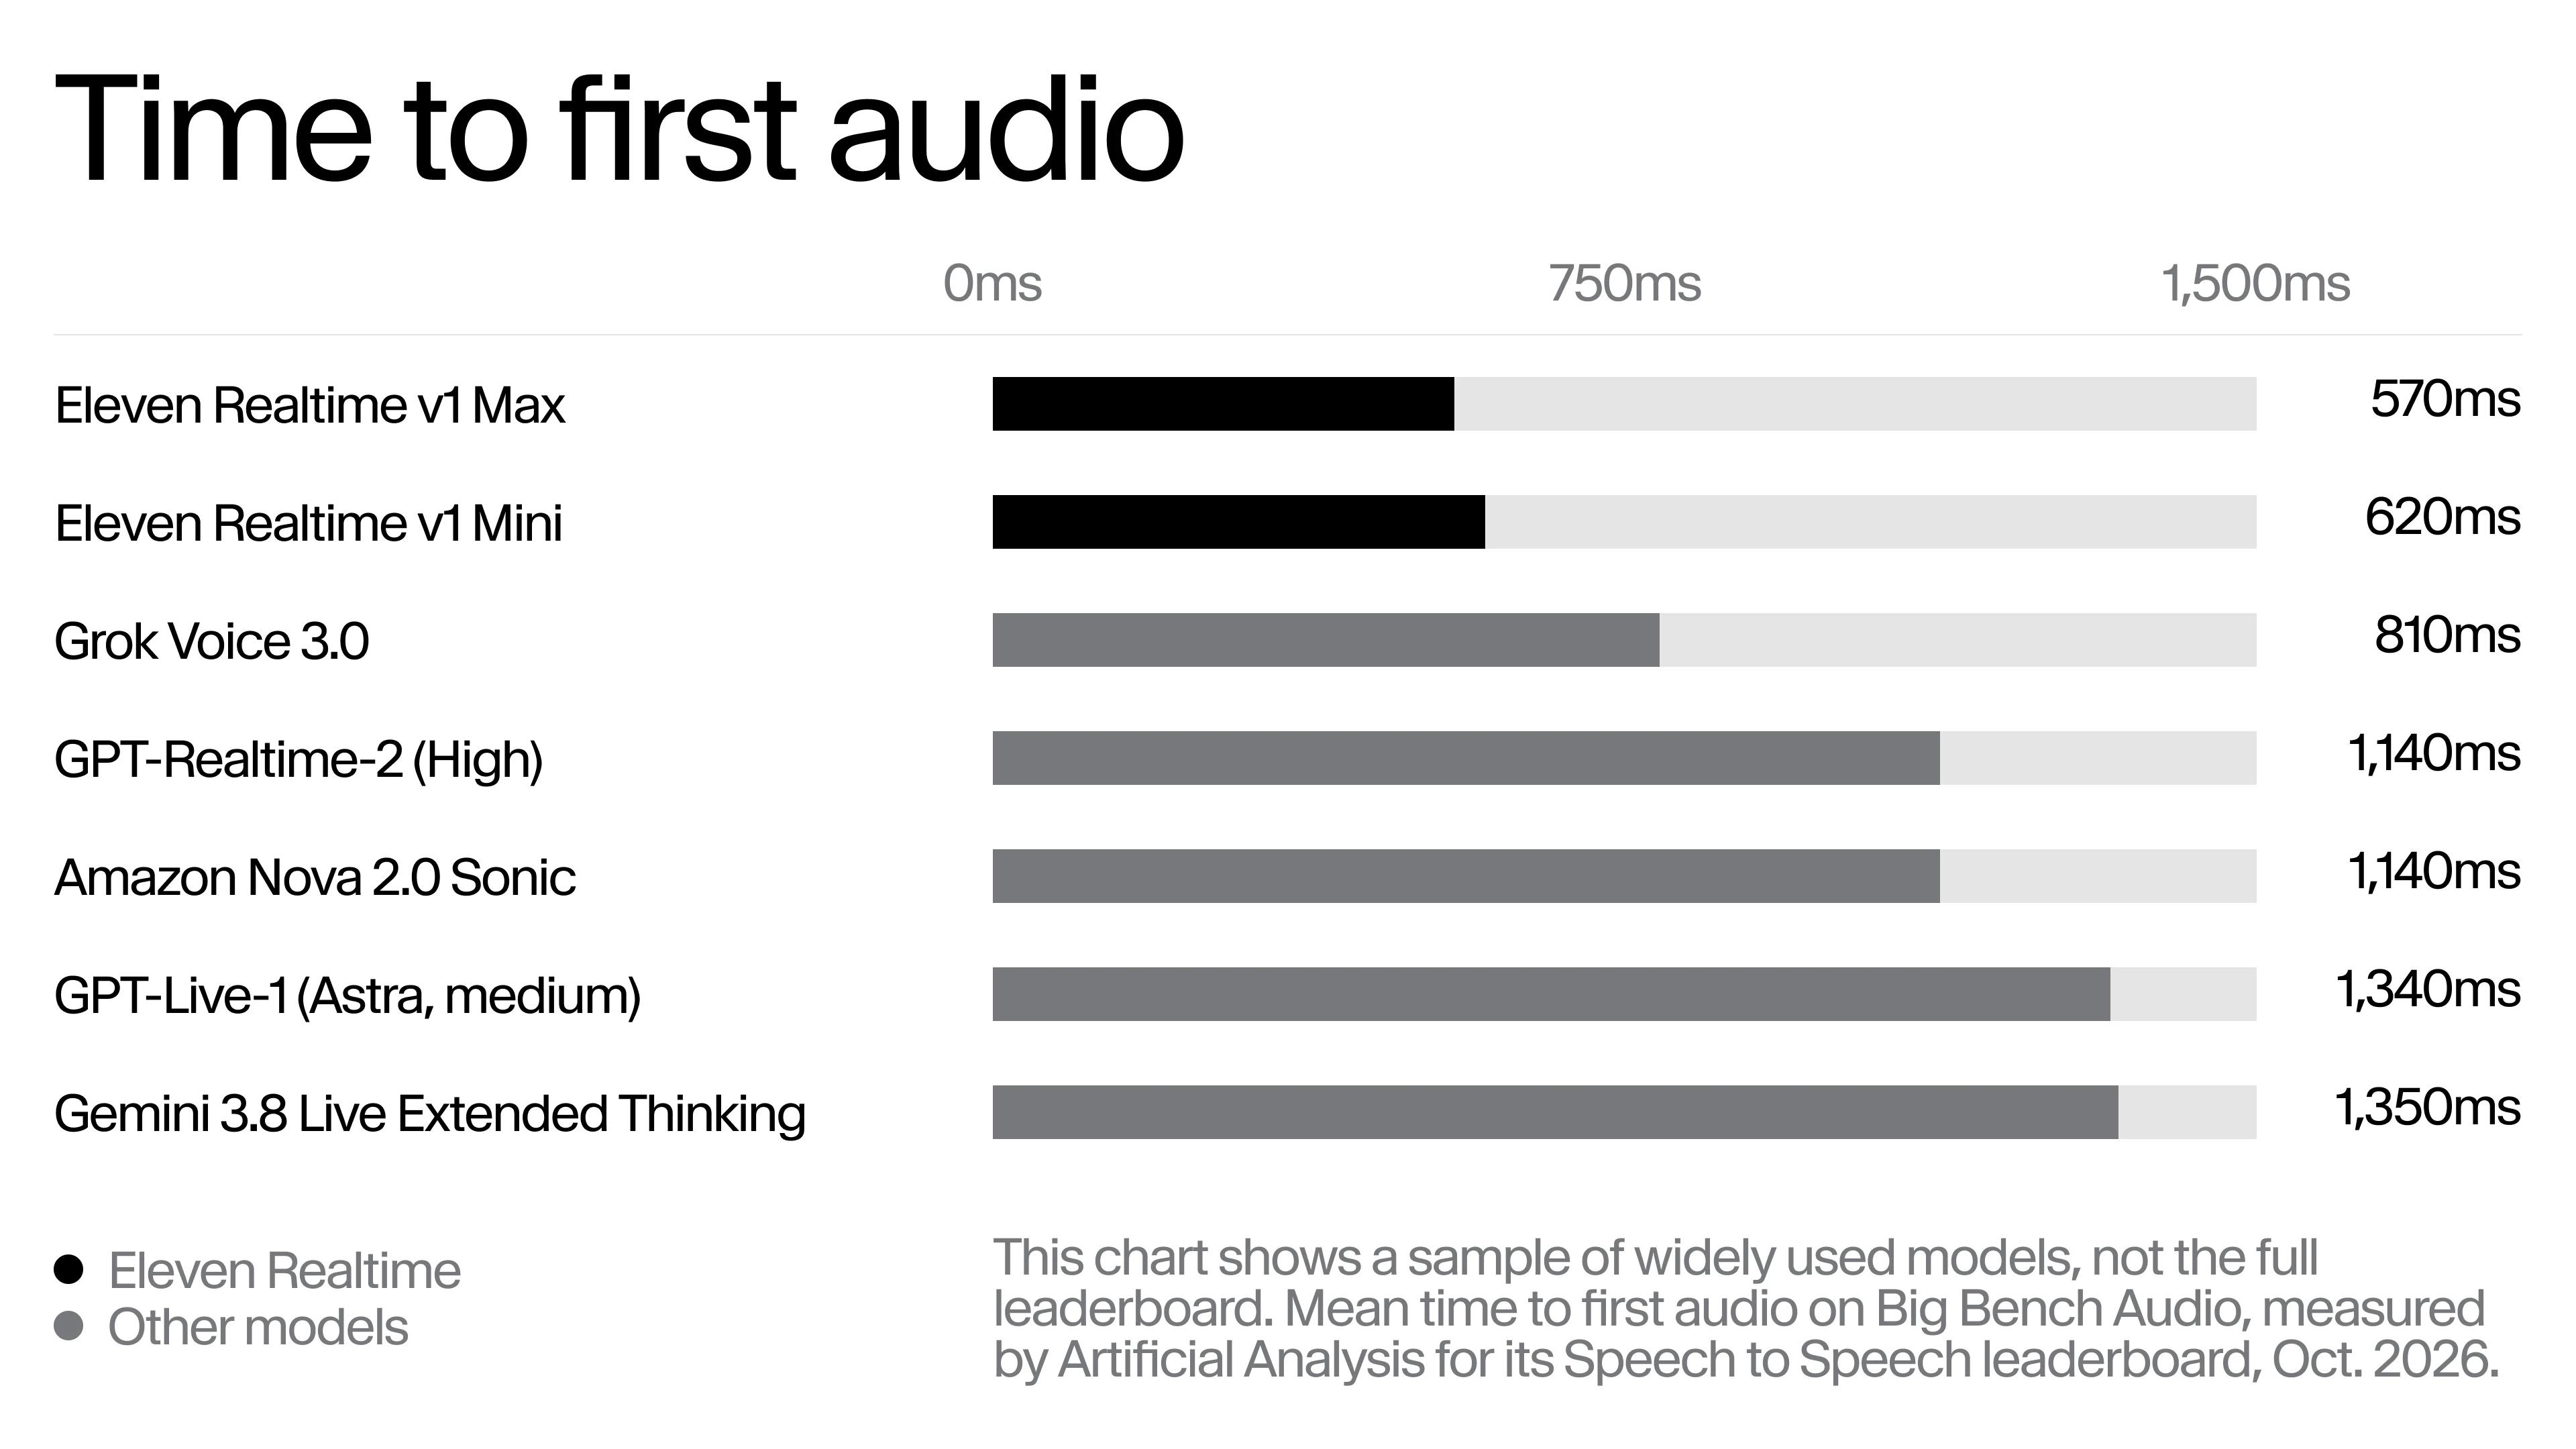
Tempo medio al primo audio | 0,62 s | 0,57 s |
Full-Duplex-Bench (pause, turni, interruzioni) | 95,8% | 94,1% |
Speech Agent Arena (preferenza, Elo) | 988 | 998 |
Compiti con strumenti riusciti | 60,3% | 87,1% |
Eleven Realtime v1 Mini e v1 Max
Risultati nei test valutati da Artificial Analysis, in percentuale, più alto è meglio
- v1 Mini
- v1 Max
Fonte: Artificial Analysis per ElevenLabs, ottobre 2026
Il dato che separa davvero i due modelli è l'ultimo: con gli strumenti Max porta a termine l'87,1% dei compiti, Mini il 60,3%. Per questo ElevenLabs consiglia Max quando l'agente deve chiamare molti strumenti, per esempio leggere un gestionale o fissare un appuntamento.
Di solito precisione e velocità sono un compromesso: i modelli che rispondono meglio sono i più lenti. Nel grafico di Artificial Analysis che mette insieme le due misure, tra i modelli che rispondono in meno di 3 secondi, v1 Max sta sulla frontiera, cioè nessun altro modello è insieme più preciso e più veloce.
Prezzi#
Voce di costo | v1 Mini | v1 Max |
|---|---|---|
Audio collegato | 0,08 $ al minuto | 0,08 $ al minuto |
Oltre il limite di chiamate contemporanee | 0,16 $ al minuto | 0,16 $ al minuto |
Token in ingresso, per milione | 0,20 $ | 1,80 $ |
Token in uscita, per milione | 6,00 $ | 9,00 $ |
Prezzi in dollari dal listino API di ElevenLabs, tasse escluse. Un agente Realtime paga la tariffa al minuto di ElevenAgents più i token. Quanti token servono in un minuto dipende dalla conversazione, quindi il costo reale non si legge direttamente dal listino.
Il listino però indica quanti minuti sono compresi in ogni piano, «in base a un uso tipico dei token». Dividendo il prezzo del piano per quei minuti si ottiene una stima del costo pratico: circa 0,084 $ al minuto con Mini (piano Pro: 99 $ per circa 1.179 minuti) e circa 0,102 $ al minuto con Max (99 $ per circa 971 minuti). È un calcolo fatto sulle cifre del listino, non un prezzo dichiarato da ElevenLabs.
Piano | Prezzo al mese | Minuti stimati con Mini | Minuti stimati con Max |
|---|---|---|---|
Free | 0 $ | circa 14 | circa 12 |
Starter | 6 $ | circa 71 | circa 59 |
Creator | 22 $ | circa 262 | circa 216 |
Pro | 99 $ | circa 1.179 | circa 971 |
Scale | 299 $ | circa 3.562 | circa 2.934 |
Business | 990 $ | circa 11.794 | circa 9.714 |
Come si usa#
Ci sono due strade:
Dentro ElevenAgents (la strada consigliata da ElevenLabs). Si crea o si apre un agente, si sceglie «Voice mode: Realtime» e poi il modello. Si hanno subito i canali telefono, web, WhatsApp e contact center, i flussi di lavoro, la base di conoscenza, i guardrail, i test e il monitoraggio.
Con la Realtime API, compatibile con quella di OpenAI. Chi ha già un'integrazione con la Realtime API di OpenAI cambia l'indirizzo, wss://api.elevenlabs.io/v1/convai/realtime, e il nome del modello. La connessione è solo via WebSocket, non WebRTC, ed è separata da ElevenAgents: canali e base di conoscenza vanno costruiti a parte.
Cosa cambia in pratica#
Un esempio aiuta a dare le proporzioni. Una piccola azienda con 15 chiamate al giorno da 3 minuti per 20 giorni arriva a 900 minuti al mese. Con Max e il costo pratico stimato di 0,102 $ al minuto, sono circa 92 $ al mese, esclusi numero di telefono, collegamento SIP o Twilio e tasse. È un esempio costruito sulle stime del listino, non un caso reale.
Tre cose da decidere prima di partire:
Mini o Max. Se l'agente deve solo conversare e raccogliere informazioni, Mini costa meno sui token. Se deve leggere sistemi e prenotare, i numeri sugli strumenti spingono verso Max.
Dove stanno i dati. La residenza dei dati in UE è disponibile per entrambi; la modalità Zero Retention e la conformità HIPAA solo per Max.
Trasparenza. Dal 2 agosto 2026 l'articolo 50 dell'AI Act chiede che chi interagisce con un sistema di AI ne sia informato. Non è una consulenza legale: per i casi concreti serve un professionista.
Se state valutando un agente al telefono, partite dal confronto Agenti vocali AI per il centralino e dalla pagina sui centralini AI.
Domande frequenti#
Che differenza c'è tra Eleven Realtime v1 Mini e v1 Max?
Mini è pensato per conversazioni naturali a basso costo, come assistenti e tutor, ed è il modello predefinito. Max ragiona prima di rispondere ed è pensato per assistenza clienti e flussi in più passaggi: con gli strumenti completa l'87,1% dei compiti contro il 60,3% di Mini.
Eleven Realtime parla italiano?
Sì. I modelli supportano oltre 90 lingue, la stessa lista di Eleven v4, che comprende l'italiano. ElevenLabs non pubblica però risultati per singola lingua.
Quanto costa?
0,08 $ al minuto di audio collegato, più i token: Mini 0,20 $ per milione in ingresso e 6 $ in uscita, Max 1,80 $ e 9 $. Sulle stime del listino il costo pratico è circa 0,084 $ al minuto con Mini e 0,102 $ con Max, tasse escluse.
È un modello unico o una catena di modelli?
Si usa come un modello unico, ma la documentazione di ElevenLabs spiega che dentro v1 Mini e v1 Max c'è un'architettura a cascata ottimizzata da un capo all'altro, con modelli interni non pubblici.
Funziona con il codice scritto per la Realtime API di OpenAI?
Sì, la Realtime API di ElevenLabs è compatibile: basta cambiare endpoint e nome del modello. La connessione è solo via WebSocket ed è separata da ElevenAgents.
I dati possono restare in Europa?
La residenza dei dati in UE è disponibile sia per Mini sia per Max. La modalità Zero Retention e la conformità HIPAA sono disponibili solo con Max, negli Stati Uniti e in UE.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.ElevenLabs, Introducing Eleven Realtimeelevenlabs.io
Annuncio di Min Kim, modelli, numeri di Artificial Analysis, 20 ottobre 2026
- 2.Documentazione ElevenLabs, Realtime modelselevenlabs.io
Limiti, residenza dei dati, Zero Retention, rilascio graduale
- 3.Documentazione ElevenLabs, OpenAI Realtime API compatibilityelevenlabs.io
Compatibilità e architettura a cascata
- 4.
- 5.ElevenLabs, prezzi APIelevenlabs.io
Prezzi al minuto e a token, minuti stimati per piano, tasse escluse
- 6.
- 7.Commissione europea, AI Act Service Desk, articolo 50ai-act-service-desk.ec.europa.eu
Obblighi di trasparenza per i sistemi di AI
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.