Fonte primaria
Google DeepMind — Gemini 4 Argon: Built to solve your hardest problems
blog.google
Vittorio e Matteo
Il Narratore a due voci · 2 min 45 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Google DeepMind — Gemini 4 Argon: Built to solve your hardest problems.
Perché se ne parla#
Il 30 settembre 2026 Google ha annunciato Gemini 4 Argon, il suo nuovo modello di frontiera, inizialmente disponibile per un gruppo ristretto di difensori informatici fidati attraverso il programma Fairwind. Il 13 ottobre 2026 il modello è diventato accessibile a tutti: sviluppatori e aziende lo usano via API, mentre gli abbonati Google AI Ultra e Pro lo trovano nell'app Gemini e in AI Mode di Search.
Google lo presenta come modello pensato per problemi complessi e di lunga durata, che richiedono ragionamento su più passaggi in ambiti come codice, lavoro professionale (finanza e legale), cybersicurezza e scienza. I risultati citati nell'annuncio sono dichiarati dal produttore: tra questi, il primo posto nel Vals Index, un indice che misura le prestazioni in settori economici come finanza, codice, legale e fiscale, e il punteggio di 87% nel benchmark ERQA sul ragionamento fisico e spaziale.
Il tema conta soprattutto per chi lavora con software e dati. Google indica un prezzo introduttivo di 2 dollari per milione di token in input e 10 dollari per milione in output, e afferma che il modello può individuare, validare e correggere vulnerabilità software in modo autonomo. Sono affermazioni del fornitore, che non hanno ancora una verifica indipendente nelle fonti disponibili.
*Questo articolo è stato scritto con l'aiuto dell'intelligenza artificiale.*
Ingegneria e lavoro aziendale#
Ingegneria del software#
Secondo Google, Argon è stato usato su progetti reali:
Chrome: refactoring di una cartella legacy di circa 6 milioni di righe su una base da 40 milioni, in settimane invece che in mesi.
ADK: -40% di tempo di preparazione delle sessioni lunghe e import a freddo 21% più veloci.
xTB: fino a 2,3x più veloce nella previsione delle strutture molecolari.
Gemma: accelerazione end-to-end di 2,85x su A100 con vLLM.
Lavoro aziendale#
Argon è primo nel Vals Index, che misura le prestazioni in finanza, programmazione, legale e fiscale. Su DeepSWE v1.1 ottiene il 77,9% e su AutomationBench il 51,3%.
Glossario#
Refactoring: riscrittura del codice per migliorarne la struttura, senza cambiarne il comportamento.
Codebase legacy: codice vecchio, ancora in uso ma difficile da modificare.
Import a freddo: caricamento dei moduli software all'avvio.
Token: unità di testo che il modello legge e produce.
Inferenza: la fase in cui il modello genera le risposte.
Benchmark: test standard per confrontare i modelli.
Ricerca, cyber e robotica#
Calcolo quantistico e fusione#
Argon ha trasformato una versione interna di AlphaQubit, decodificatore di errori quantistici basato sul machine learning, in un unico kernel hardware, raddoppiandone quasi la velocità. Sulla fusione ha contribuito a trovare controesempi alla congettura di Grad, ipotesi del 1967 sulle macchine stellarator, con il professor Matt Landreman dell'Università del Maryland.
Malattie rare ed enzimi#
Su valutazioni private di Gamow Labs, Argon ha ottenuto il 57% su RareBench e il 52,2% su LabBench, dati dichiarati dal produttore. Per gli enzimi ha proposto cinque progetti, confermati in laboratorio.
Cybersicurezza e robotica#
Nel programma Fairwind, Argon cerca vulnerabilità, anche quelle sconosciute al produttore. Nel benchmark ERQA, che misura il ragionamento spaziale, ottiene l'87%, secondo Google. Con il robot Apollo di Apptronik, dopo aver appreso il gesto da un video, centra sette tiri consecutivi.
Google offre a 10.000 scienziati l'accesso gratuito per 6 mesi alla fascia d'uso più alta di Google Antigravity, con selezione.
Kernel hardware: codice ottimizzato per girare direttamente sul chip.
Stellarator: macchina per la fusione con campi magnetici tridimensionali complessi.
Zero-day: vulnerabilità non ancora nota al produttore, quindi senza correzione.
Sicurezza del modello#
Le difese dichiarate da Google#
Secondo Google, il sistema di protezione a più livelli ha ridotto le violazioni su un test avversariale di quasi due volte rispetto ai modelli Gemini precedenti. Nel red teaming esterno sul fronte biologico, i tester sono riusciti a sbloccare meno dell'1% dei sotto-compiti testati.
Nei benchmark di coding, dove i modelli non hanno incentivi a fermarsi, i tentativi di scorciatoia sono scesi al 2%. Un monitor automatico legge ragionamento e azioni dell'agente per bloccare aggiramenti in tempo reale. Nel benchmark Gray Swan sulle iniezioni indirette di prompt, il successo degli attacchi si ferma allo 0,7% su 15 tentativi adattivi.
Cosa non è ancora verificato#
Tutte queste cifre sono affermazioni di Google, non valutazioni indipendenti. Google dice di aver coinvolto partner terzi in alcune misurazioni, ma le fonti non dicono quali né con quali esiti pubblici.
La versione senza guardrail cyber è riservata ai difensori del programma Fairwind e ai team interni di Google. Il rilascio generale avverrà solo dopo ulteriori iterazioni sulle protezioni.
Come accedere e prezzi#
Canali di accesso#
Gemini 4 Argon è disponibile da oggi a livello globale su canali diversi a seconda del profilo. Sviluppatori e aziende lo usano tramite l'API in AI Studio e nella piattaforma Gemini (fonte). Gli abbonati Google AI Ultra possono provarlo in Google Antigravity, mentre gli abbonati Ultra e Pro lo trovano nell'app Gemini e in AI Mode in Search.
Prezzi introduttivi#
Il lancio prevede un prezzo introduttivo di 2 dollari per milione di token in input e 10 dollari per milione di token in output. La fonte presenta questi valori come introduttivi e non indica per quanto tempo resteranno validi, quindi conviene verificarli nella documentazione ufficiale prima di pianificare un progetto (dettagli).
I due video seguenti sono dimostrazioni prodotte da Google, non una verifica indipendente delle capacità del modello.
Il modello in cifre#
token in output
dai 64K della versione precedente
DeepSWE v1.1
ingegneria del software su compiti lunghi
LVBench
comprensione di video lunghi
Vals Index
impatto economico su finanza, coding, legale e fiscale
Secondo Google, il limite di output di Gemini 4 Argon sale a 1M di token, dai 64K precedenti, e l'azienda lo definisce il più alto del settore: lo spazio serve a sviluppare ragionamenti lunghi in un'unica traiettoria. Il 77,9% su DeepSWE v1.1 e il primo posto nel Vals Index sono risultati che Google attribuisce al modello in ambito software e lavoro di conoscenza. Il 91,7% su LVBench, che misura la comprensione di video lunghi, è il dato più specifico di questa sezione, perché riguarda l'analisi visiva e non il testo. Si tratta di dati dichiarati dal produttore; i dettagli sono in Gemini 4 Argon: our next era of frontier intelligence.
CWE-bench: correggere le vulnerabilità#
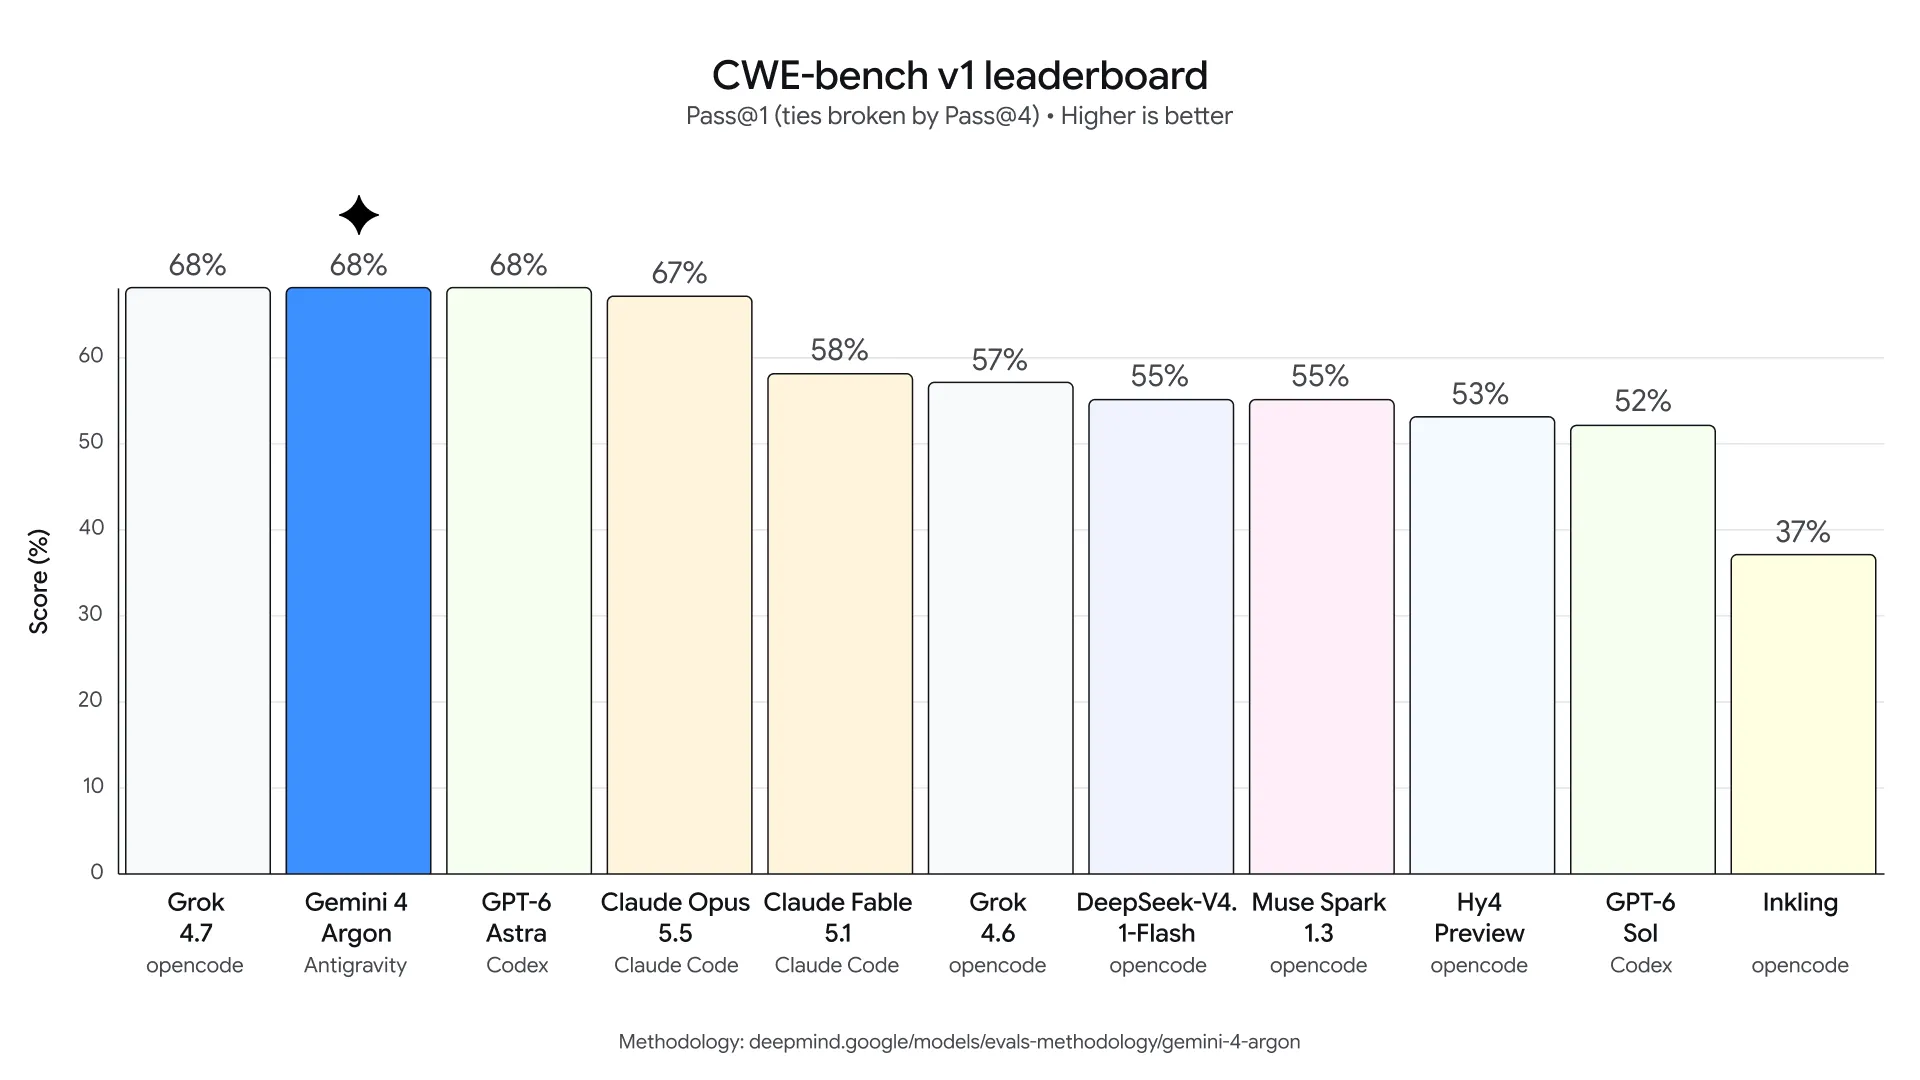
Il grafico mostra il punteggio su CWE-bench v1, il test che misura la capacità di un modello di correggere vulnerabilità di sicurezza. La metrica è il Pass@1, con i pari merito risolti dal Pass@4. Si tratta di un benchmark dichiarato da Google, quindi i punteggi vanno letti come dati forniti dal produttore.
Secondo Google, Gemini 4 Argon pareggia il primo posto con Grok 4.7 e GPT-6 Astra, tutti fermi al 68%. Seguono Claude Opus 5.5 al 67% e Claude Fable 5.1 al 58%. In fondo alla classifica c'è Inkling con il 37%. Il testo ufficiale è disponibile qui.
CWE-bench v1 leaderboard
Pass@1 (parità spezzata da Pass@4): più alto è meglio
Fonte: Google DeepMind, valori letti dal grafico ufficiale
Scoprire vulnerabilità e test di penetrazione#
Nel grafico ufficiale di Google, Gemini 4 Argon è confrontato con Gemini 3.8 Flash Cyber su due test di scoperta delle vulnerabilità, con punteggi Pass@1 in cui valori più alti indicano prestazioni migliori. Nel primo test, che analizza il codice sorgente di programmi scritti in 20 linguaggi, Argon raggiunge 85,8% contro 71% del modello precedente. Nel secondo, il Wiz Penetration Test Benchmark, il modello deve sfruttare vulnerabilità di sistemi web senza accesso al codice: qui Argon ottiene 70,9% contro 58,2%. La metodologia è indicata nella pagina di Google DeepMind.
Scoperta di vulnerabilità e test di penetrazione
Punteggio Pass@1, valori più alti = migliori
- Gemini 4 Argon
- Gemini 3.8 Flash Cyber
Fonte: Google DeepMind, valori letti dal grafico ufficiale
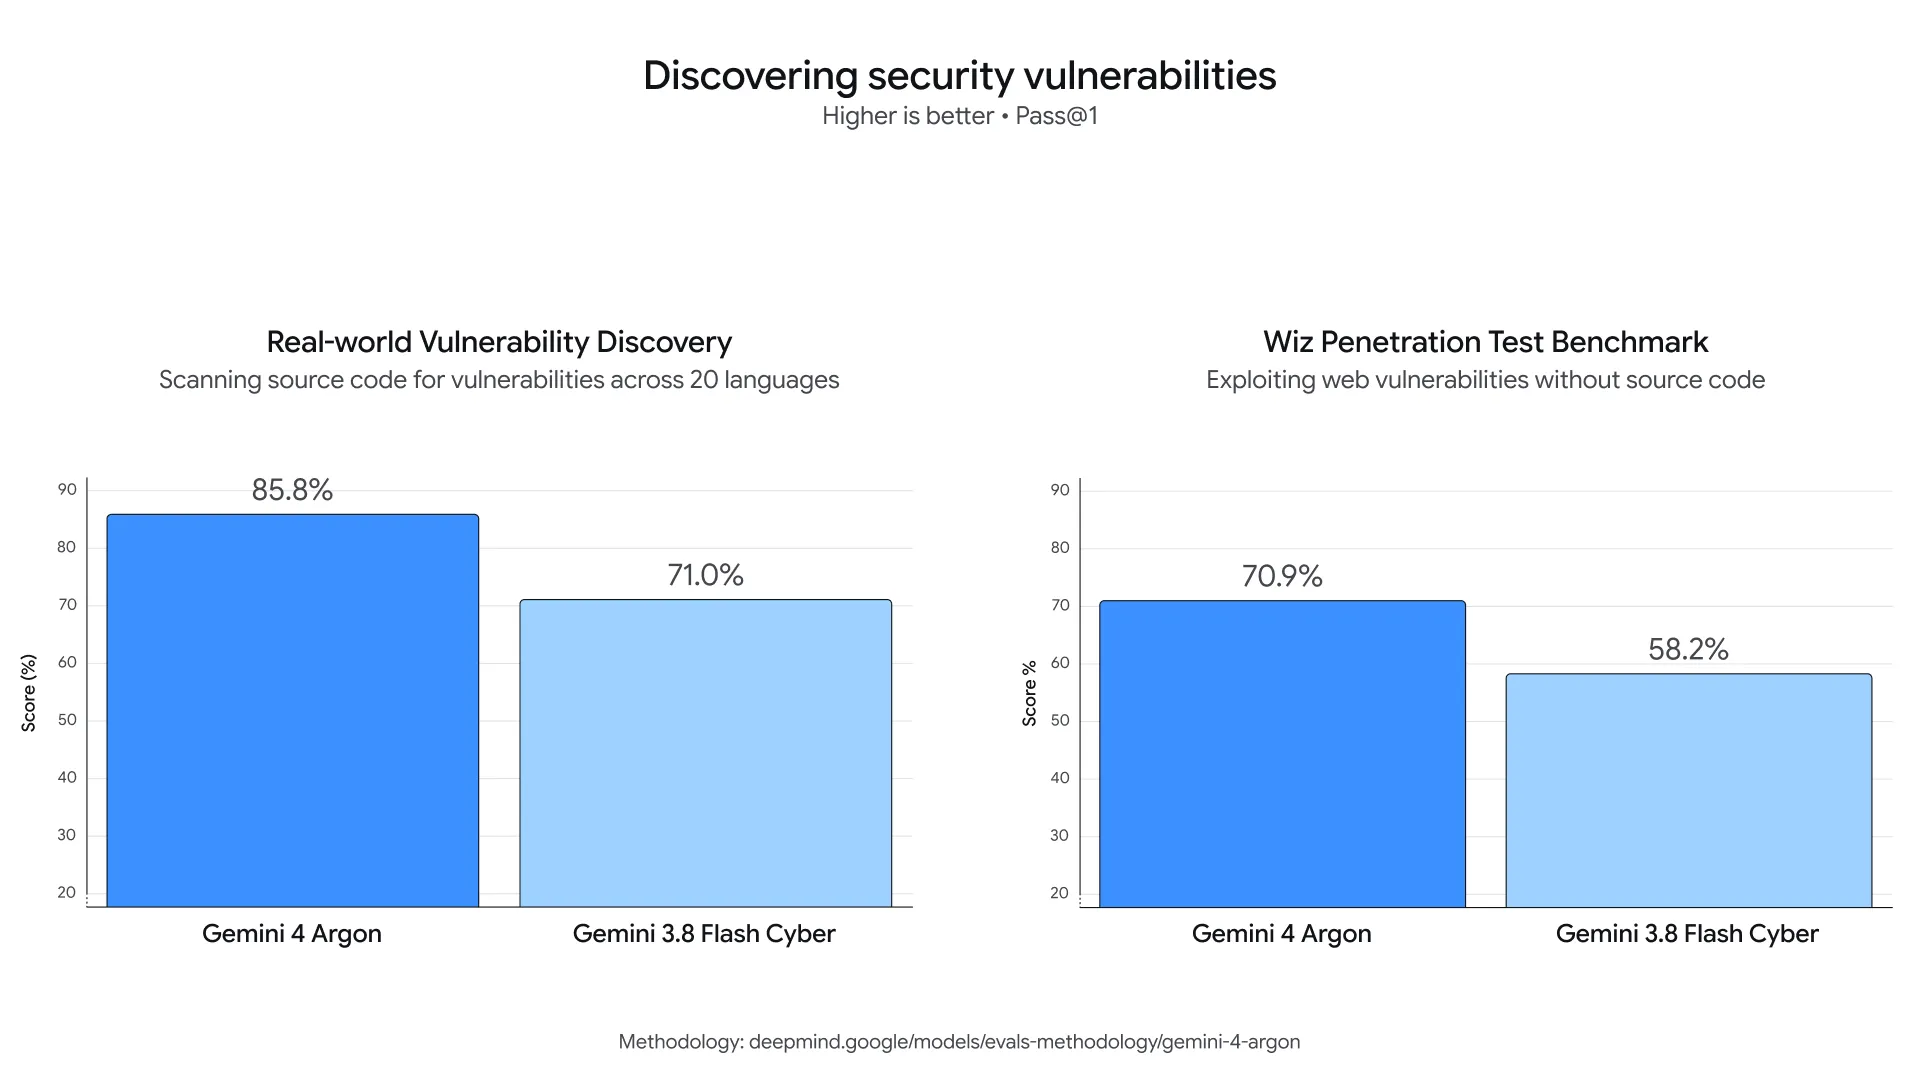
Entrambi i test sono interni: il primo è di Google, il secondo è il benchmark black-box di Wiz. Non si tratta di valutazioni indipendenti, quindi i numeri vanno letti come dichiarazioni dei produttori.
Iniezioni di prompt: il test Gray Swan IPI#
Google usa il benchmark Gray Swan Indirect Prompt Injection per misurare la resistenza alle iniezioni di prompt indirette, cioè istruzioni malevole nascoste in documenti o pagine web che cercano di dirottare il comportamento del modello. La metrica è la percentuale di attacchi riusciti su 15 tentativi adattivi: più il valore è basso, più il modello resiste. Secondo il produttore, Argon è in testa a questo test, un risultato che Google presenta come proprio.
Gray Swan IPI
Attacchi riusciti su 15 tentativi, più basso è meglio
Fonte: Google DeepMind, valori letti dal grafico ufficiale
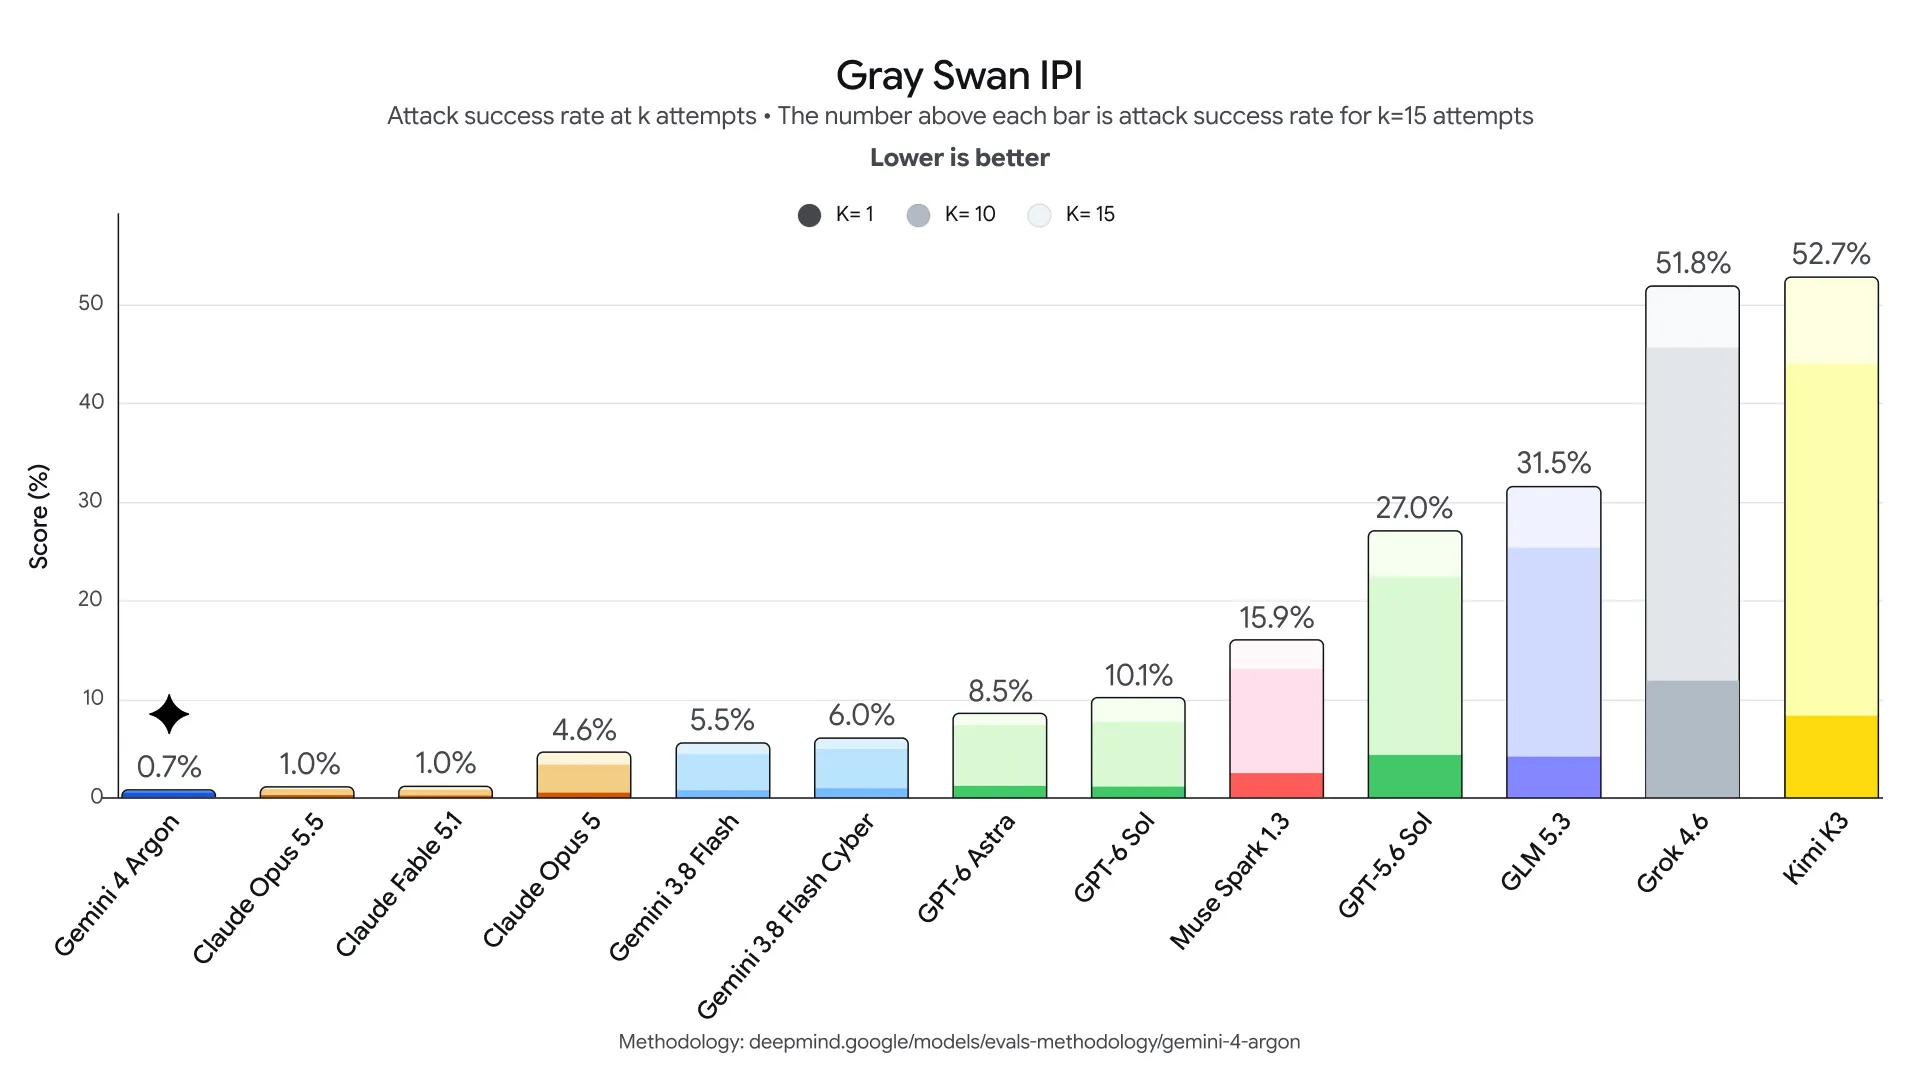
Il grafico ufficiale mostra Gemini 4 Argon allo 0,7%, seguito da Claude Opus 5.5 e Claude Fable 5.1 all'1,0%, poi Gemini 3.8 Flash al 5,5% e GPT-6 Astra all'8,5%. Agli estremi opposti Grok 4.6 arriva al 51,8% e Kimi K3 al 52,7%. Chi usa agenti che leggono email o pagine web deve considerare che questo test misura proprio questo rischio.
AlphaQubit: correggere gli errori quantistici#
Il paper pubblicato su Nature il 20 novembre 2024 presenta AlphaQubit, un decoder basato su rete neurale. Il decoder usa i controlli di coerenza sui gruppi di qubit per stabilire quali errori si sono verificati, così che possano essere corretti.
Qubit: unità di informazione quantistica, fragile e sensibile a disturbi come calore e vibrazioni.
Decoder: sistema che, a partire dai controlli di coerenza, individua gli errori avvenuti.
Risultati su 49 qubit#
Addestrato con simulazioni e rifinito su dati reali del processore Sycamore, AlphaQubit ha lavorato su 49 qubit. Secondo Google DeepMind, nei più grandi esperimenti su Sycamore commette il 6% di errori in meno rispetto ai metodi a reti tensoriali e il 30% in meno rispetto alla correlated matching, un decoder abbastanza veloce da scalare.
Il limite della velocità#
Su un processore superconduttivo veloce, ogni controllo di coerenza viene misurato un milione di volte al secondo. Il paper ammette che AlphaQubit è ancora troppo lento per correggere gli errori in tempo reale su questo tipo di processore.
Il contributo di Argon#
Argon ha tradotto una versione interna del decoder in un unico kernel hardware, con un throughput di inferenza quasi raddoppiato. Per voi il punto chiave è che la correzione degli errori resta il collo di bottiglia, e la velocità di esecuzione è il terreno su cui si lavora.
Quadro di sicurezza della frontiera#
Che cos'è il Frontier Safety Framework#
Il Frontier Safety Framework (FSF) è il documento con cui Google DeepMind descrive come individua e riduce i rischi gravi dei modelli più avanzati. La sua terza versione è stata pubblicata il 22 settembre 2025. Il testo completo e aggiornato è disponibile nel FSF.
Le novità principali#
Il framework introduce una soglia dedicata alla manipolazione dannosa, riferita a modelli che potrebbero cambiare in modo sistematico convinzioni e comportamenti delle persone. Aggiunge inoltre procedure per i modelli che potrebbero accelerare la ricerca sull'AI, includendo le distribuzioni interne su larga scala, prima coperte solo dai lanci esterni.
Il 17 aprile 2026 arriva la versione FSF 3.1, con i Tracked Capability Levels, introdotti per segnalare prima rischi meno estremi.
Glossario essenziale#
CCL (Critical Capability Level): livello di capacità oltre il quale, senza misure di mitigazione, un modello può comportare un rischio elevato di danni gravi.
TCL (Tracked Capability Level): livello monitorato per individuare in anticipo rischi meno estremi.
Disallineamento (misalignment): situazione in cui un modello potrebbe ostacolare la capacità di chi lo gestisce di dirigerlo, modificarlo o spegnerlo.
Safety case review: verifica che documenta come i rischi siano stati ridotti a livelli gestibili prima del lancio.
Come leggere questi numeri#
I numeri dell'articolo provengono da misurazioni fatte da Google o da partner come Wiz, Gray Swan, Vals, Zapier e Harvey. Ogni benchmark misura un compito diverso: DeepSWE v1.1 l'ingegneria del software su compiti lunghi, AutomationBench l'esecuzione di processi aziendali, LVBench la comprensione di video lunghi, CWE-bench v1 la correzione di vulnerabilità. Non sommate né fate la media di punteggi di benchmark diversi.
Le barre dei grafici ufficiali sono state lette e confermate da due letture indipendenti. Su CWE-bench alcuni pareggi dipendono dal criterio Pass@4, quindi un primo posto condiviso va letto con questa cautela.
I benchmark non dicono quanto il modello sia affidabile nei vostri processi, né come si comporti con i vostri dati. Il materiale di partenza non riporta un link alla metodologia ufficiale dei test: per verificare condizioni e criteri, serve consultare la documentazione pubblicata da Google.
Cosa significa per un’azienda#
Limite di 1 milione di token: se il vostro lavoro riguarda codice o documenti lunghi, verificate che il contesto rientri nel limite unificato di input e output di 1 milione di token dell'API Gemini. Leggete anche il nuovo protocollo di continuazione nella documentazione.
Calcolo dei costi: il prezzo introduttivo è di 2 dollari per milione di token di input e 10 dollari per milione di output. Esempio: un milione di token di input costa 2 dollari; se quegli stessi token sono in cache, con lo sconto del 95% costano 10 centesimi di dollaro.
Cybersicurezza: se svolgete attività di difesa informatica, richiedete l'accesso tramite il Fairwind Program, a cui Google sta aggiungendo centinaia di partner. Per i difensori l'accesso avviene senza protezioni cyber, su base progressiva.
Benchmark come indicazione: risultati come il primo posto nel Vals Index o il 77,9% su DeepSWE v1.1 sono dati dichiarati dal produttore. Prima di scegliere il modello, provatelo sui vostri compiti reali.
Verifica umana sugli agenti: Google afferma di aver addestrato Argon a chiedere conferma umana prima di passaggi irreversibili, e di aver ridotto al 2% i tentativi di scorciatoia nei benchmark di programmazione. Mantenete comunque una revisione umana dei risultati degli agenti.
Domande frequenti#
Chi può usare Argon oggi?
Gli sviluppatori e le aziende possono usarlo via API in AI Studio e nella piattaforma Gemini. Gli abbonati Google AI Ultra possono provarlo in Google Antigravity, mentre gli abbonati Google AI Ultra e Pro lo trovano nell'app Gemini e in AI Mode in Search. La versione senza guardrail cyber è riservata ai partner del Fairwind Program, a cui potete candidarvi.
Quanto costa?
Il prezzo di lancio è di 2 dollari per milione di token di input e 10 dollari per milione di token di output. I token di input in cache costano il 95% in meno. Il prezzo è introduttivo, quindi conviene verificarlo nella documentazione prima di pianificare un budget.
Cosa significa il limite di 1 milione di token?
Argon ha un limite unificato di 1 milione di token tra input e output tramite la Gemini API. Il limite di output è stato portato a 1 milione, dai precedenti 64K token. Per le attività più lunghe, la documentazione descrive il nuovo continuation protocol, che vi conviene leggere prima di configurare il progetto.
Dove trovo la model card?
L'annuncio di Google rimanda alla Gemini 4 Argon Model Card per le informazioni complete sul modello, comprese le sue misure di sicurezza. La documentazione per sviluppatori e aziende descrive invece il setup.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 7/10 | Su CWE-bench v1 Argon ottiene 68%, a pari merito con Grok 4.7 e GPT-6 Astra, ma è un dato fornito dal produttore e letto da un grafico. |
Prezzo e disponibilità | 6/10 | Il prezzo è di $2 per million input tokens e $10 per million output tokens, ma è introduttivo; le fonti non indicano il prezzo successivo. |
Sicurezza contro le iniezioni di prompt | 7/10 | Nel test Gray Swan IPI Argon registra 0.7% di attacchi riusciti su 15 tentativi adattivi, mentre Claude Opus 5.5 e Claude Fable 5.1 risultano a 1 nel grafico ufficiale. |
Trasparenza e verifica indipendente | 5/10 | La maggior parte dei benchmark è riportata da Google, mentre gli eval di Gamow Labs sono privati e non verificabili dalle fonti. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Gemini 4 Argon è un modello di Google disponibile via API con prezzo introduttivo, forte sulla sicurezza informatica e sulle prestazioni auto-dichiarate.
Per chi deve decidere, i dati ufficiali indicano prestazioni competitive su codice e cybersicurezza e un limite di output di 1M tokens. I risultati più forti provengono però dal produttore e vanno verificati su casi d'uso propri. Il costo a regime non è indicato nelle fonti e andrebbe chiarito prima di un'adozione in azienda.
Punti di forza
- Il limite di output è di 1M tokens, contro 64K tokens della versione precedente.
- Google dichiara che Argon è al primo posto sul Vals Index, che misura finanza, codice, legale e fiscale.
- Nel test Gray Swan IPI la percentuale di attacchi riusciti è la più bassa del grafico ufficiale, con 0.7%.
- Google riferisce che le violazioni nei test avversari sono diminuite di nearly 2-fold rispetto ai modelli Gemini precedenti.
Limiti
- Il prezzo di $2 per million input tokens è introduttivo e le fonti non indicano il prezzo successivo.
- Le fonti non indicano licenza né disponibilità dei pesi del modello.
- Molti risultati sono auto-dichiarati da Google e i valori dei grafici sono letti, non pubblicati come tabelle.
- Argon senza cyber guardrails è disponibile solo tramite il programma Fairwind per difensori fidati.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
4- 1.Google DeepMind — Gemini 4 Argon: Built to solve your hardest problemsblog.google
Annuncio ufficiale da cui nasce l’articolo.
- 2.Google DeepMind — Gemini 4 Argon: our next era of frontier intelligenceblog.google
Documento ufficiale collegato all’annuncio.
- 3.Google DeepMind — AlphaQubit tackles one of quantum computing’s biggest challengesblog.google
Documento ufficiale collegato all’annuncio.
- 4.Google DeepMind — Google DeepMind strengthens the Frontier Safety Frameworkdeepmind.google
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.