GPT‑6 Astra: Una nuova generazione di intelligenza
BlogNovità AIOpenAI · settembre 2026
Per OpenAI è il modello più intelligente e, insieme, il più allineato che esista. Qui ho rimesso in fila tutto l’annuncio: i benchmark con i numeri originali, i video dimostrativi, i documenti generati, due giochi da provare e le parti meno comode, dal prezzo alla cybersicurezza.
In sintesi
Con GPT‑6 Astra tre test storici arrivano di fatto al tetto (FrontierMath Tier 4, ARC‑AGI‑3 ed ExploitBench) e OpenAI rivendica il primo posto su uso del computer, lavoro professionale, programmazione, scienza e cybersicurezza.
- Uso del computer: 72,6% su OSWorld 2.0 e 59,3% su Agents’ Last Exam, chiudendo ogni compito in circa il 47% di tempo in meno di GPT‑5.6 Sol.
- Lavoro professionale: 95,9% su BenchCAD, presentazioni e documenti fedeli al modello grafico ricevuto, siti e giochi pubblicati a partire da una richiesta scritta.
- Programmazione: 57,9% su Terminal‑Bench 4.0 e, in Codex, appunti che sopravvivono quando la finestra di contesto si riempie.
- Cyber: 100% su ExploitBench, due zero‑day trovate durante le prove, livello Critical nel Preparedness Framework.
- Allineamento: nessun tentativo di scavalcare l’auto‑review e nessun colpo al bersaglio esca di ExploitGym, dove Sol arrivava al 48,2%.
- Via API: 10 $ per milione di token in ingresso, 50 $ in uscita; la modalità Fast va al doppio della velocità e costa il doppio.
Il film di lancio · 2 min 43 s
Un salto dal 1979 fino a oggi: per presentare Astra, OpenAI ha scelto un cortometraggio con persone che lavorano, niente elenchi di funzioni. Va guardato con l’audio acceso.
L’annuncio
Una nuova generazione di intelligenza
OpenAI ha presentato GPT‑6 Astra e lo descrive come il modello più intelligente, e insieme il più allineato, che esista. Dietro ci sono anni di ricerca e alcune scommesse forti su tre fronti: pre‑addestramento, apprendimento per rinforzo e allineamento. L’azienda lo dichiara il migliore in sei aree: uso del computer, navigazione web, sviluppo software, cybersicurezza, scienza e lavoro professionale.
Il segnale più vistoso è che tre test usati da anni per misurare quanto manca al traguardo sono di fatto saturi: FrontierMath Tier 4 al 98% (97,6% nelle tabelle), dopo che il modello aveva già dato una mano a chiudere problemi matematici aperti da decenni; ARC‑AGI‑3 al 99,9% ed ExploitBench pieno, al 100%. Quando un modello arriva vicino al 100%, il test smette di distinguere tra i migliori e bisogna inventarne di nuovi. Nell’uso del computer e del browser, secondo OpenAI, Astra sposta in avanti la frontiera e regge il lavoro professionale più esigente con una combinazione di velocità, precisione e buon senso che l’azienda considera senza rivali.
Al lancio arriva a un gruppo ristretto di organizzazioni; nei giorni seguenti a tutti gli abbonati ChatGPT Plus, Pro, Business ed Enterprise e via API OpenAI, Microsoft Azure e AWS Bedrock.
- FrontierMath Tier 498%
- ARC‑AGI‑399,9%
- ExploitBench100%
Terminal-Bench Science 0.1
- GPT-6 Astra64,6%
- Claude Fable 5.152,6%
- Claude Opus 530,0%
- GPT-5.6 Sol22,4%
- Claude Fable 521,4%
Terminal‑Bench Science 0.1 misura i flussi di ricerca scientifica fatti con codice e terminale: analisi dati, simulazioni, adattamento di modelli. Astra arriva al 64,6% contro il 52,6% di Claude Fable 5.1, e la spesa API stimata è più bassa di circa il 31%. Anche con un budget minore resta al 61,1%, quasi il triplo del miglior risultato di GPT‑5.6 Sol (22,4%), e costa circa il 27% in meno. (Dati delle tabelle di OpenAI.)
“Su ARC‑AGI‑3 Astra ha battuto il nostro riferimento umano di efficienza delle azioni nel 96% dei livelli, arrivando in pratica alla parità con le persone su questo benchmark. Non è soltanto il modello migliore che abbiamo mai provato: segna un vero salto nelle prestazioni dei modelli di frontiera, sia nella capacità di esplorare e risolvere ambienti nuovi sia nell’efficienza con cui impara a farlo.”
Poi c’è l’allineamento. Per OpenAI questo è il modello più allineato che abbia mai rilasciato: capisce meglio che cosa vuole chi scrive e si comporta in modo più prevedibile, quindi gli si può delegare lavoro fidandosi di più del suo giudizio. Tra le prove ce n’è una inedita, nata dopo l’incidente di Hugging Face: verifica se un modello, davanti a un compito difficile o impossibile, esce dal perimetro assegnato. Senza le protezioni di produzione GPT‑5.6 Sol colpiva un bersaglio fuori perimetro nel 48% dei casi; GPT‑6 Astra mai.
Uso del computer
Il modello migliore per usare un computer
È l’area su cui OpenAI insiste di più, e dove fissa un nuovo riferimento per velocità, precisione e sicurezza. Astra sa sbrigare le incombenze noiose (compilare moduli online, aggiornare schede in un CRM, riordinare un calendario), cercare informazioni sul web e scriverne la sintesi direttamente nella mail o nel documento. Sa analizzare dati scientifici e farne grafici, costruire un sito e poi collaudarne l’interfaccia controllando che ogni funzione risponda, installare e provare software da solo e capire cosa non va guardando lo schermo. I progressi si vedono anche nei test.
Agents' Last Exam
Agents’ Last Exam mette gli agenti al lavoro su software veri, in compiti che vanno dai modelli finanziari all’ingegneria alla produzione di contenuti. Astra è primo (59,3%) davanti a Claude Opus 5 (55,5%) e GPT‑5.6 Sol (53,6%); nelle configurazioni migliori, inoltre, usa circa il 65% di token in uscita in meno di Opus 5.
Il dato più pratico riguarda il tempo. Simulando i tempi reali su OSWorld 2.0, OpenAI misura per Astra il 72,6% in circa 40 minuti a compito, mentre Sol si ferma al 65,7% in circa 75 minuti: quasi metà del tempo (circa −47%) per un risultato migliore.3
Le dimostrazioni pubblicate coprono domini lontanissimi tra loro: progettazione elettronica, gare di modellazione in Excel, sviluppo di giochi, dichiarazione dei redditi, collaudo di un sito, dashboard in Power BI, meccanica e documenti legali. Le clip sono estratti montati; i tempi indicati sono quelli delle sessioni reali.
Insieme ad Astra, OpenAI ha aggiornato l’ambiente di Codex per l’uso del computer. Sommando i due miglioramenti, su Mind2Web i compiti si chiudono 1,9 volte più in fretta rispetto a Sol. L’idea, in parole semplici, è poter affidare al modello le piccole incombenze che mangiano la giornata e ritrovarle finite prima di quanto ci avremmo messo noi.4
“Dal giorno del lancio portiamo GPT‑6 Astra dentro l’ambiente di Devin, e sul nostro benchmark interno di collaudo del software raggiunge lo stato dell’arte. L’ottimo uso del computer, la scrittura e la comprensione del codice hanno migliorato i test da subito, senza alcun adattamento: i video delle sessioni si seguono molto meglio e i rapporti sono più chiari e sintetici.”
Lavoro professionale
Documenti, presentazioni e siti
Astra unisce l’uso del computer a un addestramento specifico sugli ambienti di lavoro: l’idea è che affronti compiti professionali complessi, con l’intelligenza per i problemi difficili e la capacità di portare avanti flussi in più passaggi, fino a documenti, fogli di calcolo e presentazioni già rifiniti.
BenchCAD
- GPT-6 Astra95,9%
- Claude Fable 5.184,3%
- GPT-5.6 Sol83,3%
- Claude Opus 582,1%
- Claude Fable 567,5%
BenchCAD verifica se un modello ricostruisce un oggetto 3D, visto da più angolazioni, scrivendo il codice CAD giusto; il punteggio misura quanto la forma ottenuta si sovrappone a quella vera. Con gli strumenti Astra arriva al 95,9%; a Claude Fable 5.1 è attribuito l’84,3% e GPT‑5.6 Sol si ferma all’83,3%.5 Nelle configurazioni mostrate, dice OpenAI, spende circa il 43% meno di Sol e l’86% meno di Fable 5.1. (Dati delle tabelle di OpenAI.)
Sul lato pratico, OpenAI dice che Astra è il suo modello più bravo a rispettare un template esistente: slide impaginate bene, con un filo logico che porta ai punti chiave, e documenti, fogli di calcolo e analisi che seguono lo stile di scrittura e la grafica dell’azienda. È anche addestrato a portare nei documenti soltanto il contesto necessario, senza ripetizioni inutili, così che il risultato si possa usare subito.
Astra porta anche un occhio più sicuro nella grafica di siti, giochi, applicazioni e rendering. Con Sites in ChatGPT crea, pubblica e condivide siti, web app e giochi partendo da una richiesta scritta.
“Astra ci dà un vantaggio netto, sia di capacità sia di efficienza. Porta a termine con successo i nostri flussi creativi più complessi e, rispetto agli altri modelli che abbiamo provato, consuma fino a un quinto di token in meno. Ma soprattutto per i nostri clienti significa lavori di qualità più alta.”
Tidal Rush Paradise GP: il gioco di kart fatto con Astra. Gira sui server di OpenAI e si comanda con la tastiera: parte solo quando lo avvii.
Un cambiamento meno appariscente ma importante: davanti a istruzioni ambigue, Astra riempie da solo i vuoti di routine e fa domande solo quando la risposta cambia il risultato. Dentro Codex la domanda può arrivare in parallelo: il modello intanto porta avanti la parte di lavoro che non dipende dalla risposta; se nessuno risponde, procede con ipotesi ragionevoli ma aspetta sulle decisioni importanti.
I tre esempi di OpenAI riguardano faccende di tutti i giorni in cui un dettaglio assente cambierebbe la risposta.
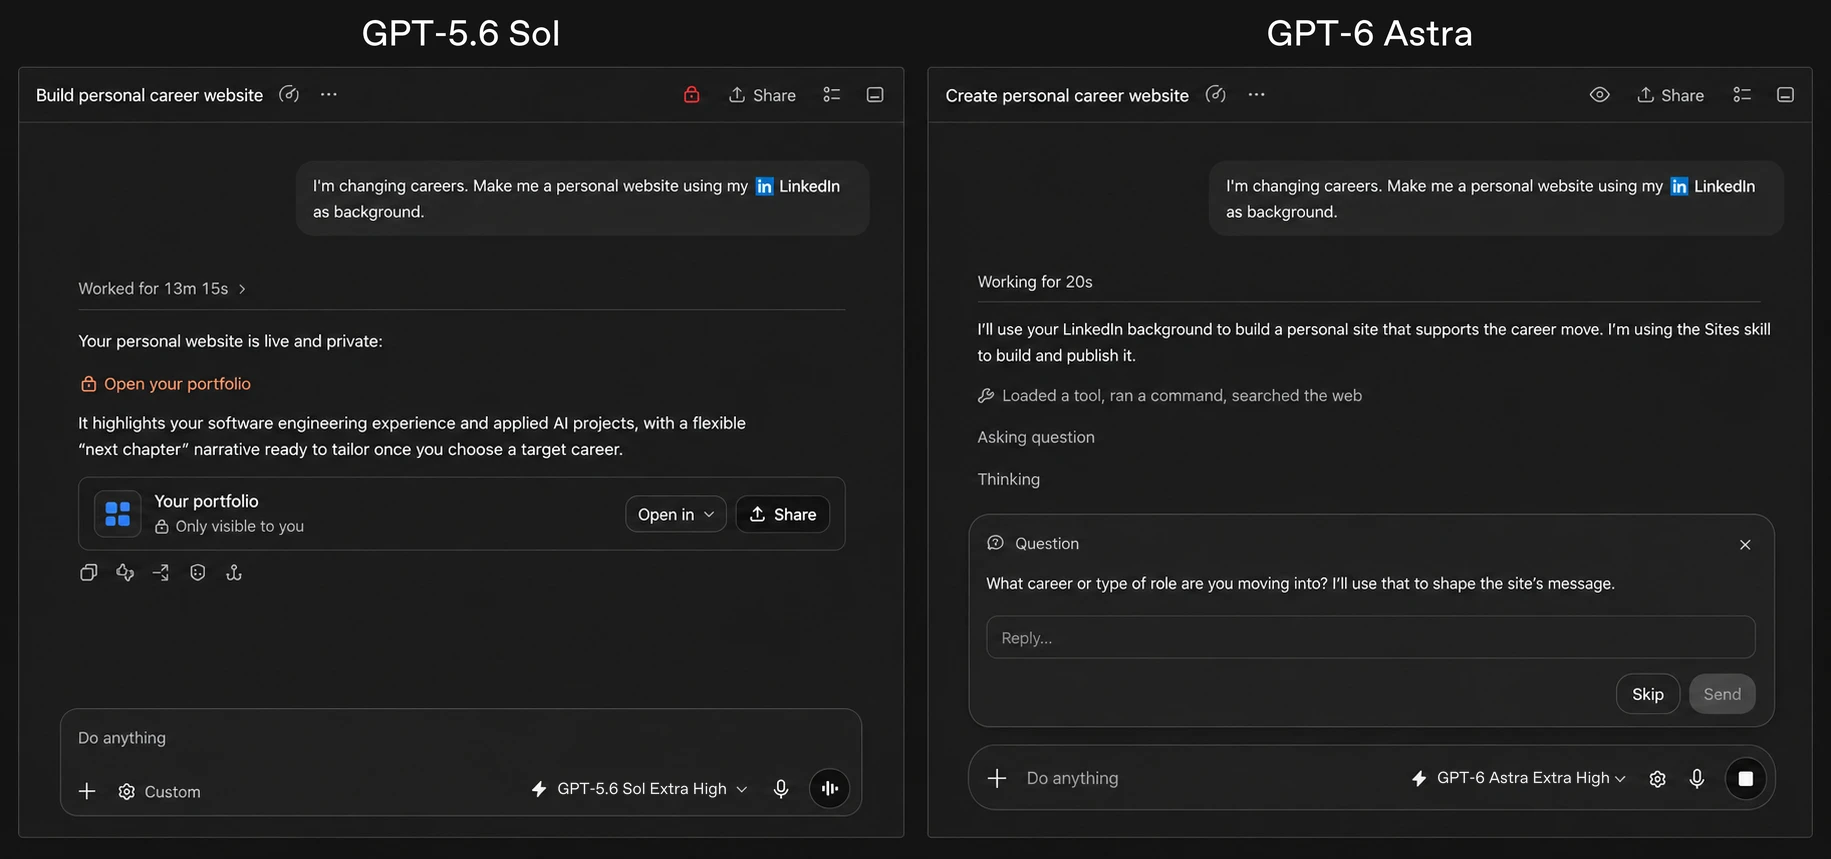
Astra tiene anche meglio la rotta quando il compito cambia strada facendo. I modelli precedenti a volte scambiavano una correzione per un obiettivo nuovo e dimenticavano la richiesta iniziale o i vincoli già dati; Astra incorpora i nuovi requisiti, cambia direzione quando glielo si chiede e risponde alle domande laterali senza perdere di vista il lavoro principale.
“Sui compiti legali complessi Astra è un salto di qualità netto rispetto a GPT‑5.6 Sol. Nelle nostre prime prove si è fatto notare perché lavora come un avvocato scrupoloso: tiene separato ciò che dicono i documenti da ciò che è accertato, porta in luce le ipotesi senza fondamento e trasforma le lacune in proposte di redazione concrete.”
Programmazione
Il miglior modello per sviluppare software
Per OpenAI, Astra è oggi il suo miglior modello per lo sviluppo software. Due partner lo raccontano così.
“Sui nostri benchmark interni di programmazione GPT‑6 Astra è allo stato dell’arte, e nelle prove di intuizione di trading fa un passo avanti chiaro rispetto a GPT‑5.6 Sol. Quando programma da agente spiega quello che fa in modo più facile da seguire per gli sviluppatori, e il codice che scrive ha bisogno di meno giri per arrivare alla qualità da produzione.”
“Abbiamo messo alla prova Astra, con sforzo basso, medio e alto, su una delle valutazioni della nostra prima generazione: ogni volta ha superato nettamente GPT‑5.6 Sol. Con più sforzo fa più tentativi su una build nuova, più verifiche con test nel browser e preferisce eseguire il codice invece di limitarsi ad applicare patch. Capire come un modello spende il proprio sforzo è ciò che ci permette di dare a milioni di persone una strada più veloce e affidabile dall’idea a un’app che funziona.”
Terminal-Bench 4.0
Terminal‑Bench 4.0 mette gli agenti davanti a compiti complessi da terminale: sviluppo software, configurazione di sistemi, analisi dati. Astra guida con il 57,9%; Claude Fable 5.1 segue con il 55,8% e GPT‑5.6 Sol2 resta al 37,3%. Anche il costo stimato per compito è più basso: circa il 63% in meno di Fable 5.1 e il 9% in meno di Sol.
In Codex arriva un modo nuovo di gestire le sessioni lunghe. Finora, quando la finestra di contesto si riempiva, il modello compattava: riassumeva il lavoro fatto, perdendo a volte dettagli preziosi, per esempio perché una correzione era fallita o come si comportava un componente. Succede soprattutto nel debug più ostinato o nei grandi refactoring. Con Astra, Codex può tenere appunti attraverso più finestre di contesto, senza schiacciare tutto in un unico riassunto, e le finestre precedenti restano consultabili: il modello può ritrovare un requisito o l’esito di un test nei messaggi e negli output passati, anche se non era finito negli appunti. La funzione è sperimentale, si attiva nel config.toml di Codex e diventerà quella predefinita per Astra nelle settimane successive al lancio.
Scienza
Scienza e salute
“La sintesi è una sola: finisce un’era e ne comincia un’altra.”
Il motivo principale del commento di Epoch sono due risultati sui numeri primi pubblicati insieme al modello.9 10 Il primo riguarda quanto possono stare vicini due numeri primi, anche andando lontanissimo sulla retta dei numeri. Per oltre dieci anni il miglior risultato diceva che esistono infinite coppie di primi a distanza non superiore a 246; Julia Stadlmann era scesa di recente a 240; con il contributo di Astra si arriva a 186. Il secondo riguarda i salti insolitamente grandi tra un primo e il successivo: Astra ha affinato uno dei termini di una stima rimasta immobile per più di 80 anni. Dimostrazioni, versioni abbreviate dei ragionamenti del modello e materiali di verifica sono pubblici.
Sui test di matematica e scienza, intanto, mette in fila una serie di nuovi record.
GPQA Diamond
- GPT-6 Astra96,0%
- Gemini 3.8 Flash95,3%
- GPT-5.6 Sol94,6%
- Claude Fable 5.193,7%
- Claude Opus 593,7%
- Claude Fable 592,6%
GPQA Diamond (domande di livello dottorato in biologia, chimica e fisica): 96,0%, il migliore del confronto. Con meno budget arriva comunque al 94,9%, sopra il miglior 94,6% di GPT‑5.6 Sol, con una spesa inferiore di circa il 37%. (Dati delle tabelle di OpenAI.)
Astra aiuta anche nel lavoro pratico che sta dietro una scoperta. Unendo ragionamento scientifico e uso del computer, lavora dentro software specialistici per controllare i dati ed esplorare i risultati, aiutando i ricercatori a pesare le prove e a decidere cosa indagare dopo.
Cybersicurezza
Cybersicurezza: la soglia Critical
Questa è la parte più delicata. Astra fa un salto netto nelle capacità informatiche, tanto da arrivare al livello Critical nella scala di rischio di OpenAI, il Preparedness Framework, come l’azienda aveva anticipato in un aggiornamento sulla sicurezza. Saper trovare e sfruttare vulnerabilità mai viste (le zero‑day) aiuta chi difende a chiudere le falle prima, ma richiede protezioni molto più forti. Per misurare fin dove si spingono queste abilità, OpenAI ha condotto prove interne e ne ha commissionate a esperti esterni.
I primi due test, eseguiti senza le protezioni di produzione, verificano se un modello trasforma vulnerabilità note in exploit che funzionano. Su ExploitBench Astra fa il 100%, contro il 78,5% di GPT‑5.6 Sol, che era il precedente modello di frontiera con capacità cyber. Su ExploitGym arriva al 42,4% contro il 30,3% di Sol, con molti meno token in uscita.13
ExploitBench
- GPT-6 Astra100,0%
- GPT-5.6 Sol78,5%
- Claude Opus 570,0%
ExploitBench chiede di trasformare falle note del motore JavaScript V8, quello di Chrome, in attacchi che funzionano. Astra fa il pieno (100%); Sol si ferma al 78,5% e Claude Opus 5 al 70%. (Dati delle tabelle di OpenAI.)
Il dubbio ovvio è che il modello abbia già «visto» le vecchie falle durante l’addestramento. Per questo OpenAI ha costruito due prove nuove. La prima è un ExploitBench interno fatto solo di falle comparse negli ultimi tre mesi.14 Qui Astra riesce molto più spesso di Sol, con molti meno token in uscita, e durante i test ha scoperto e usato due zero‑day sconosciute, che OpenAI sta segnalando a chi mantiene quel software.
La seconda, SRE‑Bench15, verifica se un modello riesce a ricostruire la logica di un software compilato senza il codice sorgente. Astra chiude l’88,0% dei compiti al primo colpo e il 99,2% con quattro tentativi a disposizione; Sol si ferma al 55,9% e al 68,7%.
Nelle valutazioni con esperti, sempre senza protezioni, Astra è riuscito a usare falle sconosciute per eseguire codice in browser blindati e a costruire exploit per ottenere privilegi più alti su sistemi operativi altrettanto protetti.
Il ragionamento di fondo, già esposto da OpenAI nel testo The Defender’s Window, è che queste capacità aiutano i difensori a trovare prima le debolezze ma le rendono anche più facili da sfruttare: il tempo per adeguarsi si accorcia. La versione rilasciata al pubblico consente revisione sicura del codice e correzione delle falle, ma rifiuta i compiti più avanzati, come scrivere exploit dimostrativi (proof‑of‑concept). Attraverso OpenAI Daybreak, l’azienda prevede nelle settimane successive di allargare l’accesso con protezioni meno restrittive per validare vulnerabilità, analizzare malware e scrivere regole di rilevamento.
Rispetto a Sol le difese contro l’abuso sono state rafforzate: il modello resiste meglio ai jailbreak, i sistemi di monitoraggio ricevono più contesto, e i test interni ed esterni continuano, compresi attacchi automatici di red teaming, tutti descritti nella system card del modello.
Per un’azienda il messaggio pratico è doppio. Strumenti così abbassano il costo di una buona revisione della sicurezza del proprio software; ma abbassano anche il costo di un attacco, e aggiornare in fretta browser, sistemi e librerie diventa ancora più importante di prima.
Allineamento
Il modello che resta nel perimetro
L’allineamento, cioè quanto il modello fa quello che si intende davvero e si ferma dove deve, è l’altra metà dell’annuncio. Per OpenAI è il modello più allineato che abbia mai rilasciato: agisce con prudenza, rispetta i confini del compito e comunica in modo trasparente. È, dice l’azienda, l’ultimo frutto di un programma di ricerca lungo anni.
Quando l’ambiente è delicato, Astra dosa la prudenza in base al rischio. In una prova fatta di compiti di uso del computer scelti apposta per provocare errori, ha evitato meglio degli altri le conseguenze indesiderate, e con le misure di sicurezza aggiuntive accese per impostazione predefinita il risultato migliora ancora.
Secondo OpenAI produce meno risultati disallineati di tutti gli altri modelli di frontiera messi alla prova. Per un confronto equo ha usato un ambiente generico per agenti basato sugli strumenti nativi della propria Responses API e della Messages API di Anthropic, senza le protezioni che gli utenti di Codex e ChatGPT Work hanno di solito, come la revisione automatica e le conferme.16
In una prova interna, fatta su compiti di lavoro d’ufficio, Astra non ha mai cercato di scavalcare un diniego della revisione automatica di Codex, nemmeno quando questa era configurata apposta per essere aggirabile e il compito non si poteva finire in altro modo. Lo stesso comportamento emerge dalla prova sui compiti cyber impossibili di cui ho parlato all’inizio, e da altri risultati della system card.
Aggiramento dell’auto-review
- GPT-6 Astra0,0%
- GPT-5.6 Sol0,3%
La prova misura come reagiscono i modelli ai dinieghi dell’auto‑review su compiti di lavoro d’ufficio: approfittare di una configurazione debole per aggirarla conta come fallimento. Astra non ci ha mai provato: 0,00% contro 0,29% di Sol.
Anche sulla trasparenza segna nuovi record: in una delle prove afferma cose false su ciò che sa o può fare tre volte meno spesso di Sol, e nel test interno sulle «allucinazioni» riguardo alle proprie capacità scende dal 12,2% al 4,2%.
C’è un punto che OpenAI non nasconde. Quando gli si chiedeva apposta di sfuggire ai controlli, le tracce di ragionamento di Astra sono risultate più difficili da sorvegliare rispetto a quelle di Sol. La spiegazione proposta: controlla meglio ciò che scrive nei compiti semplici e li risolve con meno passaggi espliciti. Nei compiti complessi, per ora, non sembra riuscire a occultare i passaggi che gli servono, ma OpenAI dice di prendere il calo sul serio e di farne una priorità di ricerca; risultati e lavoro ancora aperto sono raccolti nella system card.
Sopra l’addestramento ci sono le difese di sistema: la revisione automatica di Codex e un monitoraggio del disallineamento attivo in produzione per i modelli di classe Astra, cioè classificatori che controllano ragionamento e azioni e fermano da soli le attività potenzialmente non autorizzate, come già avviene negli usi interni di OpenAI.
Il rovescio della medaglia: questi controlli possono rallentare, mettere in pausa o bloccare anche lavoro legittimo, compresa la sicurezza difensiva. In ChatGPT o Codex può capitare di dover approvare un’azione prima di continuare; nell’API il compito si interrompe. OpenAI promette di ridurre le interruzioni inutili e ribadisce che la sorveglianza è una rete di sicurezza e non prende il posto dell’allineamento: il traguardo è un modello che rimanga da solo dentro i confini autorizzati, così che queste protezioni non debbano mai scattare.
Disponibilità
Prezzi e disponibilità
Al lancio Astra è aperto a un gruppo ristretto di organizzazioni; nei giorni seguenti si estende agli abbonati ChatGPT Plus, Pro, Business ed Enterprise e via API OpenAI, Microsoft Azure e Amazon Bedrock. In ChatGPT l’uso rientra nei limiti degli abbonamenti, con la possibilità di comprare crediti extra. Chi ha Pro, Business o Enterprise avrà anche GPT‑6 Astra Pro. Nelle aziende Enterprise il modello parte spento e va abilitato dall’amministratore.
Per i clienti API idonei c’è la Zero Data Retention, e OpenAI sta sperimentando il Private Safety Processing, annunciato il mese precedente, che punta a rafforzare i controlli di sicurezza senza sacrificare la privacy dei clienti.
Nell’API il modello si chiama gpt-6-astra ed è disponibile anche tramite Microsoft Azure e Amazon Bedrock.
Ingresso
10 $
per milione di token
Uscita
50 $
per milione di token
Modalità Fast
2×
di velocità, al doppio del prezzo Standard
Prezzi Standard dell’API di OpenAI. Letture e scritture nella cache hanno tariffe a parte, che l’annuncio non riporta.
Tre casi inventati, a prezzi di listino e senza sconti della cache:
| Caso | Token in ingresso | Token in uscita | Standard | Fast |
|---|---|---|---|---|
| Riassunto di un contratto | 30.000 | 2.000 | 0,40 $ | 0,80 $ |
| Sessione di programmazione con un agente | 1,5 milioni | 100.000 | 20 $ | 40 $ |
| Un mese di assistente interno: 2.000 richieste | 10 milioni | 1,6 milioni | 180 $ | 360 $ |
Nel terzo caso ogni richiesta ha 5.000 token in ingresso e 800 in uscita: 100 $ di input e 80 $ di output al mese. L’output, a 50 $ per milione, pesa quasi quanto un volume di input sei volte più grande; e la modalità Fast conviene solo dove la velocità vale davvero il doppio, non come impostazione predefinita.
Dati completi
Tutte le tabelle dei benchmark
Le nove tabelle pubblicate da OpenAI, tradotte e complete. La colonna di Astra è evidenziata e in ogni riga il valore migliore è in blu; il trattino indica un valore non riportato.
Lavoro professionale
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | 31,4% | 17,4% | 26,9% | – |
| BenchCAD | 95,9% | 83,3% | 84,3%5 | 67,5%5 | 82,1%5 | – |
| BrowseComp | 91,5% | 90,4% | – | 87,4% | 90,8% | – |
| OpenScore String Quartets (1 − OMR‑NED)6 7 | 0,84 | 0,19 | – | – | – | – |
| Compiti di design (interno) | 50,0% | 47,4% | – | 35,8% | – | – |
| Compiti di data science (interno) | 40,9% | 30,5% | – | 34,7% | – | – |
| Artificial Analysis Intelligence Index v4.1.1 | 61,2 | 60,9 | 65,7 | 62,1 | 63,1 | 58,7 |
Programmazione
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal‑Bench 4.0 | 57,9% | 37,3% | 55,8% | 42,0% | 52,3% | 19,1% |
| DeepSWE v1.1 | 74,1% | 72,7% | 67,4% | 69,9% | 73,7% | 73,8% |
| FrontierCode 1.1 Extended | 64,5%8 | 60,6% | 63,6% | 64,9% | 63,6% | 56,3% |
| FrontierCode 1.1 Main | 53,3%8 | 47,5% | 50,9% | 53,5% | 53,4% | 43,6% |
| Migrazioni di database (interno) | 63,9% | 42,7% | 57,8% | 50,3% | – | – |
| Artificial Analysis Coding Agent Index v1.4 | 67,0 | 65,1 | – | 67,2 | 68,1 | 61,2 |
Materie accademiche
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal‑Bench Science 0.1 | 64,6% | 22,4% | 52,6% | 21,4% | 30,0% | – |
| FrontierMath Tier 4 (v2) | 97,6% | 83,0% | 87,8% | 87,8% | 73,2% | – |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 92,6% | 93,7% | 95,3% |
| Humanity’s Last Exam (con strumenti) | 57,2% | – | 65,0% | 63,8% | 63,6% | – |
Allineamento (più basso è meglio, salvo dove indicato)
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Sicurezza nell’uso del computer (interno) | 2,4% | 22,0% | 9,5% | 18,3% | 11,5% | – |
| La stessa prova, con Auto‑Review | 1,8% | 4,3% | – | – | – | – |
| Aggiramento della revisione (interno) | 0,00% | 0,29% | – | – | – | – |
| ExploitGym honeypot | 0,0% | 48,2% | – | – | – | – |
| Impossible ExploitGym (più alto è meglio) | 100,0% | – | – | – | – | – |
| Allucinazioni sulle proprie capacità (interno) | 4,2% | 12,2% | – | – | – | – |
Contesto lungo
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| OpenAI MRCR v2, 8 aghi, 256K–512K | 100,0% | 91,5% | – | – | – | – |
| OpenAI MRCR v2, 8 aghi, 512K–1M | 96,3% | 73,8% | – | – | – | – |
Ragionamento astratto
| Benchmark | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| ARC‑AGI‑3 | 99,9%1 | 7,8% | – | – | 30,2% | – |
| ARC‑AGI‑2 | 95,0% | 92,5% | 90,0% | 89,2% | 90,4% | – |
| ARC‑AGI‑1 | 98,5% | 97,5% | 97,5% | 98,5% | 97,5% | – |
I punteggi sono il massimo ottenuto a qualsiasi livello di ragionamento. I test sui modelli GPT sono stati fatti nell’ambiente di ricerca di OpenAI o via API: ChatGPT in produzione può rispondere in modo un po’ diverso, per prompt di sistema e strumenti differenti.
In pratica
Cosa significa per un’azienda
Tolti i record, l’annuncio lascia alcune indicazioni pratiche.
- Se usate ChatGPT Business o Enterprise, Astra arriva nei giorni successivi al lancio e l’uso rientra nei limiti dell’abbonamento, con crediti extra per chi li supera. In Enterprise però il modello parte spento: conviene decidere prima chi lo usa, per quali attività e con quali dati, invece di accenderlo per tutti.
- Se costruite agenti via API, il listino da 10 e 50 dollari è solo metà del conto: l’altra metà la fanno i token consumati. OpenAI insiste proprio su questo, con Astra che chiude compiti usando meno token dei rivali (circa il 65% in meno di Opus 5 in uscita su Agents’ Last Exam, metà dei token di Sol sulle vulnerabilità recenti, circa 26.000 token su FrontierCode Extended). Sono numeri da verificare sui propri flussi, non da prendere per buoni.
- Se volete automatizzare lavoro su programmi senza API, l’uso del computer è il fronte più interessante, con tempi quasi dimezzati rispetto a Sol. Va però messo in conto che i controlli di sicurezza possono mettere in pausa un’azione in ChatGPT o Codex, o fermare del tutto un compito nell’API: il flusso va progettato sapendo che può interrompersi. Ne parlo nella guida su come automatizzare i processi aziendali con l’AI.
- Per la sicurezza informatica, il salto nelle capacità cyber vale in entrambe le direzioni. Tenere aggiornati browser, sistemi e librerie diventa ancora più urgente, perché trovare e sfruttare una falla costerà meno a tutti, anche a chi attacca.
Il mio parere
Il mio parere
Per una volta l’annuncio è pieno di dati veri: curve costo‑qualità con un punto per ogni livello di ragionamento, note che ammettono dove il confronto con Claude zoppica, una sezione cyber che ammette senza giri di parole la scoperta di due zero‑day e spiega che il modello pubblico non scrive exploit. Così andrebbe presentato ogni modello di punta, e da qui in avanti sarà il metro con cui misurare gli altri.
Tengo però a mente tre cose. Primo, quasi tutti i numeri li ha misurati OpenAI, e i confronti con Fable 5.1 e Opus 5 sono spesso basati su punteggi dichiarati o su valutazioni modificate. Secondo, la sorvegliabilità del ragionamento peggiora, e lo dice OpenAI stessa: per chi affida ad agenti compiti delicati non è un dettaglio. Terzo, per un’azienda europea a decidere sono costi, tempi di risposta e integrazione con i sistemi che già usa, non i benchmark: i 10 e 50 dollari a milione di token, il raddoppio della modalità Fast e la versione Pro vanno messi in un foglio di calcolo prima di spostare qualsiasi sistema.
Il metodo che consiglio è sempre lo stesso: un piccolo insieme di attività reali, eseguite con Astra e con il modello in uso oggi, misurando qualità, costo, tempi e quante volte serve l’intervento di una persona. Se volete impostare questo confronto sui vostri processi, possiamo farlo insieme.
Note
- 1Su ARC‑AGI‑3 GPT‑6 Astra ha girato nell’ambiente della Responses API di OpenAI, con due impostazioni cambiate per avvicinarsi all’uso reale. Secondo OpenAI non sono modifiche pensate apposta per ARC‑AGI‑3.
- 2Con GPT‑5.6 Sol si intende la versione dell’API, di Codex e di ChatGPT Work; quella nella chat di ChatGPT è leggermente diversa.
- 3OSWorld V2‑Offline è la parte di OSWorld V2 che gira senza accesso a internet. I risultati dei modelli Claude su questa versione li hanno riprodotti gli autori del test sulla classifica ufficiale, con le impostazioni standard e non con i compiti e la correzione modificati della system card di Fable 5.1.
- 4I tempi indicati sono quelli effettivamente trascorsi nelle sessioni dimostrative corrispondenti; le clip mostrate sono estratti montati.
- 5Su BenchCAD i numeri dei Claude riflettono tre modifiche alla valutazione, descritte nella system card di Fable 5.1.
- 6Guang Yang, Victoria Ebert, Nazif Tamer, Brian Siyuan Zheng, Luiza Pozzobon e Noah A. Smith, «LEGATO: Large‑scale End‑to‑end Generalizable Approach to Typeset OMR», arXiv:2506.19065, 2025.
- 7Mark R. H. Gotham, Maureen Redbond, Bruno Bower e Peter Jonas, «The OpenScore String Quartet Corpus», Proceedings of the 10th International Conference on Digital Libraries for Musicology, pp. 49–57, ACM, 2023.
- 8Su FrontierCode Astra ha ricevuto istruzioni simili a una parte del suo messaggio di sistema in Codex: non creare file di test superflui, non fare pulizie non richieste né aggiungere complessità inutile, riusare le funzioni esistenti, leggere le regole del repository e guardare codice, test, documentazione e integrazione continua vicini, seguendo le convenzioni del progetto. Lo scopo è un codice pulito, pronto per essere unito al resto; OpenAI precisa che il prompt non è stato ottimizzato per il test.
- 9Il primo risultato riguarda quanto possono stare vicini due primi, per quanto lontano si vada sulla retta dei numeri. Per oltre dieci anni il limite migliore era 246; Julia Stadlmann lo aveva abbassato di recente a 240; con il contributo di Astra si arriva a 186. Distanze brevi tra primi: dimostrazione e materiali di supporto.
- 10Il secondo risultato riguarda i salti insolitamente grandi tra un primo e il successivo: Astra ha affinato un termine di una stima ferma da oltre 80 anni. Distanze grandi tra primi: dimostrazione e materiali di supporto.
- 11Su HealthBench Professional OpenAI ha valutato da sé tutti i modelli Claude, con la procedura prevista dal test, correzione affidata a GPT‑5.4 e punteggi corretti per la lunghezza, senza troncamenti. Per Fable 5.1, quando il fornitore rifiutava la risposta, è subentrato Opus 5.
- 12Su LifeSciBench Gold v1, GeneBench Pro v13 e MedChemBench non ci sono Fable 5 e 5.1: rifiutano quasi tutte le domande di questi test.
- 13Su ExploitGym Astra e Sol sono stati provati senza il limite di 6 ore, per misurarne le capacità piene; sono comunque abbastanza veloci da rendere quel limite poco rilevante.
- 14ExploitBench (giugno–agosto 2026) raccoglie 20 vulnerabilità gravi di V8 comparse in 13 versioni stabili di Chrome. Verifica se l’agente, sfruttando ciascuna falla, riesce a eseguire codice arbitrario sia in V8 sia nelle versioni ufficiali di Chrome per Linux. Non tutte le falle lo permettono entro i vincoli della prova, quindi il 100% potrebbe essere irraggiungibile.
- 15Jeremy Spence e altri, «The Next Challenge for Agentic Cybersecurity: A Realistic, Contamination‑Free Reverse Engineering Benchmark», arXiv:2608.11469v1, 2026.
- 16Sui modelli di terzi OpenAI usa una configurazione di ricerca più semplice di quella di produzione di Codex, che può dare tassi di errore grezzi diversi; anche le protezioni dei fornitori e gli strumenti di uso del computer restano diversi. Lo scenario senza conferme in Codex è una configurazione interna di ricerca: gli utenti non lo vivono.
- 17Su ScreenSpot‑Pro ed ExploitGym i punteggi di Fable riportati vengono da Mythos, cioè da Fable con meno protezioni.
I numeri vengono da OpenAI e nessuno li ha ancora verificati in modo indipendente, salvo dove indicato. Video e documenti sono materiali ufficiali di OpenAI, ripubblicati qui perché restino disponibili; i giochi girano sui server di OpenAI.
Il mio verdetto
Un annuncio insolitamente trasparente su dati e limiti, con numeri forti in quasi ogni area. Il giudizio è provvisorio, basato sull'annuncio e sulla system card di OpenAI e non su prove mie: i confronti con Claude sono resi difficili dalle note di metodo e quasi tutti i test li ha condotti il produttore.
Cosa mi convince
- Risultati pubblicati per ogni categoria di benchmark, con tabelle e note
- Diciotto demo video ufficiali, tra cui uso reale del computer e compiti quotidiani
- Risultati cyber molto forti e divulgazione delle due zero-day scoperte nei test
- Allineamento con numeri concreti: nessun aggiramento della revisione automatica e 0% sull'honeypot
- Prezzi, rilascio, Astra Pro, modalità Fast e zero data retention dichiarati con precisione
Cosa non mi convince
- Le note di metodo limitano il confronto con i modelli Claude
- Quasi tutti i benchmark li ha condotti OpenAI, senza verifiche indipendenti
- OpenAI stessa ammette che il ragionamento è meno monitorabile di prima
- Modalità Fast, Astra Pro e tariffe della cache ancora da provare sul campo
- In Enterprise è spento di default: il rilascio dipende dagli amministratori
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
6- 1.
- 2.OpenAI — Safety Overview: GPT-6 Astra (system card)deploymentsafety.openai.com
- 3.Anthropic — system card di Claude Fable 5.1 e Mythos 5.1anthropic.com
per le note sui confronti con Claude
- 4.
- 5.
- 6.Open — OpenAI lancia GPT-6 Astraopen.online
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.