Inception porta la diffusione su un modello 40 volte più grande del primo Mercury. Cosa vuol dire, i 12 benchmark del produttore uno per uno, prezzi, velocità reale e limiti.
Mercury 3 di Inception: modello a diffusione da 1.068 token al secondo, contesto da 1M, prezzi da 0,10 $. I 12 benchmark del produttore contro GPT-6 Luna e Claude Haiku 5.5 e i limiti.
di Andrea Pirazzini
Fonte primaria
Inception, Diffusion at Scale: Introducing Mercury 3
inceptionlabs.ai
Tommaso
Il Narratore · 1 min 56 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Inception, Diffusion at Scale: Introducing Mercury 3.
Perché se ne parla#
Il 19 ottobre 2026 Inception, la società californiana che sviluppa modelli linguistici a diffusione, ha presentato Mercury 3. È il suo modello più grande e, secondo l'azienda, il modello a diffusione più capace mai rilasciato. Il messaggio dell'annuncio è netto: Mercury 3 supera GPT-6 Luna e Claude Haiku 5.5 in una serie di benchmark, scrivendo oltre 1.000 token al secondo, da 4 a 8 volte più veloce.
Per un'azienda la velocità non è un vezzo tecnico. Conta negli assistenti vocali, nelle chat di assistenza, negli agenti che navigano siti e fanno decine di passaggi: ogni secondo di attesa si somma. Per capire dove si collocano i modelli piccoli e veloci di OpenAI, leggete anche GPT-6 Sol e Luna.
Token al secondo in uscita su GPU NVIDIA, dichiarati da Inception
Token di contesto, contro i 260.000 di Mercury 2.5
Per milione di token in ingresso, prezzo di lancio scontato del 50%
I test vinti contro GPT-6 Luna e Claude Haiku 5.5 nella tabella ufficiale
Tutti i benchmark di questo articolo sono misurati da Inception: sono dichiarazioni del produttore, non verifiche indipendenti.
In parole semplici: cosa vuol dire «a diffusione»#
Quasi tutti i modelli linguistici che usate oggi, da ChatGPT a Claude, sono autoregressivi: scrivono la risposta un token alla volta, da sinistra a destra, e ogni parola aspetta quella prima. Mercury lavora in un altro modo. Come i modelli che generano immagini, parte da una bozza grezza dell'intera risposta e la rifinisce in pochi passaggi, generando più token in parallelo, dal grossolano al preciso.
Il risultato pratico è la velocità: meno passaggi in sequenza vuol dire risposte complete in una frazione del tempo. Nell'API questo si vede anche nello streaming, che avanza a blocchi invece che parola per parola. Inception non ha pubblicato quanti passaggi usa Mercury 3.
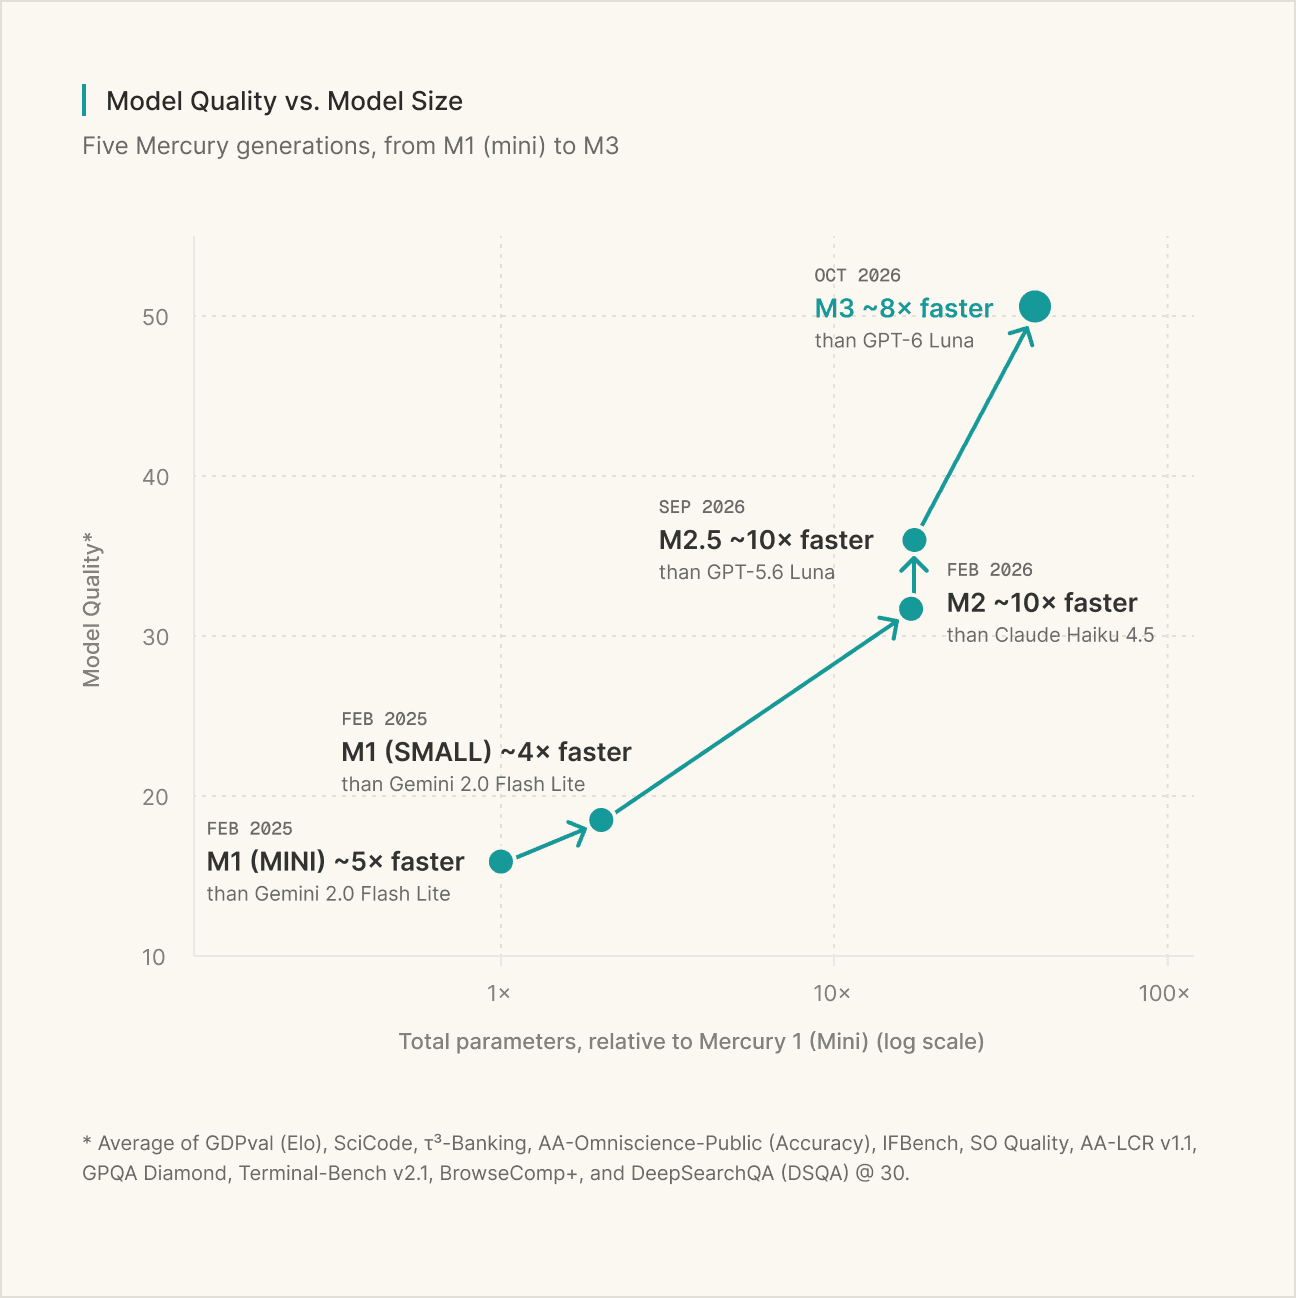
La domanda aperta, finora, era se questo approccio reggesse anche su modelli grandi. Inception sostiene di sì: Mercury 3 è oltre 40 volte più grande di Mercury 1 e, sulla media dei test standard, tre volte più capace di Mercury 1 mini, restando veloce. In altre parole, le leggi di crescita che valgono per i modelli autoregressivi varrebbero anche per la diffusione.
Il video di lancio#
Il video ufficiale di lancio dura 30 secondi e riassume il posizionamento: velocità o intelligenza, con Mercury 3 che promette entrambe.
I benchmark, uno per uno#
Questa è la tabella ufficiale dell'annuncio. Tutti i modelli sono al livello di ragionamento medium; in grassetto il valore migliore di ogni riga.
Test | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
Velocità (token al secondo) | 1.068 | circa 130 | circa 240 |
GDPval (Elo) | 1.237,2 | 1.204,0 | 1.225,0 |
τ³-bench Banking | 30,24 | 23,00 | 13,06 |
MultiChallenge | 60,35 | 51,49 | 52,48 |
AA-Omniscience | 46,44 | 46,94 | 37,22 |
IFBench | 76,84 | 61,82 | 54,65 |
GPQA Diamond | 89,23 | 86,36 | 84,51 |
AA-LCR v1.1 | 77,67 | 78,30 | 74,70 |
MRCR v2 | 75,50 | 62,72 | 78,40 |
SWE-Bench Atlas | 51,08 | 33,33 | 32,26 |
DeepSWE v1 | 46,31 | 37,76 | 51,62 |
BrowseComp+ | 55,18 | 50,50 | 45,78 |
DeepSearchQA | 71,33 | 60,00 | 65,22 |
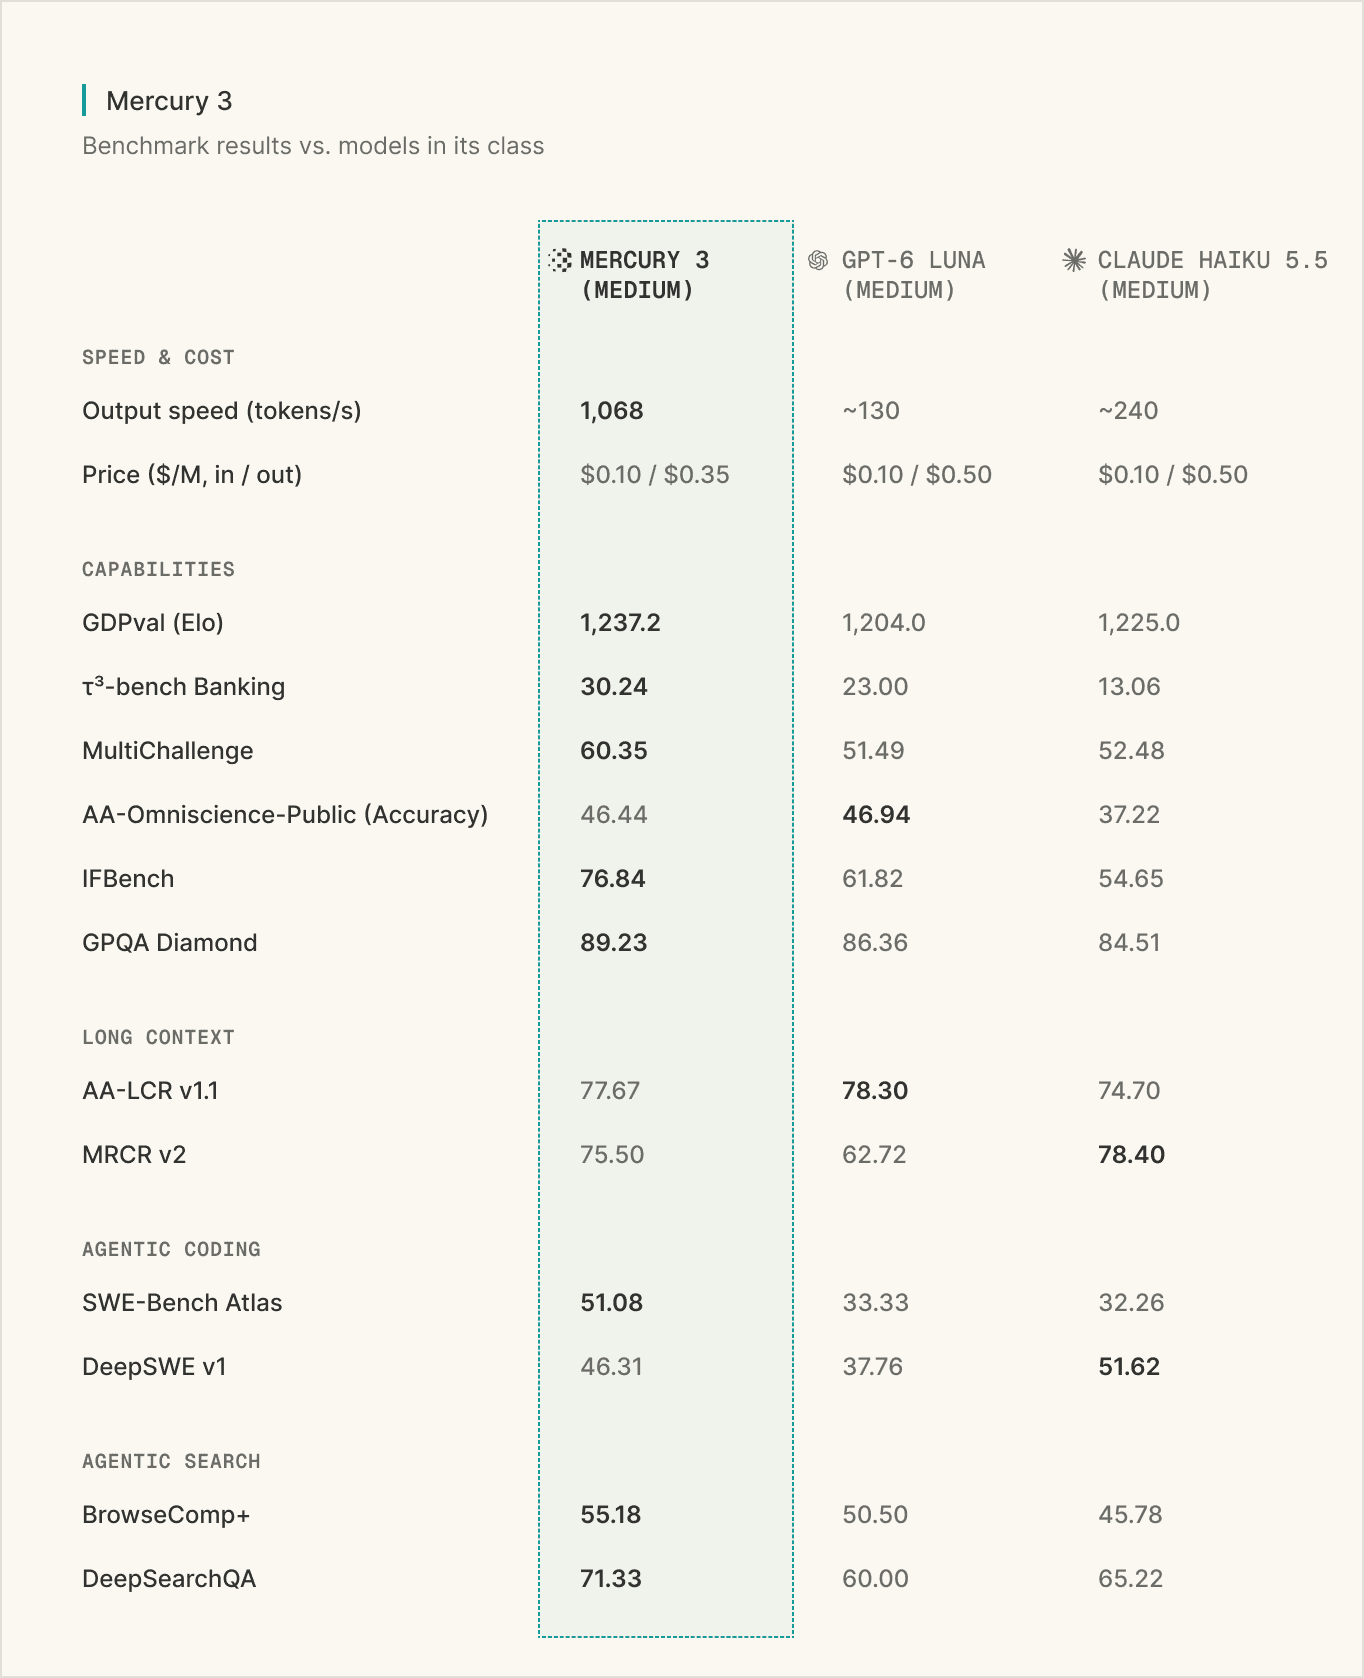
Mercury 3 vince 8 test su 12. Perde due volte contro GPT-6 Luna (AA-Omniscience e AA-LCR, entrambi di poco) e due volte contro Claude Haiku 5.5 (MRCR v2 sul contesto lungo e DeepSWE sulla programmazione su lavori lunghi). Il titolo «batte Luna e Haiku» è quindi vero in parte: più veloce sì, migliore nella maggior parte dei test, non in tutti. Anche il video ufficiale è più prudente del comunicato: parla di qualità «comparabile» a Haiku 5.5 e Luna.
Mercury 3 contro GPT-6 Luna e Claude Haiku 5.5
Sei test della tabella ufficiale, livello di ragionamento medium, più alto è meglio
- Mercury 3
- GPT-6 Luna
- Claude Haiku 5.5
Fonte: Dati di Inception, 19 ottobre 2026
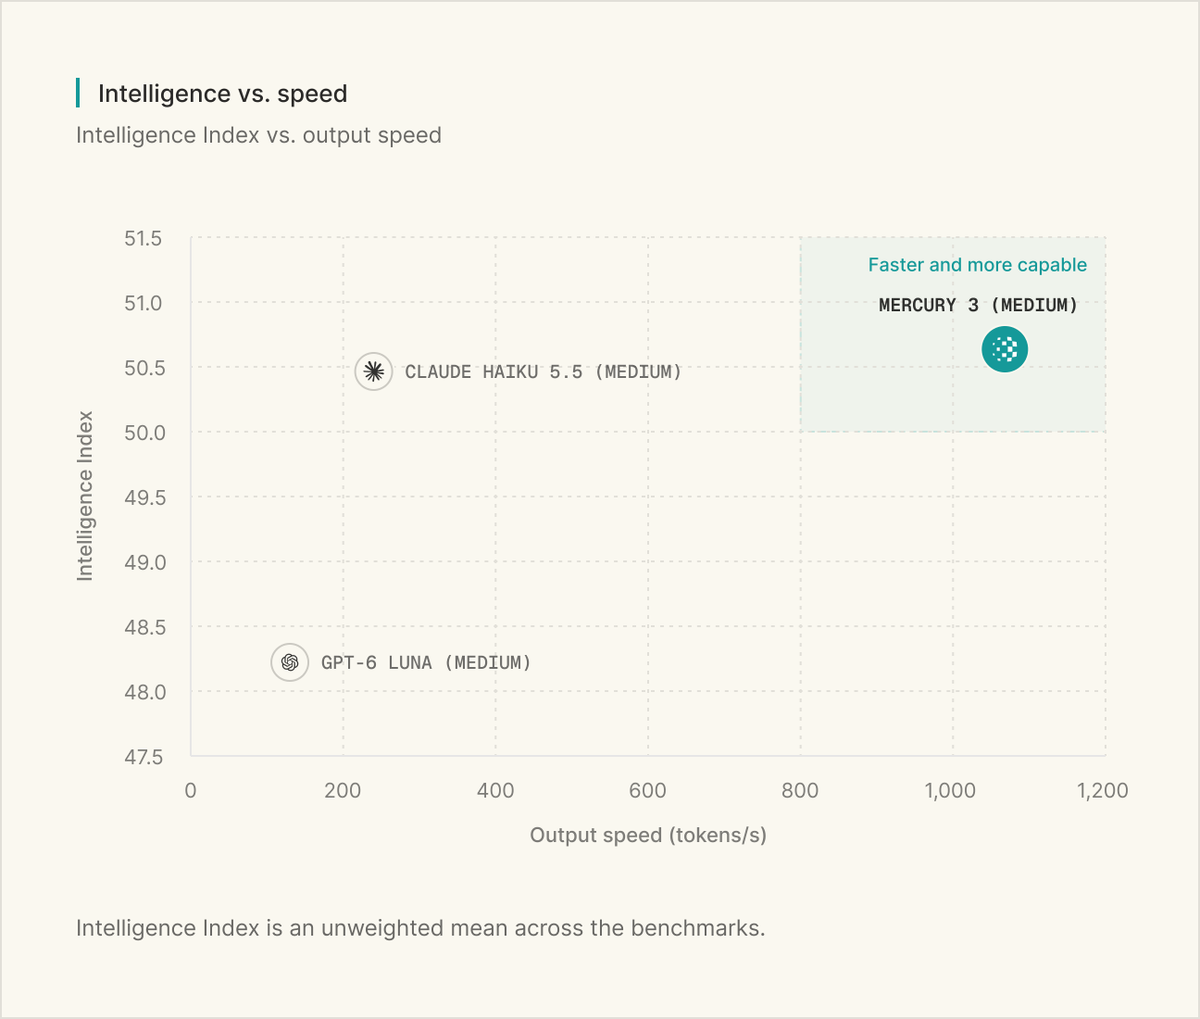
Il grafico che Inception ha pubblicato su X mette insieme le due dimensioni: sull'asse orizzontale la velocità, su quello verticale un indice di intelligenza, cioè la media non pesata dei test. Mercury 3 è da solo nel riquadro «più veloce e più capace», con Claude Haiku 5.5 molto vicino sull'intelligenza e lontano sulla velocità.
Prezzi e disponibilità#
Ingresso | Ingresso in cache | Uscita | |
|---|---|---|---|
Mercury 3, prezzo di lancio (−50%) | 0,10 $ | 0,01 $ | 0,35 $ |
Mercury 3, prezzo pieno | 0,20 $ | 0,02 $ | 0,70 $ |
GPT-6 Luna | 0,10 $ | 0,50 $ | |
Claude Haiku 5.5 | 0,10 $ | 0,50 $ |
Prezzi in dollari per milione di token, IVA non indicata, dalla tabella dell'annuncio e dalla documentazione. Inception non dice quando finisce lo sconto di lancio. Le nuove chiavi API ricevono 100 milioni di token gratuiti, una volta sola.
Mercury 3 è disponibile sulla piattaforma API di Inception, su OpenRouter, Baseten e Vercel AI Gateway. L'API è compatibile con quella di OpenAI, supporta la chiamata di strumenti e gli output strutturati, accetta solo testo in ingresso e restituisce fino a 131.072 token. Il ragionamento ha quattro livelli: instant, low, medium e high.
Per dare un ordine di grandezza, ecco una stima del costo di 1.000 risposte da 3.000 token in ingresso e 300 in uscita, calcolata sui prezzi e sulle velocità dichiarate, senza ragionamento, cache e IVA. Non è un dato di Inception.
Modello | Costo di 1.000 risposte (stima) | Tempo per scrivere 300 token (stima) |
|---|---|---|
Mercury 3, prezzo di lancio | 0,41 $ | 0,3 s |
Mercury 3, prezzo pieno | 0,81 $ | 0,3 s |
GPT-6 Luna | 0,45 $ | 2,3 s |
Claude Haiku 5.5 | 0,45 $ | 1,3 s |
Al prezzo pieno Mercury 3 costa circa il doppio dei concorrenti su questo esempio; al prezzo di lancio è in linea. Il vantaggio vero, sulla carta, è il tempo.
Chi lo usa già#
Inception cita quattro partner che hanno provato Mercury 3 in anteprima. Sono testimonianze raccolte dal produttore:
TinyFish, agenti che navigano il web: su 50 compiti reali di Mind2Web Mercury 3 ne ha completati il 50%, più di GPT-6.1 Sol secondo il cofondatore.
RevisionDojo, tutor per studenti: suggerimenti e correzioni tornano in circa un secondo.
Octen, ricerca per occhiali smart: tempo mediano di generazione di 0,9 secondi e risposta completa in 2,2 secondi.
Lorikeet, assistenza clienti in settori regolati: latenza più bassa e risultati migliori nei test interni.
Cosa cambia in pratica#
Mercury 3 ha senso dove la latenza pesa più dell'ultimo punto di qualità: assistenti vocali e centralini, chat di assistenza, agenti che fanno molti passaggi, ricerca su tanti documenti. Prima di sceglierlo, tre controlli concreti:
Provate al livello giusto. Il livello di ragionamento predefinito di Mercury 3 è low, mentre tutti i benchmark ufficiali sono a medium. Misurate qualità e velocità con le impostazioni che userete davvero.
Misurate la velocità reale. Il dato di 1.068 token al secondo è di Inception. Su OpenRouter, il 20 ottobre alle 18:58 ora italiana, la velocità mediana osservata era di 188 token al secondo con una latenza mediana di 747 ms: è un metodo diverso, che include rete e carico, ma ricorda che il numero di laboratorio non è quello che vedrete in produzione.
Controllate l'italiano e i dati. Il supporto all'italiano non è dichiarato. Le condizioni d'uso di Inception permettono di usare i contenuti inviati per addestrare i modelli, salvo disattivare l'opzione «Improve the model for everyone»; non risultano indicazioni sul trattamento dei dati in Unione europea.
Se state valutando quale modello mettere dietro un assistente o un agente, potete partire dalla pagina sui sistemi AI su misura.
Domande frequenti#
Cos'è un modello linguistico a diffusione?
È un modello che non scrive un token alla volta da sinistra a destra, ma genera una bozza dell'intera risposta e la rifinisce in pochi passaggi, producendo più token in parallelo. Per questo può essere molto più veloce dei modelli autoregressivi.
Mercury 3 è migliore di GPT-6 Luna e Claude Haiku 5.5?
Nella tabella ufficiale di Inception vince 8 test su 12, tutti al livello medium. Perde AA-Omniscience e AA-LCR contro Luna, MRCR v2 e DeepSWE contro Haiku. Sono dati del produttore.
Quanto costa Mercury 3?
Al lancio 0,10 $ per milione di token in ingresso e 0,35 $ in uscita, con uno sconto del 50% sul prezzo pieno di 0,20 $ e 0,70 $. La data di fine dello sconto non è indicata. Le nuove chiavi API hanno 100 milioni di token gratuiti.
Dove si può usare?
Sulla piattaforma API di Inception, su OpenRouter, Baseten e Vercel AI Gateway. L'API è compatibile con quella di OpenAI, quindi si integra cambiando endpoint e nome del modello.
Funziona in italiano?
Inception non dichiara il supporto all'italiano. Conviene provarlo sui propri testi prima di usarlo con i clienti.
I dati inviati vengono usati per l'addestramento?
Le condizioni d'uso di Inception lo permettono, salvo disattivare l'opzione «Improve the model for everyone» nelle impostazioni. La conservazione zero si chiede caso per caso e i contratti Enterprise hanno una conservazione configurabile.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.Inception, Diffusion at Scale: Introducing Mercury 3inceptionlabs.ai
Annuncio, tabella dei benchmark, prezzi, partner, 19 ottobre 2026
- 2.Documentazione Inception, Modelsdocs.inceptionlabs.ai
Prezzi, contesto da 1M, output massimo, livelli di ragionamento
- 3.Documentazione Inception, FAQdocs.inceptionlabs.ai
Token gratuiti per le nuove chiavi, Mercury 2 e 2.5
- 4.
- 5.
- 6.OpenRouter, Mercury 3openrouter.ai
Velocità e latenza mediane osservate il 20 ottobre 2026 alle 18:58 ora italiana
- 7.Inception, Terms of Usedocs.inceptionlabs.ai
Uso dei contenuti per l'addestramento e opzione per disattivarlo
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.