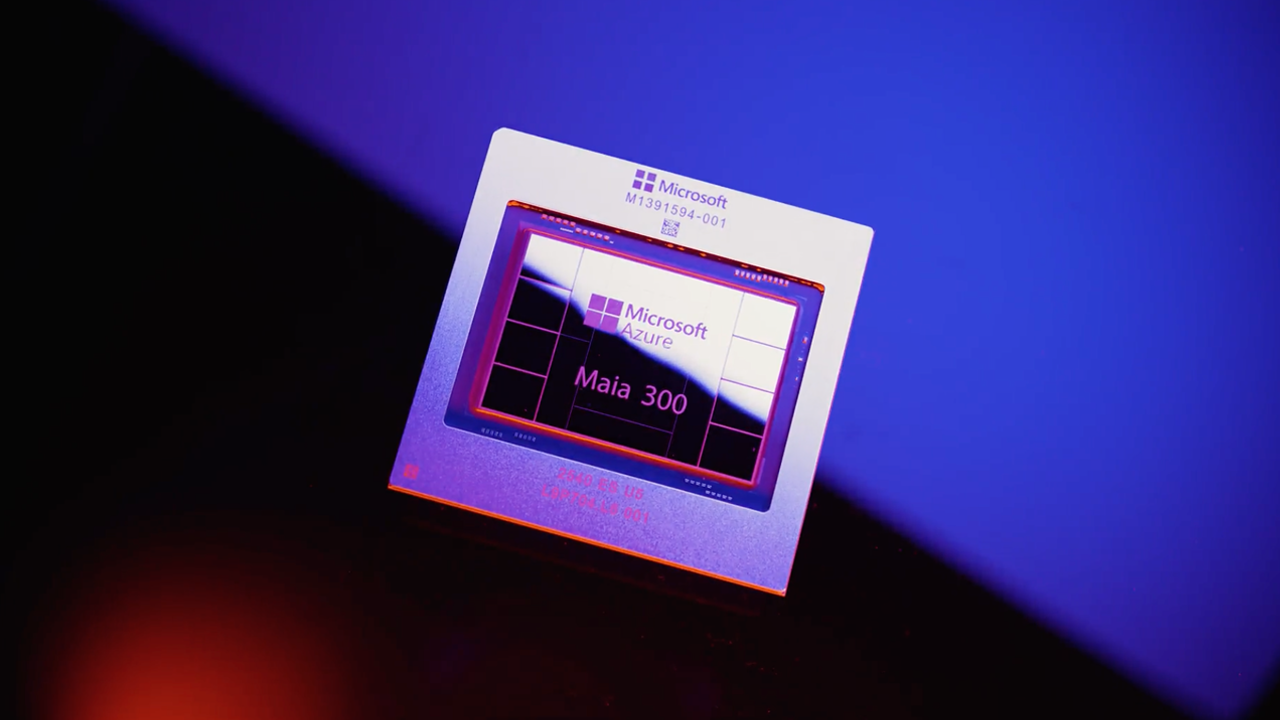
Il terzo chip di inferenza AI di Microsoft: cifre, architettura e limiti delle dichiarazioni del produttore
Microsoft annuncia Maia 300, terza generazione dei suoi acceleratori per l'inferenza AI, con distribuzioni su scala multi-gigawatt previste dal 2027. Ecco cosa dichiara l'azienda, cosa mostrano i grafici ufficiali e quali limiti avere presenti.
di Andrea Pirazzini
Fonte primaria
Microsoft — Microsoft to expand Azure Maia system to multi-gigawatt deployments - The Official Microsoft Blog
blogs.microsoft.com
Carlo
Il Narratore · 2 min 31 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Microsoft — Microsoft to expand Azure Maia system to multi-gigawatt deployments - The Official Microsoft Blog.
Azure Maia 200 è in produzione, Maia 300 arriva nel 2027#
Microsoft ha annunciato che Maia 200 è già in produzione e serve i carichi di lavoro di produzione dell'azienda, tra cui Microsoft Copilot, mentre la terza generazione del programma, Maia 300, sarà impiegata in distribuzioni multi-gigawatt a partire dal 2027. Nel comunicato ufficiale l'azienda indica che Maia diventerà il sistema primario di inferenza per i propri prodotti e servizi. Maia 200 esegue già modelli OpenAI, modelli MAI di Microsoft e famiglie di modelli open source.
Il punto che conta è che Maia 300 è progettato per i nuovi carichi dell'AI: ragionamento su contesti lunghi, esperienze conversazionali sensibili alla latenza e attività agentiche multi-step. Microsoft prevede che il sistema offra 40% di token in più per megawatt rispetto a sistemi basati su GPU, e che in configurazione completa da 96 acceleratori arrivi fino a 7x il throughput di token a livello di rack rispetto a Maia 200. Si tratta di stime indicate dallo stesso produttore.
Microsoft ha collegato i dettagli dell'annuncio a Microsoft Ignite 2026, in programma a San Francisco e online il mese successivo alla pubblicazione del comunicato. Per chi usa i servizi Microsoft, la data da tenere d'occhio è il 2027, perché prima di allora la produzione con Maia 300 non è ancora avviata.
Maia 200 e i carichi di lavoro reali di Microsoft#
Microsoft non progetta il chip in isolamento. Lo sviluppo del silicio richiede anni, quindi i team di hardware e software si confrontano in anticipo su architetture, dimensioni e capacità dei modelli futuri. Il punto di partenza sono i carichi reali, cioè i servizi che Microsoft fa funzionare su larga scala.
Maia 200 è già in produzione e serve Copilot e il team MAI, mentre GitHub Copilot e Microsoft Foundry arriveranno entro fine anno. Il sistema esegue modelli OpenAI, modelli MAI e famiglie open-source. Per le funzioni integrate in Teams, Copilot e Cowork, Microsoft dichiara fino a 1,7 volte più token per watt rispetto a un'infrastruttura basata su GPU concorrente: è una dichiarazione del produttore, non un risultato verificato da terzi nella fonte.
Carico di lavoro: l'insieme di richieste che un sistema deve eseguire.
Silicio: il materiale del chip; qui indica il processore progettato da Microsoft.
Token: piccola unità di testo che il modello elabora per produrre una risposta.
Watt: unità di potenza; più token per watt significa più risultati a parità di energia consumata.
GPU: processore grafico, molto usato per far funzionare i modelli di intelligenza artificiale.
Maia 300 in numeri: rack, memoria e prestazioni dichiarate#
Acceleratori per rack
Configurazione completa Maia 300
Potenza del rack
Inviluppo energetico dichiarato
Capacità HBM
Per rack
Banda HBM aggregata
Nel dominio scale-up
Microsoft descrive Maia 300 come sistema completo e non come singolo chip: il rack raccoglie 96 acceleratori entro 167 kW, con 27,6 TB di memoria HBM e 1,7 PB/s di banda aggregata nel dominio scale-up. Secondo l'azienda, questa densità permette di servire più interazioni AI simultanee da ogni rack e di migliorare la capacità dei data center. Per il dato sull'efficienza in token per megawatt, presentato come dichiarazione del produttore, vi rimandiamo alla sezione introduttiva.
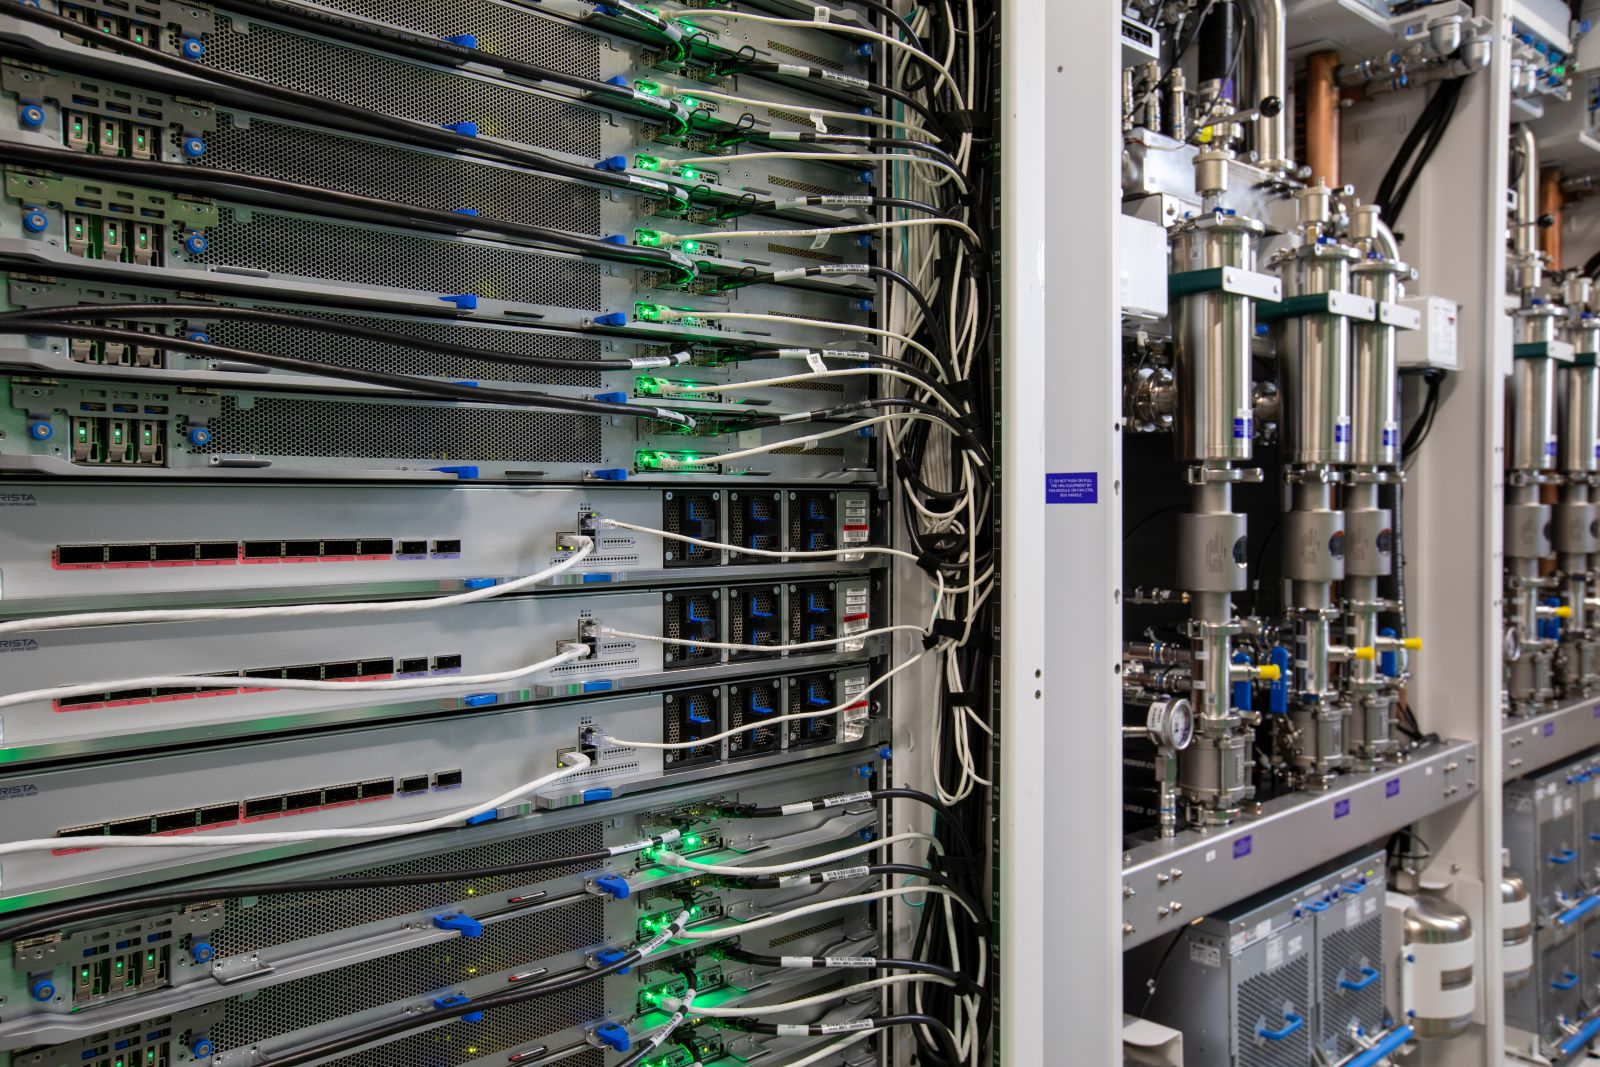
Maia 300 è pensato per carichi di lavoro con contesti lunghi, risposte a bassa latenza e attività agentiche in più passaggi, e le prime distribuzioni in produzione sono previste nel 2027. I valori completi del singolo acceleratore, come la potenza termica e la banda di memoria, si trovano nella sezione successiva, dove sono riportati dalla scheda tecnica ufficiale.
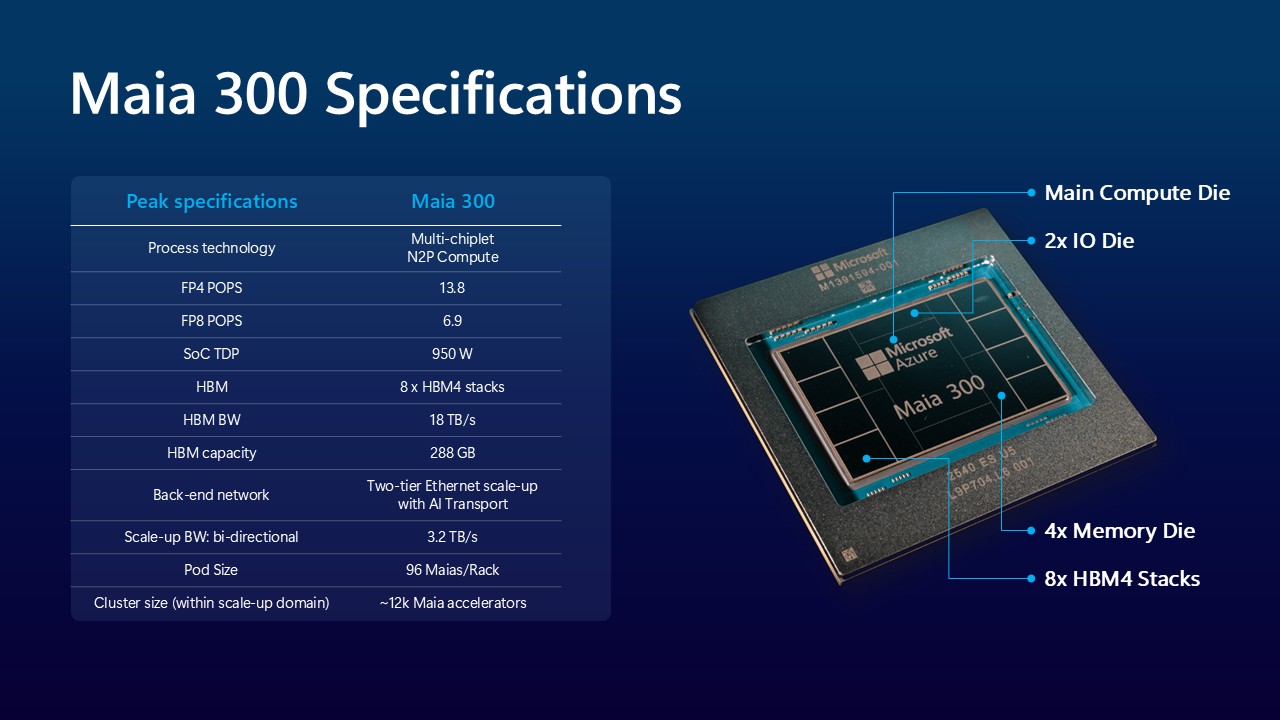
La scheda: specifiche di Maia 300 in sintesi#
Il sistema Maia 300 è la terza generazione del programma Azure Maia e nasce con un'architettura pensata soprattutto per l'inferenza. La scheda seguente riassume le specifiche principali, lette dal grafico ufficiale di Microsoft. Tutti i valori sono dichiarazioni del produttore.
Specifica | Maia 300 |
|---|---|
Process technology | — |
FP4 POPS | 13.8 |
FP8 POPS | 6.9 |
SoC TDP | 950 |
HBM | — |
HBM BW | 18 |
HBM capacity | 288 |
Back-end network | — |
Scale-up BW: bi-directional | 3.2 |
Pod Size | 96 |
Cluster size (within scale-up domain) | 12000 |
Microsoft Azure Maia 300 contro Maia 200: specifiche a confronto
Prestazioni di calcolo, banda HBM, capacità di memoria e densità per rack dichiarate da Microsoft
- Maia 200
- Maia 300
Fonte: Microsoft, valori letti dal grafico ufficiale Maia 300 Specifications
Specifiche di Maia 300 lette dal grafico ufficiale di Microsoft. Tutti i valori sono dichiarazioni del produttore. Fonte: Microsoft.
Microsoft prevede di avviare le distribuzioni in produzione di Maia 300 nel 2027, nello stesso periodo in cui il programma Azure Maia si estende a installazioni multi-gigawatt. Maia 200, già in produzione, rappresenta la generazione precedente su cui il produttore dice di aver basato la progettazione del nuovo sistema.
Azure Maia al centro della Frontier Transformation#
Una visione che parte dal chip#
Secondo Microsoft, la strategia è chiamata Frontier Transformation: un approccio che ottimizza l'intero percorso, dal silicio ai sistemi fino agli agenti AI. Hardware, software e applicazioni vengono quindi progettati insieme, invece che separatamente.
La piattaforma è descritta come aperta, eterogenea e multi-modello: può far girare modelli diversi e componenti hardware di tipi differenti, senza affidarsi a una sola scelta. Secondo l'azienda, né un singolo modello né un singolo chip definiranno il futuro. In questa cornice Azure Maia è presentata come una componente fondamentale dell'approccio, non come soluzione isolata.
Il glossario essenziale#
Silicio: il materiale con cui si producono i chip, qui usato per indicare i processori stessi.
Agente AI: un sistema che non si limita a rispondere, ma può ragionare, agire e collaborare per completare compiti in più passaggi.
Piattaforma multi-modello: un ambiente che supporta più modelli di intelligenza artificiale diversi.
Eterogenea: composta da elementi di natura differente.
Inferenza: l'uso di un modello già addestrato per produrre risposte.
Dietro le quinte: galleria e video del chip Maia 300#
Il chip e il server nelle immagini#
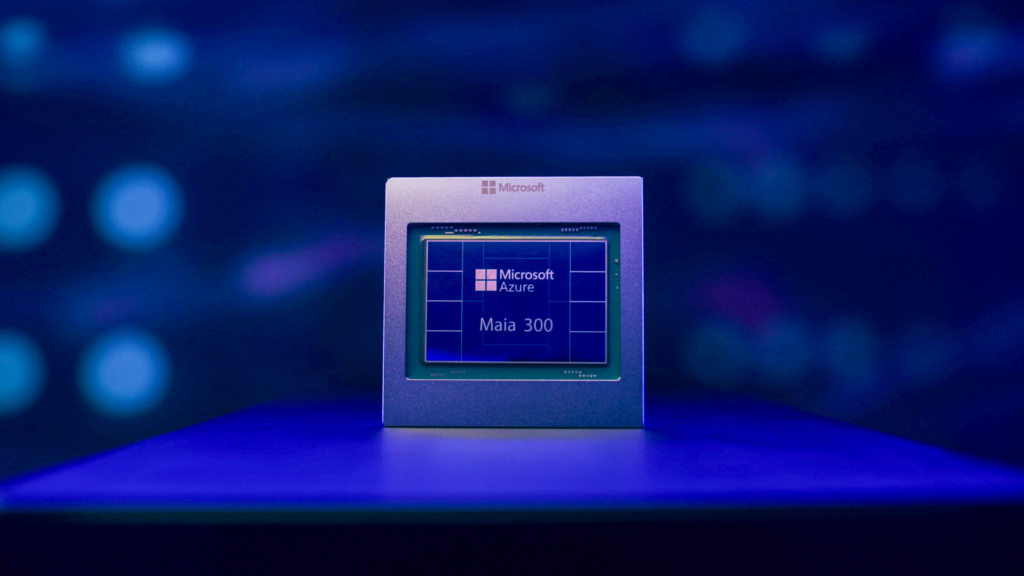
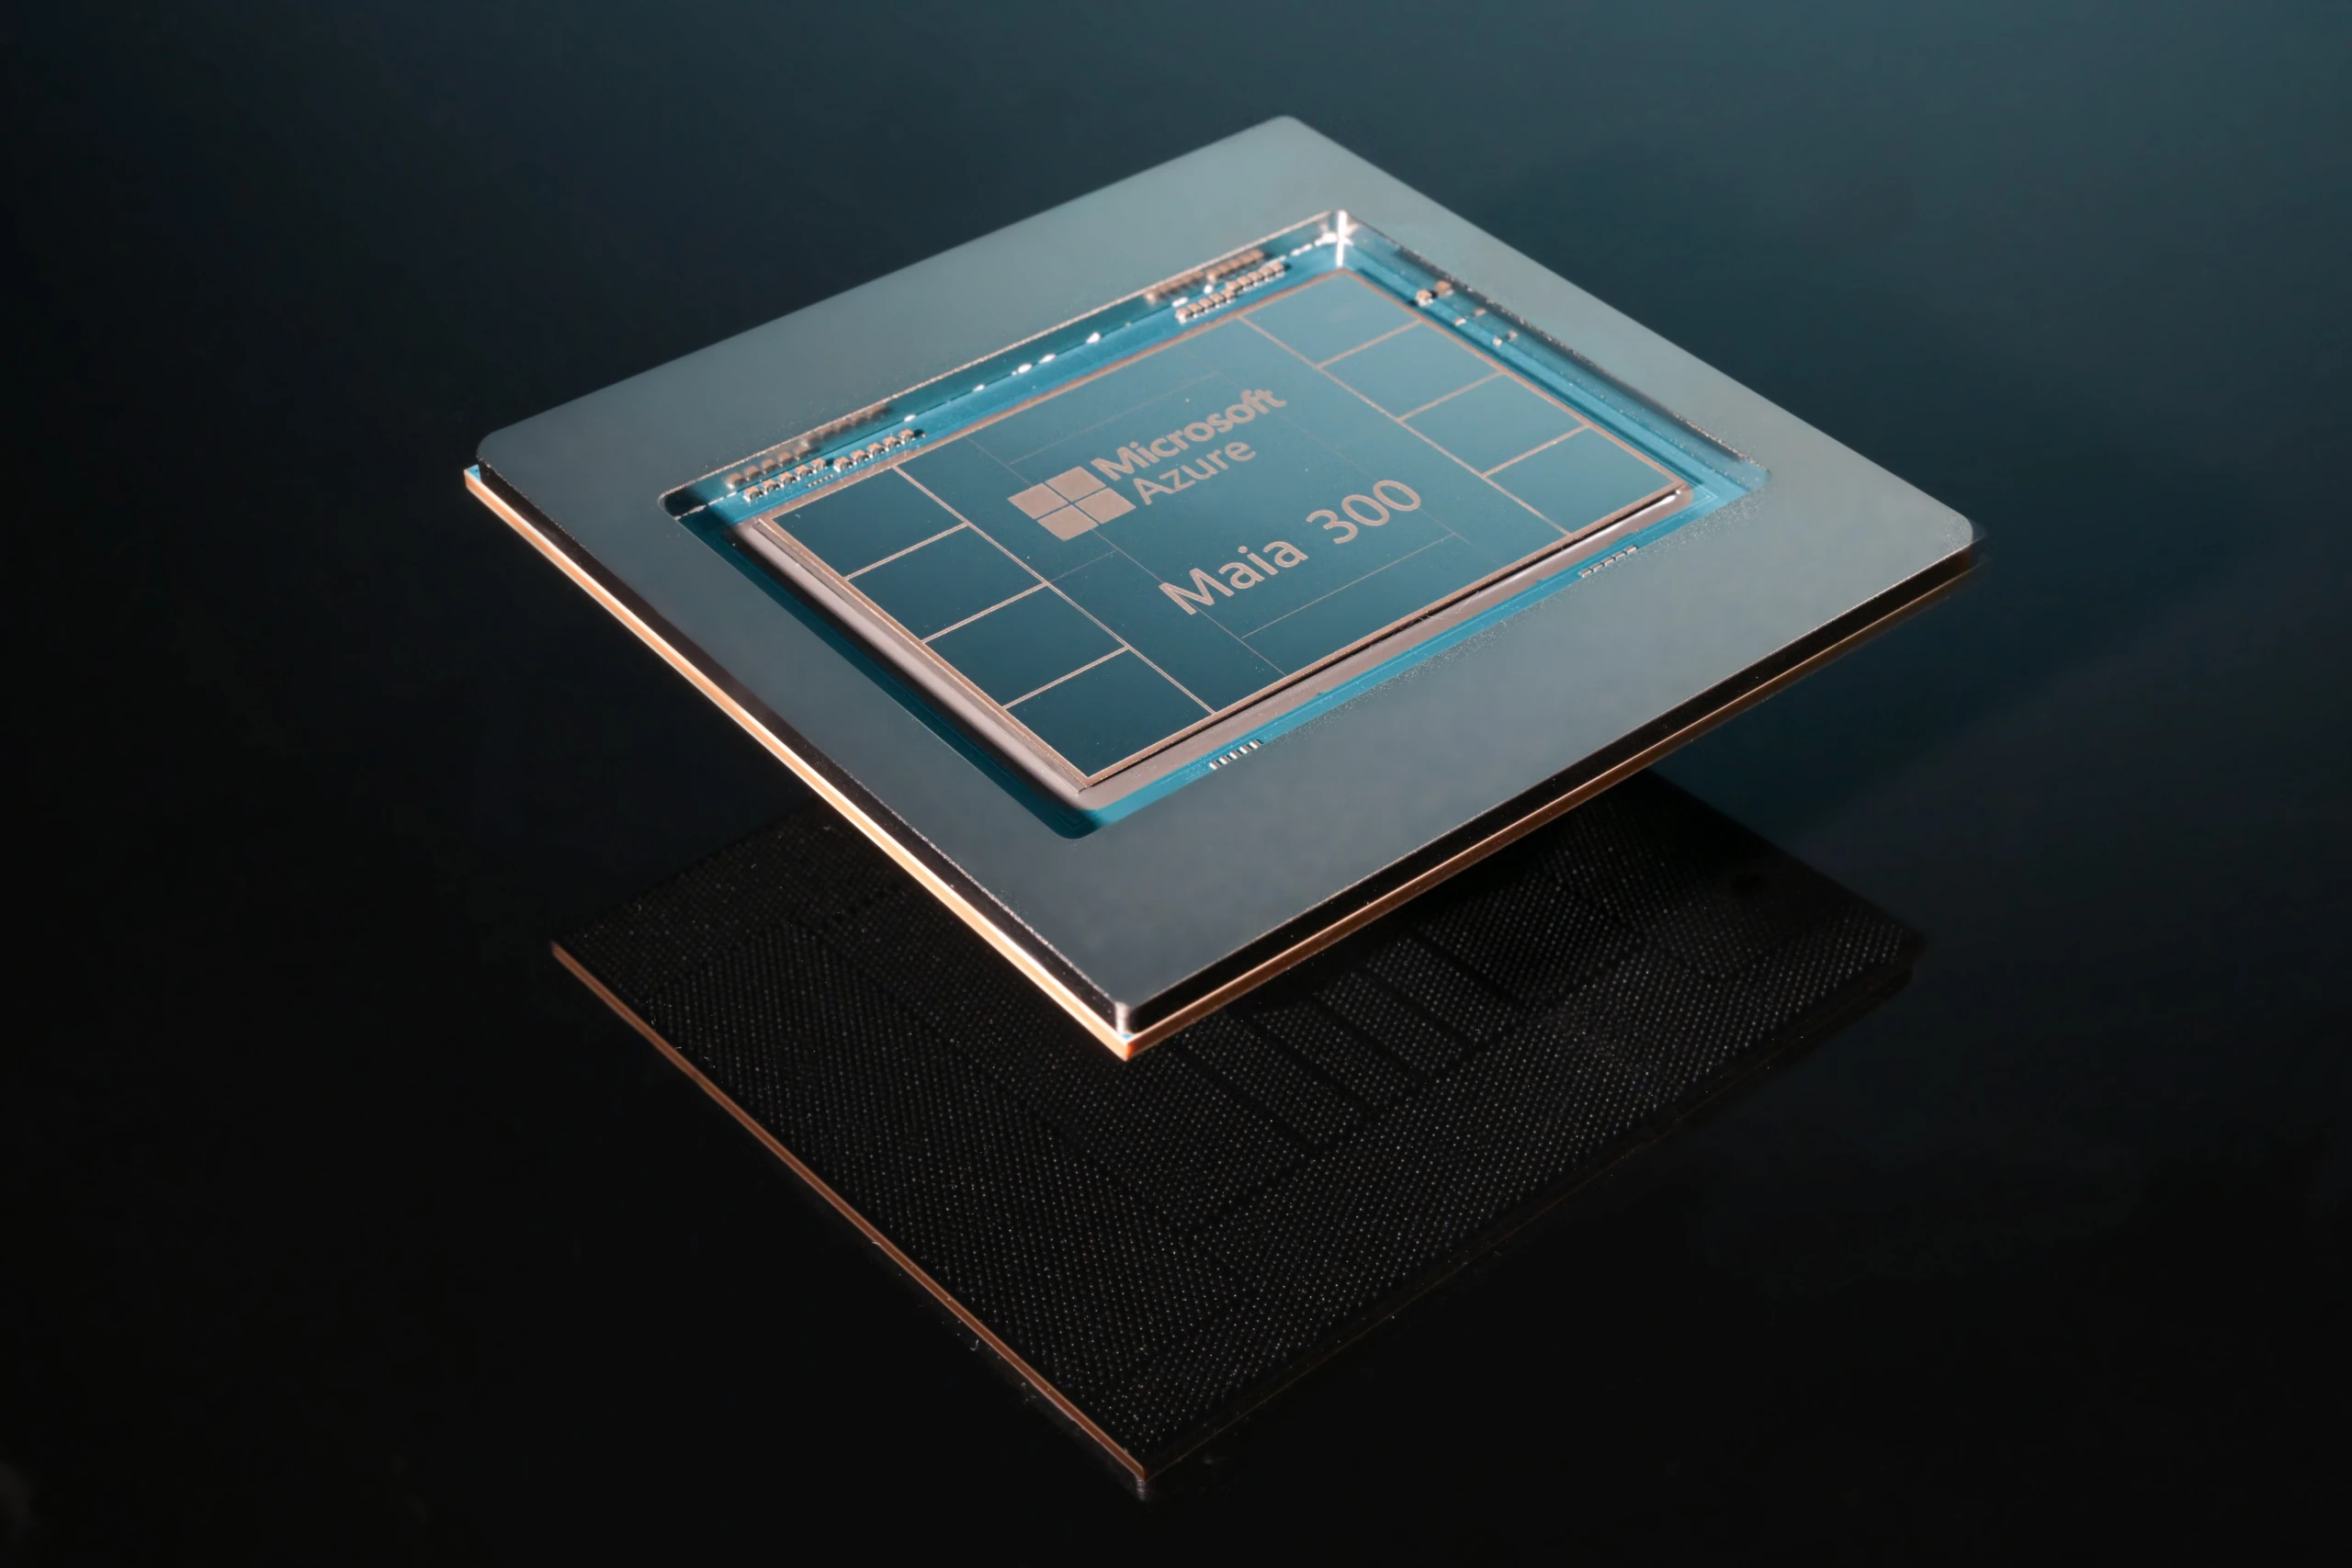
La pagina Before - Microsoft's latest custom chip: Maia 300 raccoglie immagini e un video che mostrano il chip, il suo package e il server che lo ospita. Le foto aiutano a capire come il componente si collega al sistema e al rack.
La pagina elenca gli interventi di alcuni dirigenti Microsoft: Scott Guthrie (EVP, Cloud + AI Group) sul vantaggio full-stack dell'AI su scala di produzione; Rani Borkar (presidente, Azure Hardware Systems and Infrastructure) sull'approccio di sistema all'inferenza efficiente; Saurabh Dighe (CVP, Azure Hardware Systems Planning and Architecture) sui progressi nei livelli dell'infrastruttura; Mustafa Suleyman (CEO, Microsoft AI) sulla co-progettazione tra chip e modello; Jim Kleewein (Technical Fellow, Microsoft 365) su Maia che alimenta le esperienze AI in Microsoft 365. Per i contenuti completi, consultate la pagina originale.
Deep dive: come è fatta l'architettura di Maia 300#
Dati prima di tutto: l'architettura SDLA#
Maia 200 ha introdotto l'architettura SDLA, cioè Software Defined Locally Accessed Dataflow Architecture. Il software decide esplicitamente dove collocare i dati, come spostarli, convertirli e sincronizzarli tra memorie locali, motori DMA, unità di calcolo e rete, mentre il controllo resta separato dall'esecuzione.
Con Maia 300 la memoria passa da un'organizzazione uniforme (UMA) a una non uniforme (NUMA) tra i chiplet. Ogni zona di calcolo ha memoria vicina, quindi i dati viaggiano su distanze più brevi e consumano meno energia.
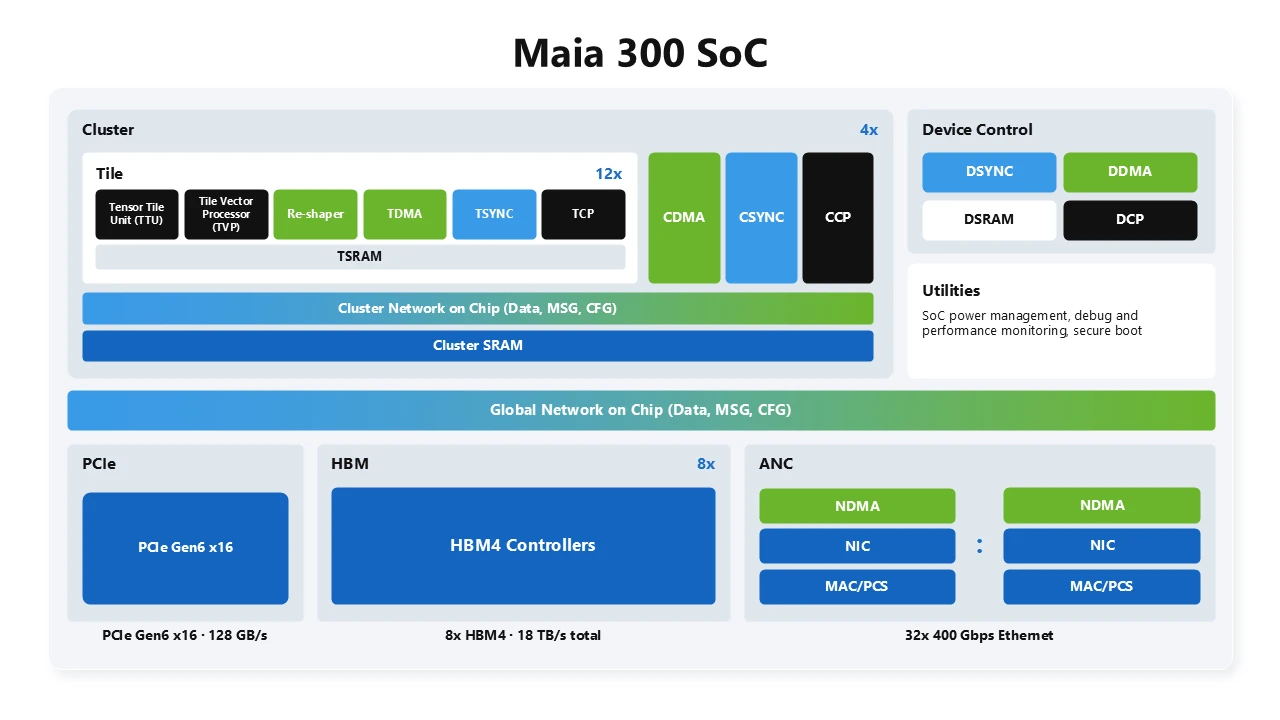
Chiplet e formati a bassa precisione#
Il calcolo è realizzato sul processo TSMC N2P, mentre controller di memoria e I/O sono su chiplet separati, ottimizzati per banda, connettività e costo. Secondo Microsoft, rispetto a Maia 200 questa scelta porta +36% di FLOPS di calcolo, 2,5 volte la banda HBM e +14% di banda scale-up, con circa il doppio di banda HBM per watt. Sono dati dichiarati dal produttore. I formati a bassa precisione, come MXFP4 e quelli sotto i 3 bit, riducono i byte da spostare per ogni token.
SDLA: architettura in cui il software governa il percorso dei dati.
NUMA: memoria non uniforme, con zone di memoria vicine a ciascun blocco di calcolo.
MXFP4: formato numerico a bassa precisione, che occupa meno memoria.
HBM4: memoria ad alta banda; Maia 300 ne usa 8 stack per 288 GB e 18 TB/s per acceleratore.
Rete: un unico tessuto Ethernet#
Maia 300 usa un solo tessuto Ethernet per il dominio scale-up, dentro il pod e fino al superpod, con la stessa semantica di comunicazione. Esistono tre domini di latenza: la coppia diretta di acceleratori, gli acceleratori dello stesso pod a un hop di switch e quelli di pod diversi a tre hop. Un rack contiene 96 acceleratori, e un superpod arriva fino a 12.288 acceleratori su 128 rack, collegati con ottiche tra i rack.
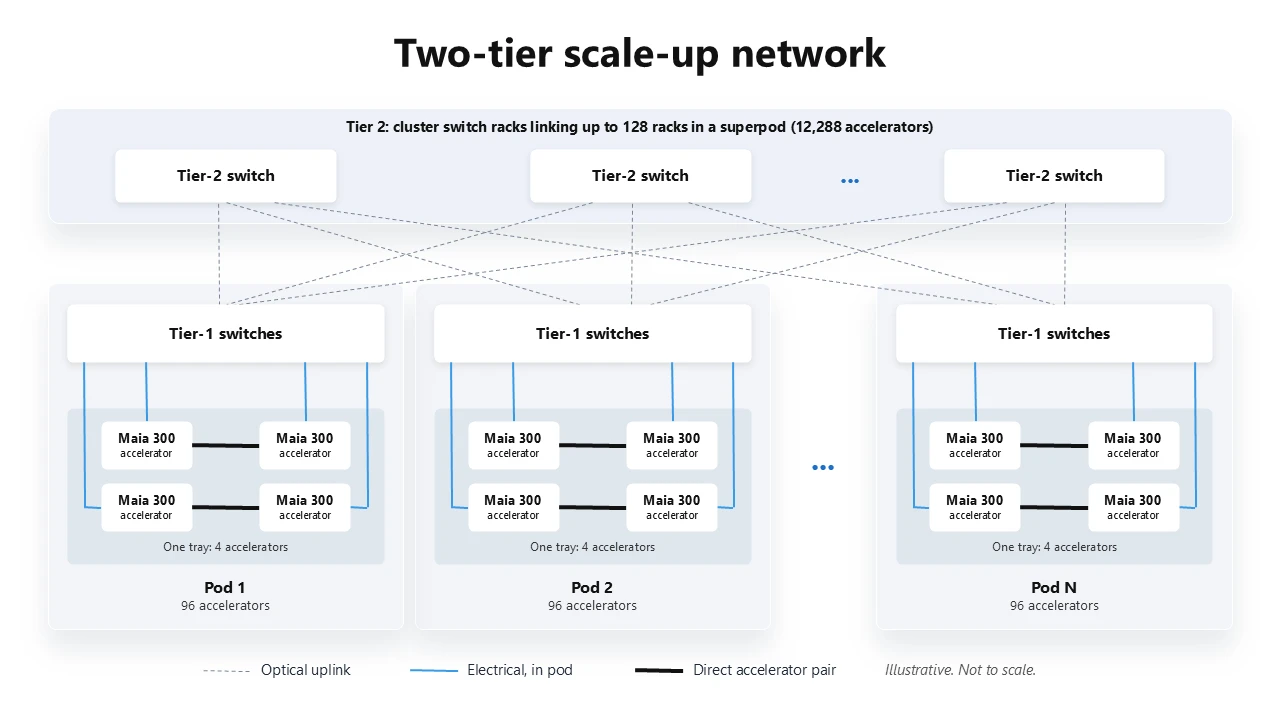
Per i dettagli tecnici completi, consultate la fonte originale: Deep dive into Azure Maia 300 architecture.
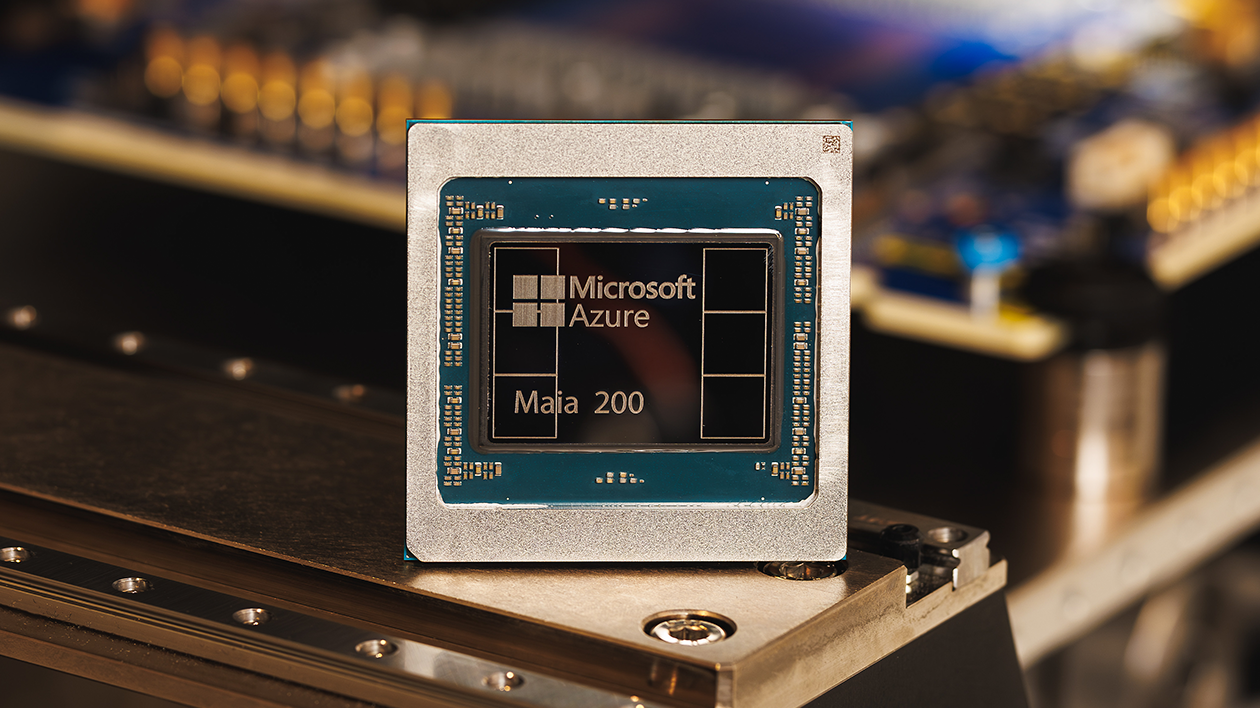
Maia 200 in video e in galleria#
La pagina ufficiale di Maia 200 raccoglie sei immagini, tra silicio, acceleratore, sistema, hardware, rack e blade server, insieme a due video di presentazione. Qui ne trovate tre, per vedere il chip da vicino e il contesto in cui viene testato. Microsoft dichiara un 30% di migliore rendimento per dollaro rispetto ai sistemi esistenti: è un’affermazione del produttore, che in queste fonti non trova conferme indipendenti. Per approfondire, consultate la pagina Maia 200.
Maia 200 in numeri: 216 GB di HBM3e e 750 W#
Specifiche dichiarate da Microsoft#
Secondo il post ufficiale Microsoft, Maia 200 è un acceleratore per l'inferenza costruito con processo TSMC a 3 nanometri, con oltre 140 miliardi di transistor per chip. Microsoft dichiara oltre 10 petaFLOPS in FP4 e oltre 5 petaFLOPS in FP8, entro un TDP SoC di 750 W.
HBM3e a 7 TB/s
TDP SoC
Banda scale-up bidirezionale
Acceleratori per cluster
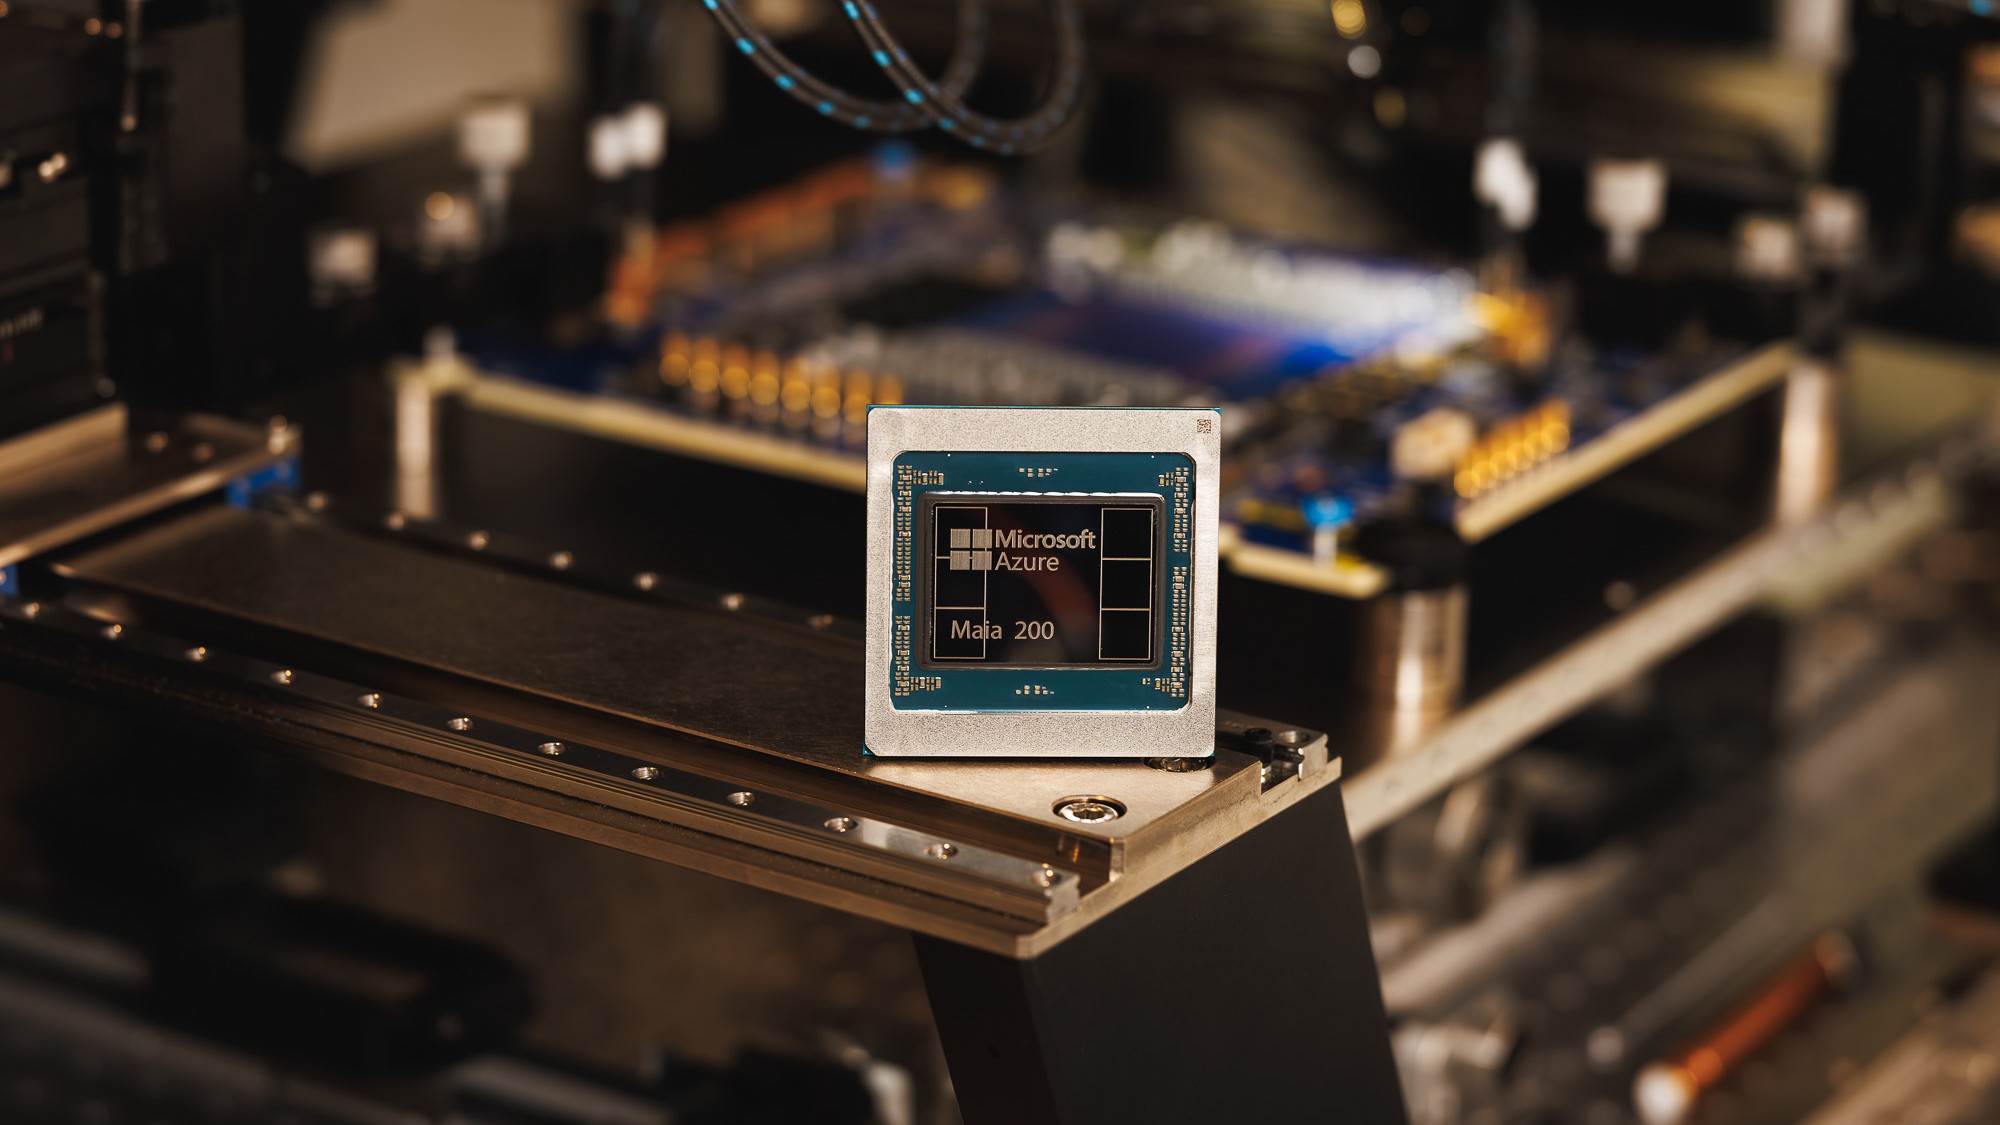
La memoria comprende 216 GB di HBM3e a 7 TB/s e 272 MB di SRAM on-chip. Ogni acceleratore espone 2,8 TB/s di banda scale-up bidirezionale su Ethernet standard, con cluster fino a 6.144 acceleratori.
Microsoft confronta il chip con la terza generazione di Amazon Trainium, dichiarando tre volte la performance FP4, e con la settima generazione di Google TPU, dichiarando una performance FP8 superiore. Si tratta di affermazioni del produttore.
Maia 200 è distribuito nella regione US Central vicino a Des Moines, Iowa. La regione US West 3 vicino a Phoenix, Arizona, è indicata come prossima in arrivo.
Come leggere questi numeri: metodo e limiti#
Chi ha misurato i dati#
Quasi tutti i numeri di questo articolo sono dichiarazioni di Microsoft, contenute nel blog ufficiale, nel blog Azure e nella pagina tecnica su Maia 300. Nelle fonti consultate non compaiono test indipendenti: i valori vanno letti come affermazioni del produttore.
Confronti e basi di misura#
Il 40% di token per megawatt è confrontato con «leading GPU-based systems», senza nomi di prodotti né configurazioni dichiarate.
Il 7 volte di throughput a livello di rack e i 2,5 volte di prestazioni per watt sono confronti con Maia 200, non con sistemi GPU.
Il 2,5 volte di banda HBM è una misura diversa dalle prestazioni per watt: non va sommato o sovrapposto ad altri valori.
La nozione di token non è definita nei testi, quindi il confronto dipende dal modo in cui Microsoft la conta.
Cosa non si sa ancora#
Le fonti non danno prezzi per Maia 300, né costi per token o per ora di calcolo, quindi il vantaggio in termini di costo non è quantificabile. I valori della tabella di sintesi sono letti dall'immagine ufficiale del produttore e non da un dataset verificabile. Per valutare l'effetto sui vostri costi servono benchmark indipendenti e informazioni commerciali che oggi non sono pubbliche.
Cosa significa per un'azienda#
Le fonti descrivono Maia come infrastruttura interna di Azure e non dicono che sia venduta separatamente, quindi le scelte concrete riguardano i servizi che la utilizzano.
Verificate quali servizi Microsoft girano su Maia prima di scegliere un fornitore. Le fonti indicano Maia 200 al servizio di Microsoft Copilot, mentre GitHub Copilot e Microsoft Foundry dovrebbero seguire entro fine anno. Chiedete al fornitore se il vostro servizio è su questa infrastruttura.
Chiedete la disponibilità nella vostra regione. Le fonti citano US Central, vicino a Des Moines, nell'Iowa, e US West 3, vicino a Phoenix, in Arizona, oltre a Stati Uniti, Europa e Australia in generale, senza un elenco completo di regioni.
Misurate il costo per risultato sui vostri carichi di lavoro. Le percentuali di miglioramento, come il 30% di performance per dollar e il 40% di token per megawatt, sono dichiarazioni del produttore e vanno verificate con i vostri dati.
Distinguete l'uso dell'AI come servizio dallo sviluppo di modelli. La preview dell'SDK Maia, con compilatore Triton, supporto a PyTorch e simulatore, è rivolta a sviluppatori, startup e ricercatori, quindi riguarda chi costruisce o ottimizza modelli.
Confrontate i fornitori con la guida testo, usando gli stessi criteri su costi, regioni e servizi disponibili.
Domande frequenti#
Quando entra in produzione Maia 300?
Le fonti indicano che le distribuzioni in produzione di Maia 300 partono nel 2027. Microsoft prevede di scalare la famiglia Azure Maia a distribuzioni multi-gigawatt a partire dallo stesso anno, rendendo Maia il sistema principale per l'inferenza dei prodotti Microsoft.
Che cosa significa inferenza, in parole semplici?
È la fase in cui un modello già addestrato produce le risposte, generando i token che compongono testi e risposte. Maia 300 è progettata soprattutto per questa fase, con contesti lunghi e compiti agentici in più passaggi.
Maia 300 sostituisce le GPU?
Le fonti non dicono questo. Descrivono un'infrastruttura eterogenea, in cui convivono più tipi di acceleratori e più modelli. Il confronto riportato è con i sistemi basati su GPU: Microsoft dichiara fino al 40% di token in più per megawatt, come previsione del produttore.
Qual è la differenza tra Maia 200 e Maia 300?
Maia 300 porta a 96 acceleratori il rack, che nel sistema precedente raddoppia la densità. Secondo Microsoft, nella configurazione completa offre fino a 7 volte il throughput di token a livello di rack rispetto a Maia 200. Ogni acceleratore dispone di 288 GB di HBM4 con 18 TB/s, contro 216 GB e 7 TB/s di Maia 200: capacità di memoria più alta del 33% e banda 2,5 volte superiore.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 6/10 | Microsoft dichiara fino a 7 volte il throughput per rack rispetto a Maia 200 e il 40% di token in più per megawatt, ma sono dati del produttore non verificati da test indipendenti. |
Prezzo e disponibilità | 3/10 | Le produzioni sono previste a partire dal 2027 e le fonti non indicano prezzi né modalità di acquisto per clienti esterni. |
Apertura e licenza | 4/10 | Le fonti non dichiarano il modello di licenza; l'SDK in anteprima citato riguarda Maia 200, non Maia 300. |
Trasparenza dei dati | 6/10 | Le fonti pubblicano specifiche dettagliate (288 GB di HBM4, 18 TB/s, 950 W di TDP, 167 kW per rack), ma la tabella riporta una cluster size di 12000 mentre il testo indica 12.288 acceleratori. |
Uso in azienda | 5/10 | Il sistema è destinato a carichi di inferenza di Microsoft come Copilot, GitHub Copilot e Foundry, mentre l'uso da parte di terzi non è descritto. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Maia 300 è l'acceleratore AI di Microsoft per l'inferenza, previsto in produzione dal 2027; le prestazioni dichiarate dal produttore non risultano verificate da terzi.
Per chi deve decidere, le fonti descrivono in dettaglio l'architettura e le specifiche di Maia 300, ma non ne indicano prezzi, disponibilità per clienti esterni né condizioni di licenza. I vantaggi in termini di token per megawatt e di throughput per rack sono dichiarati dal produttore e non verificati da terzi. Ai fini di una valutazione operativa, conviene attendere dati indipendenti e la disponibilità commerciale prevista dal 2027.
Punti di forza
- Un rack integra 96 acceleratori entro 167 kW, con 27,6 TB di capacità HBM e 1,7 PB/s di banda HBM aggregata.
- Ogni chip combina otto stack HBM4 da 288 GB con 18 TB/s di banda di picco entro un TDP di 950 W.
- Il raffreddamento a liquido rimuove oltre l'80% del carico termico del rack dagli acceleratori, dai regolatori di tensione e dagli switch ASIC.
- Le fonti offrono una documentazione tecnica pubblica dettagliata sull'architettura.
Limiti
- La produzione è prevista a partire dal 2027 e le fonti non indicano disponibilità per clienti esterni.
- I prezzi non sono indicati nelle fonti.
- Le prestazioni dichiarate sono affermazioni del produttore e non risultano verificate da test indipendenti.
- La tabella delle specifiche e il testo non coincidono sul numero di acceleratori nel superpod (12000 contro 12.288).
- Le fonti non dichiarano licenza né grado di apertura della piattaforma.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
5- 1.Microsoft — Microsoft to expand Azure Maia system to multi-gigawatt deployments - The Official Microsoft Blogblogs.microsoft.com
Annuncio ufficiale da cui nasce l’articolo.
- 2.Microsoft — Before - Microsoft's latest custom chip: Maia 300news.microsoft.com
Documento ufficiale collegato all’annuncio.
- 3.Microsoft — Deep dive into Azure Maia 300 architecture | Microsoft Azure Blogazure.microsoft.com
Documento ufficiale collegato all’annuncio.
- 4.
- 5.Microsoft — Maia 200: The AI accelerator built for inference - The Official Microsoft Blogblogs.microsoft.com
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.