Un milione di token di contesto, testo, immagini, video e PDF, agenti che si dividono il lavoro e un'API compatibile con OpenAI a 1,25 $ per milione di token. Cosa ha presentato Meta Superintelligence Labs e cosa resta da verificare.
Muse Spark 1.1 di Meta: contesto da 1 milione di token, API compatibile con OpenAI a 1,25 $ e 4,25 $ per milione di token, benchmark e limiti per le aziende.
di Andrea Pirazzini
Fonte primaria
Meta AI — annuncio di Muse Spark 1.1 e demo ufficiali, 9 luglio 2026
ai.meta.com
Versione audio
2 min 48 s
Perché se ne parla#
Il 9 luglio 2026 Meta Superintelligence Labs, il laboratorio di Meta guidato da Alexandr Wang, ha pubblicato Muse Spark 1.1. È il primo modello di ragionamento multimodale del laboratorio ed è un aggiornamento corposo del precedente Muse Spark: contesto da 1 milione di token, testo, immagini, video e PDF gestiti in modo nativo, e soprattutto la capacità di lavorare come agente, cioè di usare strumenti, app e computer per portare a termine un compito.
La vera notizia per chi sviluppa, però, è un'altra: con Muse Spark 1.1 arriva la Meta Model API, la prima API pubblica di Meta per i suoi modelli, in anteprima e compatibile con lo standard di OpenAI.
Lo stesso giorno sono usciti anche Muse Image e, in anteprima, Muse Video. I tre modelli insieme formano la prima famiglia multimodale completa del laboratorio, nato dopo l'operazione di Meta su Scale AI con l'obiettivo dichiarato di costruire una "superintelligenza personale".
token di contesto
testo, immagini, video e PDF
per milione di token in ingresso
4,25 $ in uscita
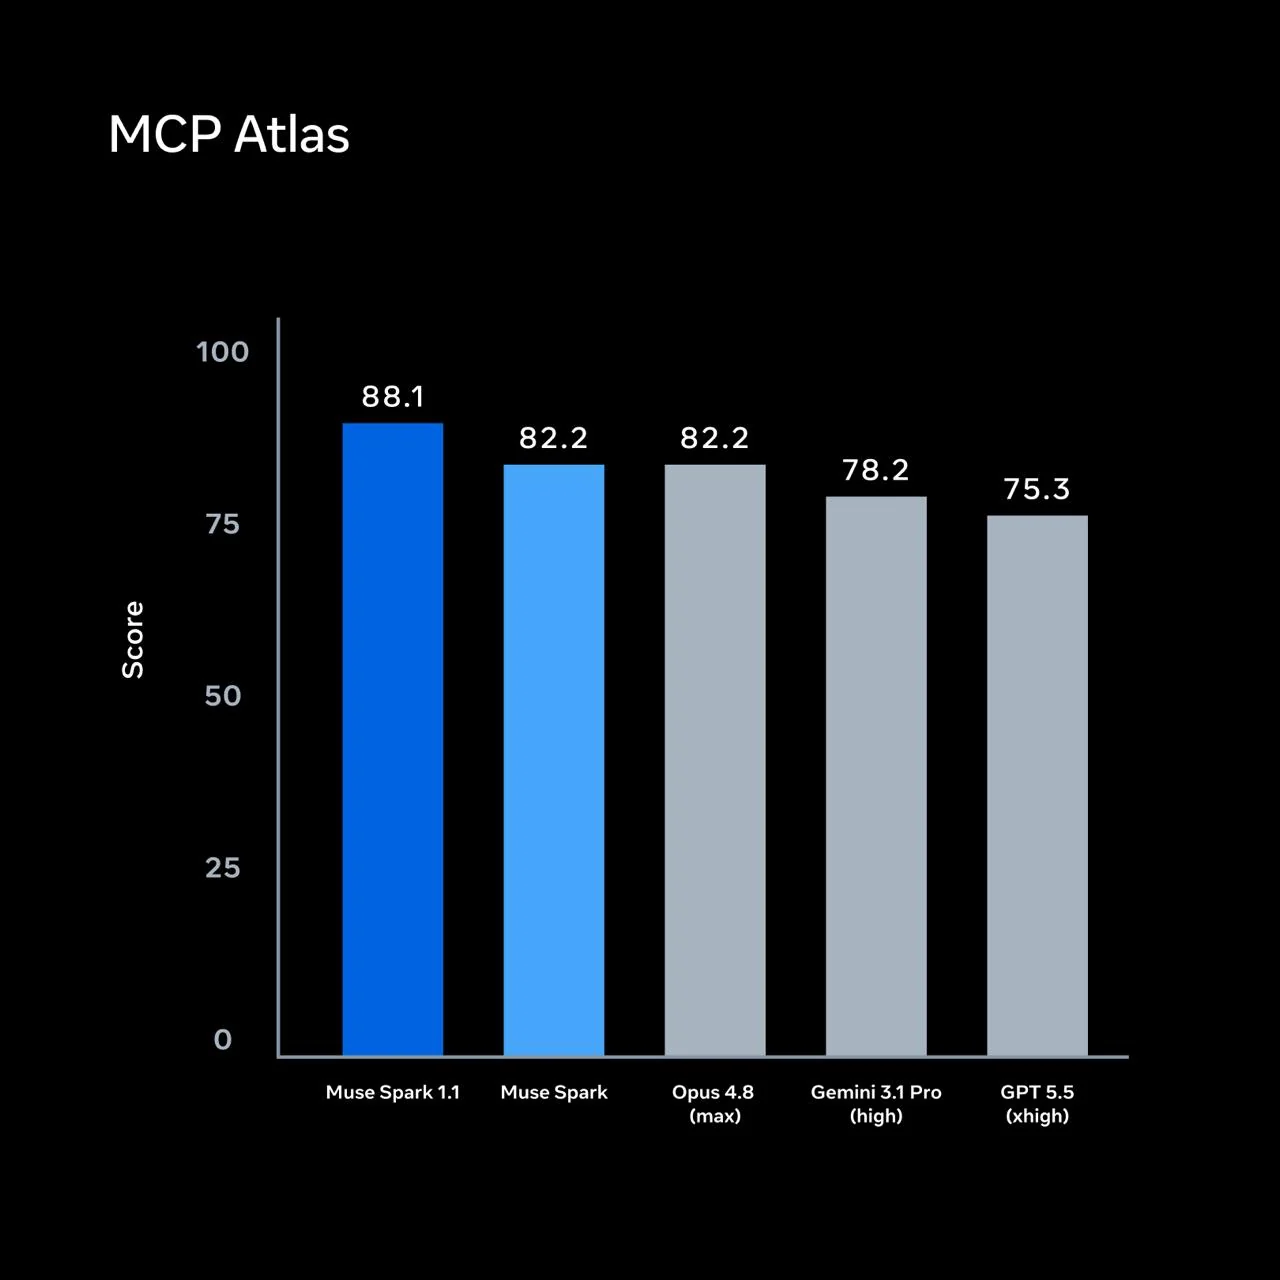
su MCP Atlas, primo tra i modelli confrontati da Meta
punti su DeepSWE 1.1 rispetto a Muse Spark
La scheda#
Voce | Cosa dichiara Meta |
|---|---|
Tipo di modello | Ragionamento multimodale, pensato per compiti agentici |
Contesto | 1.000.000 di token |
Cosa legge | Testo, immagini, video, PDF |
Strumenti integrati | Ricerca con citazioni, output strutturato, chiamate a funzione, più strumenti in parallelo |
Modalità Thinking | Sì, nell'app Meta AI, su meta.ai e via API |
Lingue | Multilingue |
API | Meta Model API, in anteprima pubblica, compatibile con OpenAI |
Prezzo API | 1,25 $ input · 4,25 $ output per milione di token |
Crediti iniziali | 20 $ per ogni nuovo account |
Disponibilità API al lancio | Stati Uniti |
Rispetto a Muse Spark, Meta indica miglioramenti netti in quattro aree: uso degli strumenti, uso del computer, programmazione e comprensione di immagini e video.
Quattro demo per capire cosa sa fare#
Meta ha accompagnato il lancio con quattro dimostrazioni. Valgono come esempi scelti dal produttore, ma rendono bene l'idea.
1. Organizzare una grigliata#
Ash deve organizzare un barbecue: mettere d'accordo gli invitati, scegliere un fornitore e, a un certo punto, fare i conti con il meteo che cambia. Il modello scrive ai fornitori su Messenger, verifica chi è disponibile e, quando le previsioni peggiorano, riorganizza il piano da solo, senza che Ash debba intervenire. Nel frattempo tiene a mente ogni messaggio ricevuto, capisce cosa vuole ciascun partecipante e porta avanti più sotto-attività in parallelo.
2. Descrivere un'immagine nei minimi dettagli#
La seconda demo si chiama action captioning. Il modello esamina un particolare sfocato di una bicicletta e produce una didascalia molto precisa, pensata per addestrare altri modelli di visione artificiale. Il punto è che la qualità della descrizione resta alta lungo tutto il flusso di lavoro con immagini e video.
3. Valutare sé stesso#
In OpenCode, un ambiente di programmazione, Muse Spark 1.1 esegue 20 compiti tratti da DeepSWE con diversi livelli di ragionamento, analizza come sono andati e costruisce un cruscotto con i risultati. In pratica fa il lavoro di un analista che misura le prestazioni di un sistema, e il sistema è lui.
4. Trovare e correggere un bug che si vede#
Sempre in OpenCode, il modello realizza un'applicazione web per chattare, poi si fa da solo delle schermate per scovare gli errori visibili, risale dal difetto grafico alla riga di codice responsabile, lo corregge e verifica che la correzione funzioni. Programmazione, vista e uso degli strumenti lavorano insieme.
Come lavora da agente#
Un capo e una squadra#
Muse Spark 1.1 è addestrato per funzionare in sistemi con più agenti, in due ruoli diversi:
da agente principale raccoglie il contesto, prepara un piano e affida i pezzi di lavoro a sotto-agenti che procedono in parallelo;
da sotto-agente si concentra sul proprio incarico, capisce quali strumenti ha a disposizione e sa quando fermarsi e riportare la questione all'agente principale.
Meta dichiara che, grazie a un addestramento specifico su questo coordinamento, affronta i progetti complessi molto più in fretta del predecessore, perché riduce il tempo totale dall'inizio alla fine del compito.
Un milione di token, gestito con criterio#
Il contesto da un milione di token non viene solo riempito: il modello lo gestisce. Ricorda le azioni già fatte, recupera informazioni da passaggi lontani e, quando serve, compatta la memoria tenendo solo i passaggi importanti per le fasi successive. Nella demo della grigliata è quello che gli permette di riprendere il filo con ogni invitato in modo naturale.
La modalità Thinking aggiunge un ragionamento interno più lungo: il modello pianifica prima di agire, valuta strade alternative e spiega perché ha scelto una soluzione. Si attiva sia nell'app sia via API.
Strumenti mai visti prima#
Un dettaglio che conta per chi integra: Meta afferma che il modello si adatta senza addestramento aggiuntivo a strumenti nativi nuovi, a server MCP (lo standard con cui un agente si collega a servizi esterni) e a skill personalizzate.
Usare il computer come una persona#
L'uso del computer è una delle capacità su cui Meta punta di più. Il modello osserva le interfacce, clicca, scrive, apre menu e gestisce finestre, anche su più applicazioni insieme e con informazioni che cambiano mentre lavora. Tiene il filo in sessioni lunghe, si adatta se i requisiti cambiano e si muove in interfacce che non conosce con poco aiuto umano.
La parte più interessante è la scelta del metodo. Muse Spark 1.1 decide quando conviene scrivere uno script che automatizzi il lavoro, quando è meglio cliccare direttamente sull'interfaccia e quando preparare un gruppo di azioni da eseguire in un colpo solo, per ridurre i tempi.
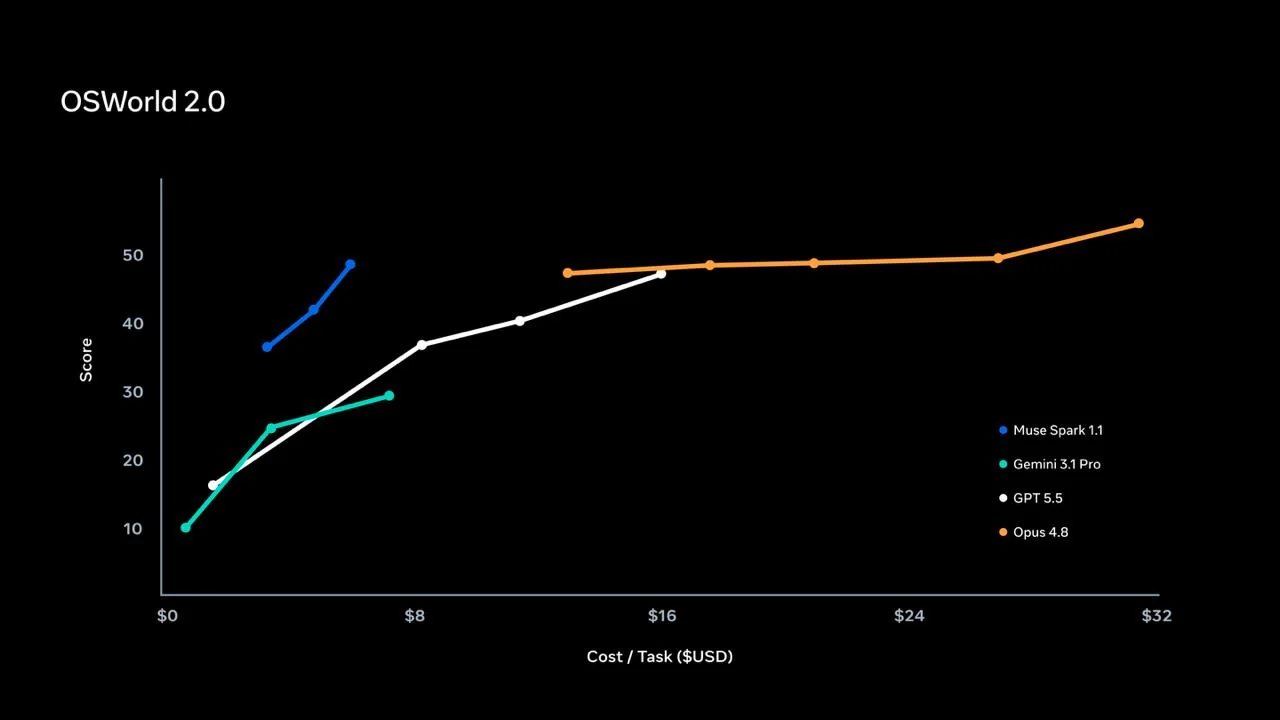
Su OSWorld-Verified, un test di uso autonomo del computer, Meta riporta questi punteggi:
OSWorld-Verified
Uso autonomo del computer, punteggio
Fonte: dichiarato da Meta, luglio 2026
I benchmark dichiarati da Meta#
Meta ha pubblicato un confronto completo con la versione precedente. Sono dati del produttore, non ancora verificati da terzi.
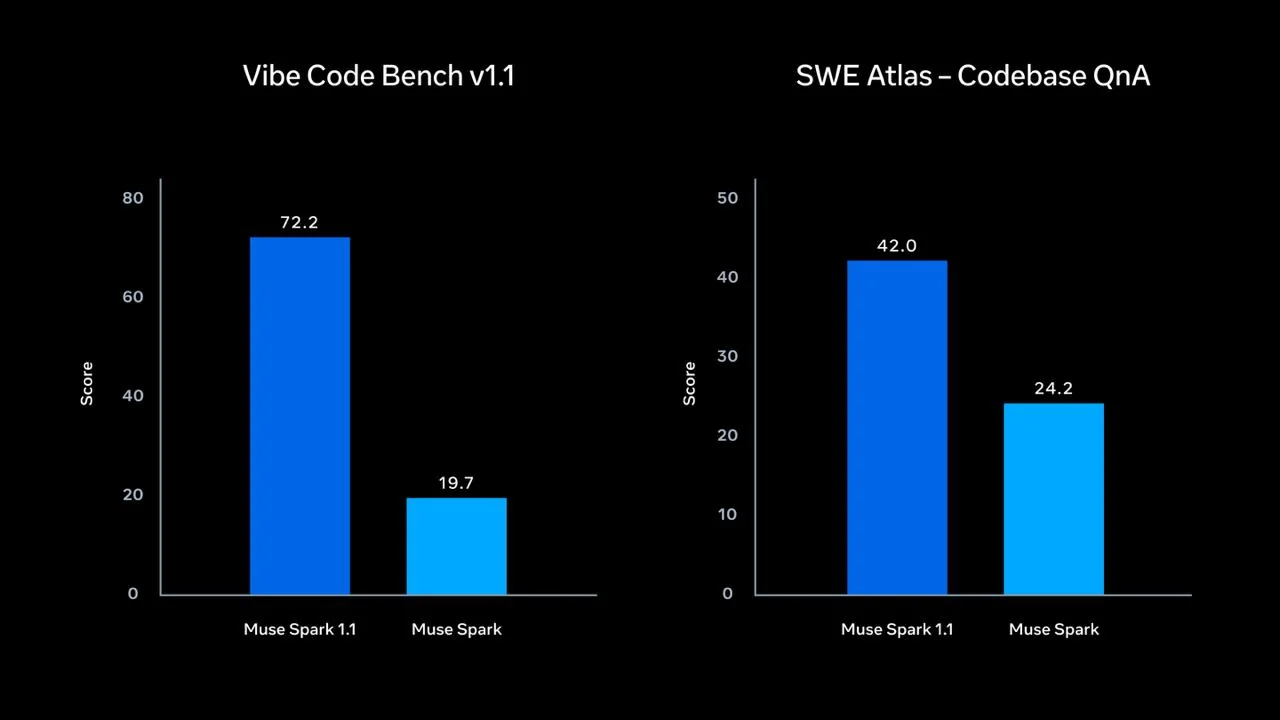
Benchmark | Cosa misura | Muse Spark 1.1 | Muse Spark | Differenza |
|---|---|---|---|---|
Vibe Code Bench v1.1 | Programmazione | 72,2 | 19,7 | +52,5 |
SWE Atlas, Codebase QnA | Domande su un codice esistente | 42,0 | 24,2 | +17,8 |
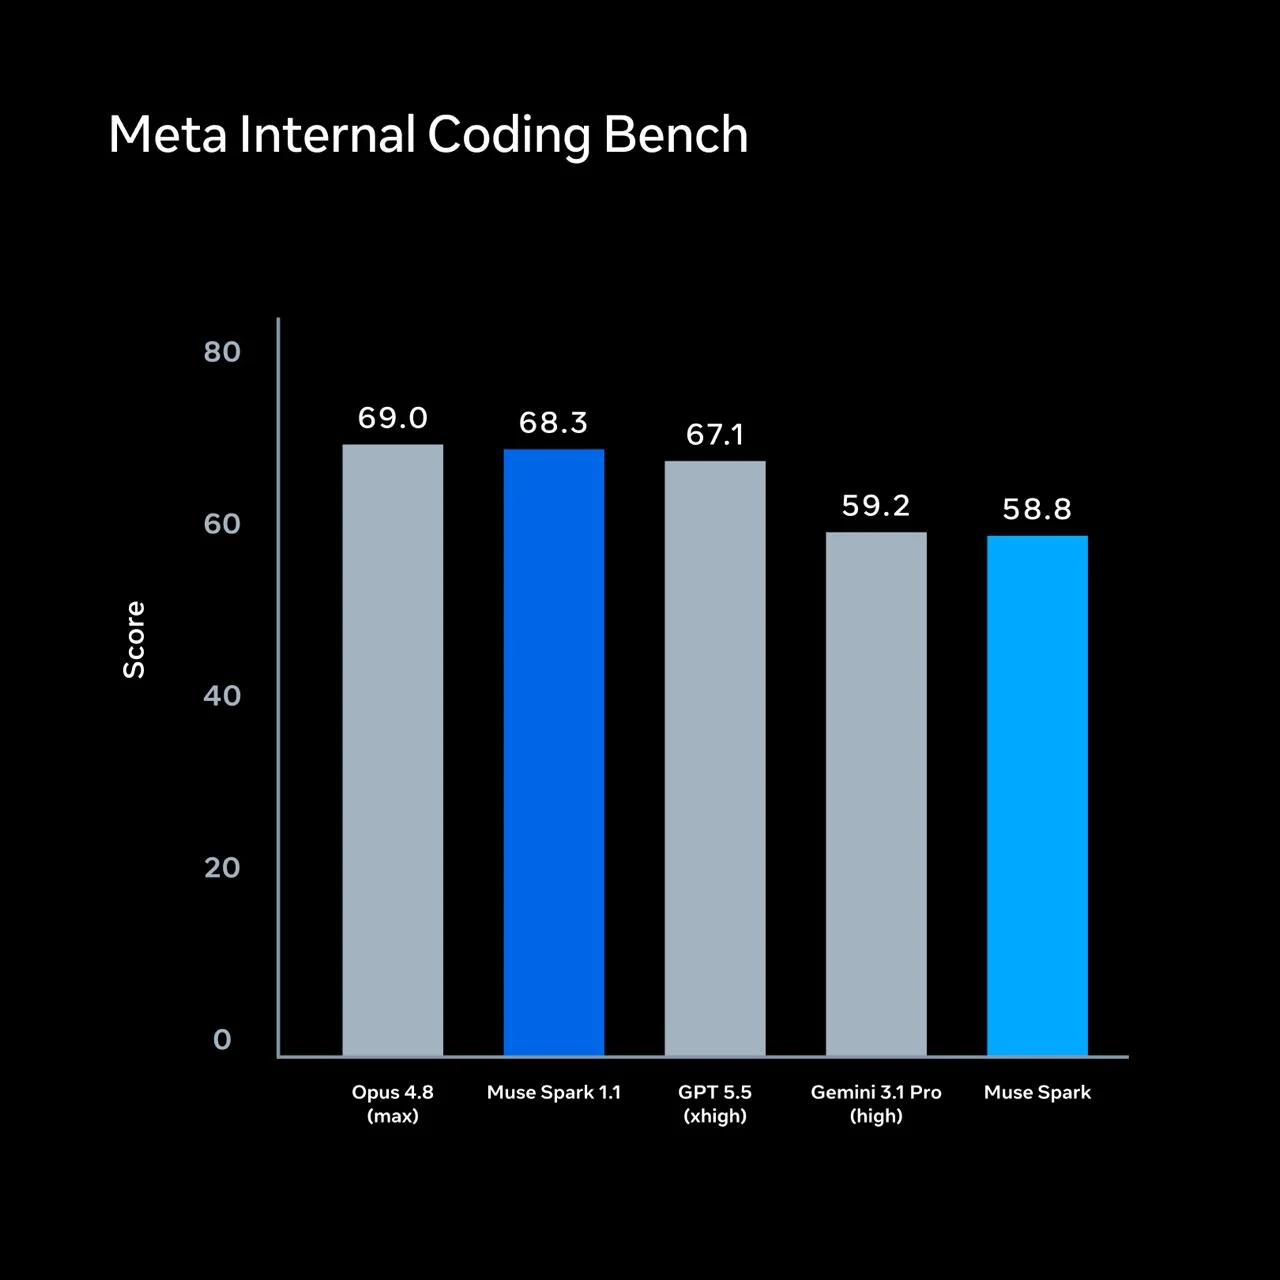
Meta Internal Coding Bench | Programmazione, test interno | 68,3 | 58,8 | +9,5 |
MCP Atlas | Uso di molti strumenti | 88,1 | 82,2 | +5,9 |
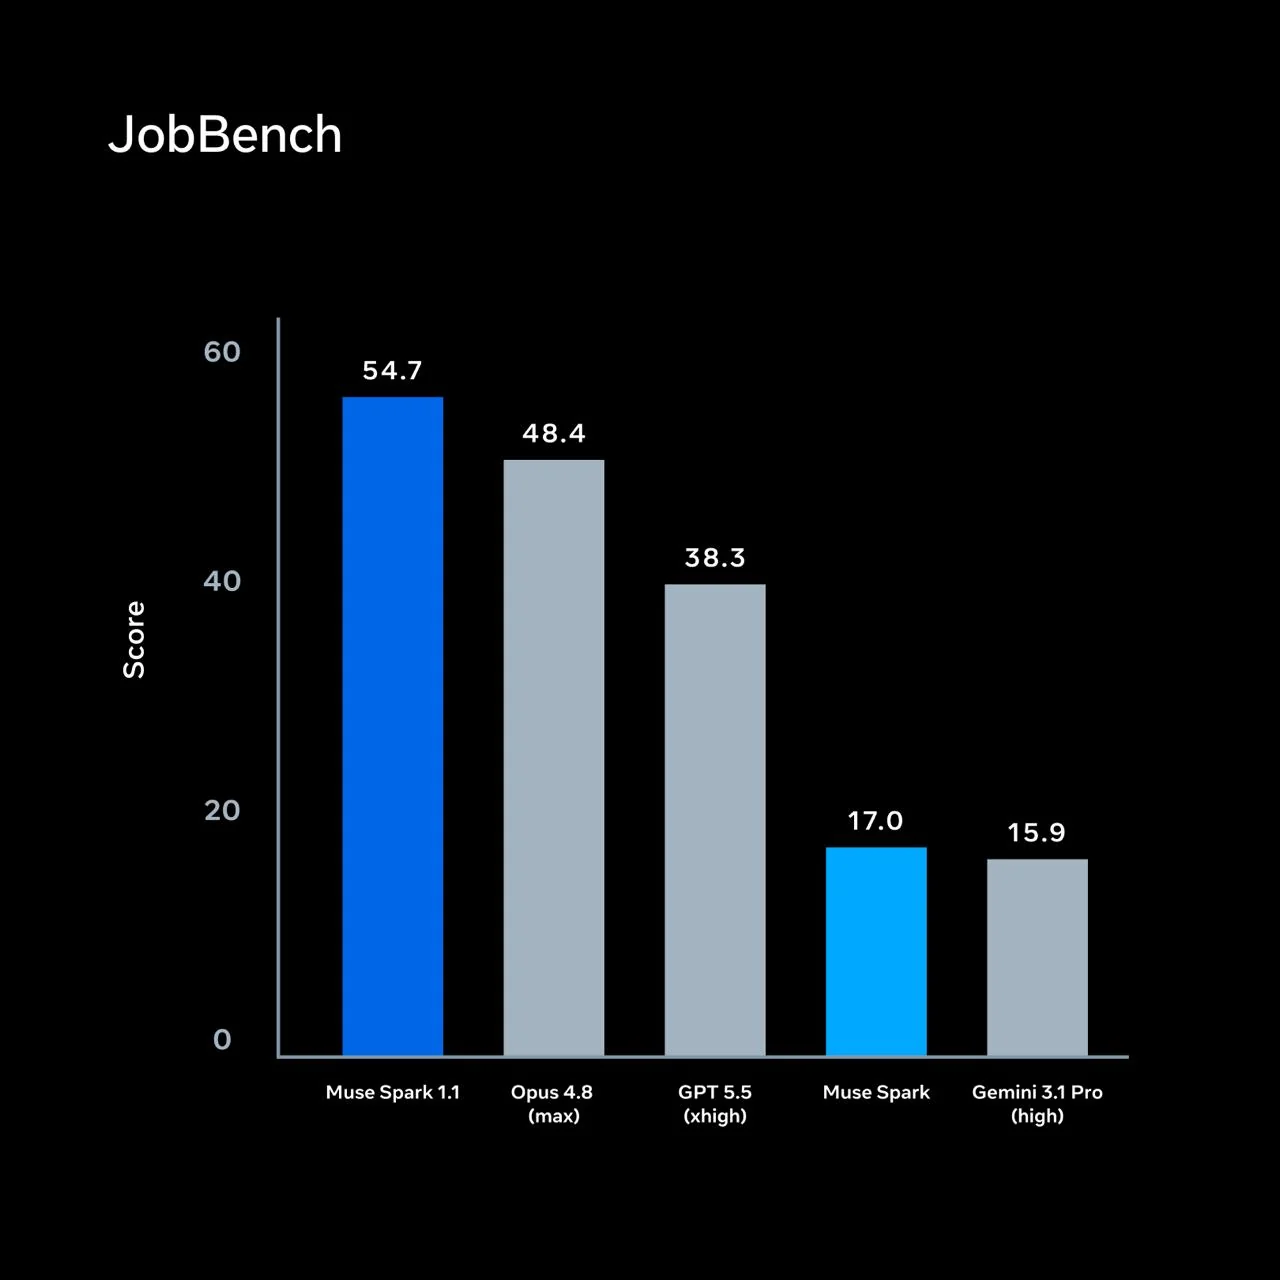
JobBench | Strumenti professionali | 54,7 | 17,0 | +37,7 |
Toolathlon-Verified | Strumenti personali | 75,6 | 49,4 | +26,2 |
Humanity's Last Exam, con strumenti | Domande difficilissime | 62,1 | 50,4 | +11,7 |
Terminal-Bench 2.1 | Lavoro nel terminale | 80,0 | 67,3 | +12,7 |
SWE-Bench Pro | Correzione di bug reali | 61,5 | 55,0 | +6,5 |
DeepSWE 1.1 | Programmazione di lunga durata | 53,3 | 10,0 | +43,3 |
CharXiv Reasoning | Lettura di grafici | 88,4 | 88,9 | -0,5 |
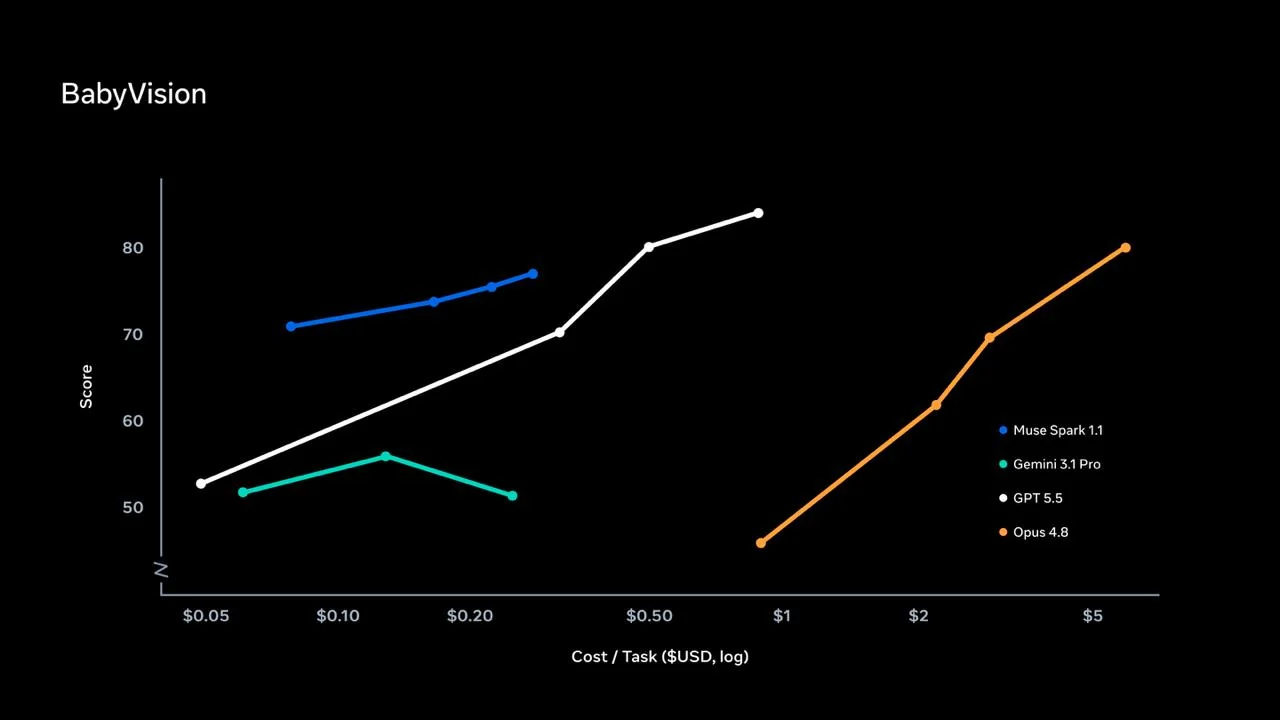
BabyVision | Ragionamento visivo | 76,3 | 39,9 | +36,4 |
Muse Spark 1.1 contro Muse Spark
Punteggi su otto benchmark
- Muse Spark 1.1
- Muse Spark
Fonte: dichiarato da Meta, luglio 2026
Gli altri quattro benchmark
Muse Spark 1.1 contro Muse Spark, punteggio
- Muse Spark 1.1
- Muse Spark
Fonte: dichiarato da Meta, luglio 2026
E rispetto ai concorrenti?#
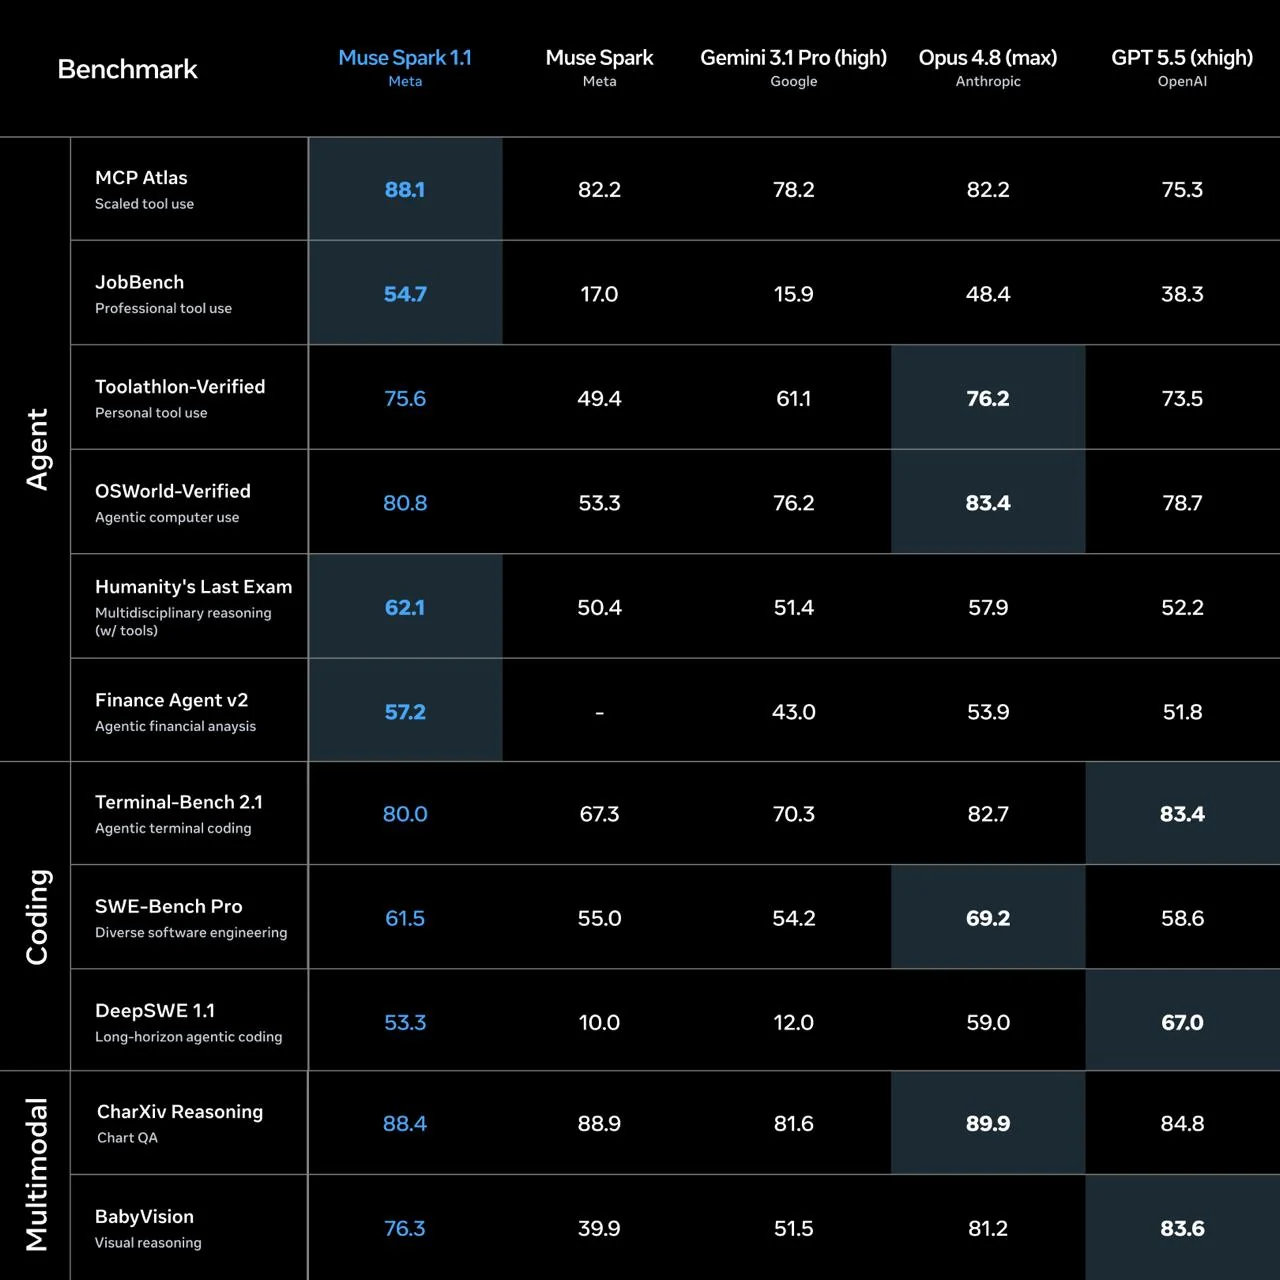
Meta ha pubblicato anche grafici di confronto con Claude Opus 4.8, GPT-5.5 e Gemini 3.1 Pro. La tabella completa divide le prove in tre famiglie: agenti (MCP Atlas, JobBench, Toolathlon, OSWorld, Humanity's Last Exam e Finance Agent), programmazione (Terminal-Bench, SWE-Bench Pro, DeepSWE) e comprensione multimodale (CharXiv, BabyVision). I valori dei concorrenti si leggono nella tabella e nei grafici ufficiali; in sintesi, le conclusioni dichiarate sono queste:
su MCP Atlas Muse Spark 1.1 è primo, davanti a tutti i concorrenti;
su JobBench fa meglio di GPT-5.5 (xhigh) e di Opus 4.8 (max);
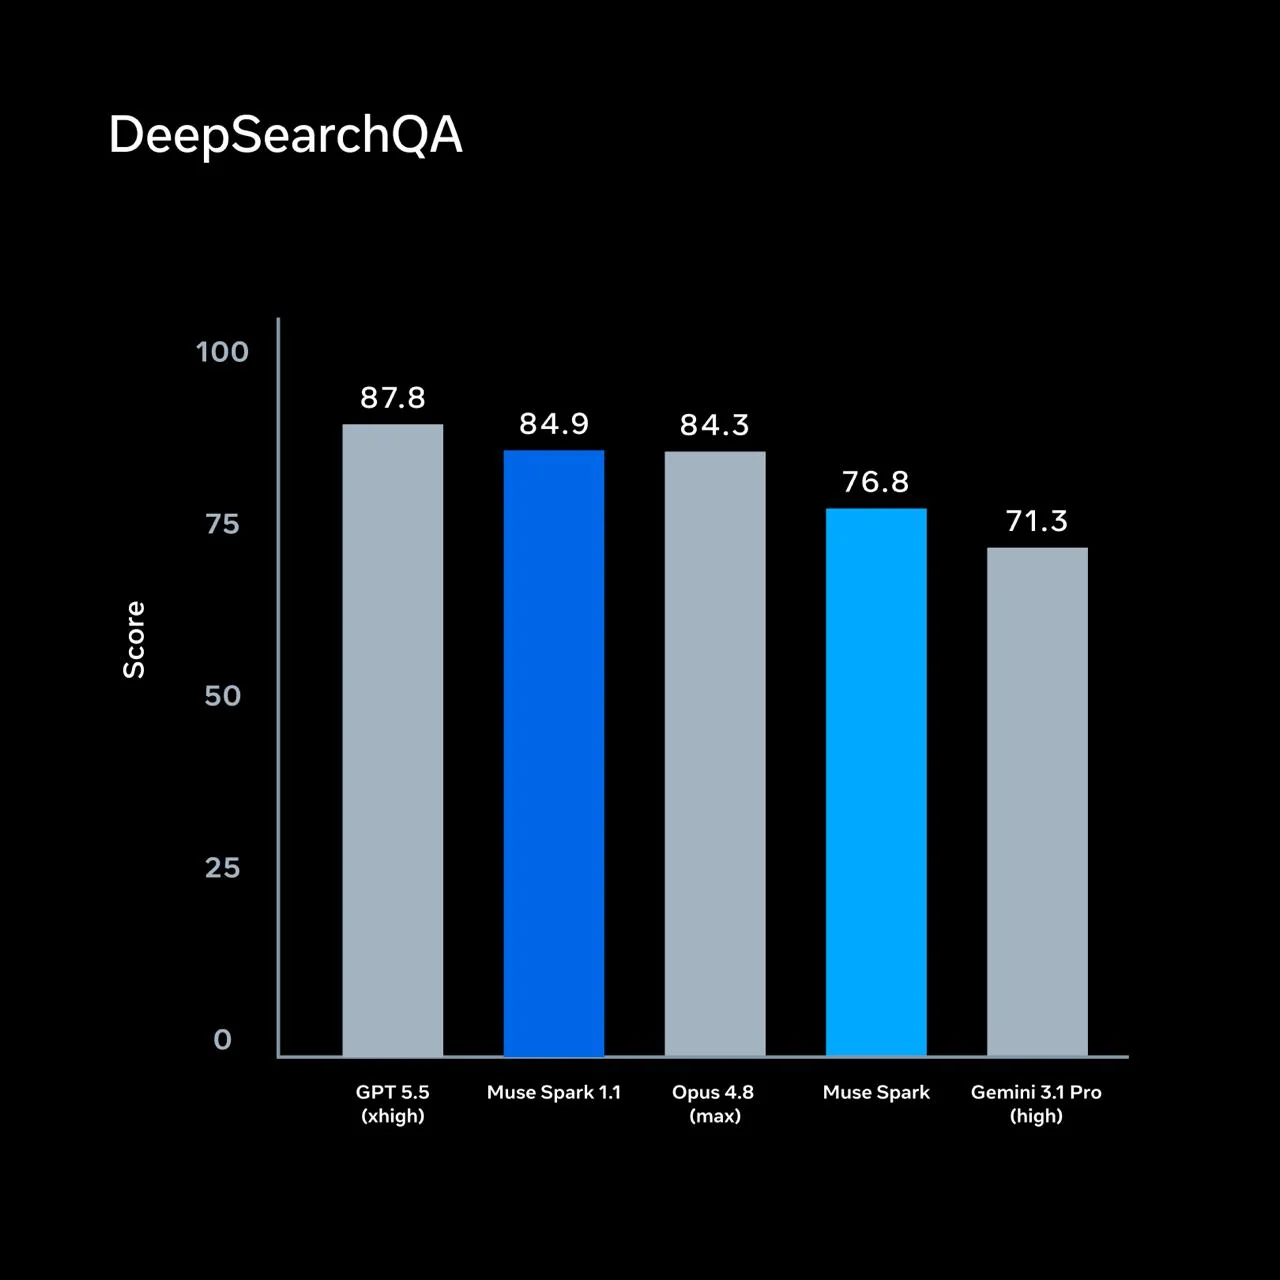
su DeepSearchQA è secondo, dietro GPT-5.5 xhigh e davanti a Opus 4.8;
sul test interno di programmazione di Meta è competitivo con Opus 4.8, GPT-5.5 e Gemini 3.1 Pro;
su BabyVision e OSWorld 2.0, guardando al costo per attività, è il migliore quando si spende poco; chi è disposto a spendere molto di più arriva più in alto con GPT-5.5 od Opus 4.8;
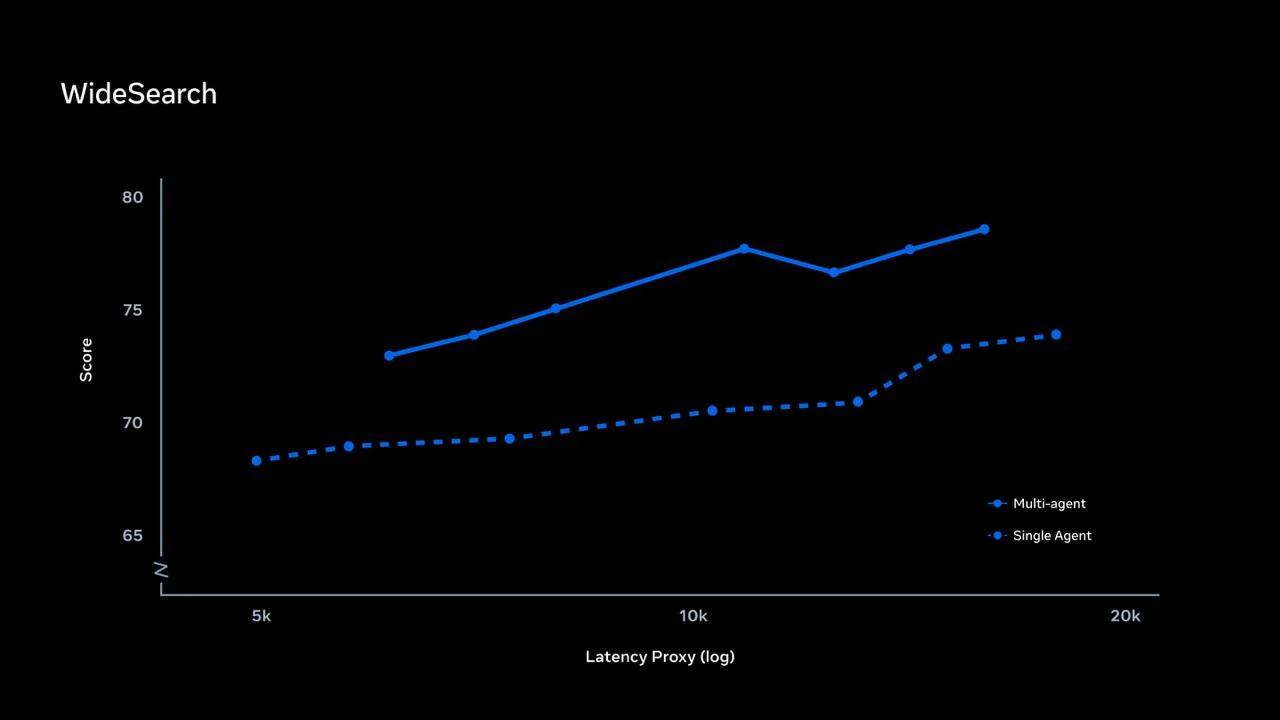
su WideSearch il sistema con più agenti batte quello con un agente solo a qualsiasi livello di latenza.
C'è però un'area in cui resta indietro, ed è quella della programmazione di lunga durata.
DeepSWE 1.1
Programmazione su compiti lunghi, punteggio
Fonte: dichiarato da Meta, luglio 2026
Sicurezza#
Prima del rilascio Meta ha valutato il modello seguendo il proprio Advanced AI Scaling Framework. Sulle categorie di rischio più gravi (armi chimiche e biologiche, sicurezza informatica, perdita di controllo) le valutazioni lo collocano, secondo Meta, entro margini considerati sicuri.
Meta dichiara inoltre che il modello:
resiste ai tentativi diretti di aggirarne le regole (jailbreak);
resiste agli attacchi indiretti nascosti in dati non affidabili, alla prompt injection e agli attacchi tramite le istruzioni dello sviluppatore;
inventa meno risposte (allucinazioni) e tende meno a dare ragione all'utente a ogni costo.
Il dettaglio sta nel Muse Spark 1.1 Evaluation Report. Per un'azienda il punto sulla prompt injection è il più concreto: un agente che legge email, pagine web o documenti di terzi può trovarsi davanti istruzioni malevole nascoste nel testo, e deve saperle ignorare.
Cosa dicono i primi partner#
Alcune aziende che hanno avuto accesso anticipato hanno commentato il lancio:
Amjad Masad, CEO di Replit, elenca tra i punti forti il contesto da un milione di token, il supporto multimodale, la ricerca con citazioni, il ragionamento e la programmazione, e lo definisce una base completa per costruire agenti.
Saoud Rizwan, CEO di Cline, sottolinea che Meta sta puntando sulla programmazione agentica seria, con un buon uso degli strumenti a un prezzo che rende sostenibili carichi di lavoro reali.
Yashodha Bhavnani, VP AI Products di Box, parla di capacità aziendali all'altezza dei migliori modelli di frontiera.
Dave Morin, della OpenClaw Foundation, lo riassume così: "Fast, powerful, and fun with OpenClaw."
Sono testimonianze di partner scelti da Meta: utili per capire il posizionamento, non una prova indipendente.
La Meta Model API e i prezzi#
È la prima volta che Meta mette a disposizione un'API pubblica per i propri modelli. È in anteprima pubblica e segue lo standard di OpenAI, quindi funziona con strumenti già diffusi come Cursor, Cline, Replit e OpenClaw. L'indirizzo è https://api.meta.ai/v1 e l'accesso avviene con una chiave API.
Per chi ha già un'integrazione basata sull'SDK di OpenAI, la prova richiede pochi cambiamenti:
from openai import OpenAI

client = OpenAI(
    api_key="LA_TUA_CHIAVE_META",          # la chiave della Meta Model API
    base_url="https://api.meta.ai/v1",     # l'indirizzo delle API di Meta
)
risposta = client.chat.completions.create(
    model="NOME_DEL_MODELLO_MUSE_SPARK",   # il nome indicato nella documentazione
    messages=[{"role": "user", "content": "Riassumi questo contratto in 5 punti."}],
)
Il listino annunciato al lancio:
Voce | Prezzo |
|---|---|
Token in ingresso | 1,25 $ per milione |
Token in uscita | 4,25 $ per milione |
Crediti gratuiti | 20 $ per ogni nuovo account |
Un esempio di calcolo#
Prendiamo un agente che in un mese legge 5 milioni di token (email, documenti, pagine) e ne scrive 1 milione:
Voce | Costo |
|---|---|
Ingresso: 5 milioni × 1,25 $ | 6,25 $ |
Uscita: 1 milione × 4,25 $ | 4,25 $ |
Totale al mese | 10,50 $ |
Con i 20 $ di crediti iniziali si coprono quasi due mesi di un carico simile. È un esempio indicativo: gli agenti che lavorano a lungo consumano molti token, e il conto vero va misurato su un caso reale.
Dove si usa#
Meta Model API, in anteprima pubblica, al lancio solo negli Stati Uniti.
App Meta AI e meta.ai, in modalità Thinking.
Strumenti per sviluppatori compatibili: SDK di OpenAI, Replit, Cline, OpenClaw, Cursor.
Cosa resta da capire#
Come si comporta nelle valutazioni indipendenti (LMArena, Artificial Analysis, LiveBench).
Se e quando accetterà l'audio in ingresso: al lancio lavora su testo, immagini, video e PDF.
Quale sarà la strada verso Muse Spark 2.0 e la generazione successiva.
Tempi e limiti della disponibilità in Europa.
Cosa significa per un'azienda#
Muse Spark 1.1 è pensato per agenti che fanno cose: rispondere a fornitori e clienti su più canali, lavorare dentro gestionali e siti web, programmare e controllare il proprio lavoro. Se state valutando un progetto del genere, tre considerazioni pratiche:
Cambiare fornitore costa poco. Con un'API compatibile con OpenAI si può mettere Muse Spark 1.1 a confronto con il modello che si usa oggi cambiando indirizzo e chiave, senza riscrivere l'integrazione.
Dipende dal lavoro. Se il compito è soprattutto usare strumenti e app, i numeri di Meta sono promettenti; se è programmazione lunga e complessa, Opus 4.8 e GPT-5.5 restano davanti.
Prima la disponibilità. Finché l'API è limitata agli Stati Uniti, per un'azienda europea è un modello da tenere d'occhio più che da mettere in produzione.
Se volete capire in concreto cosa può fare un agente in un'azienda come la vostra, trovate esempi nella guida su cosa sono gli agenti AI.
Il mio parere#
Muse Spark 1.1 è un rilascio strategico per Meta più che una corsa al primo posto. Non vince tutte le classifiche e non ci prova: offre una piattaforma equilibrata e completa, con un'API compatibile con OpenAI che abbassa molto la barriera d'ingresso per chi sviluppa. I dati di Meta lo mettono davanti a Opus 4.8 e GPT-5.5 nell'uso degli strumenti (88,1 su MCP Atlas, 54,7 su JobBench), mentre nella programmazione di lunga durata, con 53,3 su DeepSWE 1.1, resta alle spalle di GPT-5.5 (67,0) e di Opus 4.8 (59,0).
Per chi sviluppa in Italia il vantaggio più immediato è proprio la compatibilità: provarlo richiede di cambiare l'indirizzo base e poco altro. Il limite, per ora, è la disponibilità geografica. Quando arriverà anche da noi, il metodo sarà quello di sempre: un piccolo insieme di compiti reali, eseguiti con Muse Spark 1.1 e con il modello attuale, misurando qualità, costo, tempi e quante volte serve l'intervento di una persona.
Domande frequenti#
Che cos'è Muse Spark 1.1?
È il modello di Meta Superintelligence Labs pensato per compiti agentici multimodali: 1 milione di token di contesto, testo, immagini, video e PDF, e un'API compatibile con OpenAI in anteprima pubblica.
Come si può usare?
In modalità Thinking dentro l'app Meta AI e sul sito meta.ai, oppure attraverso la Meta Model API in anteprima. L'API segue lo standard di OpenAI; al lancio era disponibile negli Stati Uniti.
Quanto costa l'API?
1,25 $ per milione di token in ingresso e 4,25 $ per milione in uscita, con 20 $ di crediti gratuiti per ogni nuovo account.
Quanto è migliorato su programmazione e strumenti?
Secondo Meta, su DeepSWE 1.1 passa da 10,0 a 53,3, su MCP Atlas da 82,2 a 88,1 e su JobBench da 17,0 a 54,7 rispetto a Muse Spark.
È protetto da jailbreak e prompt injection?
Meta dichiara di sì: lo ha valutato con l'Advanced AI Scaling Framework e riporta una buona tenuta sia contro i jailbreak diretti sia contro gli attacchi indiretti e la prompt injection, oltre a meno allucinazioni e meno compiacenza. Sono valutazioni del produttore.
Che differenza c'è con Muse Image e Muse Video?
Muse Spark 1.1 ragiona e agisce su contenuti multimodali. Muse Image e Muse Video invece generano immagini e video. Insieme formano la prima famiglia multimodale completa del laboratorio.
Il mio verdetto
Per Meta è un lancio strategico: invece di inseguire il primo posto offre una piattaforma equilibrata e completa, con un’API compatibile con OpenAI. Nei test di Meta è chiaramente avanti nell’uso degli strumenti, meno nella programmazione di lunga durata, dove i migliori restano davanti. Con Muse Image e Muse Video forma la prima famiglia multimodale completa del laboratorio.
Cosa mi convince
- API compatibile con OpenAI: provarlo richiede pochissimo lavoro
- Contesto da 1 milione di token, con la compattazione della memoria nelle sessioni lunghe
- Primo nell’uso degli strumenti nei test di Meta: 88,1 su MCP Atlas e 54,7 su JobBench, davanti a Opus 4.8 e GPT-5.5
- Il sistema con più agenti batte quello con un agente solo a ogni livello di latenza
- Modalità Thinking con un ragionamento più lungo e spiegato
Cosa non mi convince
- Ancora nessuna valutazione indipendente, per esempio su LMArena o LiveBench
- Nella programmazione lunga (53,3 su DeepSWE 1.1) resta dietro Opus 4.8 (59,0) e GPT-5.5 (67,0)
- API in anteprima e, al lancio, solo negli Stati Uniti: l’arrivo in Europa è da verificare
- Un piccolo passo indietro nella lettura dei grafici su CharXiv (88,4 contro 88,9)
- Le demo mostrano compiti semplici: l’uso in azienda va ancora provato sul campo
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
3- 1.Meta AI — annuncio di Muse Spark 1.1 e demo ufficiali, 9 luglio 2026ai.meta.com
I benchmark citati nell’articolo sono tutti dichiarati da Meta.
- 2.Meta — Muse Spark 1.1 Evaluation Reportai.meta.com
- 3.Meta AI Developers — Muse Spark sulla Meta Model APIdeveloper.meta.com
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.