Laptop, desktop compatti e DGX Station per Windows: cosa annunciano NVIDIA e Microsoft e come leggere i dati del produttore
NVIDIA e Microsoft portano l'intelligenza artificiale locale su Windows con RTX Spark: laptop e desktop compatti, preordini aperti e DGX Station per Windows in arrivo nel Q4.
di Andrea Pirazzini
Fonte primaria
NVIDIA — NVIDIA, Microsoft Kick Off a New Beginning for Windows PCs With RTX Spark and AI Agents
blogs.nvidia.com
Carlo
Il Narratore · 2 min 6 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: NVIDIA — NVIDIA, Microsoft Kick Off a New Beginning for Windows PCs With RTX Spark and AI Agents.
Perché se ne parla#
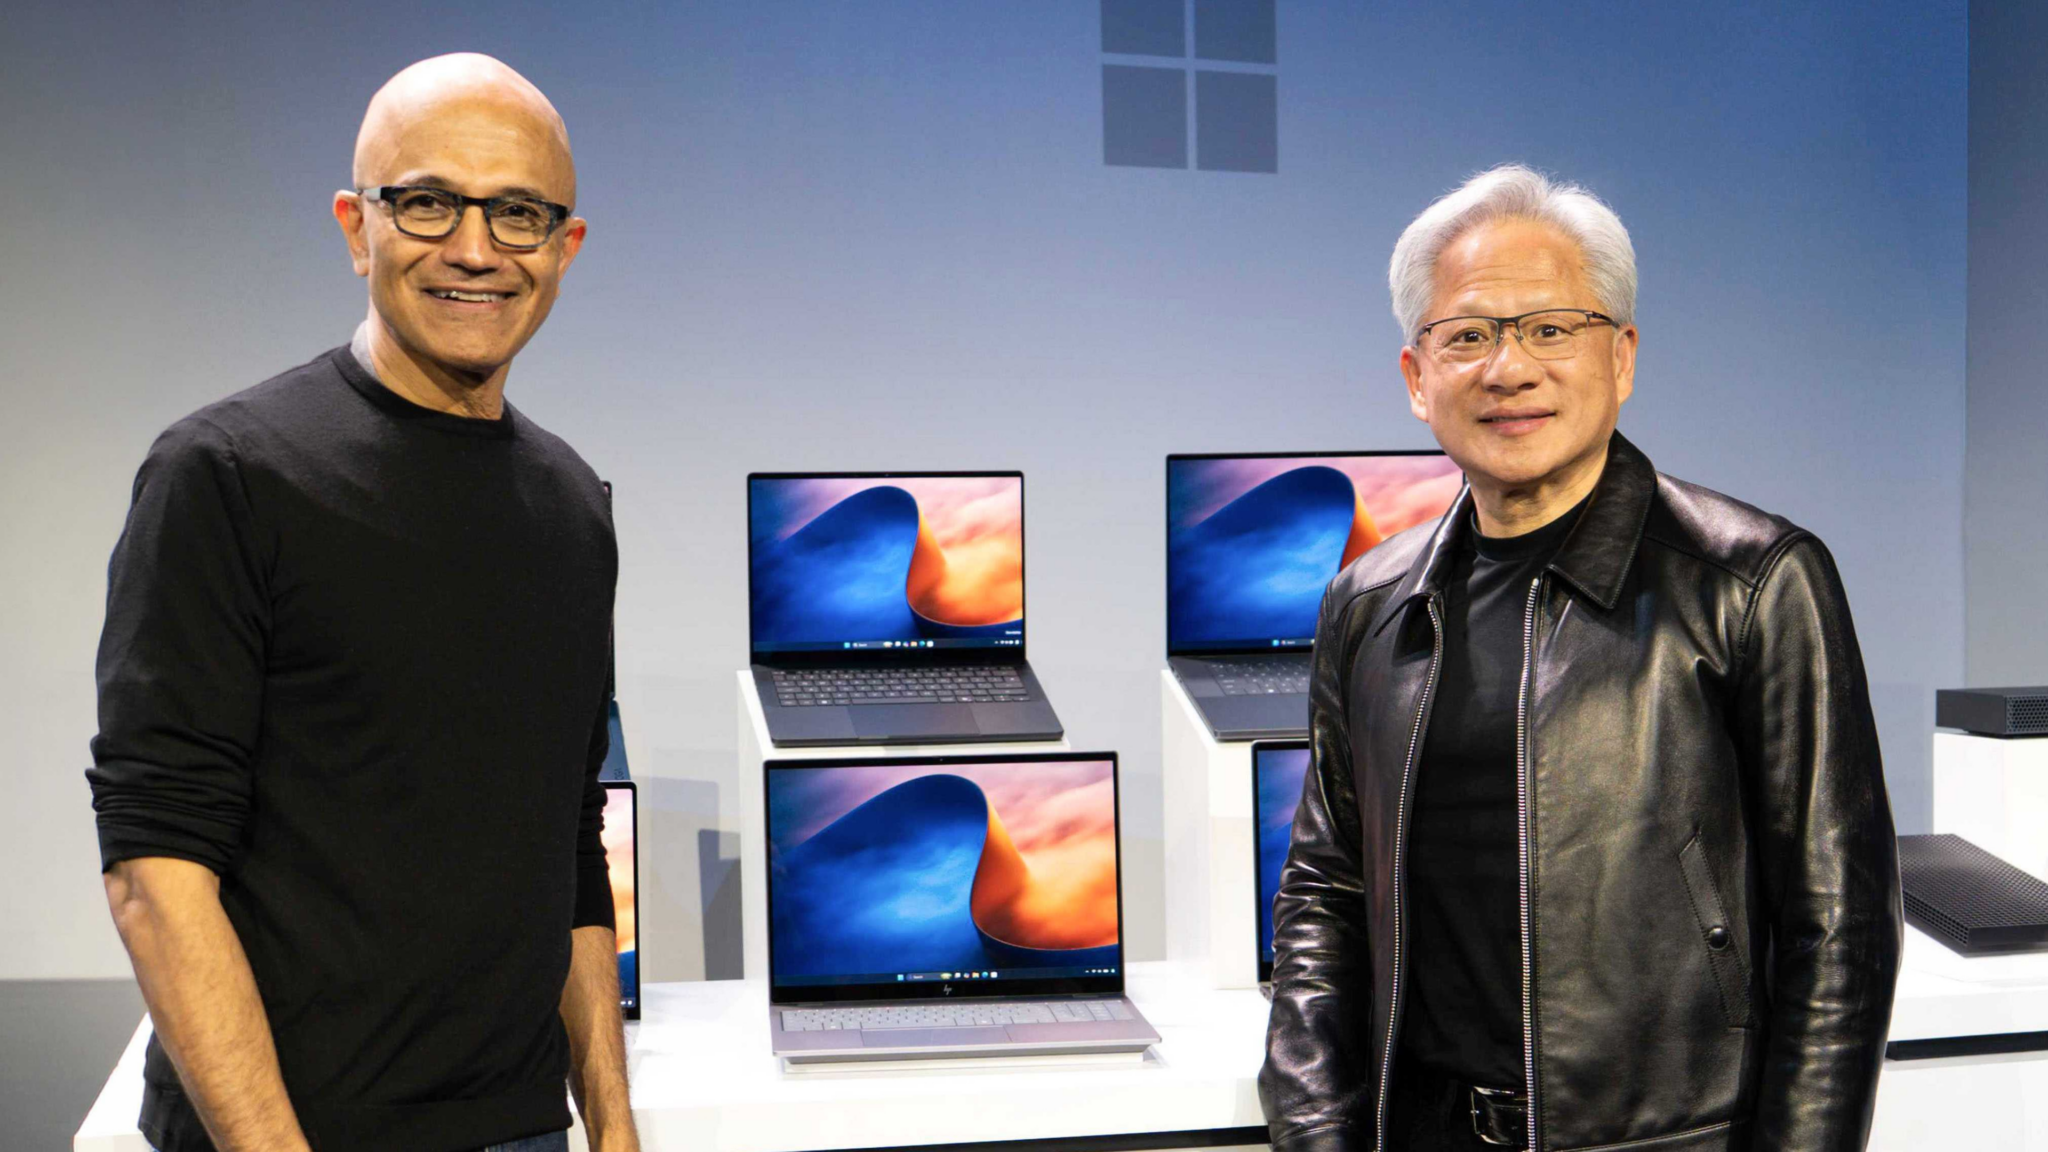
Mercoledì, durante un evento Windows AI e Surface a San Francisco, Jensen Huang, fondatore e CEO di NVIDIA, e Satya Nadella, CEO di Microsoft, hanno illustrato il lavoro comune delle due aziende su hardware e software per far girare agenti AI sui PC Windows. Huang ha ricordato che NVIDIA è nata grazie a Windows e che, senza Windows, non esisterebbe GeForce. Il filo del discorso è che il sistema operativo diventa ora il luogo in cui operano gli agenti.
Sul lato della piattaforma, Pavan Davuluri, executive vice president di Windows and Devices, ha annunciato la disponibilità generale di Microsoft Execution Containers (MXC), l'infrastruttura a livello di sistema operativo che permette agli agenti di funzionare in background in modo sicuro e persistente, sotto il controllo del sistema operativo. Davuluri ha spiegato che, insieme a Microsoft Security e Agent 365, MXC serve a rendere gli agenti sicuri, osservabili e governabili.
Nadella ha ripreso il tema affermando che il desktop deve diventare il luogo più sicuro in cui gli agenti possono eseguire attività. Huang ha paragonato MXC a ciò che Windows e DirectX hanno rappresentato per la costruzione delle applicazioni. Per i dettagli su hardware e prodotti, vi rimandiamo a NVIDIA e Microsoft: un nuovo inizio per i PC Windows.
RTX Spark in sintesi#
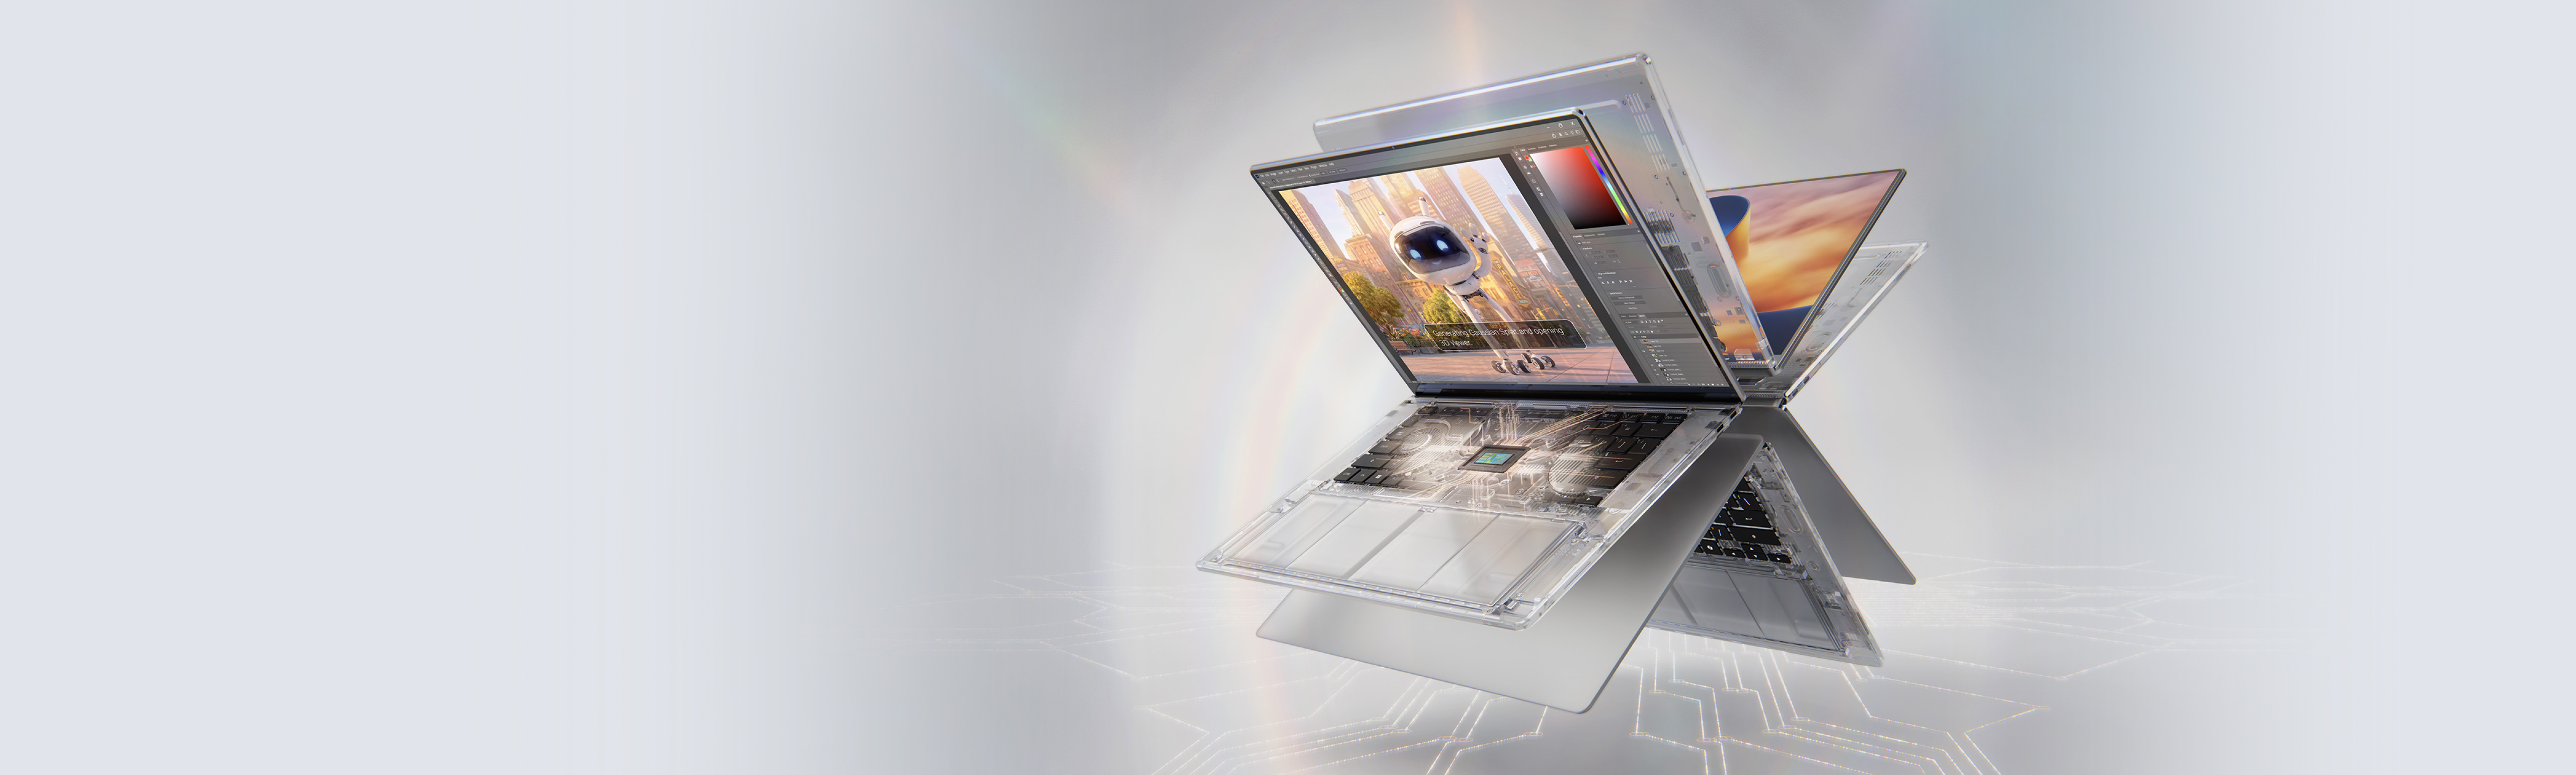
RTX Spark è il superchip con cui NVIDIA porta l'AI locale nei PC Windows: una GPU Blackwell RTX fino a 6.144 core e una CPU Grace fino a 20 core, collegate a 600 GB/s. Il chip offre fino a un petaflop di prestazioni FP4 e fino a 128 GB di memoria unificata. Il produttore afferma che, con questa configurazione, è possibile eseguire modelli in locale senza inviare dati al cloud; si tratta di una dichiarazione di NVIDIA, non verificata in modo indipendente.
I sistemi annunciati arrivano da Acer, ASUS, Dell, HP, Lenovo, Microsoft, MSI e Gigabyte, dai laptop sottili ai desktop compatti. I preordini dei laptop sono aperti e la vendita parte da venerdì 16 ottobre; i desktop compatti arriveranno in vendita a novembre. Dettagli e modelli sono nella pagina NVIDIA RTX Spark.
Voce | Dettaglio |
|---|---|
Cos'è | Superchip RTX Spark per laptop sottili e desktop compatti con Windows 11 |
Disponibilità | Laptop: preordini aperti, vendita da venerdì 16 ottobre; desktop compatti: vendita a novembre |
Prezzi | Non indicati nella fonte |
Contesto | Annunciato con Microsoft, che ha costruito Surface Laptop Ultra attorno a RTX Spark |
Limiti dichiarati | Configurazioni PCI Express e capacità HDMI e DisplayPort da verificare con il produttore di ciascun modello |
I numeri di testa#
Uscita dei laptop RTX Spark
Preordini aperti dalla data dell'annuncio
Disponibilità di DGX Station per Windows
Indicata come «Coming in Q4»
Rete ConnectX-8 SuperNIC, fino a
Potenza totale di sistema DGX Station
Richiede un circuito da 20A
Questi valori sono dichiarati da NVIDIA: quelli marcati «fino a» indicano la configurazione massima, non quella di ogni modello. Le date riguardano la disponibilità: i laptop con RTX Spark arrivano il 16 ottobre 2026, mentre DGX Station per Windows è indicata per il Q4. Il consumo di 1.600 W e la rete a 800 Gb/s descrivono il lato enterprise, dove il sistema va collegato a un'infrastruttura adeguata.
Video e cronologia delle GPU#
Secondo quanto dichiara NVIDIA, la pagina di RTX Spark collega oltre 30 anni di innovazione dell'azienda al nuovo superchip, che porta l'AI eseguita direttamente sul PC accanto alla grafica avanzata. Il lancio è fissato per il 16 ottobre a livello globale, con preordini già aperti. Per approfondire, potete consultare la pagina ufficiale.
Specifiche: laptop e desktop a confronto#
Laptop e desktop: le differenze#
La prima tabella confronta le due configurazioni di RTX Spark N1X. Il laptop ha GPU Blackwell RTX da 6.144 core, CPU Grace a 20 core e fino a 128 GB di memoria LPDDR5X; il desktop ha 5.120 core GPU, CPU a 18 core e fino a 64 GB. Le tre voci cambiano, mentre il TDP è 45–80 W per entrambi e le funzioni RTX restano identiche.
Voce | Laptop (6.144 core) | Desktop (5.120 core) |
|---|---|---|
CPU | 20-core NVIDIA Grace CPU | 18-core NVIDIA Grace CPU |
Memory Type | Unified | Unified |
OS Support | Windows 11 | Windows 11 |
Superchip Specs: | — | — |
GPU | 6144-core NVIDIA Blackwell RTX GPU | 5120-core NVIDIA Blackwell RTX GPU |
CPU | 20-core NVIDIA Grace CPU | 18-core NVIDIA Grace CPU |
Power (TDP) | 45 - 80 W | 45 - 80 W |
Memory Specs: | — | — |
Memory Configuration | Up to 128 GB LPDDR5X | Up to 64 GB LPDDR5X |
Technology Support: | — | — |
Ray Tracing Cores | Fourth Generation | Fourth Generation |
Tensor Cores (AI) | Fifth Generation | Fifth Generation |
NVIDIA DLSS | DLSS 5 | DLSS 5 |
NVIDIA Reflex | Reflex 2 Low Latency Mode Frame Warp | Reflex 2 Low Latency Mode Frame Warp |
NVIDIA Broadcast | ✓ | ✓ |
RTX Remix | ✓ | ✓ |
NVIDIA App | ✓ | ✓ |
NVIDIA Studio Drivers | ✓ | ✓ |
Game Ready Drivers | ✓ | ✓ |
NVIDIA G-SYNC | ✓ | ✓ |
Microsoft DirectX 12 Ultimate | ✓ | ✓ |
NVIDIA GPU Boost | ✓ | ✓ |
PCI Express Gen 5 (1) | ✓ | ✓ |
Vulkan RT API, OpenGL 4.6 | ✓ | ✓ |
HDMI (2) | ✓ | ✓ |
DisplayPort (3) | ✓ | ✓ |
NVIDIA Encoder | 1x Ninth Generation | 1x Ninth Generation |
NVIDIA Decoder | 1x Sixth Generation | 1x Sixth Generation |
CUDA Capability | ✓ | ✓ |
Scheda tecnica NVIDIA delle due configurazioni RTX Spark N1X: unità di calcolo, TDP, memoria e supporto alle tecnologie RTX e AI. Fonte: NVIDIA.
La seconda tabella riporta la configurazione laptop a 6.144 core con TDP di 140 W», come riga di confronto. Rispetto al laptop da 45–80 W, il consumo sale a 140 W, mentre memoria e funzioni restano le stesse.
Voce | Configurazione 6.144 core, 140 W |
|---|---|
CPU | 20-core NVIDIA Grace CPU |
Memory Type | Unified |
OS Support | Windows 11 |
Superchip Specs: | — |
GPU | 6144-core NVIDIA Blackwell RTX GPU |
CPU | 20-core NVIDIA Grace CPU |
Power (TDP) | 140 W |
Memory Specs: | — |
Memory Configuration | Up to 128 GB LPDDR5X |
Technology Support: | — |
Ray Tracing Cores | Fourth Generation |
Tensor Cores (AI) | Fifth Generation |
NVIDIA DLSS | DLSS 5 |
NVIDIA Reflex | Reflex 2 Low Latency Mode Frame Warp |
NVIDIA Broadcast | ✓ |
RTX Remix | ✓ |
NVIDIA App | ✓ |
NVIDIA Studio Drivers | ✓ |
Game Ready Drivers | ✓ |
NVIDIA G-SYNC | ✓ |
Microsoft DirectX 12 Ultimate | ✓ |
NVIDIA GPU Boost | ✓ |
PCI Express Gen 5 (1) | ✓ |
Vulkan RT API, OpenGL 4.6 | ✓ |
HDMI (2) | ✓ |
DisplayPort (3) | ✓ |
NVIDIA Encoder | 1x Ninth Generation |
NVIDIA Decoder | 1x Sixth Generation |
CUDA Capability | ✓ |
Scheda tecnica della configurazione a 6.144 core con TDP di 140 W, usata come riferimento per confrontare il consumo con le versioni da 45–80 W. Fonte: NVIDIA.
Memoria unificata e coerente: RTX Spark N1X contro DGX Station per Windows
Capacità massima di memoria (GB) per eseguire modelli AI e agenti in locale su Windows
Fonte: Schede tecniche ufficiali NVIDIA RTX Spark e DGX Station for Windows
Creatori, sviluppatori e giocatori#
Creatori, sviluppatori e giocatori#
Per i creatori, il chip include Tensor Core di quinta generazione e codifica e decodifica hardware di HEVC, H.264 e AV1. Le scene 3D possono arrivare a 90 GB grazie alla 128 GB di memoria unificata, e il materiale 4:2:2 si può portare direttamente dalla fotocamera in timeline (scheda prodotto).
Per gli sviluppatori, NVIDIA indica la possibilità di eseguire in locale modelli fino a 120 miliardi di parametri con contesto da 1 milione di token, usando lo stack CUDA e NVFP4. Secondo il produttore, questo evita i costi delle API e lascia i dati sul proprio dispositivo.
Per i giocatori la scheda elenca ray tracing, DLSS 5, NVIDIA Reflex e G-SYNC, tecnologie che migliorano qualità dell'immagine, reattività e fluidità. Il produttore le presenta come disponibili sia nei portatili sottili sia nei desktop compatti.
Glossario essenziale#
Tensor Core: unità del chip pensate per i calcoli dell'intelligenza artificiale.
NVFP4: formato numerico usato per far girare i modelli in modo più efficiente.
Memoria unificata: memoria condivisa tra processore grafico e processore principale.
Token: piccole unità di testo che un modello legge e produce.
AV1 e 4:2:2: formato di compressione video moderno e schema di colore usato nelle riprese professionali.
Ray tracing: calcolo della luce che rende più realistici riflessi e ombre nei giochi.
DGX Station per Windows: GB300 sulla scrivania#
Una stazione AI da scrivania per Windows#
NVIDIA presenta DGX Station per Windows come stazione AI da scrivania basata sul superchip GB300 Grace Blackwell Ultra, con disponibilità annunciata per il Q4 (NVIDIA). Secondo il produttore, la macchina offre fino a 748 GB di memoria coerente e fino a 20 petaFLOPS di calcolo FP4 con sparsità, e può eseguire modelli fino a 1 trilione di parametri in un unico pool di memoria.
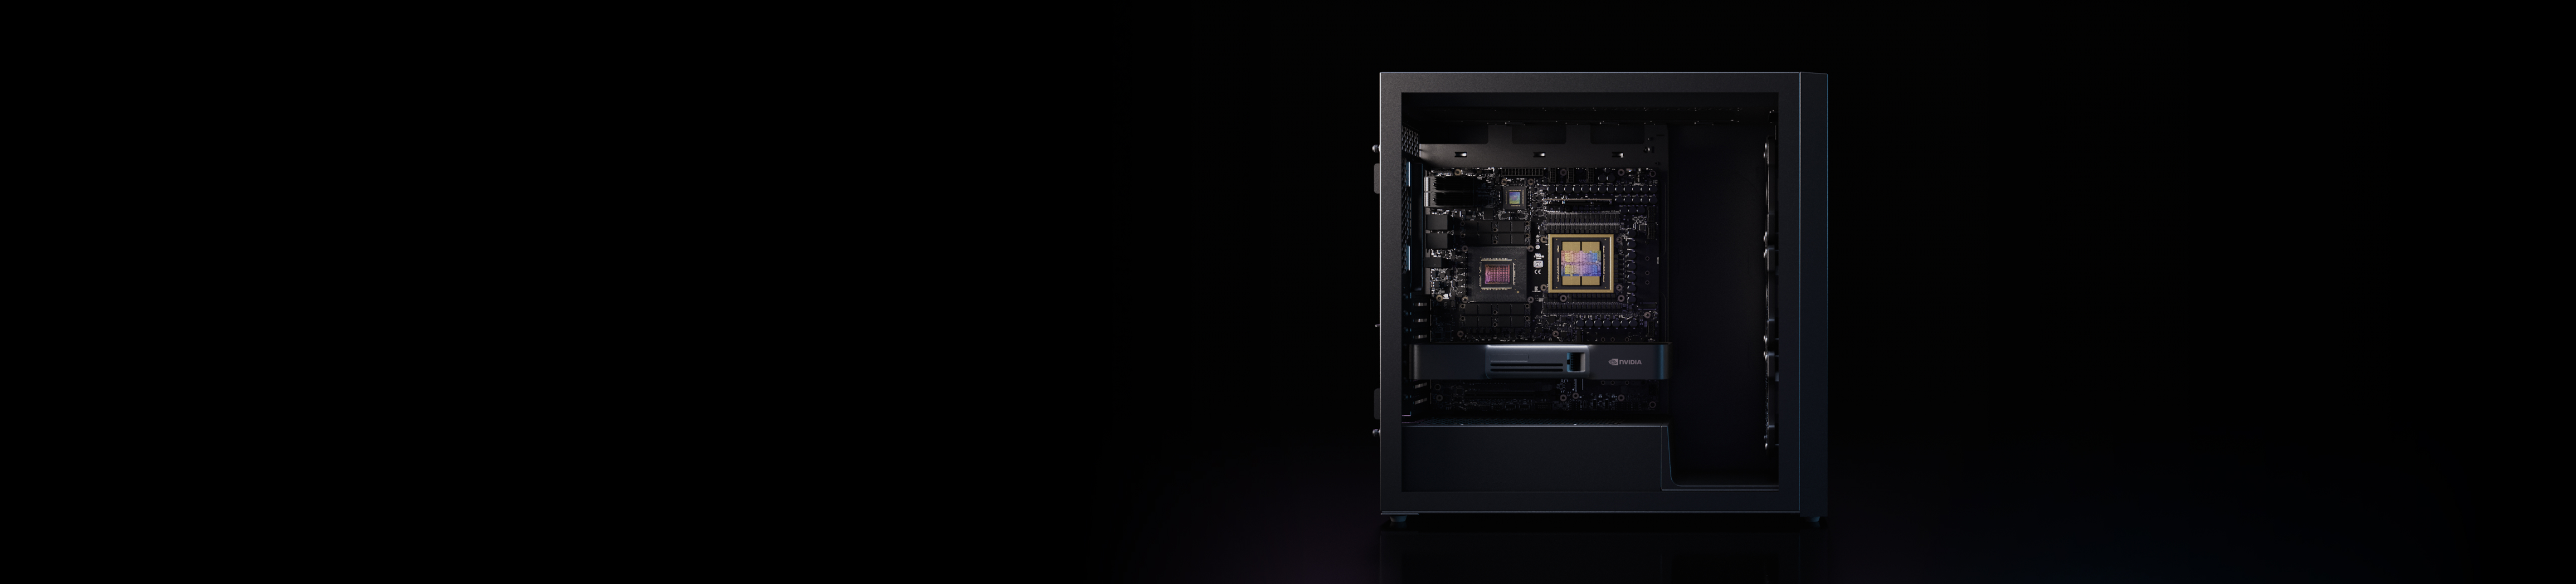
Il sistema si integra nell'infrastruttura Windows già esistente, senza nuove policy di gruppo né modifiche al sistema operativo, come dichiara NVIDIA. Gli strumenti Linux restano accessibili tramite WSL. Il collegamento tra più postazioni avviene con la scheda di rete ConnectX-8 SuperNIC, fino a 800 Gb/s.
Sintesi e specifiche#
Voce | Dettaglio dalla scheda |
|---|---|
Cos'è | Stazione AI da scrivania per Windows con superchip GB300 |
Disponibilità | Annunciata per il Q4, con iscrizione alle notifiche sulla pagina |
Prezzo | Non indicato nella scheda |
Contesto | Agenti AI collegati ad applicazioni aziendali, sviluppo e fine-tuning, strumenti Linux via WSL |
Limiti dichiarati | Supporto GPU RTX PRO variabile per sistema; alimentazione con circuito da 20A |
Componente | Valore dichiarato |
|---|---|
NVIDIA CPU | 1x Grace 72-Core Neoverse V2 |
GPU Memory | 252 GB HBM3e | 7.1 TB/s |
CPU Memory | 496 GB LPDDR5X | 396 GB/s |
NVLink-C2C | 900 GB/s |
Networking | Peak Bandwidth | NVIDIA ConnectX-8 SuperNIC | Up to 800 Gb/s | Ethernet |
Supported OS | Microsoft Windows |
FP4 Tensor Core | 20 | 15 3 PFLOPS |
FP8 / FP6 Tensor Core | 10 PFLOPS |
Int8 Tensor Core | 330 TOPS |
FP16/BF16 Tensor Core | 5 PFLOPS |
TF32 Tensor Core | 2.5 PFLOPS |
FP32 | 80 TFLOPS |
FP64 / FP64 Tensor Core | 1.3 TFLOPS |
Total System Power | 1,600 W | 20A circuit required |
Decoders | 7 NVDEC 7 nvJPEG |
Supported RTX PRO GPU 4 | NVIDIA RTX PRO 6000 Workstation Edition RTX PRO 6000 Blackwell Max-Q Workstation Edition RTX PRO 4000 Blackwell SFF Edition RTX PRO 2000 Blackwell |
Storage | 4x M.2 Gen 5 Slots |
Ethernet Ports | 2x QSFP112 (400 Gbs per port) 1x RJ45 10GbE 1x RJ45 1GbE (BMC for system management) |
PCIe Slots | 1x PCIe Gen 5 x16 2x PCIe Gen 5 x16 (x8 electrical) |
Additional Ports and Connectors 4 | Front IO: 2x USB Type C (USB3.1), 2x USB Type A (USB3.1), Audio Rear IO: 4x USB Type A, USB Micro-B (BMC) mDP 5 (BMC), Audio |
Specifiche principali di DGX Station per Windows secondo la scheda tecnica NVIDIA. Fonte: NVIDIA.
Agenti sempre attivi e inferenza in locale#
Agenti sempre attivi sul desktop#
Secondo NVIDIA, DGX Station for Windows serve a costruire e far girare agenti AI, cioè programmi che svolgono compiti in autonomia collegandosi alle applicazioni di produttività, design e ingegneria. Il produttore indica che questi agenti possono restare attivi a lungo e che, generando i token in locale, si riducono i costi.
Inferenza di modelli grandi in locale#
L'inferenza è la fase in cui un modello già addestrato risponde alle richieste. Per NVIDIA, il sistema accelera l'inferenza locale di modelli grandi, con generazione rapida di token e analisi dei dati. Le specifiche indicano fino a 748 GB di memoria coerente, fino a 1 trilione di parametri e fino a 20 PFLOPS di calcolo FP4. La fonte non riporta misure di velocità.
Token: unità di testo, come parole o parti di parole, che il modello legge e produce.
Inferenza: l'uso di un modello già addestrato per generare risposte.
Parametri: i valori interni di un modello che ne determinano il comportamento.
PFLOPS: un milione di miliardi di operazioni al secondo.
DGX Station: la versione Linux#
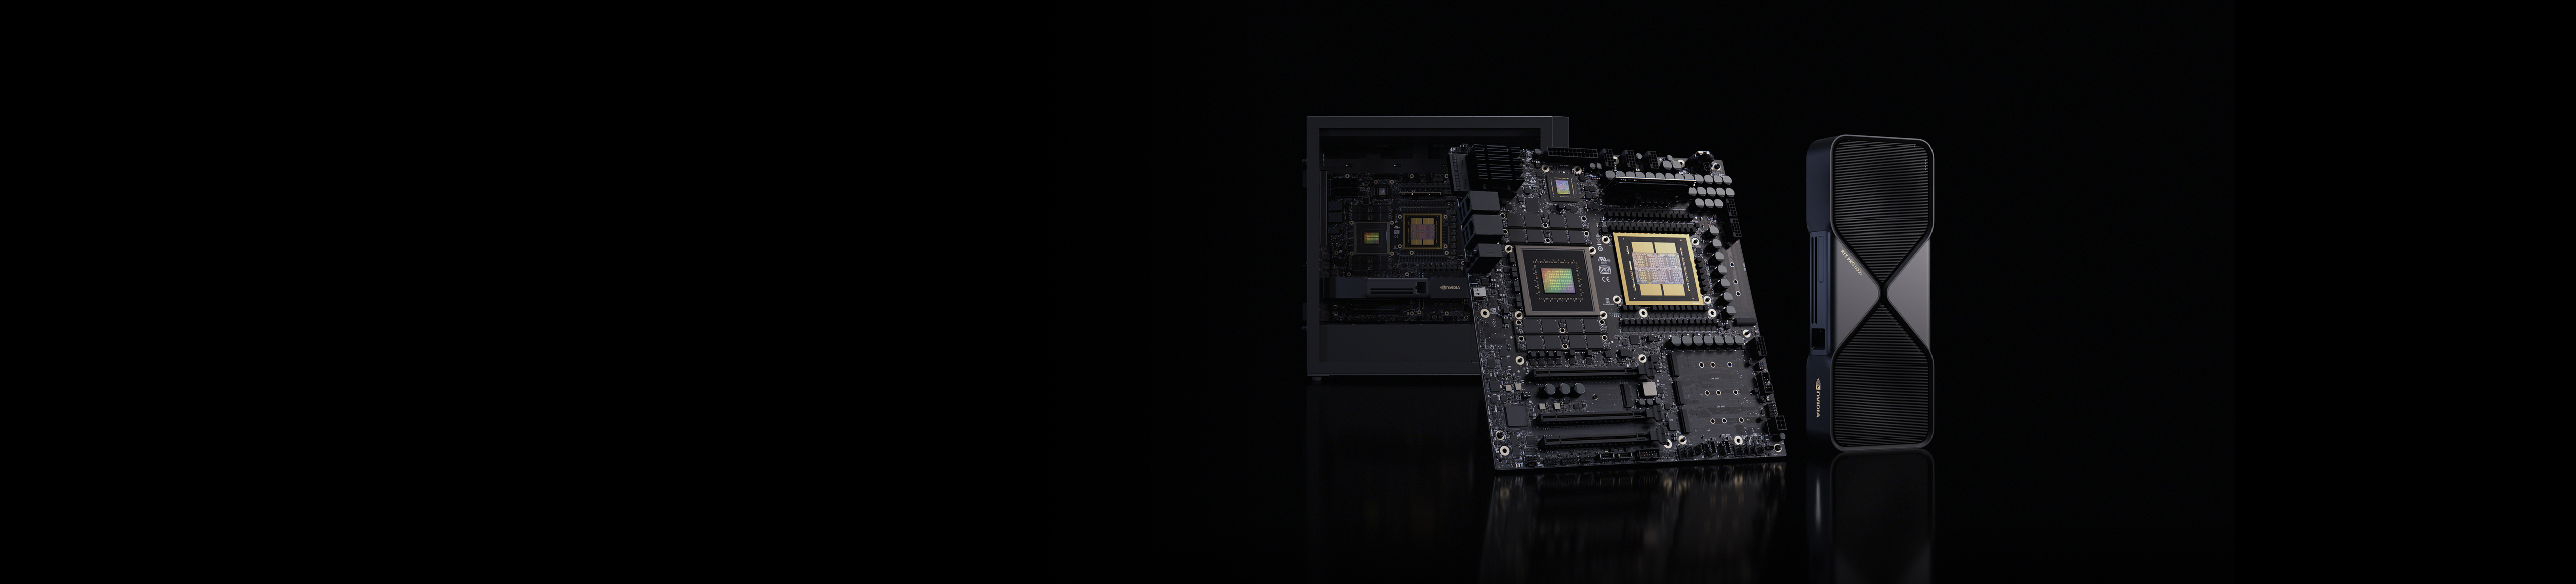
La versione Linux di NVIDIA DGX Station funziona con Ubuntu e NVIDIA AI Developer Tools, un ambiente preconfigurato con le librerie CUDA-X essenziali per sviluppo, data science e inferenza locale. È distinta dalla variante Windows, annunciata come DGX Station for Windows e pensata per collegare agenti AI alle applicazioni aziendali. Il sistema si ordina tramite partner OEM: la pagina invita a iscriversi per ricevere un avviso sulla disponibilità.
Voce | Dettaglio |
|---|---|
Versione | Linux, con Ubuntu e NVIDIA AI Developer Tools |
Disponibilità | Notifica di disponibilità; ordine tramite partner OEM |
Prezzo | Non indicato nella fonte |
Contesto | Versione Windows separata: DGX Station for Windows |
Partizionamento | Fino a sette istanze MIG |
Limiti dichiarati | Supporto NIM previsto a giugno; production branch previsto a ottobre |
Il produttore precisa che il supporto può variare a seconda del sistema e va confermato con l'OEM. Le specifiche complete restano nella tabella della sezione dedicata.
Strumenti per sviluppare e far girare modelli#
Dal progetto all'agente: il flusso di sviluppo#
Il flusso parte dagli agenti. NemoClaw è uno stack open source che aggiunge controlli di privacy e sicurezza a OpenClaw: con un solo comando si avviano agenti sempre attivi, che possono evolvere nel tempo, anche in locale. Secondo NVIDIA, abbinarlo a DGX Station riduce i costi aggiuntivi dei token (fonte).
Modelli e dati sulla stessa macchina#
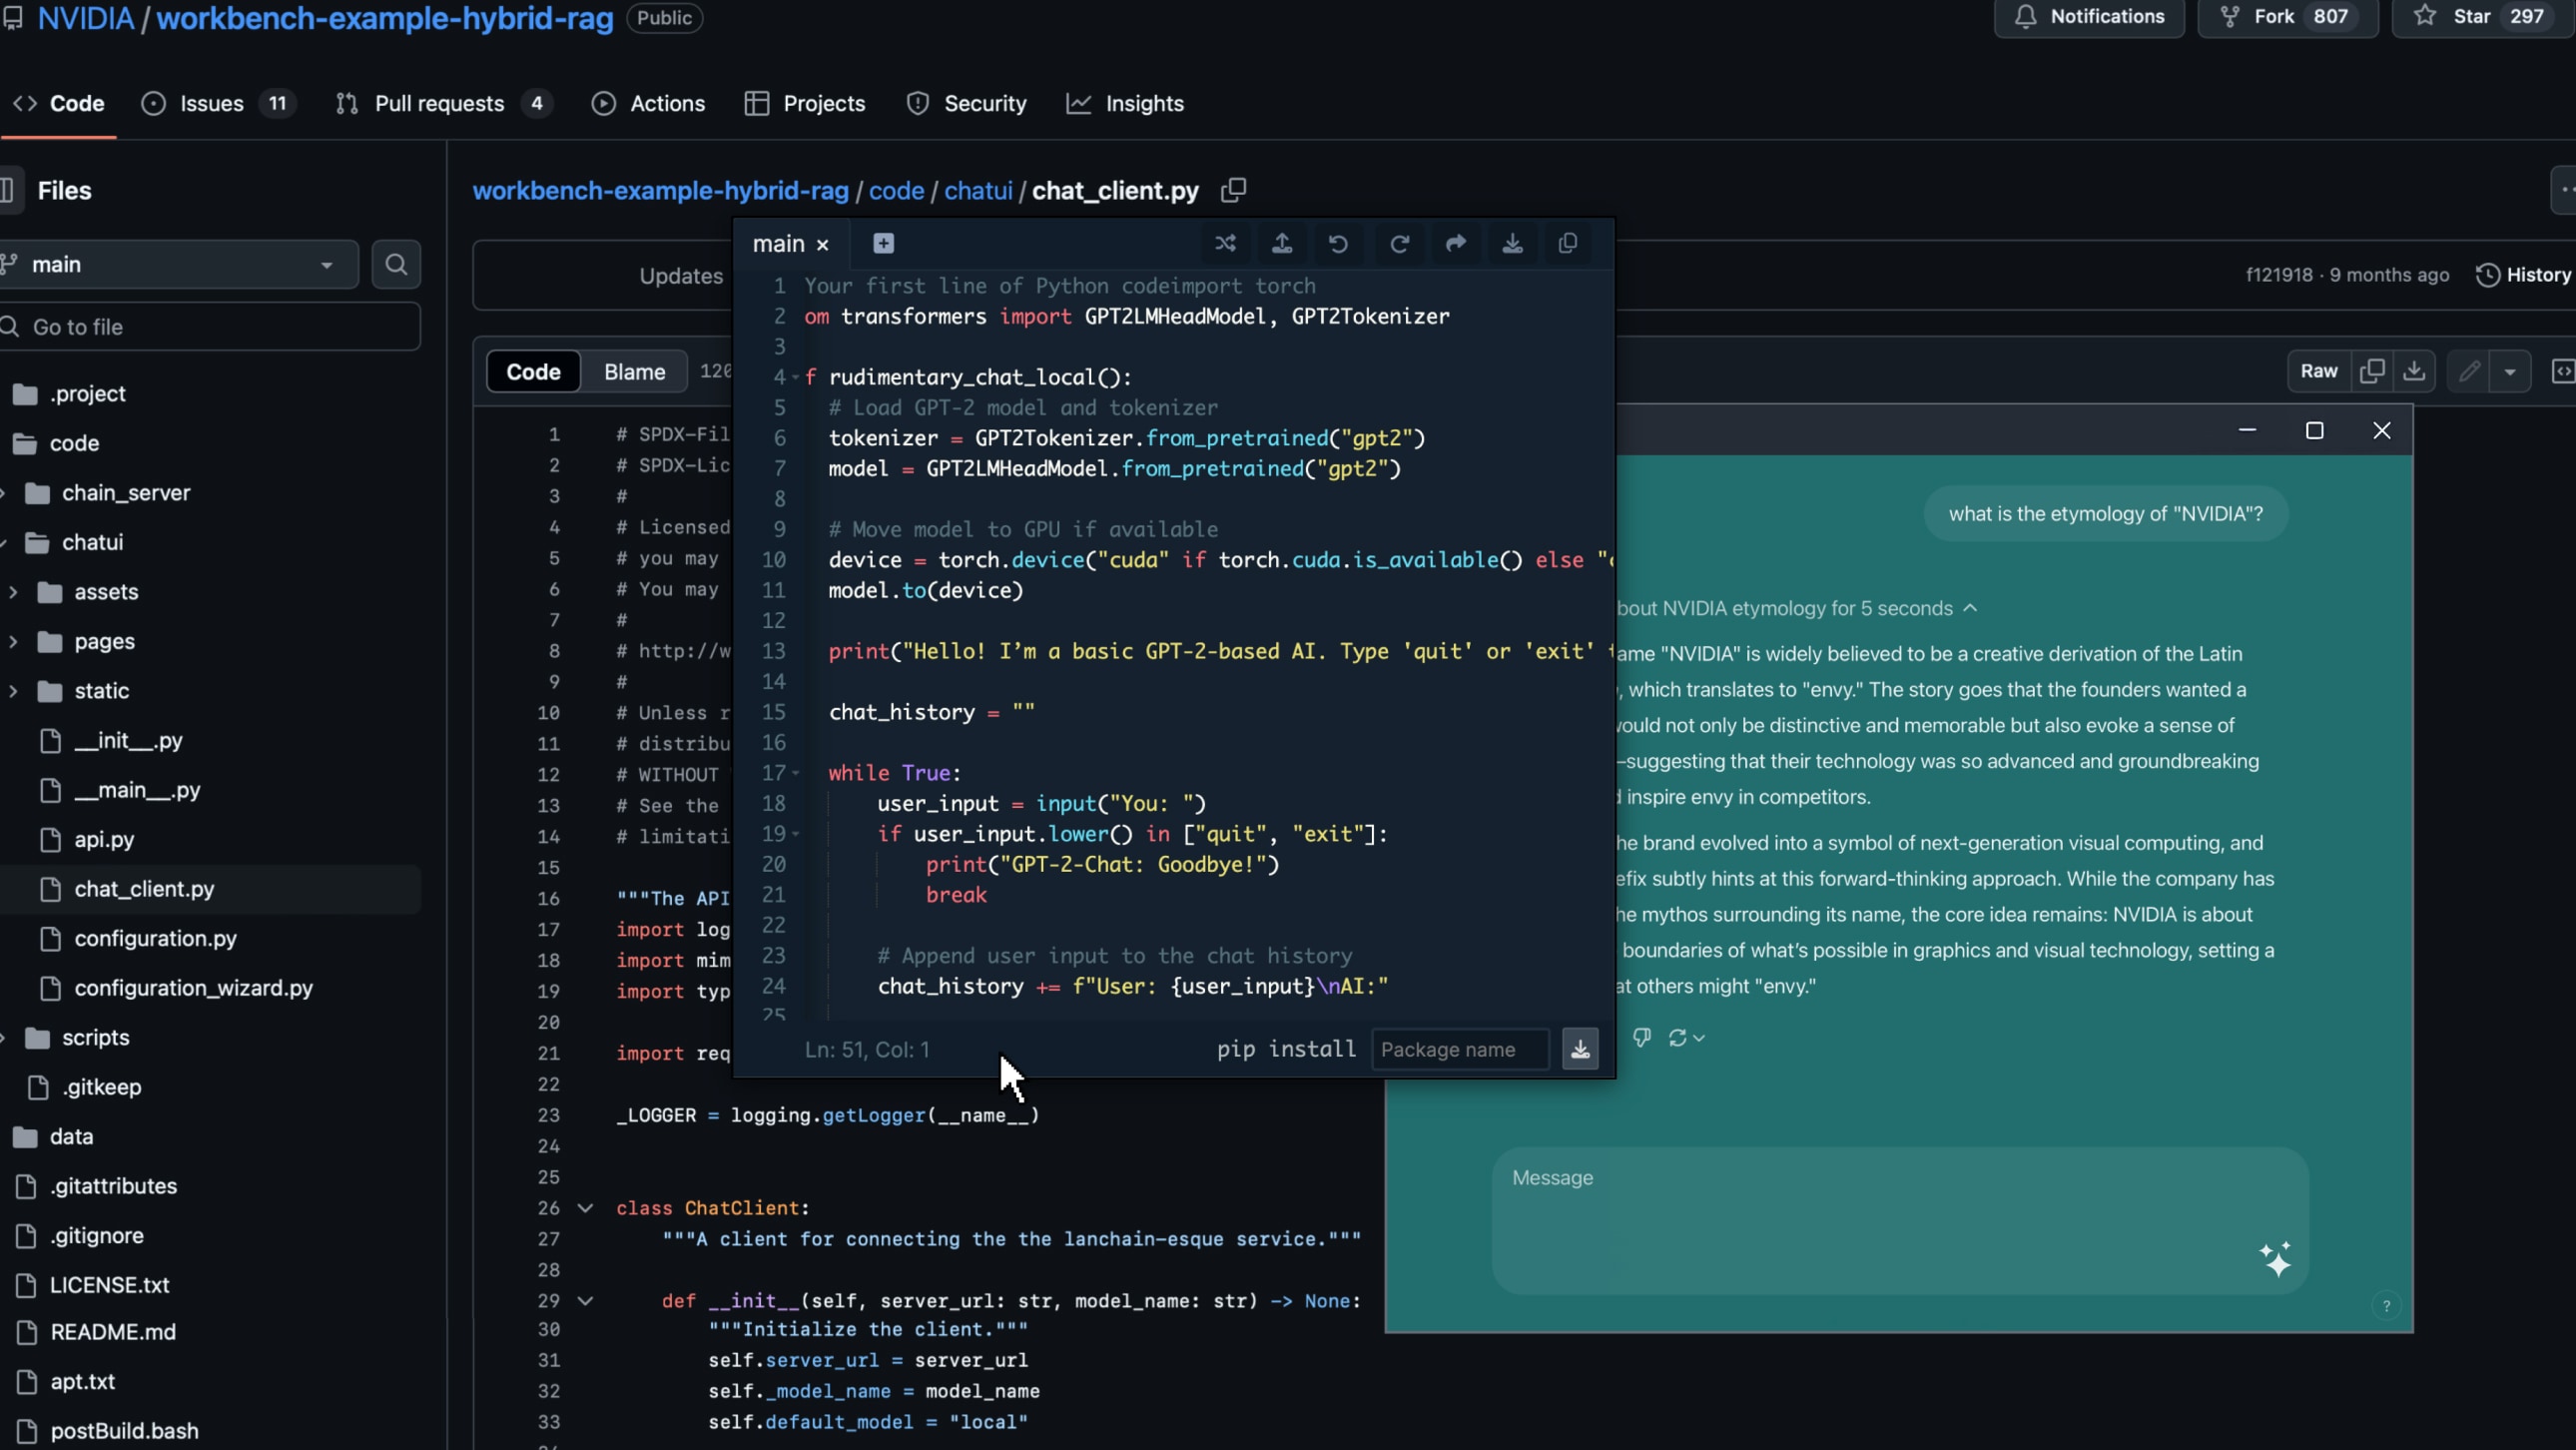
Per addestrare e mettere a punto i modelli, la piattaforma include librerie CUDA ottimizzate per il deep learning e il machine learning. Per la data science entrano in gioco le librerie open source RAPIDS: il grande pool di memoria coerente permette di caricare interi data lake direttamente in memoria, evitando i colli di bottiglia che rallentano i flussi di lavoro.
Piccolo glossario#
Agente AI: programma che svolge compiti in autonomia, anche per lunghi periodi.
Deep learning: ramo del machine learning basato su reti neurali a più strati.
Inferenza: uso di un modello già addestrato per produrre risposte o risultati.
Token: unità di testo che un modello elabora, spesso alla base del costo d'uso.
Data lake: grande archivio di dati grezzi, di vari formati.
Open source: software il cui codice è pubblico e può essere usato e modificato.
Workstation virtuali NVIDIA RTX#
Cos'è una workstation virtuale#
Una workstation virtuale è una postazione di lavoro potente che gira in un data center o nel cloud e si usa da qualsiasi dispositivo. Secondo NVIDIA, RTX vWS unisce il proprio software alle GPU per grafica, ingegneria, data science e AI, e i file restano nel data center.
I numeri dichiarati dal produttore#
NVIDIA dichiara fino a 4,1 volte la prestazione grafica con la L40S e fino a 1,5 volte la prestazione per dollaro con la A10. Il test è stato eseguito su DaVinci Resolve 19 Beta, con un utente per GPU e un costo che include hardware e quattro anni di software vGPU.
Glossario essenziale#
GPU: il processore specializzato nella grafica e nei calcoli pesanti.
vGPU: una GPU condivisa tra più utenti virtuali.
Data center: il centro di server dove stanno i dati e le applicazioni.
Cloud: servizi informatici usati via internet, senza hardware di proprietà.
Come leggere questi numeri#
Cosa misura ciascun valore#
I valori di calcolo sono dichiarazioni di NVIDIA, riportate nella pagina RTX Spark e nelle specifiche di DGX Station. Il dato FP4 di DGX Station per Windows dipende dalla sparsità: 20 PFLOPS con sparsità, 15 PFLOPS senza. Le specifiche precisano che i valori dei Tensor Core sono con sparsità, salvo diversa indicazione. Il dato più alto è quindi il più favorevole e presuppone questa tecnica, che le fonti non spiegano nel dettaglio.
Anche «fino a» indica un massimo dichiarato. Il valore reale dipende dalla configurazione scelta e dal carico di lavoro.
Le condizioni del test vWS#
I grafici sulle prestazioni grafiche della pagina Virtual Workstations derivano da un test con un utente per GPU, su un server configurato con 64 GB di RAM per utente. Il test ha usato DaVinci Resolve 19 Beta e misura il FPS geomean. Il risultato descrive quindi un server condiviso, non un laptop o un desktop singolo.
Cautela: cosa le fonti non dicono#
Cosa significa per un'azienda#
Decidete quali carichi di lavoro tenere in locale: secondo il produttore, con RTX Spark i dati restano sul dispositivo e il cloud serve solo quando lo scegliete.
Verificate l'infrastruttura Windows esistente, perché il produttore sostiene che DGX Station per Windows non richiede nuove group policy né modifiche al sistema operativo, ma è annunciato per il Q4.
Se i vostri team usano Linux, valutate WSL, che secondo NVIDIA permette di eseguire i toolchain AI Linux su Windows.
Per agenti attivi 24/7, confrontate i desktop compatti, in vendita a novembre, con i laptop, disponibili dal 16 ottobre dopo il preordine.
Per la grafica remota, valutate RTX vWS: le fonti citano solo il nome della linea Virtual Workstation senza specifiche, quindi verificate i dati direttamente presso NVIDIA prima di decidere.
Per un inquadramento sull'uso dell'AI nelle aziende italiane, leggete Chi fa intelligenza artificiale per le aziende in Italia.
Domande frequenti#
Quando posso acquistare un RTX Spark?
I preordini dei laptop sono aperti e i modelli saranno disponibili venerdì 16 ottobre. I desktop compatti andranno in vendita a novembre.
Cos'è DGX Station for Windows e quando arriva?
È una supercomputer AI da scrivania basata sul GB300 Grace Blackwell Ultra Desktop Superchip, con fino a 748 GB di memoria coerente e fino a 20 petaFLOPS di calcolo FP4. Il produttore lo indica in arrivo nel Q4 e invita a iscriversi per ricevere un avviso sulla disponibilità. Gli strumenti Linux restano accessibili tramite WSL.
Cosa significa «fino a» nelle specifiche?
Sono valori massimi della configurazione più potente. Per esempio, 128 GB di memoria unificata e fino a 6.144 core GPU non riguardano necessariamente ogni modello. Il produttore precisa che i picchi di prestazione si basano sulla frequenza di boost e che il valore FP4 di DGX Station è riportato con sparsity.
I dati restano in locale?
Per l'uso locale, sì: il produttore indica che i dati restano sul dispositivo. Il cloud è disponibile a scelta, quando serve maggiore scala, e il codice può girarvi senza modifiche.
Questo articolo è stato scritto con l'aiuto dell'intelligenza artificiale; i dati provengono dalle pagine e dal comunicato ufficiali di NVIDIA citati nel testo.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 6/10 | Le fonti indicano GPU fino a 6.144 core, CPU fino a 20 core, fino a 1 petaflop FP4 e fino a 128 GB di memoria unificata, ma sono valori "fino a" dichiarati dal produttore e spesso basati su test interni, non verificati da terzi. |
Disponibilità e preordini | 7/10 | I preordini dei laptop sono aperti dal 7 ottobre 2026, con vendite dal 16 ottobre, mentre i desktop compatti sono previsti per novembre; la data dei preordini è riportata dalla notizia ma non confermata nelle pagine ufficiali citate. |
Prezzo | 2/10 | Nelle fonti non sono indicati prezzi per i laptop, i desktop o la DGX Station for Windows. |
Uso locale e privacy dei dati | 7/10 | Le fonti affermano che l'esecuzione locale evita l'invio dei dati al cloud, senza costi per prompt o abbonamenti, ma sono affermazioni del produttore. |
Disponibilità DGX Station for Windows | 4/10 | La DGX Station for Windows è indicata come in arrivo nel Q4, con pagina di iscrizione per la notifica, quindi non ancora acquistabile. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
RTX Spark porta l'AI locale su laptop e desktop Windows con specifiche dichiarate dal produttore, ma prezzi e prestazioni verificate indipendentemente restano non disponibili.
Per chi deve decidere, le fonti offrono specifiche tecniche dettagliate ma nessun prezzo, quindi il confronto economico non è possibile. Le prestazioni citate sono massimi dichiarati dal produttore, da verificare con test indipendenti. Per i laptop la disponibilità è fissata al 16 ottobre 2026, per i desktop a novembre e per la DGX Station for Windows nel Q4. Chi valuta l'acquisto dovrebbe attendere test di terze parti e listini ufficiali prima di decidere.
Punti di forza
- Specifiche tecniche dettagliate per GPU, CPU, memoria unificata e TDP dei superchip RTX Spark N1X
- Supporto dichiarato a CUDA e a Windows 11, con compatibilità con WSL per toolchain Linux
- Per la DGX Station for Windows sono dichiarati fino a 748 GB di memoria coerente e 20 PFLOPS FP4 con sparsity
Limiti
- Prezzi non indicati in nessuna delle fonti per laptop, desktop o DGX Station
- Le prestazioni sono espresse con la formula «fino a» e spesso basate su test interni del produttore
- Il DGX Station for Windows non è ancora disponibile e la data è solo "Q4"
- I desktop compatti arrivano solo a novembre
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
5- 1.NVIDIA — NVIDIA, Microsoft Kick Off a New Beginning for Windows PCs With RTX Spark and AI Agentsblogs.nvidia.com
Annuncio ufficiale da cui nasce l’articolo.
- 2.NVIDIA — NVIDIA RTX Spark — Slim Laptops & Small Desktopsnvidia.com
Documento ufficiale collegato all’annuncio.
- 3.NVIDIA — NVIDIA DGX Station for Windows — GB300 Deskside AI Supercomputingnvidia.com
Documento ufficiale collegato all’annuncio.
- 4.NVIDIA — NVIDIA DGX Station: Ultimate AI Supercomputernvidia.com
Documento ufficiale collegato all’annuncio.
- 5.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.