Cosa annuncia NVIDIA al Summit OCP e cosa dicono le sue schede tecniche
NVIDIA apre l'architettura Vera Rubin con contributi a OCP, nuovi standard per le AI factory e una rete Spectrum-X dedicata. Ecco gli annunci, le specifiche e i limiti dei dati forniti dal produttore.
di Andrea Pirazzini
Fonte primaria
NVIDIA — OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide
blogs.nvidia.com
Matteo
Il Narratore · 2 min 21 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: NVIDIA — OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide.
Perché se ne parla#
Le AI factory, cioè le infrastrutture dedicate all'intelligenza artificiale, passano dalla scala dei megawatt a quella dei gigawatt, e costruirle richiede molto più che potenza di calcolo. Servono standard aperti che permettano al settore di realizzarle più in fretta, con maggiore efficienza e affidabilità. Al Summit OCP di San Jose NVIDIA ha annunciato nuove partnership e contributi pensati per creare una base comune per la prossima generazione di infrastrutture AI, come riporta l'annuncio ufficiale di NVIDIA.
Il contributo più concreto riguarda il sistema Vera Rubin: NVIDIA ha messo a disposizione dell'OCP i progetti di rack e di compute tray attraverso l'architettura aperta MGX, così che i costruttori di sistemi possano partire da un fondamento condiviso. L'iniziativa abbraccia l'AI factory, la rete elettrica che la alimenta e l'architettura rack-scale su cui poggia il calcolo accelerato.
Per chi investe o gestisce infrastrutture, il punto è che progetti condivisi possono essere adottati, prodotti e replicati da più soggetti, invece di restare legati a un unico fornitore. Il Summit OCP diventa così il luogo in cui questi progetti vengono resi disponibili all'intero ecosistema.
Sei annunci dal Summit OCP#
Standard aperti per AI factory con Google, Meta, AMD e Microsoft, tra cui design e resilienza alla rete elettrica
Nuovi componenti open source per il DSX AI Factory di NVIDIA
Meta adotta Spectrum-6 per reti Ethernet aperte
Visionbay presenta K-1, un progetto di AI factory con architettura a 800 VDC
NVIDIA e Cisco annunciano USFP, un nuovo modulo ottico per reti AI
Google e NVIDIA portano Falcon Transport su ConnectX-10 e BlueField DPU
tempo di ripristino a pieno carico dopo un disturbo alla rete
OCP Grid Resilience Specification
GPU per le AI factory di Meta con Spectrum-6
piani di rete indipendenti nel Multiplane
busbar raffreddato a liquido nella specifica MGX 1.2
I numeri indicano dove si concentrano gli annunci. Secondo lo standard OCP Grid Resilience, un'infrastruttura AI deve tornare a quasi pieno carico in meno di 2 secondi dopo un disturbo alla rete elettrica. Meta e NVIDIA indicano la scala di oltre 100.000 GPU per le AI factory con Spectrum-6, mentre il Multiplane distribuisce il traffico su 8 piani indipendenti. Il busbar da 5.000A della specifica MGX 1.2 riguarda l'alimentazione dei rack. Sono dichiarazioni del produttore, riportate nella fonte OCP.
MGX 1.2 e i rack Vera Rubin#
Cosa cambia con MGX 1.2#
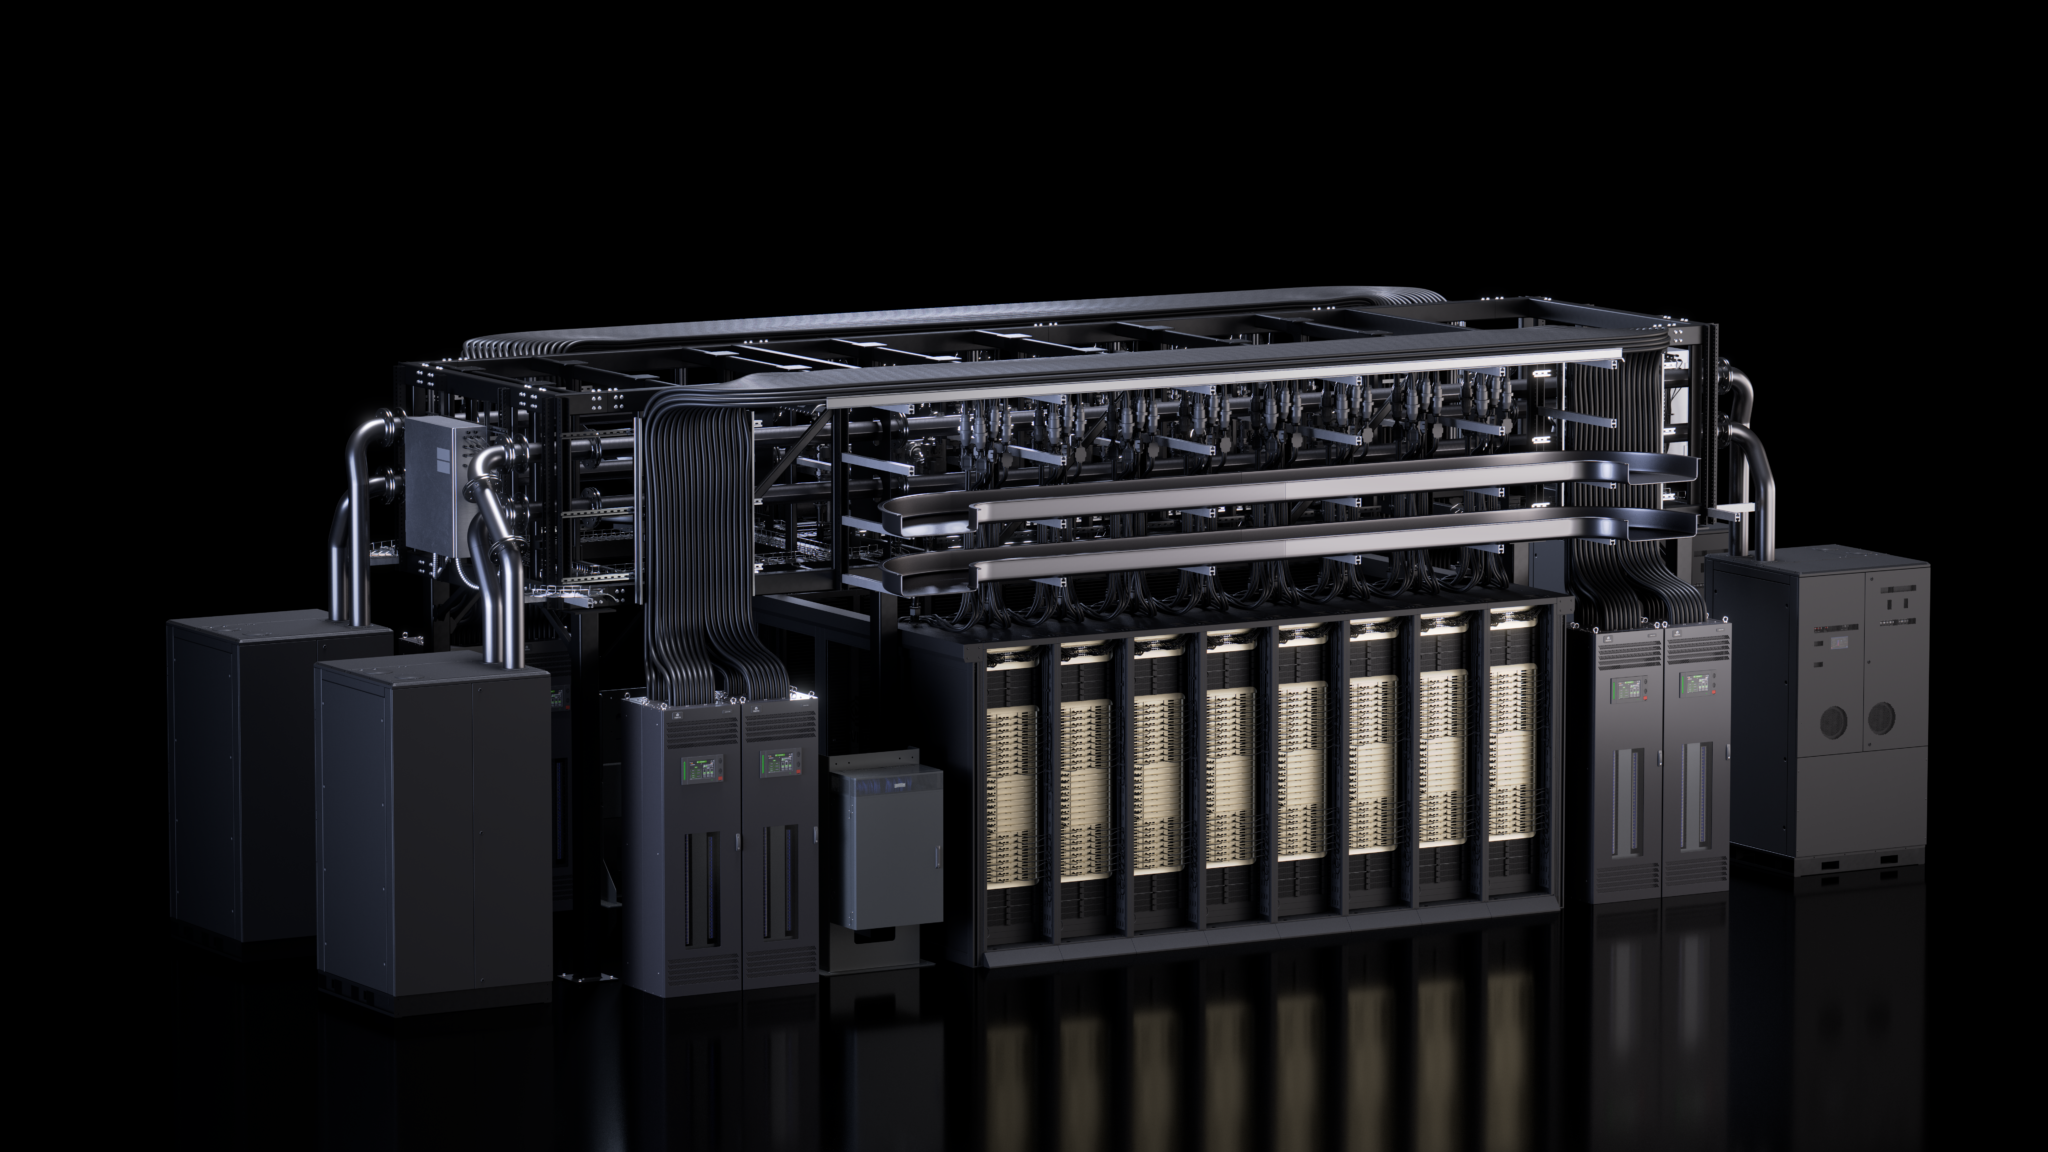
La specifica MGX 1.2 porta alle AI factory Vera Rubin il raffreddamento a liquido blind-mate a livello di rack e un busbar a liquido da 5.000 A. Aggiunge il supporto nativo a equipaggiamenti da 19 pollici e rack fino a 250 kW. I moduli di calcolo sono raffreddati a liquido e privi di ventole, con interfacce di potenza e raffreddamento standardizzate.
Il rack Vera CPU#
Il rack Vera CPU estende MGX oltre il calcolo accelerato. Mentre Vera Rubin NVL72 sostiene addestramento e inferenza, questo rack supporta il tool calling, ossia la chiamata di applicazioni e servizi esterni da parte del modello, l'orchestrazione e l'esecuzione sandboxed. Gli agenti AI possono così interagire in tempo reale con applicazioni, dati e servizi.
Busbar: barra conduttrice che distribuisce la corrente ai componenti del rack.
Blind-mate: collegamento che si innesta senza vedere i connettori.
Sandboxed: esecuzione del codice in un ambiente isolato.
DSX OS e i nuovi componenti open source#
DSX OS: il sistema operativo aperto delle AI factory#
DSX OS è lo strato software aperto che rende ripetibili le operazioni di un'AI factory. Al OCP NVIDIA ha aggiunto quattro componenti open source, descritti qui:
NVIDIA Config Manager: configura gli switch di rete su larga scala.
NVIDIA Cluster Readiness Engine: stressa i cluster GPU prima dell'addestramento.
NVIDIA Rack Management Service: gestisce i rack come unità, firmware compreso.
Cluster API Provider for NVIDIA Infrastructure Controller: porta i server bare metal a cluster pronti in ore, non giorni.
Derivano dall'esperienza di NVIDIA con NVIDIA DGX Cloud e possono essere integrati dai fornitori cloud nelle loro piattaforme multi-tenant.
Standard aperti per le AI factory#
Due specifiche aperte per il data center#
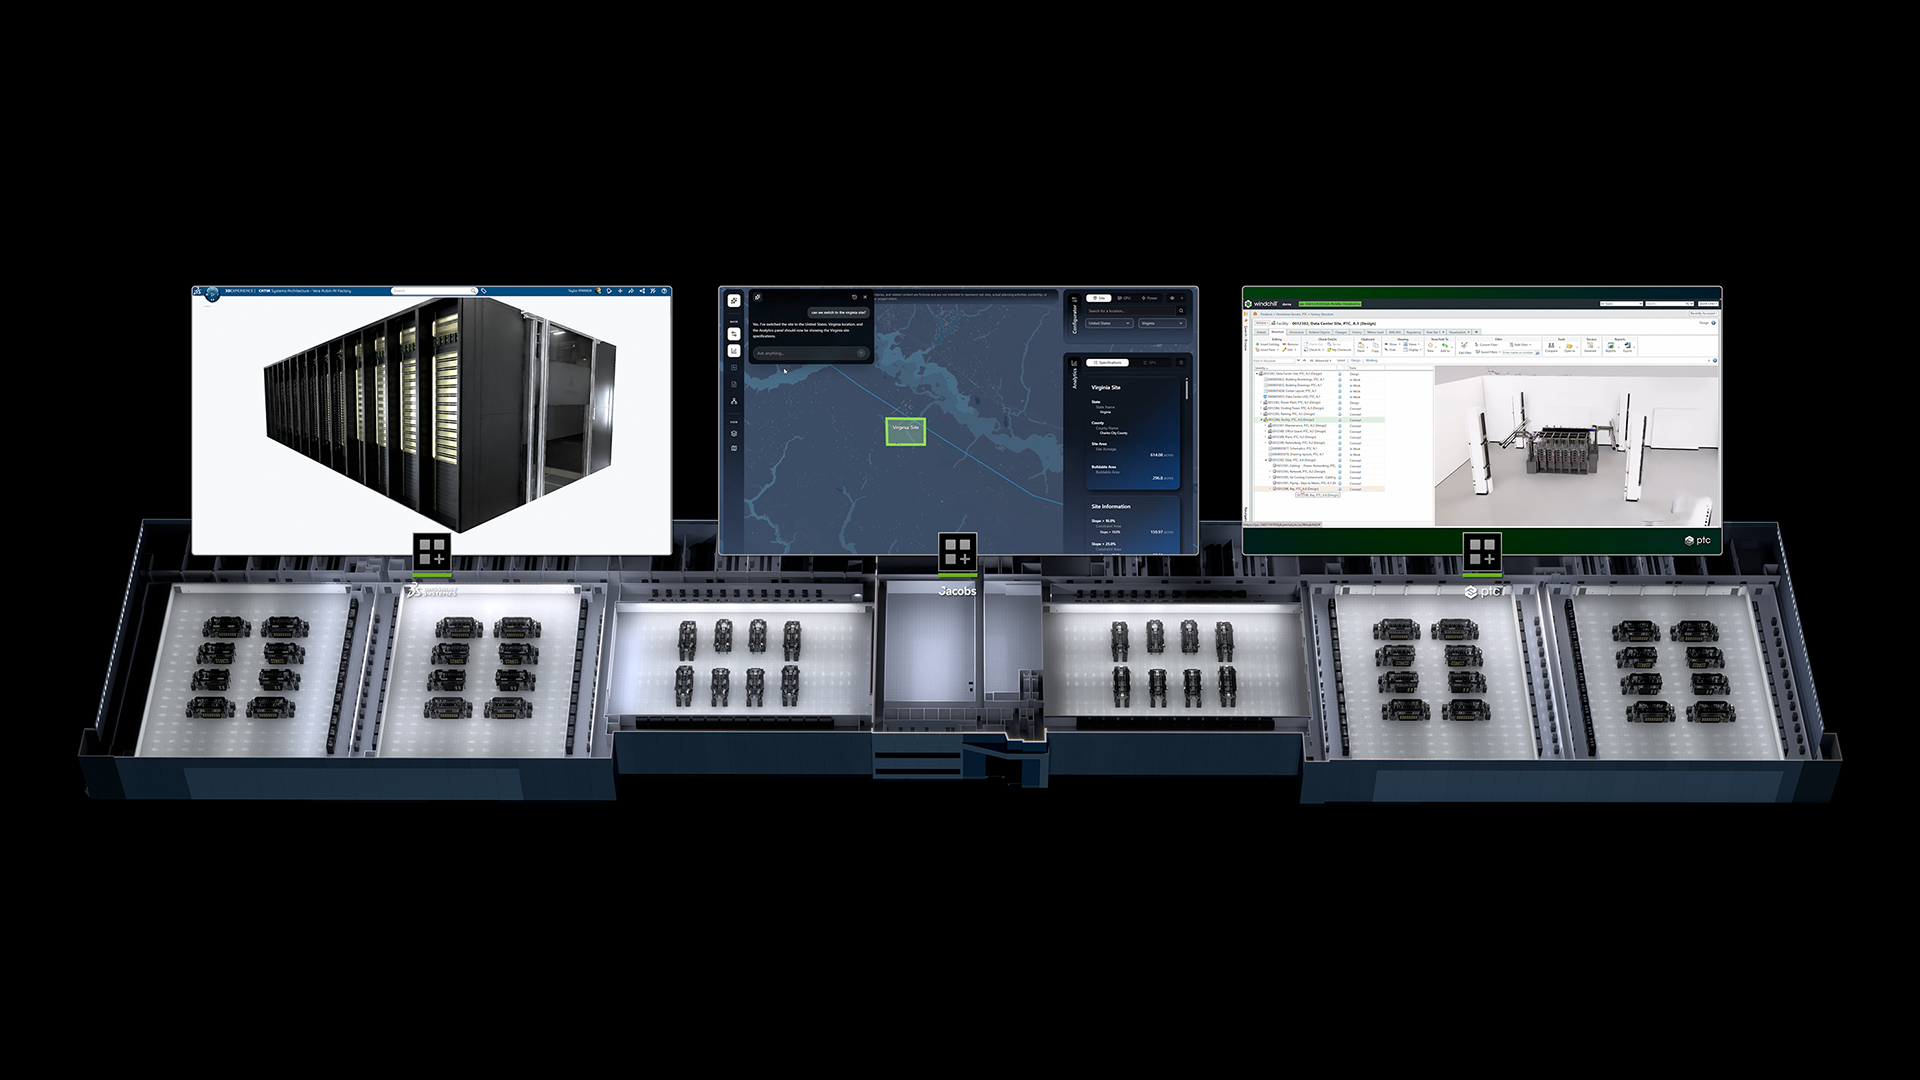
Due documenti pubblicati in ambito OCP fissano regole comuni per le AI factory. L'Open Data Center Specification v0.7, pubblicata con AMD, Google e Meta oltre a NVIDIA, descrive un progetto unico per il centro dati: alimentazione, raffreddamento e disposizione fisica. L'OCP Grid Resilience Specification, pubblicata da Google, Meta, Microsoft e NVIDIA, stabilisce come l'infrastruttura deve reagire ai disturbi della rete elettrica: restare collegata, rispondere in automatico e tornare quasi a pieno carico in meno di due secondi, come dichiarato nella specifica (fonte OCP).
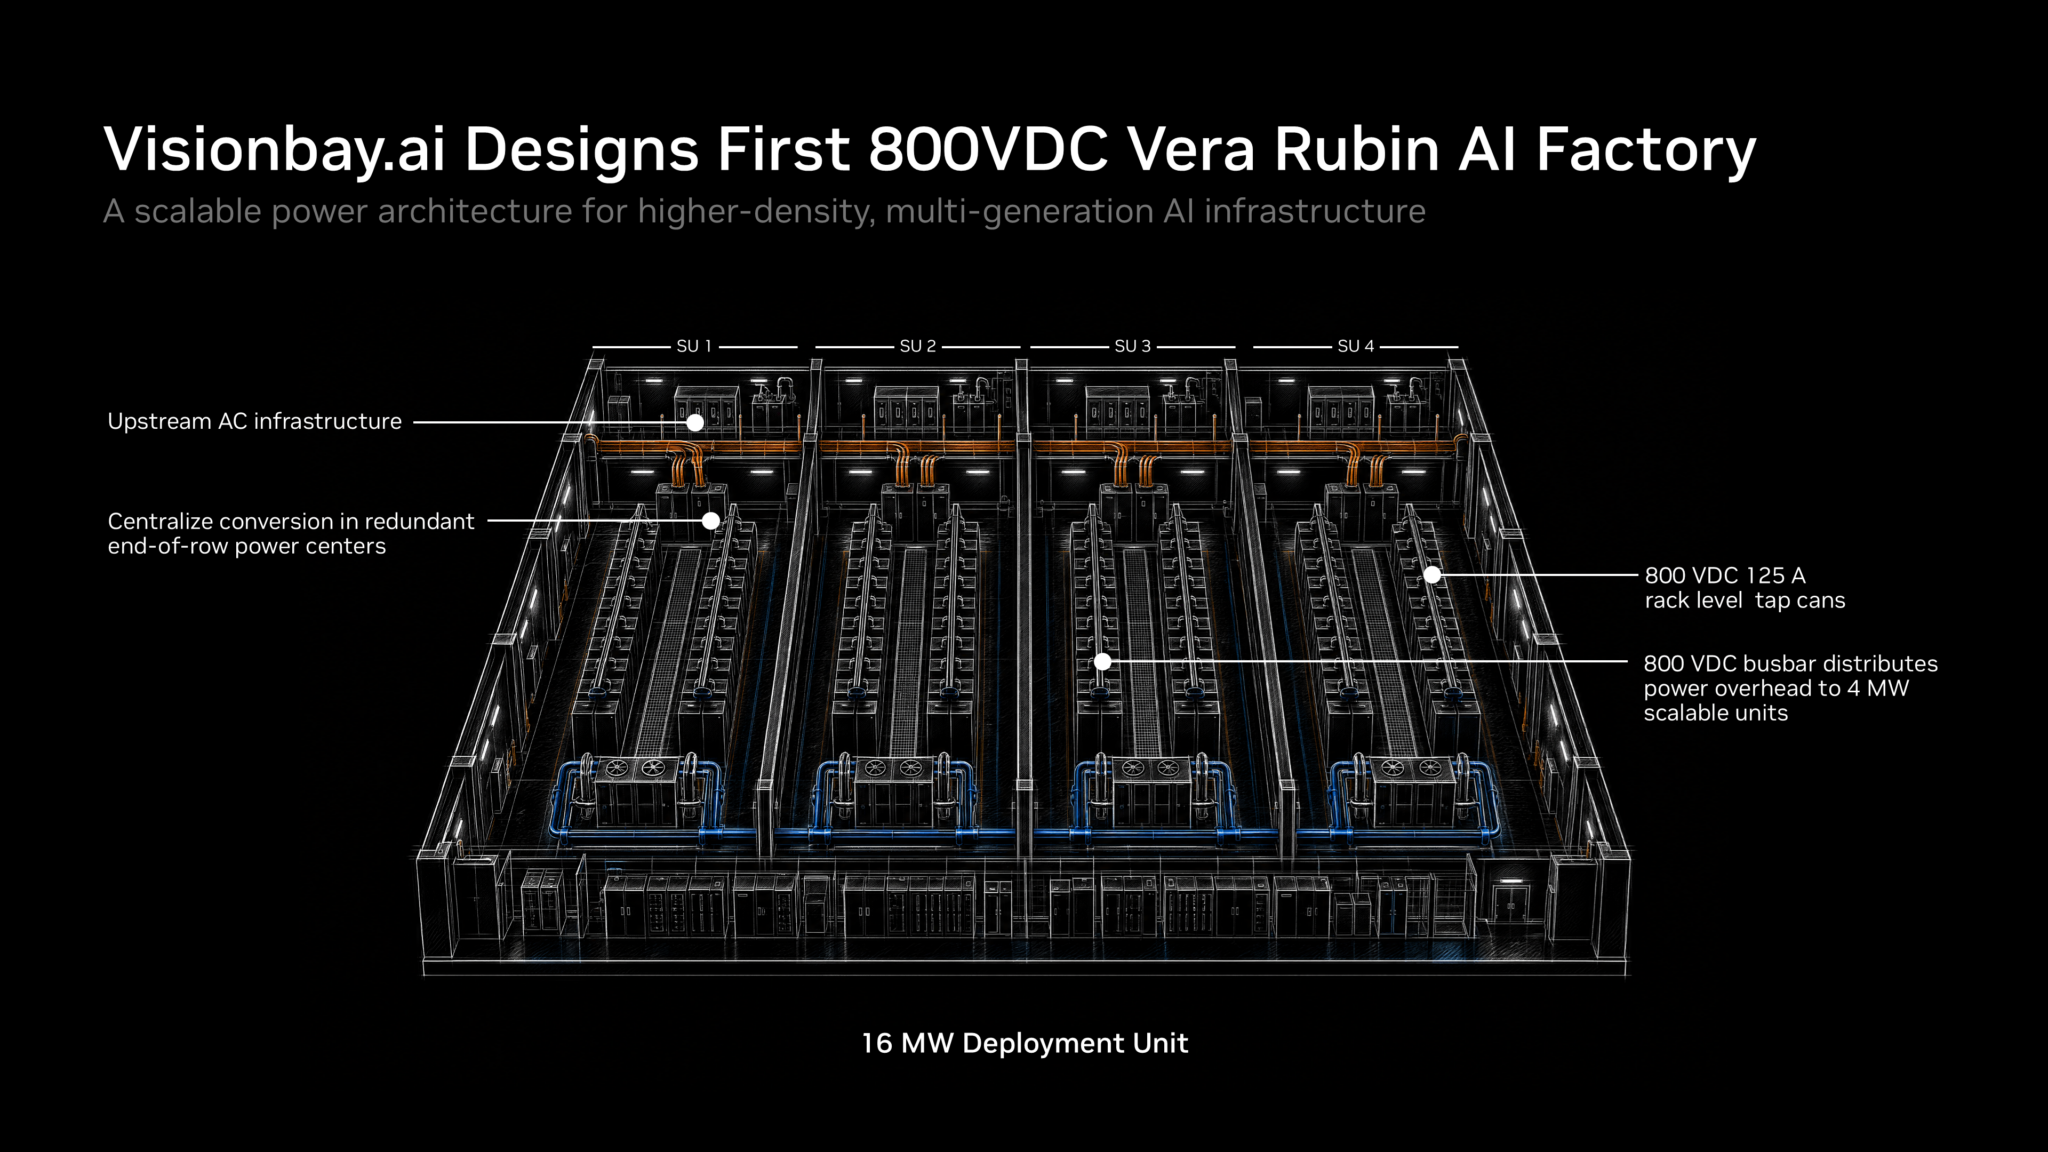
800 VDC: distribuzione in corrente continua a 800 volt.
Busbar: barra conduttrice che porta l'energia lungo le file di rack.
Power center: punto in cui la corrente alternata diventa continua, vicino ai computer.
Tap can: derivazione che alimenta il singolo rack.
Visionbay K-1 e l'architettura a 800 VDC#
Al OCP Global Summit Visionbay ha presentato i piani di K-1, una piattaforma per AI factory costruita attorno all'architettura a 800 VDC di NVIDIA, con tecnologie di alimentazione e termiche di Vertiv. Si tratta di piani annunciati, non di impianti già realizzati, come indicano le fonti ufficiali.
Il progetto non richiede una conversione completa il primo giorno: il 800 VDC entra per fasi, dove porta il beneficio maggiore. Le centrali di potenza a livello di cluster convertono la corrente alternata in continua e la distribuiscono vicino ai processori.
Piccolo glossario#
VDC: corrente continua, cioè elettricità che scorre in un solo verso.
AC-to-DC: conversione da corrente alternata a continua.
Centrale di potenza di cluster: punto che converte e distribuisce l'energia per un gruppo di server.
Rack: armadio metallico che ospita server e apparecchiature.
Meta e Spectrum-6#
Meta e Spectrum-6: il networking delle AI factory#
Meta adotta gli switch Ethernet Spectrum-6 da 102,4 Tb/s per costruire AI factory basate su Vera Rubin. Il suo switch N-IceCube gira su FBOSS, il sistema operativo di rete open source di Meta (annuncio OCP).
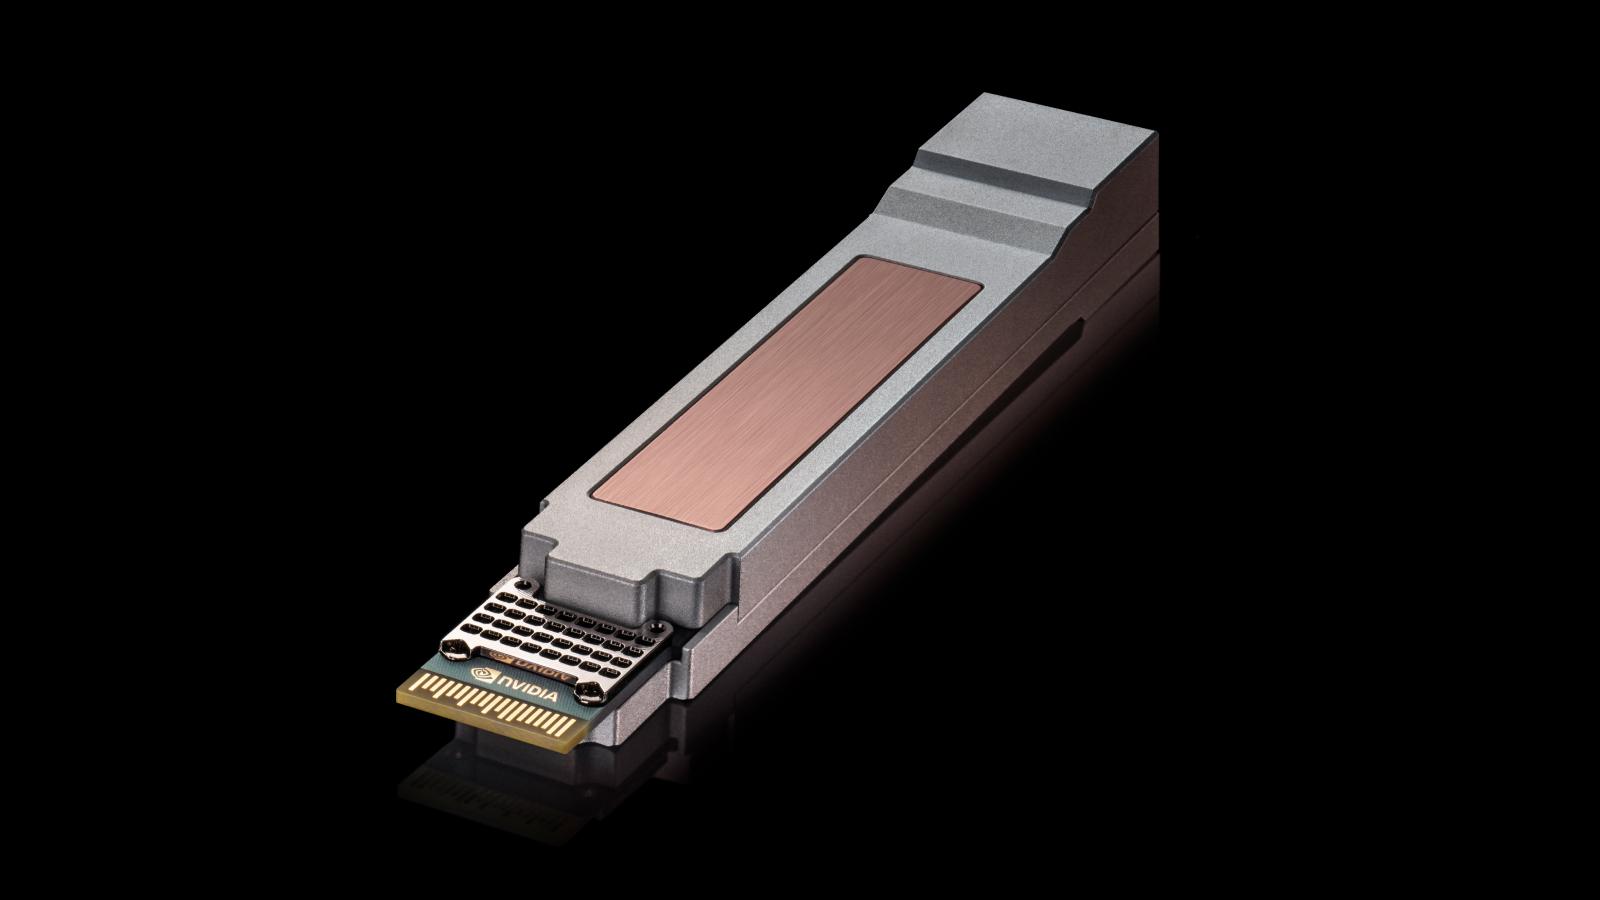
Il cuore della novità è il Multiplane: il traffico tra le GPU viene distribuito su fino a otto piani di rete indipendenti. Se un componente si guasta, i dati passano agli altri piani e i sistemi restano operativi, anche con banda ridotta. Secondo quanto dichiarato, questo approccio permette di superare 100.000 GPU.
Omar Baldonado di Meta spiega che rendere il multiplane affidabile e performante è essenziale sia per l'infrastruttura interna sia per i partner cloud. Lo stesso software può girare su tutte le reti grazie a FBOSS.
Ethernet: standard di rete per collegare server e apparecchi.
Switch: apparecchio che instrada i dati tra i collegamenti.
Tb/s: terabit al secondo, unità di capacità di trasferimento.
Multiplane: più reti parallele che lavorano insieme, così un guasto non blocca tutto.
USFP e Falcon su ConnectX-10#
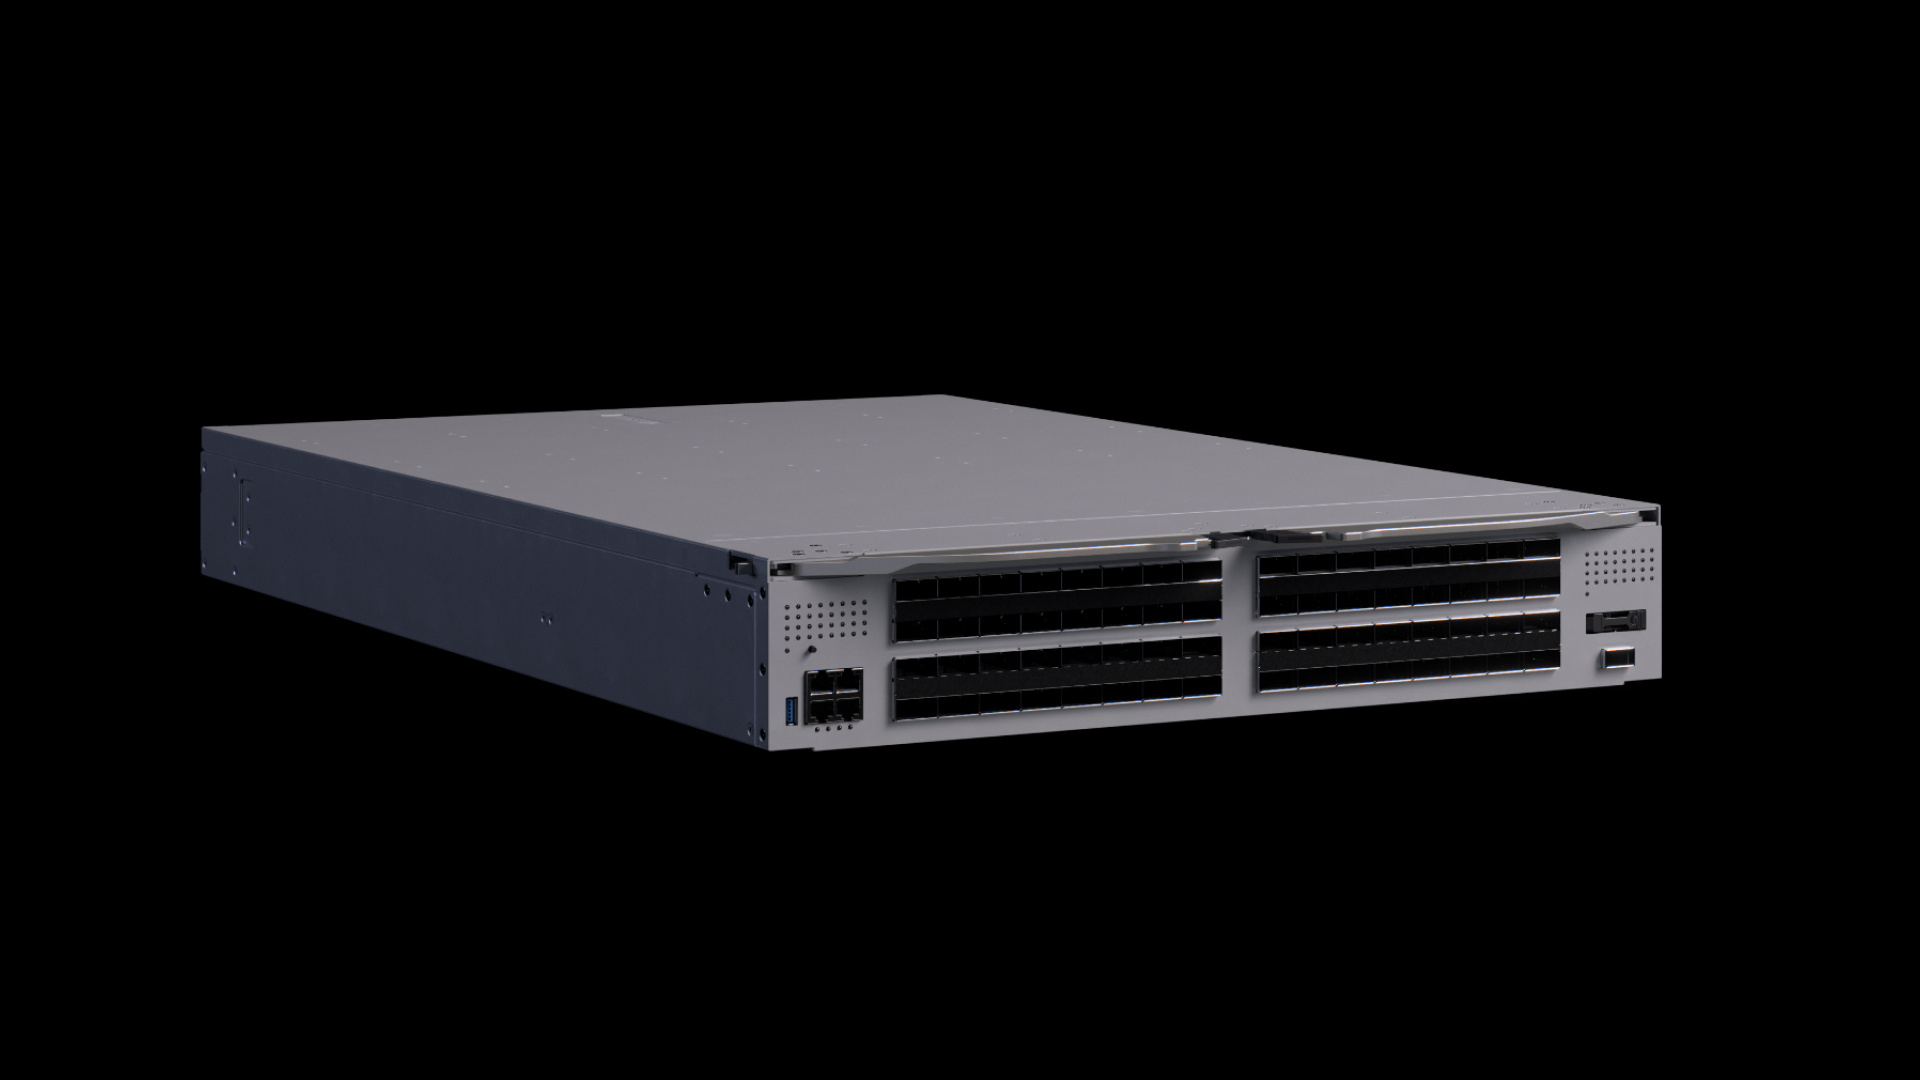
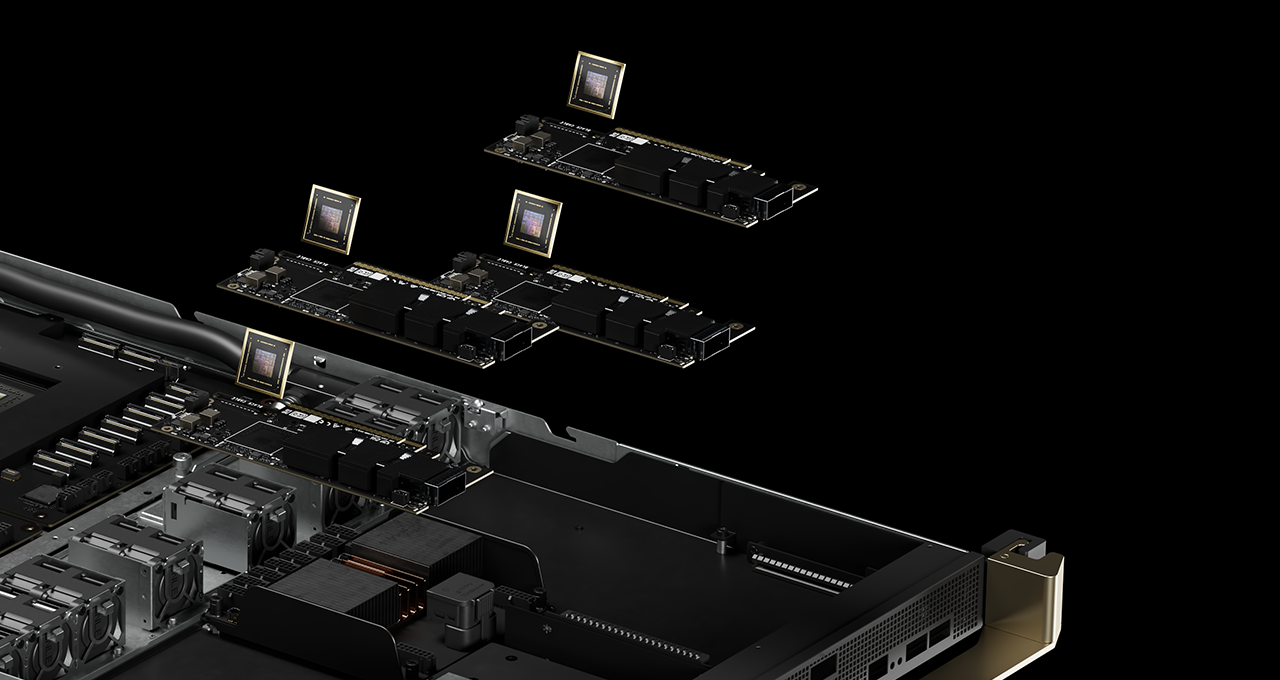
USFP è il nuovo formato di modulo ottico presentato da NVIDIA e Cisco all'OCP Global Summit. Offre 400 Gb/s per corsia con un ingombro circa uguale a quello di OSFP, fermo a 200 Gb/s per corsia. Il formato prevede 16 corsie full-duplex, con piani per arrivare a 32, e quattro volte la densità di banda dei moduli attuali. Secondo il produttore, l'efficienza energetica sarà circa 1,3x superiore.
Falcon Transport su ConnectX-10 e BlueField#
Google e NVIDIA hanno annunciato il supporto a Falcon Transport sui futuri ConnectX-10 SuperNIC e sulle DPU BlueField. Falcon è un protocollo che consegna dati in modo affidabile su reti Ethernet, dove i pacchetti possono andare persi in caso di congestione.
Corsia: singolo canale di trasmissione dentro il modulo.
Form factor: formato fisico e dimensioni standard di un componente.
Pluggable: modulo sostituibile che si inserisce in una porta della scheda di rete.
Vera Rubin: la piattaforma#
Secondo NVIDIA, Vera Rubin è una piattaforma multi-rack di tipo POD-scale che riunisce cinque sistemi rack-scale in un unico supercomputer per l'AI. L'azienda la presenta come pensata per agenti e ragionamento in più passaggi, con flussi di lavoro su contesti lunghi. Il produttore dichiara più token per watt e un costo per token più basso rispetto all'architettura Blackwell: è un'affermazione di NVIDIA, non un risultato verificato da terzi nella fonte.
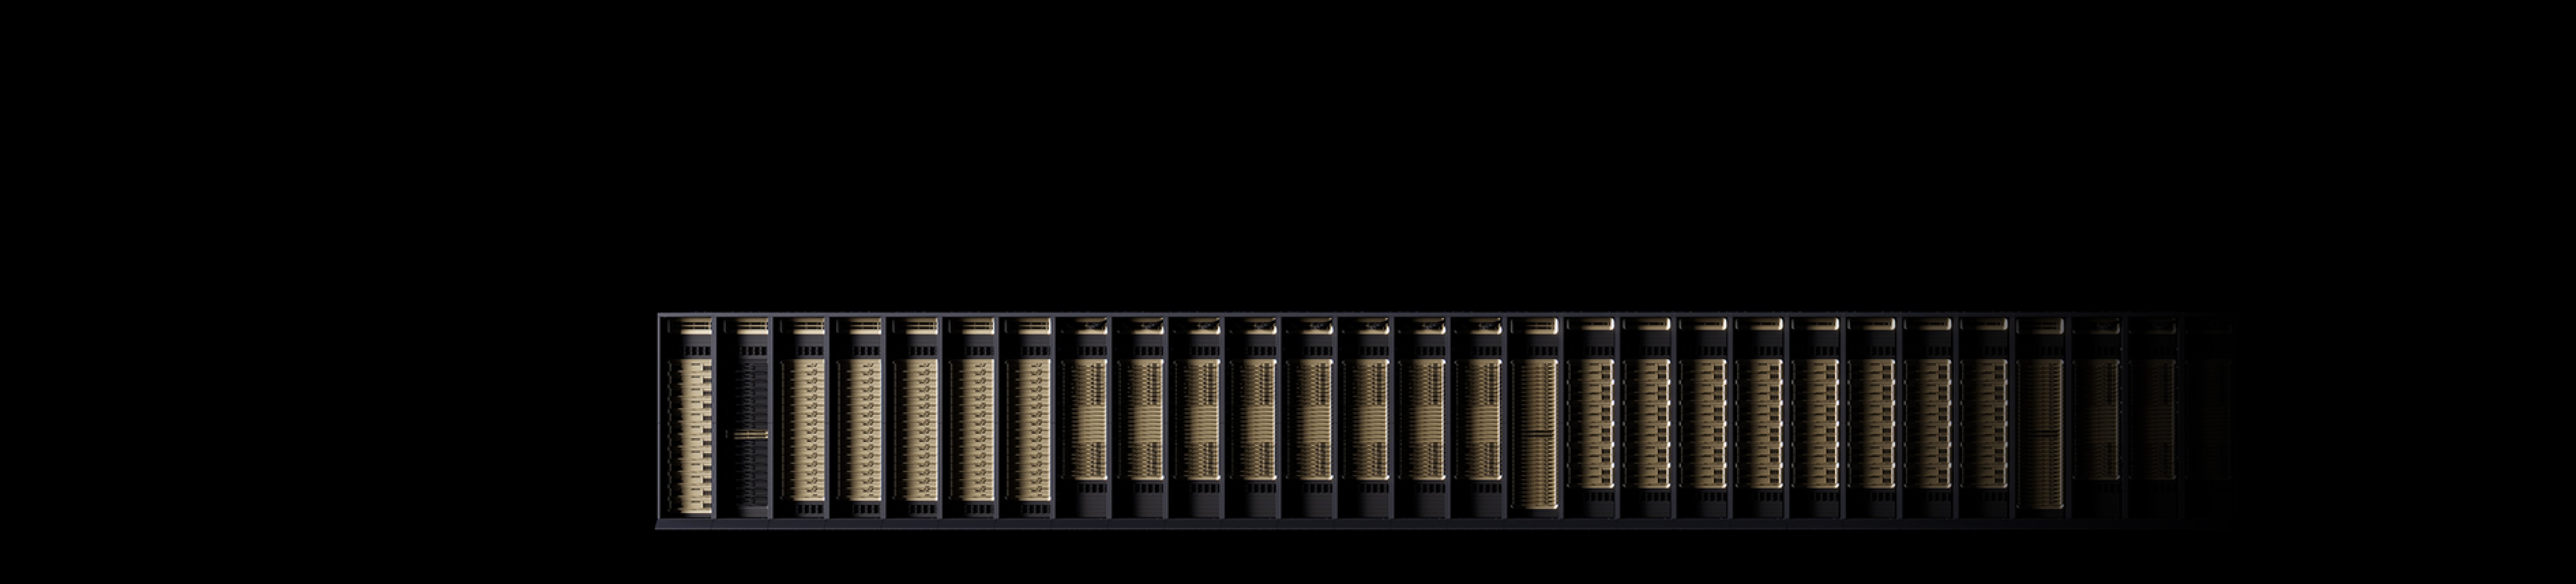
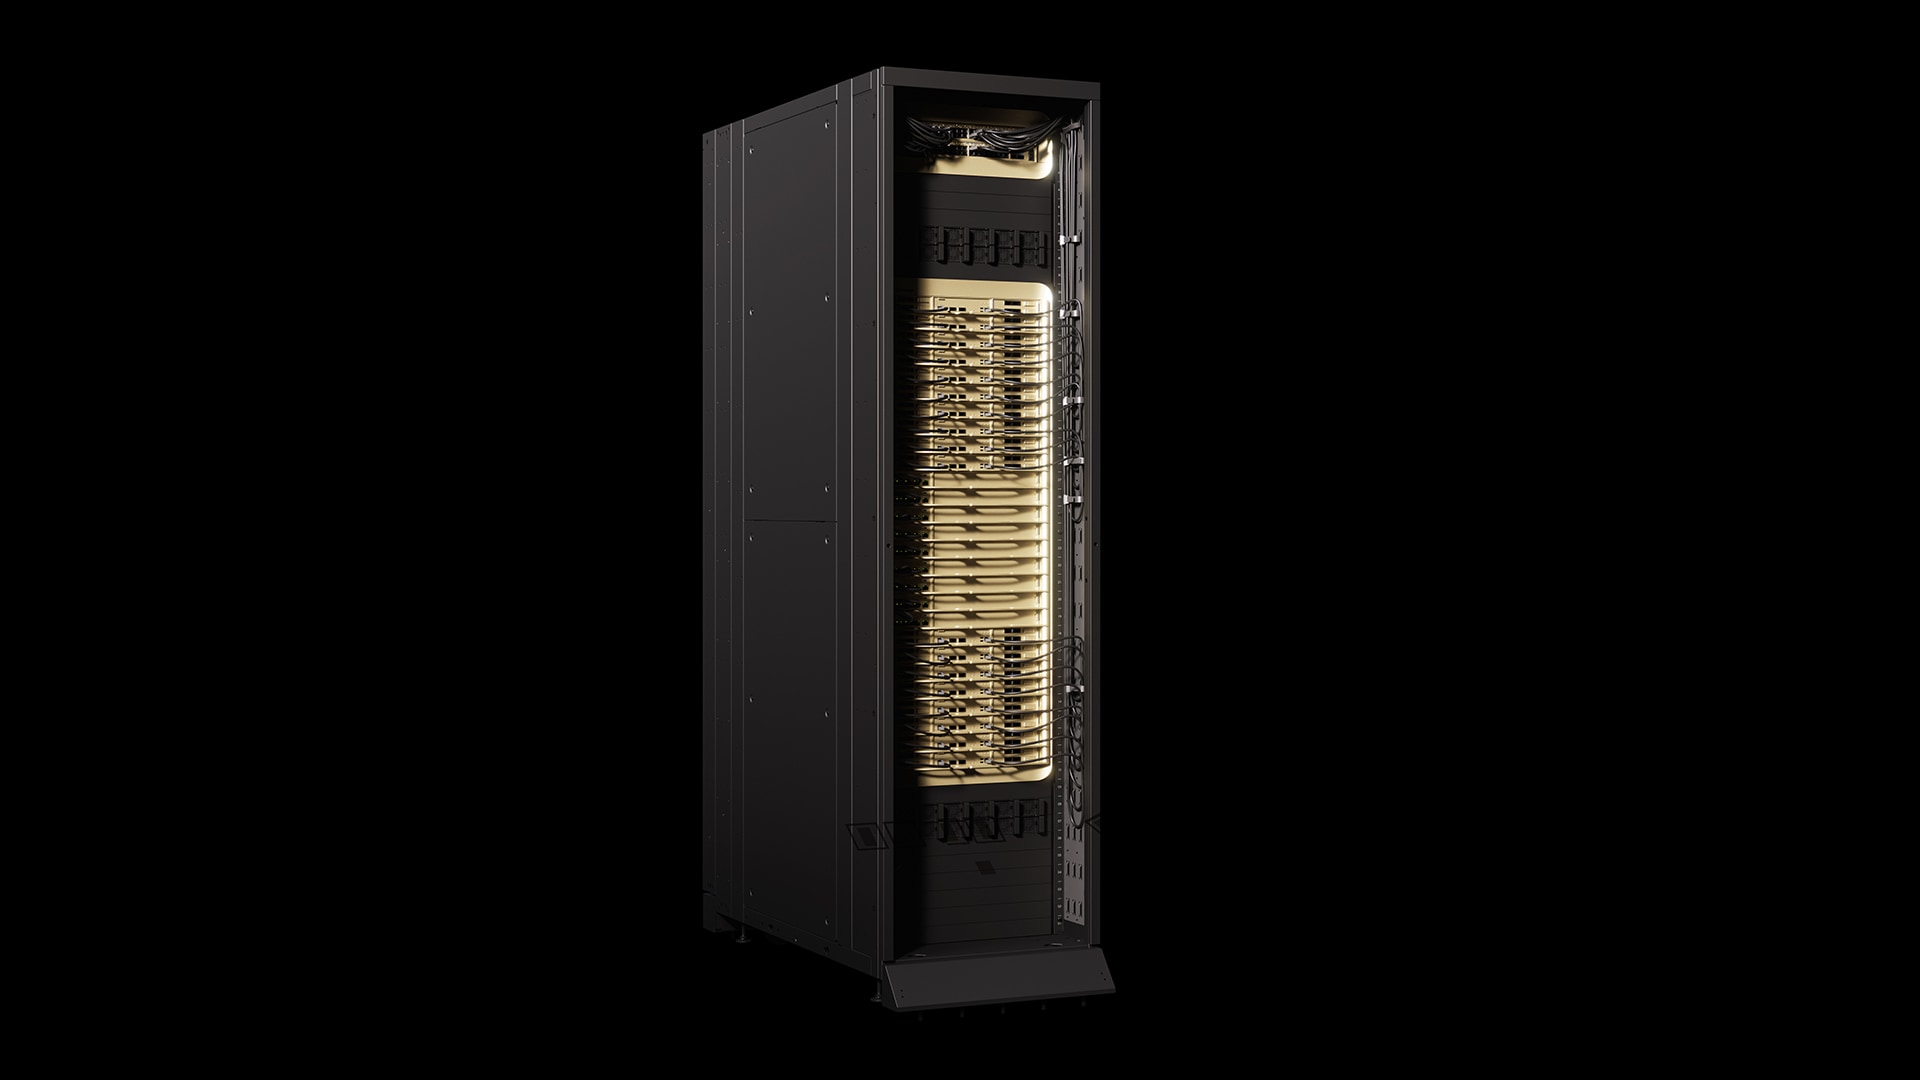
Il rack Vera Rubin NVL72 combina 72 GPU Rubin, 36 CPU Vera, switch NVLink 6 e riservatezza di calcolo di terza generazione. Un esempio citato dalla pagina è l'AI factory nazionale giapponese realizzata con Noetra Corp, che impiega 13.750 CPU Vera e 27.500 GPU Rubin.
Voce | Dettaglio |
|---|---|
Cos'è | Piattaforma multi-rack POD-scale con cinque sistemi rack-scale |
Disponibilità | In piena produzione, secondo NVIDIA; server maker di Taiwan la producono e spediscono |
Prezzi | Non indicati nella fonte |
Contesto | Agenti AI e ragionamento; AI factory in Giappone con Noetra Corp |
Limiti dichiarati | Nella fonte non sono indicati limiti; i confronti con Blackwell sono dichiarazioni del produttore |
DSX: il progetto di riferimento#
NVIDIA DSX unisce progettazione, simulazione, operazioni ed ecosistema di partner per costruire AI factory, data center pensati per produrre output di intelligenza artificiale. Dettagli nella documentazione DSX.
Due componenti#
DSX MaxLPS gestisce la potenza in modo dinamico a livello di GPU, rack e carico di lavoro: NVIDIA dichiara fino al 40% di GPU in più nello stesso budget di megawatt.
DSX Flex riceve segnali dalla rete elettrica, come riduzioni di carico e variazioni di prezzo, e adatta i carichi di lavoro.
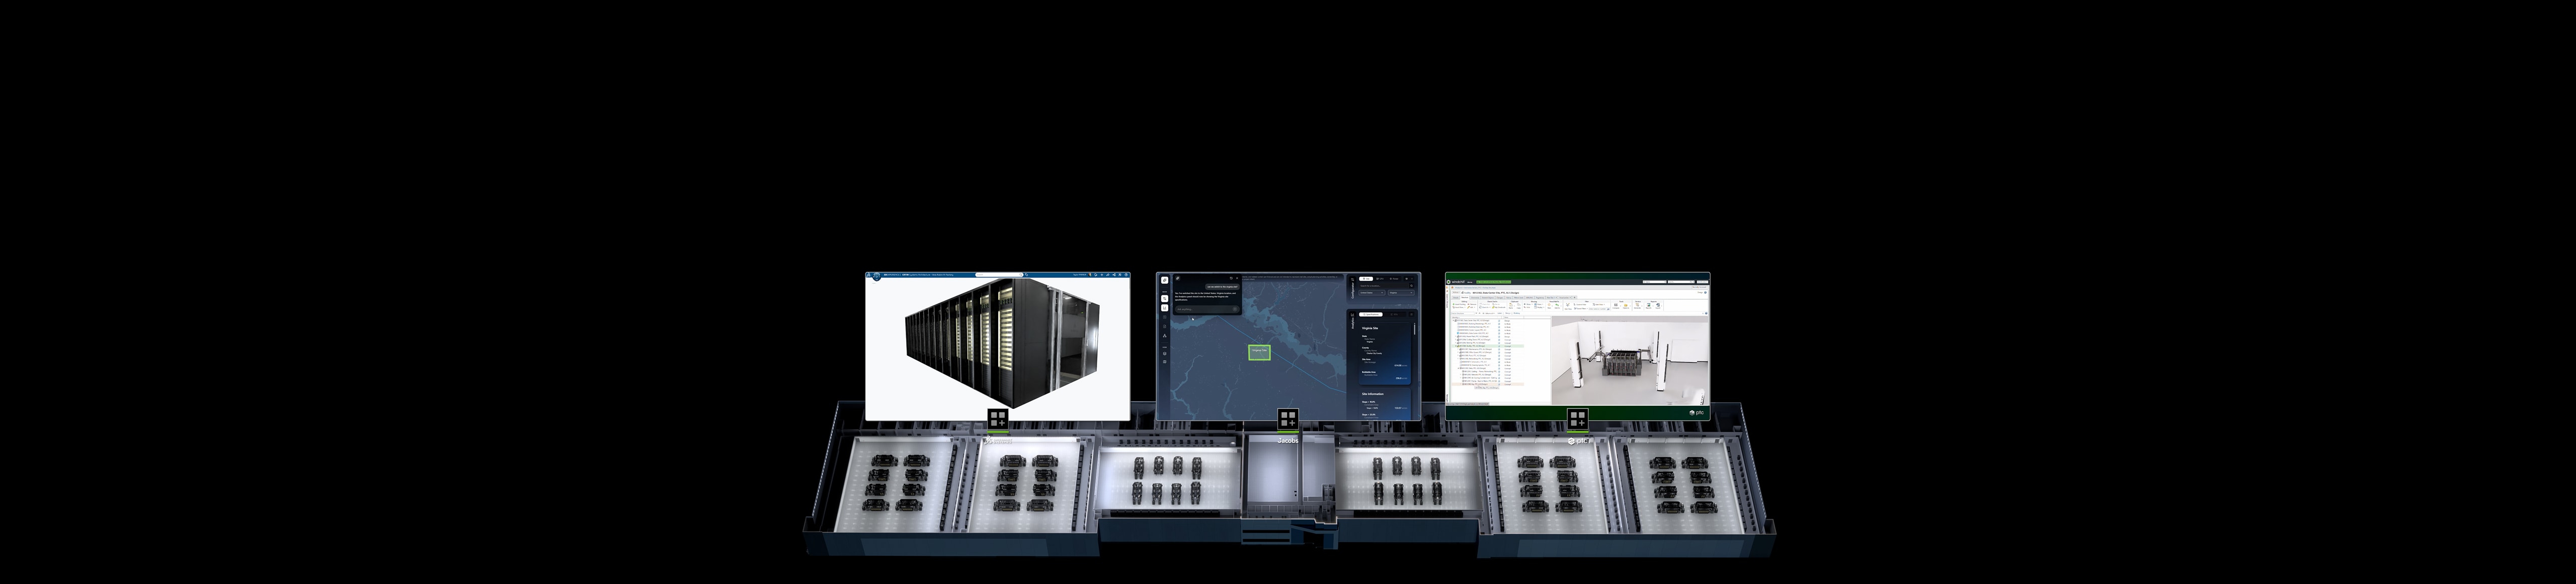
Architettura validata#
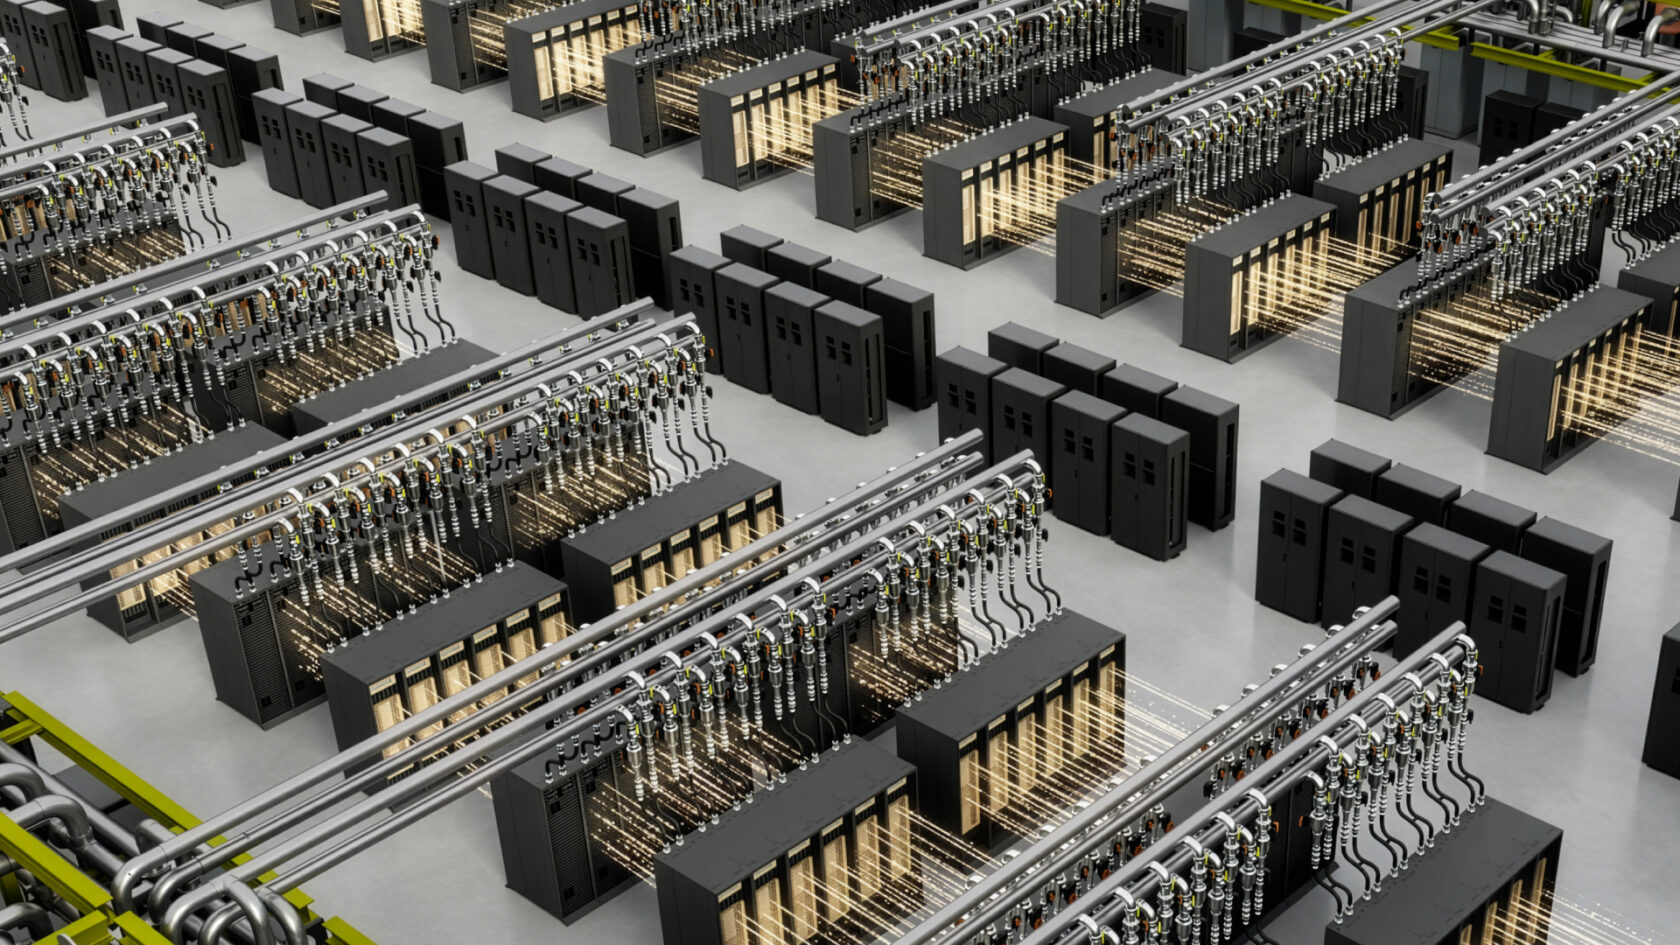
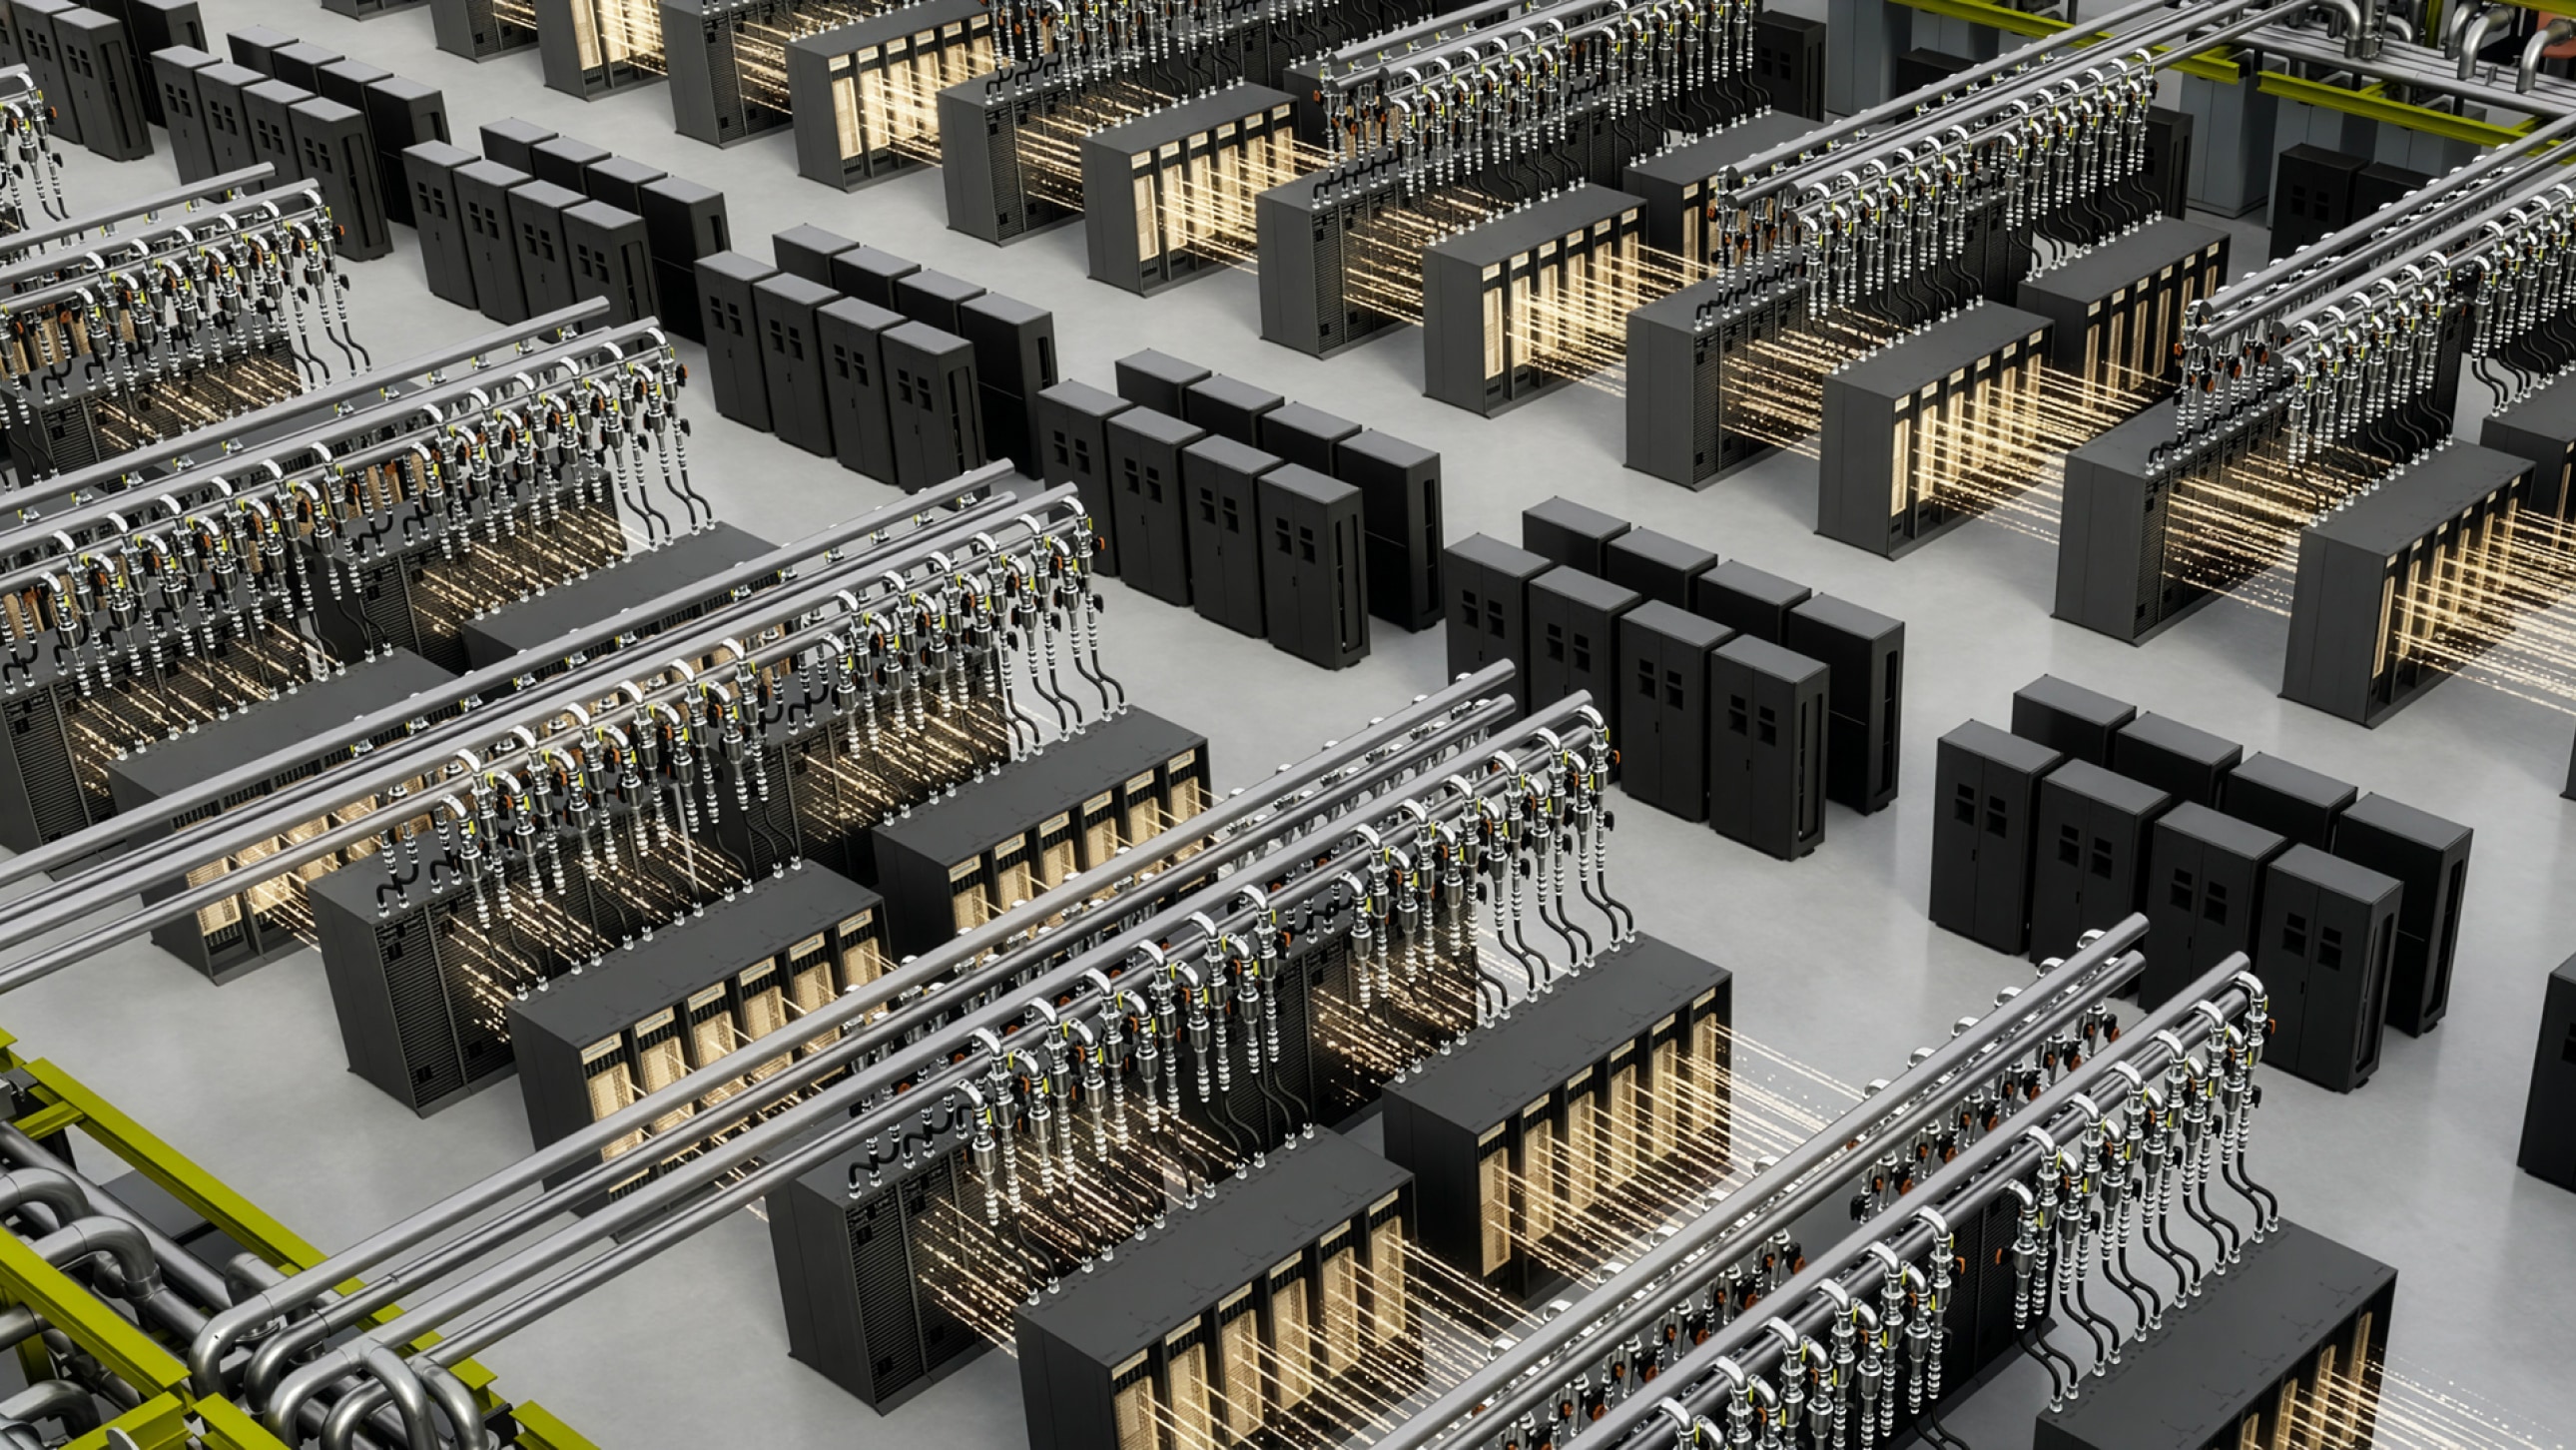
L'immagine mostra il layout validato del reference design: file di rack con tubi di raffreddamento a liquido. Il progetto copre calcolo, rete, storage e infrastrutture.
Glossario#
Tokens per watt: output prodotto per ogni watt consumato.
Digital twin: copia digitale dell'AI factory per simulare il comportamento prima della costruzione.
CDU: unità che distribuisce il liquido di raffreddamento.
Dall'AC al 800 VDC#
Meno conversioni, più potenza per il calcolo#
Oggi l'elettricità arriva dalla rete in corrente alternata e viene convertita più volte prima di raggiungere il chip. Ogni passaggio aggiunge perdite e complessità, e con rack sempre più densi le piccole inefficienze si sommano. Con 800 VDC la distribuzione avviene in corrente continua ad alta tensione, con meno stadi tra rete e acceleratore: più energia disponibile arriva al calcolo (spiegazione completa).
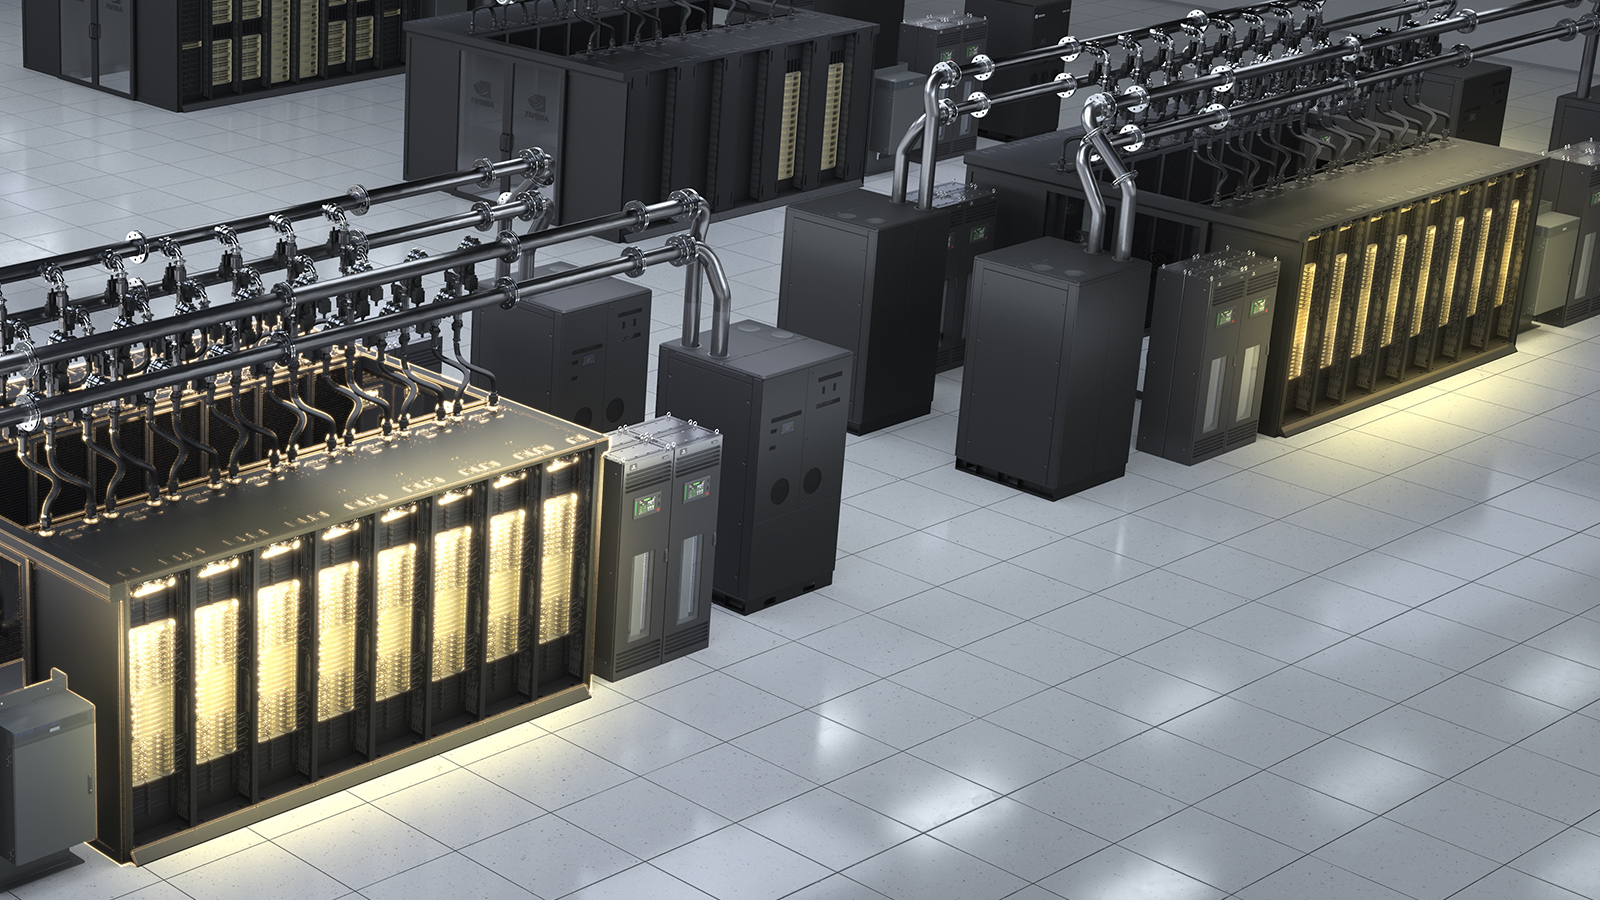
Tre tappe di adozione#
Rack di alimentazione: previsto nella seconda metà del 2026, pensato per impianti AC già operativi.
Row power center: distribuzione su più file di rack, fino a 2 MW per fila, disponibilità prevista nel 2027.
DC power block: unità a scala di impianto per nuovi data center, che converte la rete direttamente a 800 VDC in un solo passaggio.
Secondo la previsione di Wood Mackenzie riportata da NVIDIA, gli investimenti globali in infrastrutture AI e dati fino al 2040 raggiungeranno 9.000 miliardi di dollari.
Piccolo glossario#
AC: corrente alternata, il tipo di corrente con cui arriva la rete elettrica.
VDC: corrente continua, qui a 800 volt.
Rack: armadio che ospita server e acceleratori.
Busway: sbarra di distribuzione aerea che porta la corrente alle file di rack.
Il rack MGX e la CPU Vera#
Due rack, due ruoli#
NVIDIA MGX è un'architettura di riferimento modulare e aperta. Unifica server di calcolo e di rete, raffreddamento, alimentazione e connettori in un unico rack di terza generazione, pensato per tutto l'ecosistema. Nello stesso rack si possono combinare GPU, come NVIDIA Blackwell e NVIDIA Rubin, con CPU Arm, x86 o NVIDIA Vera.
Vera è la CPU progettata per l'AI agentica e per il lavoro intensivo sulla CPU: chiamate a strumenti, esecuzione di codice in sandbox, orchestrazione, analisi, servizi cloud e storage. Può affiancare le GPU come CPU host dei sistemi accelerati oppure operare da sola in tutto il data center, per tenere in movimento le pipeline di AI.
Vera Rubin NVL72: la scheda#
Secondo il produttore, il rack NVIDIA Vera Rubin NVL72 raggiunge fino a 3.600 PFLOPS in NVFP4 inference. La scheda confronta tre configurazioni: il rack con 72 GPU Rubin e 36 CPU Vera, il superchip con 2 GPU Rubin e 1 CPU Vera, e una singola GPU Rubin. Trattandosi di dichiarazioni del produttore, i valori vanno letti come tali.
Configurazione | Rack NVL72 (72 GPU Rubin, 36 CPU Vera) | Superchip (2 GPU Rubin, 1 CPU Vera) | GPU Rubin singola |
|---|---|---|---|
NVFP4 Inference² | 3,600 PFLOPS | 100 PFLOPS | 50 PFLOPS |
NVFP4 Training³ | 2,520 PFLOPS | 70 PFLOPS | 35 PFLOPS |
FP8/FP6 Training³ | 1,260 PFLOPS | 35 PFLOPS | 17.5 PFLOPS |
FP16/BF16³ | 288 PFLOPS | 8 PFLOPS | 4 PFLOPS |
TF32³ | 144 PFLOPS | 4 PFLOPS | 2 PFLOPS |
FP32 | 9,360 TFLOPS | 260 TFLOPS | 130 TFLOPS |
FP64 | 2,400 TFLOPS | 67 TFLOPS | 33 TFLOPS |
GPU Memory | Bandwidth | 20.7 TB HBM4 | 1,400 TB/s | 576 GB HBM4 | 38.5 TB/s | 288 GB HBM4 | 19.2 TB/s |
NVIDIA NVLink | Sixth Generation | — | — |
NVLink Bandwidth | 216 TB/s | 6 TB/s | 3 TB/s |
NVLink-C2C Bandwidth | 65 TB/s | 1.8 TB/s | - |
CPU Core Count | 3,168 custom NVIDIA Olympus cores | 6,336 Threads | 88 custom NVIDIA Olympus cores | 176 Threads | - |
CPU Memory | Up to 54 TB LPDDR5X | Up to 1.5 TB LPDDR5X | - |
Networking Bandwidth⁴ | 32.4 TB/s | 0.9 TB/s | 0.45 TB/s |
Total NVIDIA + HBM4 Chips | 1,296 | 30 | 12 |
GPUs in 100 MW¹ | 40K GPUs | — | — |
Inlet Temp | 45°C | — | — |
Specifiche della scheda NVL72 per configurazione, secondo la scheda tecnica del produttore. Fonte: NVIDIA.
Throughput per configurazione Vera Rubin
Dati in PFLOPS, dichiarati dal produttore
- Rack NVL72
- Superchip
- GPU singola
Fonte: NVIDIA, scheda tecnica Vera Rubin NVL72 (dichiarazioni del produttore)
Il grafico mostra che il rack supera di molto superchip e GPU singola su ogni tipo di calcolo, con il valore più alto in NVFP4 inference. Le note della scheda indicano che i dati di inference NVFP4 sono sparse, mentre quelli di training sono dense. La HBM4 del rack è di 20,7 TB con banda di 1.400 TB/s, e il NVLink di sesta generazione arriva a 216 TB/s.
La AI factory da 100 MW#
NVIDIA dichiara per una AI factory da 100 MW una configurazione con 40K GPU Rubin e MaxLPS, con 12 PB di memoria HBM4 e una banda di 800 PB/s. Le cifre di calcolo e di memoria sono riassunte nella tabella seguente.
NVFP4 inference (sparse)
NVFP4 training (dense)
Banda della memoria GPU
Le note precisano le condizioni di calcolo: i valori si riferiscono a una AI factory su scala costruita con NVIDIA DSX e MaxLPS. Le cifre di inferenza NVFP4 sono specifiche sparse, mentre quelle di training NVFP4, FP8/FP6, FP16/BF16 e TF32 sono dense.
Metrica | 40K GPU NVIDIA Rubin con MaxLPS |
|---|---|
NVFP4 Inference² | 2 ZFLOPS |
NVFP4 Training³ | 1.4 ZFLOPS |
FP8/FP6 Training³ | 700 EFLOPS |
FP16/BF16³ | 160 EFLOPS |
TF32³ | 80 EFLOPS |
GPU Memory | Bandwidth | 12 PB HBM4 | 800 PB/s |
CPU Memory | Up to 30 PB LPDDR5X |
Fast Memory | Up to 42 PB |
Configurazione della AI factory da 100 MW dichiarata da NVIDIA, con le note su sparse e dense. Fonte: NVIDIA.
Si tratta di dichiarazioni del produttore, non verificate da terzi: vanno quindi lette come dati di NVIDIA e non come prestazioni misurate in un impianto in funzione.
Spectrum-X: la rete#
Secondo NVIDIA, la piattaforma Spectrum-X Ethernet accelera le prestazioni della rete per l'AI di 1,6x rispetto all'Ethernet standard disponibile sul mercato. Si tratta di una dichiarazione del produttore, non di un benchmark indipendente.
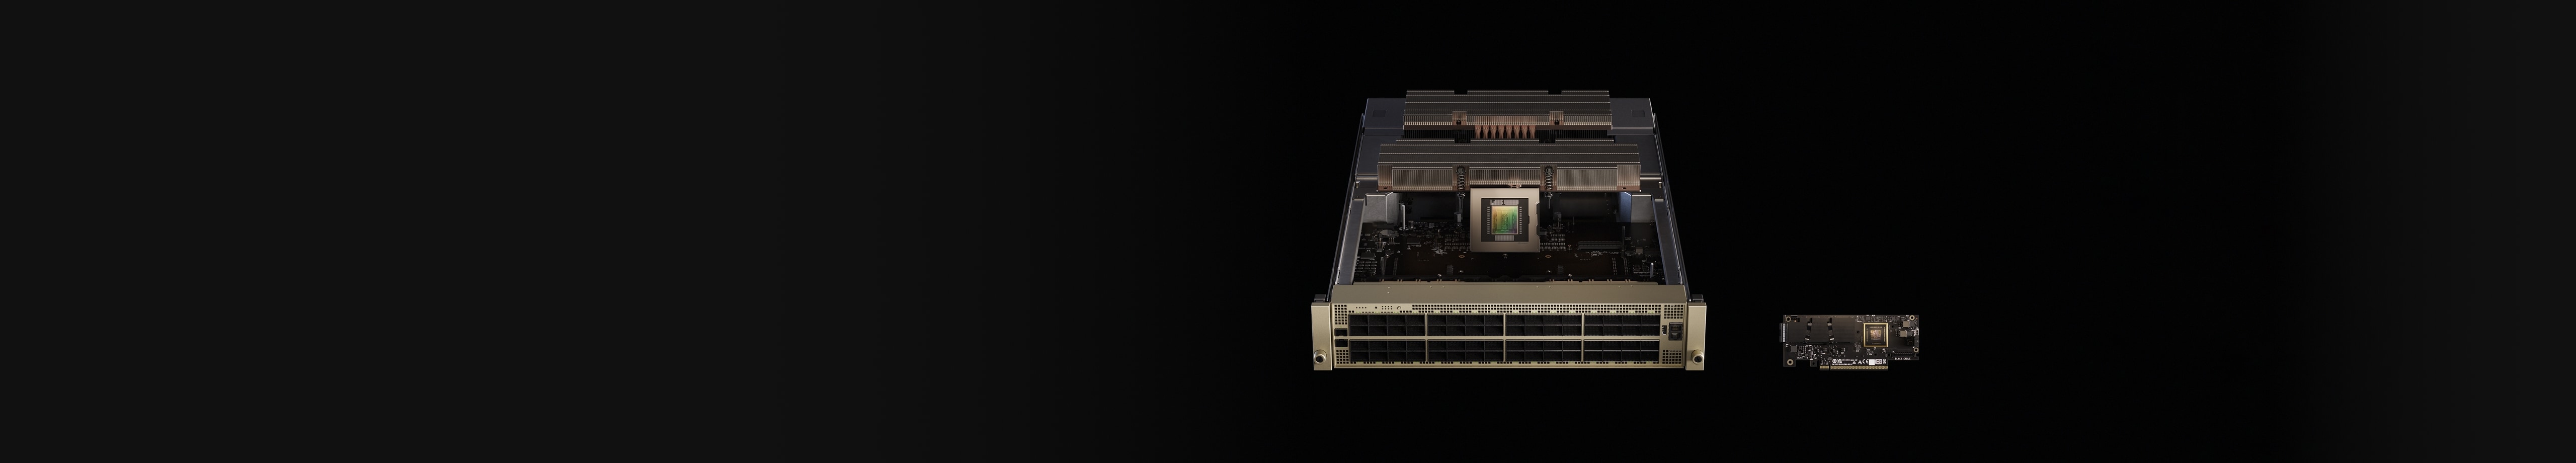
Con Spectrum-X Multiplane, ogni SuperNIC divide il traffico su due o più piani di rete indipendenti. La topologia a due livelli arriva così fino a 128.000 GPU, cioè 64 volte le reti a piano singolo.
Per collegare più data center, Spectrum-XGS Ethernet dichiara 1,9x di prestazioni NCCL in ambienti cross-data center, anche con siti distanti centinaia di chilometri.
Come leggere questi numeri#
Quasi tutti i numeri di questa notizia arrivano da NVIDIA, sia dai comunicati dell'OCP sia dalle pagine di prodotto. Nelle fonti consultate non compare alcuna misurazione indipendente: sono dichiarazioni del produttore.
I confronti di inferenza usano il modello Kimi-K2 (nella variante Thinking per il costo per milione di token), con lunghezze 32K/8K ISL/OSL, e mettono a confronto Vera Rubin NVL72 con GB200 NVL72. Il produttore indica le prestazioni come soggette a modifiche e definisce «projected» quelle di addestramento, che si basano su un modello MoE da 10T parametri addestrato su 100T token in 1 mese.
Le cifre in FLOPS sono annotate: l'inferenza NVFP4 è una specifica sparse, mentre training e FP16/BF16 sono dense. Confrontare valori sparse con valori dense, o con generazioni precedenti, richiede cautela.
Cosa significa per un'azienda#
Per una PMI o un professionista, le fonti indicano quattro verifiche concrete prima di investire in infrastrutture per l'AI:
Verificate se il vostro sito usa ancora distribuzione in corrente alternata (AC). Il power rack 800 VDC, previsto nel secondo semestre 2026, si inserisce in un'infrastruttura AC esistente senza modifiche all'impianto elettrico dell'edificio, quindi il passaggio può avvenire per gradi.
Chiedete ai fornitori la conformità alla Open Data Center Specification v0.7, alle specifiche OCP Grid Resilience e MGX 1.2, e ai reference design NVIDIA DSX.
Valutate strumenti aperti come i componenti open source di DSX OS, come NVIDIA Config Manager e Cluster Readiness Engine, disponibili su GitHub per configurare reti e validare cluster.
Chiedete la misura reale dei token per watt. Il dato di 10x più token per megawatt rispetto a GB200 NVL72 è una dichiarazione del produttore, soggetta a variazioni e riferita a modelli e configurazioni specifiche.
Se non disponete di personale tecnico per queste verifiche, potete rivolgervi a chi offre servizi di AI alle aziende in Italia.
Domande frequenti#
Che cos'è una AI factory secondo NVIDIA DSX?
Secondo la documentazione di NVIDIA, una AI factory è progettata per i carichi di lavoro di AI, con attenzione a inferenza, efficienza energetica e costo minimo per token. A differenza dei data center tradizionali, che archiviano, elaborano e distribuiscono informazioni, una AI factory genera intelligenza trasformando dati ed energia in token, previsioni e simulazioni. NVIDIA dichiara che i suoi componenti sono progettati insieme come sistema unico.
Che cosa cambia con l'architettura 800 VDC?
NVIDIA indica che l'architettura 800 VDC può ridurre il numero di stadi di conversione dell'energia, le perdite di distribuzione e la complessità infrastrutturale, per sostenere sistemi AI da megawatt in futuro. La fonte non fornisce un confronto diretto con la corrente alternata (AC), quindi non è possibile quantificare la differenza.
Che cosa significa Multiplane?
Spectrum-X Multiplane divide la SuperNIC di ogni GPU su due o più piani di rete indipendenti, mantenendo una topologia piatta a due livelli. Secondo NVIDIA, questo permette di arrivare fino a 128.000 GPU con due livelli, cioè 64 volte più di una rete a piano singolo.
Perché Spectrum-X Photonics è citato come più efficiente?
NVIDIA spiega che la tecnologia co-packaged optics colloca l'ottica sullo stesso package dello switch ASIC. Il produttore dichiara 5 volte di efficienza energetica di rete, 5 volte di tempo di funzionamento sostenuto e 10 volte di tempo medio tra interruzioni rispetto agli switch con transceiver pluggable. Si tratta di dati forniti da NVIDIA, non verificati indipendentemente.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 6/10 | Il produttore dichiara un costo per milione di token pari a un decimo rispetto a GB200 NVL72, ma le fonti indicano che le prestazioni sono soggette a modifiche e non risultano verificate da terzi. |
Prezzo e disponibilità | 4/10 | Le fonti non indicano alcun prezzo; il rack di alimentazione a 800 VDC è annunciato per la seconda metà del 2026 e la row power center per il 2027. |
Apertura e standard | 7/10 | NVIDIA ha contribuito i progetti di rack e vassoi di calcolo Vera Rubin alla specifica aperta MGX tramite OCP, con la versione MGX 1.2. |
Uso in azienda | 6/10 | Il DGX Vera Rubin NVL72 è proposto come soluzione turnkey per le imprese, ma le fonti non forniscono dettagli su costi di installazione o tempi di consegna. |
Trasparenza dei dati | 5/10 | Le specifiche includono note su dati densi e sparsi, ma molti confronti sono proiezioni soggette a modifiche e il riferimento di costo è solo il GB200 NVL72. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
NVIDIA presenta Vera Rubin come piattaforma aperta per AI factory; i numeri di prestazione e costo sono dichiarati dal produttore e non verificati da terzi.
Per chi deve decidere, l'annuncio è solido sul fronte degli standard aperti e delle specifiche tecniche pubblicate. Il valore economico dichiarato, cioè un decimo del costo per milione di token rispetto a GB200 NVL72, resta però un dato del produttore, senza prezzi indicati nelle fonti. Per le infrastrutture esistenti conviene verificare la disponibilità del rack a 800 VDC nella seconda metà del 2026 prima di pianificare investimenti.
Punti di forza
- Rack e vassoi di calcolo Vera Rubin contribuiti alla specifica aperta MGX 1.2 tramite OCP.
- Rack fino a 250 kW e busbar a liquido da 5.000 A dichiarati nella specifica MGX 1.2.
- Spectrum-X dichiarato migliorare le prestazioni di rete dell'1,6x rispetto all'Ethernet standard.
- Specifiche tecniche pubblicate per NVL72: 72 GPU Rubin, 36 CPU Vera e 20,7 TB di HBM4 per rack.
Limiti
- Prezzi non indicati nelle fonti.
- Le prestazioni sono dichiarate dal produttore e marcate come soggette a modifiche; nessuna verifica indipendente nelle fonti.
- Il confronto di costo per token è solo con GB200 NVL72.
- Il rack a 800 VDC e la row power center non sono ancora disponibili: previsti per la seconda metà del 2026 e per il 2027.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.NVIDIA — OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwideblogs.nvidia.com
Annuncio ufficiale da cui nasce l’articolo.
- 2.NVIDIA — NVIDIA Vera Rubin: Driving the Era of Agentic AInvidia.com
Documento ufficiale collegato all’annuncio.
- 3.NVIDIA — NVIDIA DSX: Your Blueprint for AI Factory Design and Deploymentnvidia.com
Documento ufficiale collegato all’annuncio.
- 4.NVIDIA — Why Scaling AI Compute Performance Requires a New Power Architectureblogs.nvidia.com
Documento ufficiale collegato all’annuncio.
- 5.
- 6.
- 7.NVIDIA — NVIDIA Spectrum-X Ethernet Networking Platformnvidia.com
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.