Cisco porta i server Supermicro nella Secure AI Factory con NVIDIA, mentre NVIDIA e Cisco preparano un modulo ottico da 400 Gb/s per corsia
NVIDIA e Cisco annunciano il modulo ottico USFP a 400 Gb/s per corsia, mentre la piattaforma Vera Rubin NVL72 entra in produzione. Ecco i numeri dichiarati dai produttori e come leggerli con prudenza.
di Andrea Pirazzini
Fonte primaria
NVIDIA — NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories
nvidianews.nvidia.com
Marco
Il Narratore · 2 min 21 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: NVIDIA — NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories.
Perché se ne parla#
Il 12 ottobre 2026 NVIDIA e Cisco hanno annunciato piani per USFP (Ultra-Dense Small Form Factor Pluggable), un nuovo modulo ottico pluggable da 400 Gb/s per corsia destinato alle AI factory, cioè ai data center per l'addestramento e l'inferenza dei modelli di intelligenza artificiale. Il problema è questo: scalare un'AI factory richiede più banda per ogni connessione e più connessioni per ogni switch. Quando uno switch raggiunge la sua capacità, per espandere la rete servono altri livelli di switch e altri collegamenti ottici, con più latenza, più consumi e più costi.
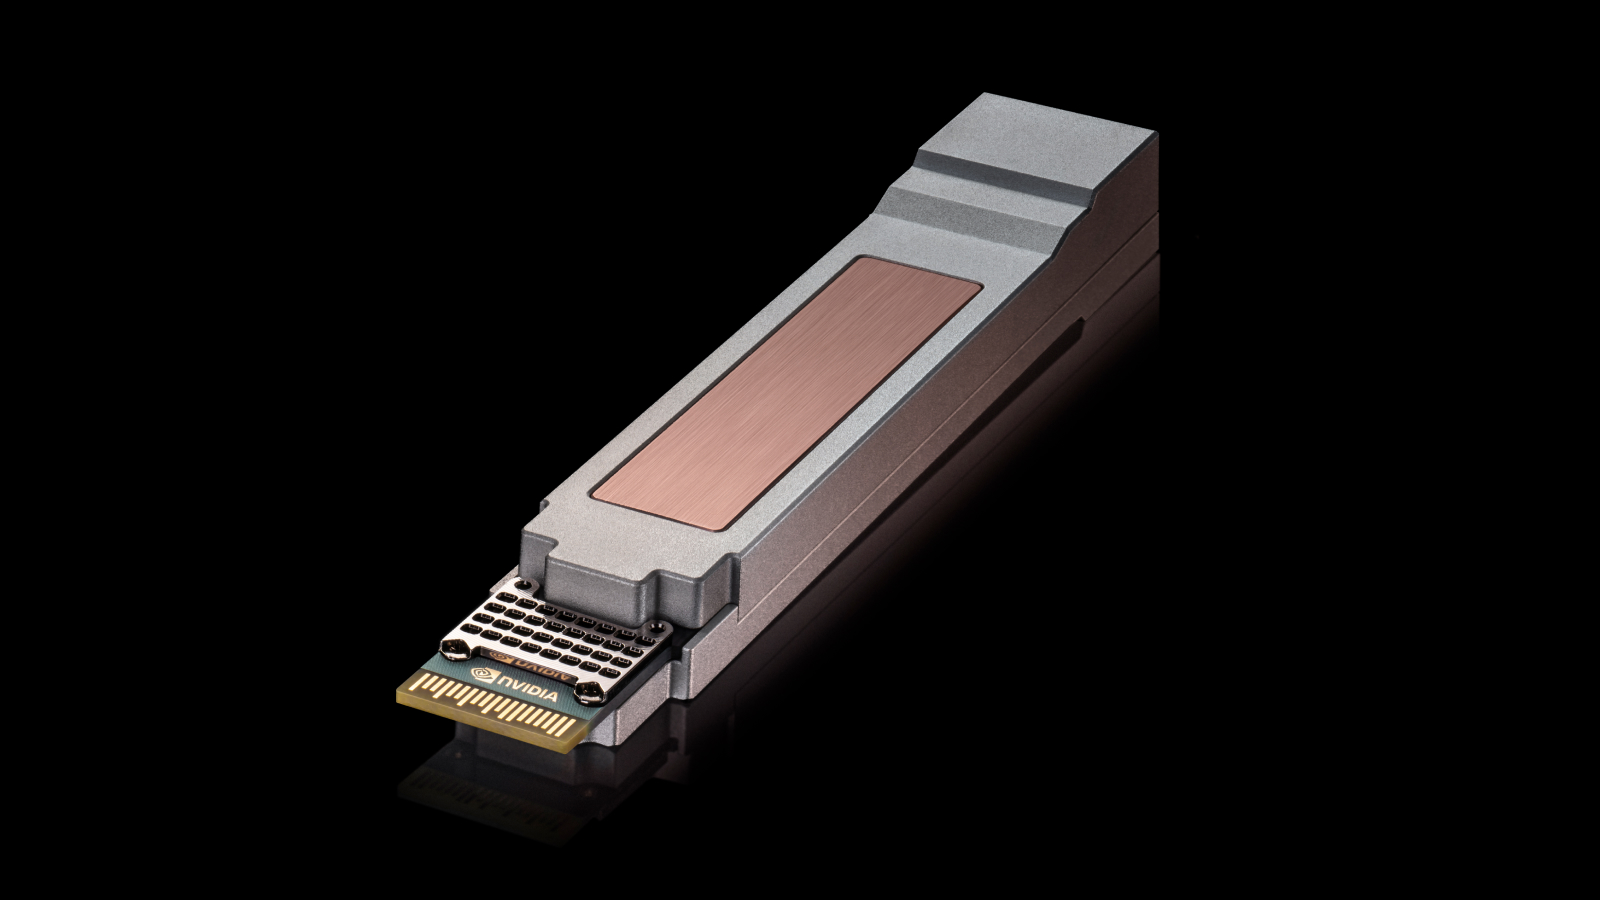
USFP prevede 16 corsie full-duplex in un ingombro di tipo OSFP, con una capacità complessiva di 12,8 Tb/s, secondo i produttori. Il modulo usa un connettore a due fasi: i contatti ad alta velocità si agganciano solo dopo l'inserimento, riducendo l'usura. Supporta una dissipazione fino a 100 watt senza un circuito di raffreddamento dedicato integrato nel transceiver, il che semplifica il progetto degli switch.
Alla realizzazione collaborano TE Connectivity e Amphenol, che sviluppano cage, connettori e moduli, con altri partner attesi. La specifica aperta arriverà da un futuro progetto multi-source guidato dalla community. Per i dettagli tecnici, leggete il comunicato congiunto di NVIDIA e Cisco: comunicato ufficiale di NVIDIA e Cisco su USFP.
I numeri di testa#
Capacità complessiva USFP
Dichiarata da NVIDIA e Cisco per i primi moduli previsti, 16 corsie full-duplex
Banda rispetto a 200 Gb/s per corsia
Dichiarazione NVIDIA e Cisco, con efficienza energetica circa 1,3x
GPU per addestrare modelli MoE rispetto a GB200 NVL72
Dichiarazione NVIDIA su un modello MoE da 10T parametri
Costo per milione di token rispetto a GB200 NVL72
Dichiarazione NVIDIA, modello Kimi-K2-Thinking con 32K/8K ISL/OSL
Modulo ottico USFP (400 Gb/s) contro ottiche a 200 Gb/s per corsia
Confronto su velocità per corsia, corsie supportate e moltiplicatori di densità ed efficienza dichiarati da NVIDIA e Cisco
- Ottiche 200G / OSFP
- USFP 400G (NVIDIA e Cisco)
Fonte: Comunicato ufficiale congiunto NVIDIA e Cisco (12 ottobre 2026)
I numeri provengono da fonti diverse e vanno letti con le loro condizioni. I 12,8 Tb/s e il rapporto 4x riguardano i moduli USFP, che NVIDIA e Cisco presentano come piani futuri, e il confronto è con moduli da 200 Gb/s per corsia a parità di ingombro OSFP. Il rapporto 1/4 delle GPU e il decimo del costo per token sono invece dichiarazioni NVIDIA su Vera Rubin NVL72 rispetto a GB200 NVL72, basate su proiezioni e su test specifici. La stessa pagina NVIDIA precisa che le prestazioni sono soggette a modifica: si tratta di stime del produttore, non di misure indipendenti.
Cisco amplia la Secure AI Factory con NVIDIA#
Cisco porta sistemi rack-scale nella Secure AI Factory#
Il 25 agosto 2026 Cisco ha annunciato, insieme a Supermicro, l'ampliamento della Secure AI Factory con NVIDIA. Entrano nel portafoglio sistemi rack-scale e server ad alta densità, raffreddati a liquido o ad aria, venduti come parte dell'infrastruttura AI di Cisco (Leggi l'annuncio).
L'architettura è compatibile con gli NVIDIA Cloud Partner (NCP) e si rivolge a neocloud e cloud sovrani. Gli switch Cisco Silicon One gestiscono il front-end, gli switch basati su NVIDIA Spectrum-X il back-end, e Cisco Nexus One li unifica. Cisco afferma di essere l'unico partner NVIDIA che usa propri switch e proprio sistema operativo di rete in una soluzione NCP: è una dichiarazione del produttore.
Cosa significa per un'azienda#
Pianificate gli investimenti tenendo presente che la fornitura dei sistemi Supermicro nella Secure AI Factory parte da ottobre 2026.
Chiedete ai fornitori come riducono il rischio di consegna, come certificano che l'infrastruttura sia costruita secondo il progetto (con CVIS) e come semplificano le operazioni con strumenti già noti.
Se offrite capacità AI a clienti in cloud sovrano o neocloud, valutate l'architettura NCP compliant come riferimento.
Jeetu Patel, President and Chief Product Officer di Cisco, sostiene che la velocità conta solo con controllo dei dati, costi dei token gestiti e ritorno reale. Justin Boitano, vice president Enterprise AI di NVIDIA, afferma che le AI factory sono infrastruttura che genera ricavi.
Vera Rubin NVL72: la scheda di sintesi#
Questa scheda riassume la piattaforma NVIDIA Vera Rubin NVL72, come presentata dal produttore: i dati sono forniti da NVIDIA e, dove indicato, sono proiezioni soggette a modifiche.
Secondo NVIDIA, l'addestramento di modelli mixture-of-experts richiede un quarto delle GPU rispetto a GB200 NVL72, mentre l'inferenza costa un decimo per milione di token. Il confronto usa il modello Kimi-K2-Thinking con sequenze da 32K in ingresso e 8K in uscita. Si tratta di dichiarazioni del produttore, non di verifiche indipendenti.
Voce | Dettaglio |
|---|---|
Cos'è | Rack-scale con 72 GPU Rubin e 36 CPU Vera, ConnectX-9, BlueField-4, NVLink 6 e design MGX di terza generazione |
Disponibilità | Indicata come «Available Now» sulla pagina NVIDIA; l'annuncio parla di rampa in piena produzione |
Prezzi | Non pubblicati; la pagina rimanda al contatto commerciale |
Contesto | Configurazione da 100 MW con 40K GPU Rubin e MaxLPS |
Limiti dichiarati | Performance soggette a modifiche; specifiche sparse per l'inferenza e dense per l'addestramento; configurazione basata su NVIDIA DSX con MaxLPS |
Voce | Valore dichiarato |
|---|---|
NVFP4 Inference² | 2 ZFLOPS |
NVFP4 Training³ | 1.4 ZFLOPS |
FP8/FP6 Training³ | 700 EFLOPS |
FP16/BF16³ | 160 EFLOPS |
TF32³ | 80 EFLOPS |
GPU Memory | Bandwidth | 12 PB HBM4 | 800 PB/s |
CPU Memory | Up to 30 PB LPDDR5X |
Fast Memory | Up to 42 PB |
Configurazione da 100 MW secondo la scheda NVIDIA, con le note del produttore su specifiche sparse e dense. Fonte: NVIDIA.
Configurazioni: dal rack al singolo chip#
Come leggere le tre configurazioni#
Le colonne confrontano il rack da 72 GPU Rubin e 36 CPU Vera, il superchip da 2 GPU Rubin e 1 CPU Vera e la singola GPU Rubin, con prestazioni, memoria HBM4 e banda NVLink dichiarate da NVIDIA per ciascuna.
Dalla singola GPU al rack#
Passando dalla singola GPU Rubin al rack completo, la memoria HBM4 cresce da 288 GB a 20,7 TB e la banda NVLink da 3 TB/s a 216 TB/s. Nella tabella si leggono anche i valori per ciascun formato di calcolo.
Configurazione | Rack: 72 GPU Rubin e 36 CPU Vera | Superchip: 2 GPU Rubin e 1 CPU Vera | Singola GPU Rubin |
|---|---|---|---|
NVFP4 Inference² | 3,600 PFLOPS | 100 PFLOPS | 50 PFLOPS |
NVFP4 Training³ | 2,520 PFLOPS | 70 PFLOPS | 35 PFLOPS |
FP8/FP6 Training³ | 1,260 PFLOPS | 35 PFLOPS | 17.5 PFLOPS |
FP16/BF16³ | 288 PFLOPS | 8 PFLOPS | 4 PFLOPS |
TF32³ | 144 PFLOPS | 4 PFLOPS | 2 PFLOPS |
FP32 | 9,360 TFLOPS | 260 TFLOPS | 130 TFLOPS |
FP64 | 2,400 TFLOPS | 67 TFLOPS | 33 TFLOPS |
GPU Memory | Bandwidth | 20.7 TB HBM4 | 1,400 TB/s | 576 GB HBM4 | 38.5 TB/s | 288 GB HBM4 | 19.2 TB/s |
NVIDIA NVLink | Sixth Generation | — | — |
NVLink Bandwidth | 216 TB/s | 6 TB/s | 3 TB/s |
NVLink-C2C Bandwidth | 65 TB/s | 1.8 TB/s | - |
CPU Core Count | 3,168 custom NVIDIA Olympus cores | 6,336 Threads | 88 custom NVIDIA Olympus cores | 176 Threads | - |
CPU Memory | Up to 54 TB LPDDR5X | Up to 1.5 TB LPDDR5X | - |
Networking Bandwidth⁴ | 32.4 TB/s | 0.9 TB/s | 0.45 TB/s |
Total NVIDIA + HBM4 Chips | 1,296 | 30 | 12 |
GPUs in 100 MW¹ | 40K GPUs | — | — |
Inlet Temp | 45°C | — | — |
Specifiche dichiarate da NVIDIA per le tre configurazioni del Vera Rubin NVL72: prestazioni di inferenza e training NVFP4, FP8/FP6, FP16/BF16, memoria HBM4 e banda NVLink. Fonte: NVIDIA.
Rack e chip in immagini#
La piattaforma Vera Rubin è composta da sette chip, che NVIDIA elenca così. Il rack NVL72 li riunisce in un unico sistema, come descritto nella scheda NVIDIA.
Rubin GPU: processore pensato per calcoli in parallelo, usato per i modelli AI.
Vera CPU: processore generico che affianca le GPU.
NVLink 6 switch: componente che collega i chip del rack ad alta velocità.
ConnectX-9: scheda di rete (SuperNIC) per collegare i server.
BlueField-4: DPU, processore che gestisce rete e dati.
Spectrum-6 SPX Ethernet: infrastruttura Ethernet per collegare più rack.
Groq 3 LPX: rack abbinato all'inferenza, cioè all'uso di un modello già addestrato.
Secondo NVIDIA, con i rack Groq 3 LPX il sistema offre fino a 35 volte più throughput per megawatt per modelli da un trilione di parametri. È una dichiarazione del produttore, basata su proiezioni. NVIDIA indica inoltre che Vera Rubin è in piena produzione, e che con Noetra Corp. sta lanciando in Giappone un'AI factory con 27.500 GPU Rubin.
Cisco N9100: switch per reti AI#
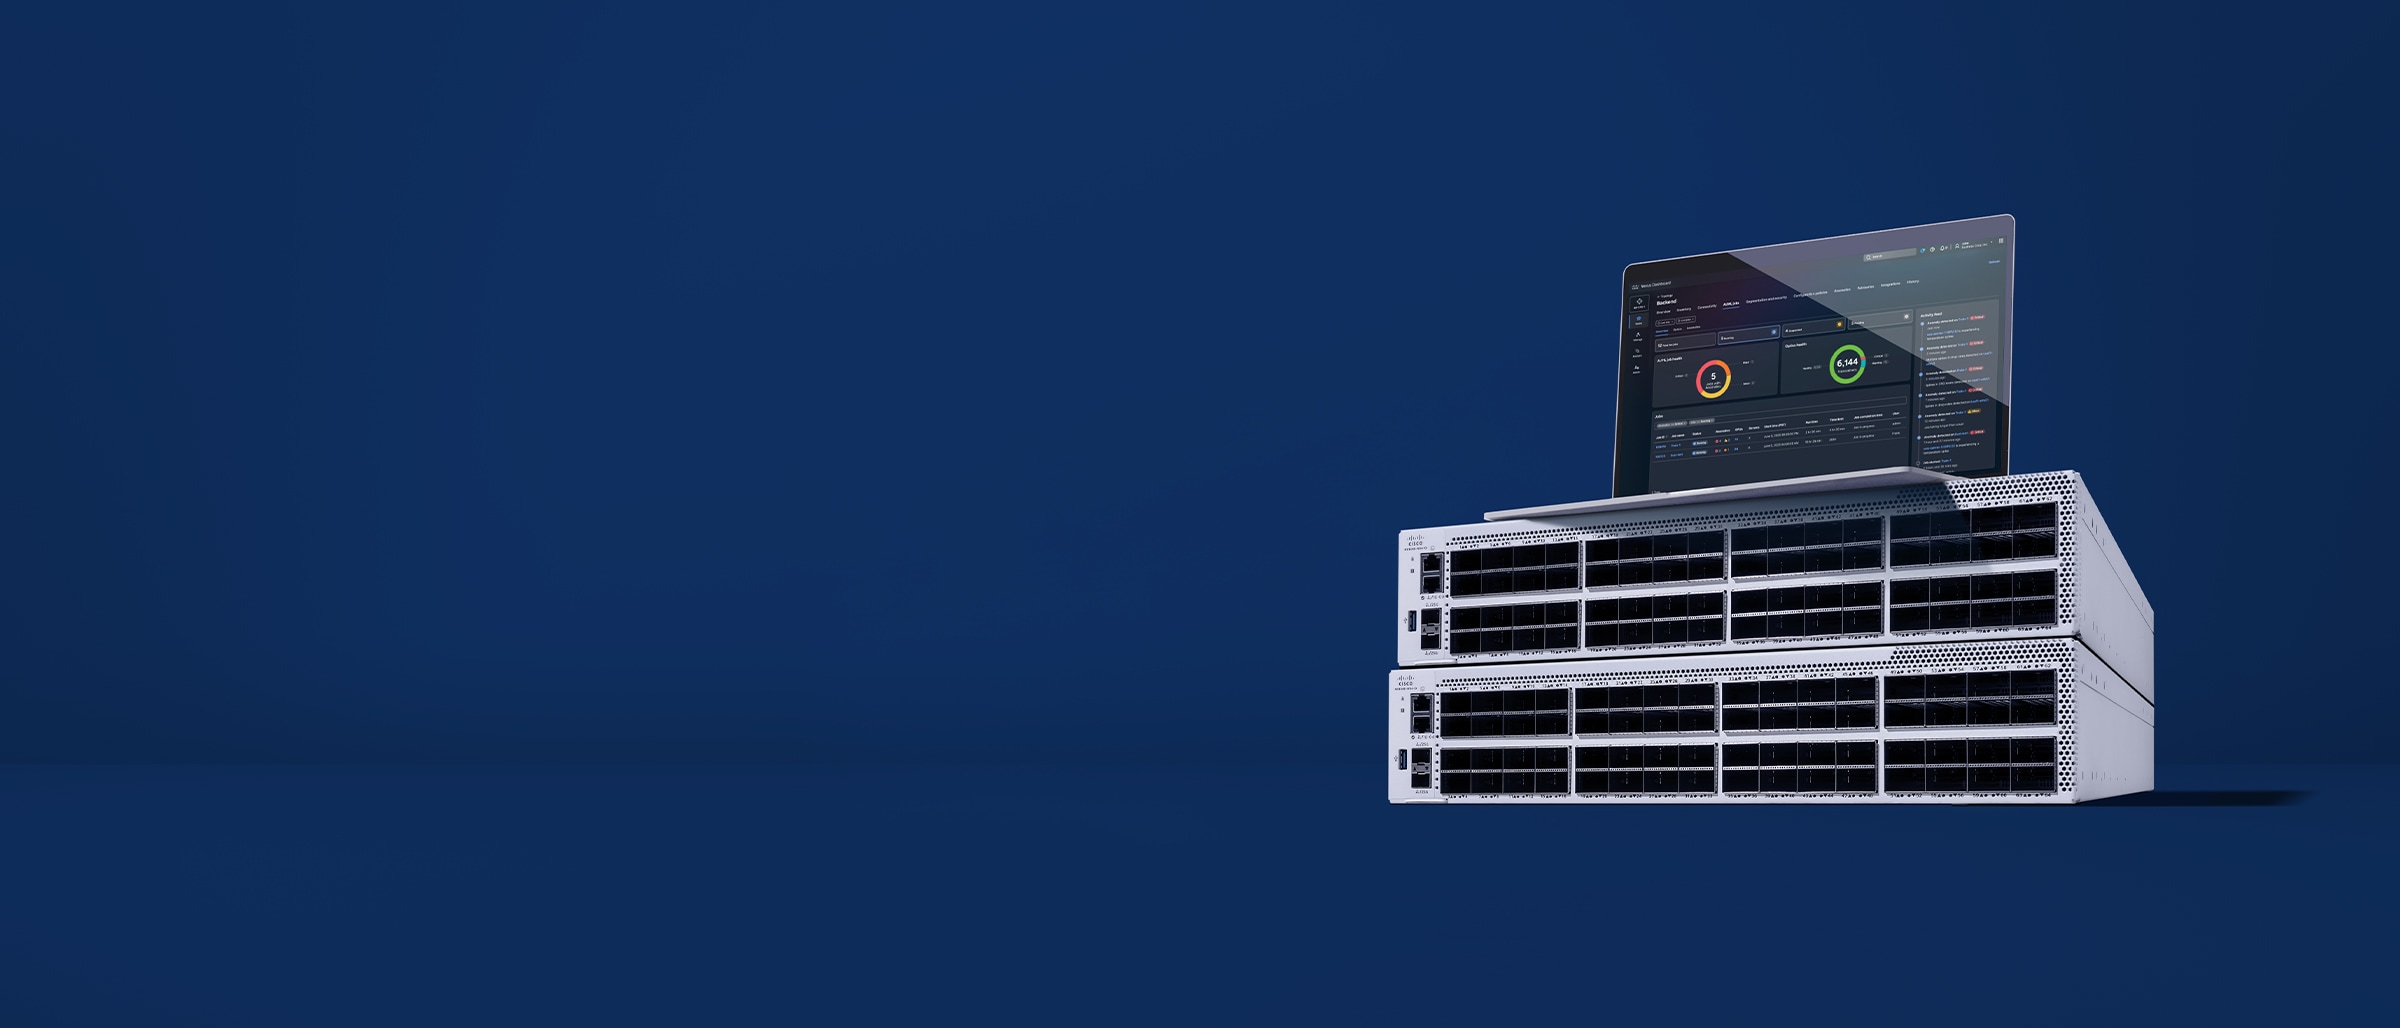
Secondo Cisco, la serie N9100 è composta da switch basati sul silicio NVIDIA Spectrum-X Ethernet, pensati per neocloud e cloud sovrani e dichiarati compatibili con l'architettura di riferimento NVIDIA Cloud Partner (NCP). Il produttore indica una banda di 51,2 Tbps e 102,4 Tbps, con Ethernet senza perdite e bassa latenza per i carichi AI. Cisco affianca a questi modelli anche silicio Cisco Silicon One e Cloud Scale.
Sistema operativo e gestione#
Per il sistema operativo potete scegliere tra NX-OS e SONiC. La gestione passa da Nexus One, piano di gestione unificato che si appoggia a Nexus Dashboard on-premises oppure a Nexus Hyperfabric in cloud. Secondo la scheda, questo approccio semplifica provisioning, monitoraggio e ottimizzazione delle reti AI.
Voce | Dettaglio (secondo Cisco) |
|---|---|
Cos'è | Switch per reti AI basati su NVIDIA Spectrum-X Ethernet |
Banda | 51,2 Tbps e 102,4 Tbps |
Rete | Ethernet senza perdite, bassa latenza |
Sistemi operativi | NX-OS o SONiC |
Gestione | Nexus One con Nexus Dashboard on-premises o Nexus Hyperfabric in cloud |
Destinazione | Neocloud, cloud sovrani, enterprise e data center telco |
Disponibilità | Non indicata nella scheda |
Prezzi | Non indicati nella scheda |
Limiti dichiarati | La scheda non ne elenca |
Per approfondire le specifiche e il quadro di riferimento, potete consultare la scheda prodotto Cisco N9100 e il materiale su Accelerating GPUaaS and AI factory performance.
GB200 NVL72: il sistema precedente#
GB200 NVL72 è il sistema della generazione precedente a Vera Rubin. NVIDIA lo descrive come un rack raffreddato a liquido che collega 36 CPU Grace e 72 GPU Blackwell, con un dominio NVLink da 72 GPU che si comporta come un'unica GPU e offre 130 TB/s di banda. Il superchip GB200 Grace Blackwell combina due GPU Blackwell e una CPU Grace.
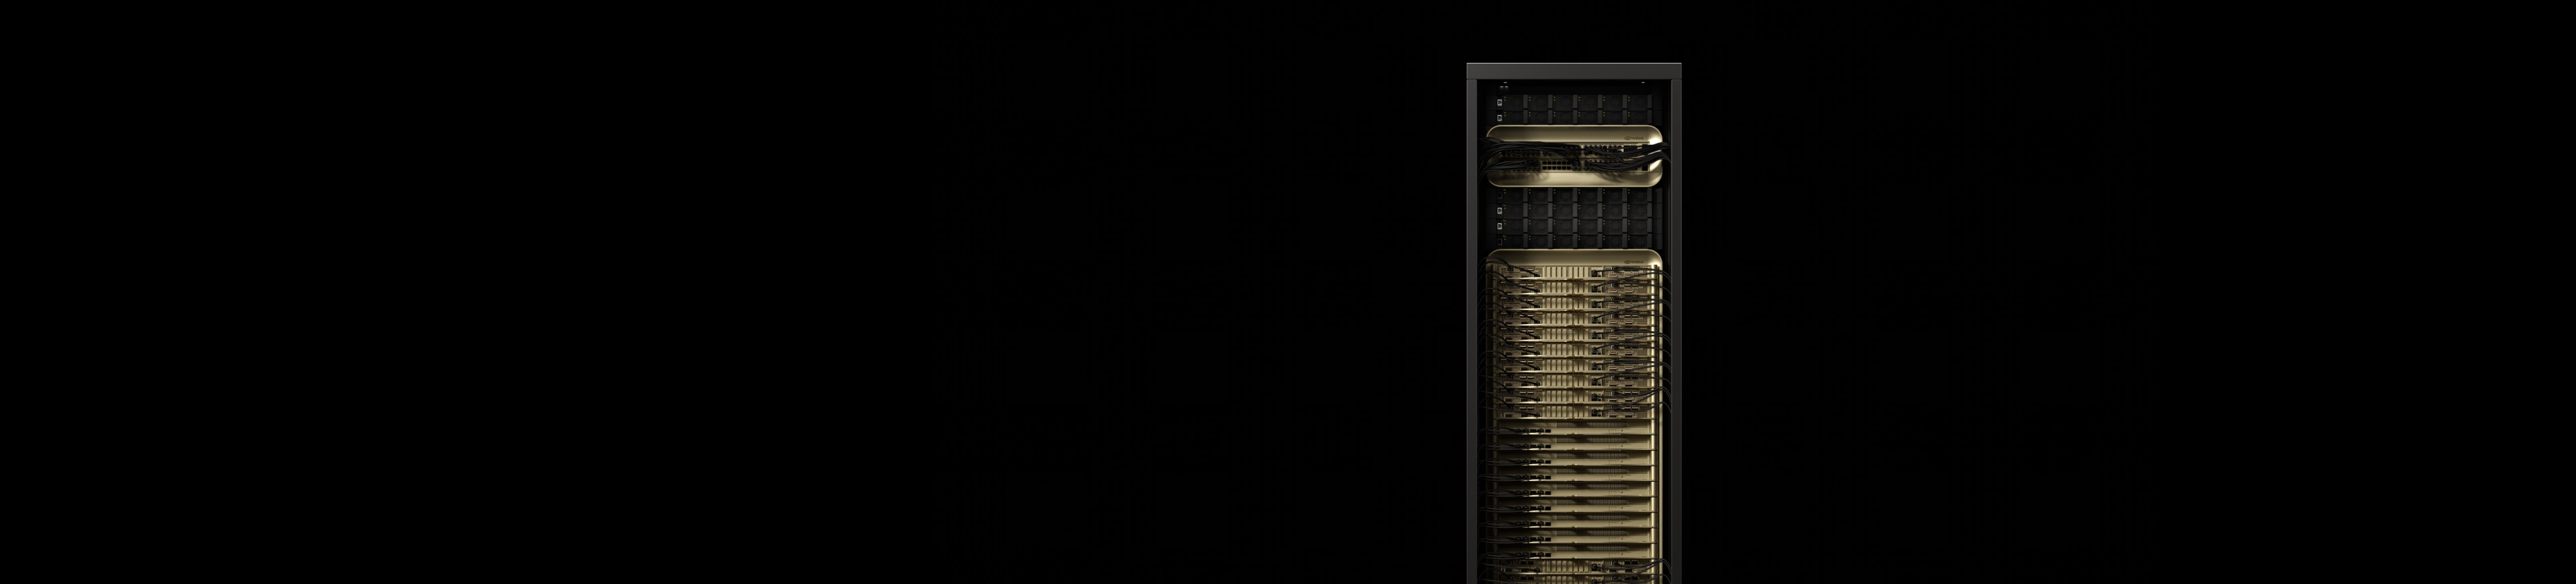
NVIDIA dichiara 30 volte più veloce l'inferenza LLM in tempo reale rispetto a H100, 4 volte nel training, 25 volte di efficienza energetica e 18 volte nell'elaborazione dati rispetto a CPU. Si tratta di benchmark del produttore: l'inferenza usa TTL di 50 ms, FTL di 5 s e 32.768 input con 1.024 output; il training è su un modello MoE da 1,8T parametri, con 4.096 HGX H100 contro 456 GB200 NVL72; l'elaborazione dati deriva da una query TPC-H Q4 confrontata con Intel Xeon 8480+. NVIDIA precisa che le prestazioni proiettate possono cambiare.
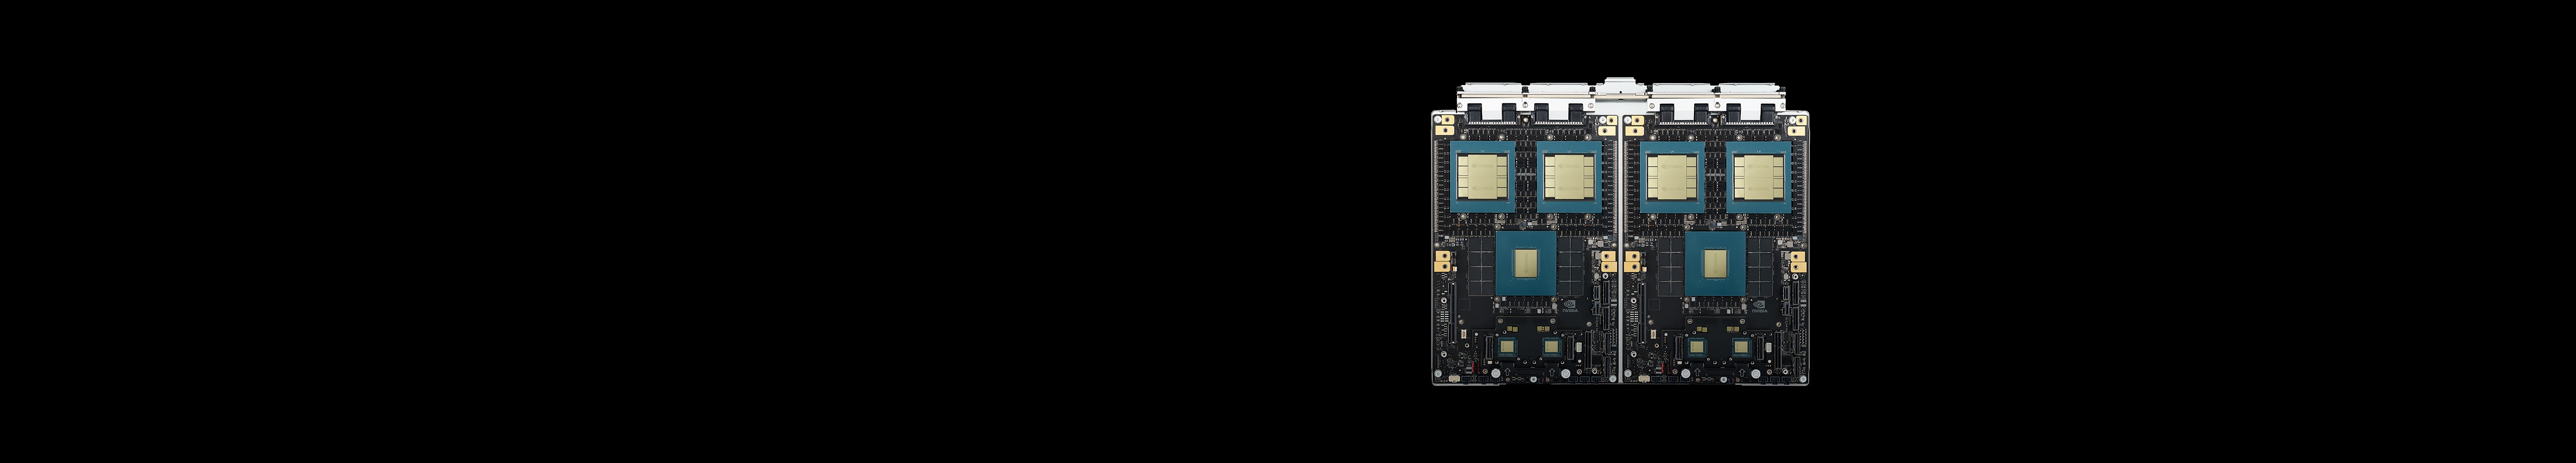
La variante GB200 NVL4 collega quattro GPU Blackwell e due CPU Grace tramite NVLink-C2C, per carichi che uniscono HPC e AI. NVIDIA dichiara fino a 2 volte di prestazioni rispetto alla generazione precedente per calcolo scientifico, addestramento AI per la scienza e inferenza.
Voce | Dettaglio |
|---|---|
Cos'è | Rack raffreddato a liquido con 36 CPU Grace e 72 GPU Blackwell |
Disponibilità | Non indicata nella fonte |
Prezzi | Non indicati nella fonte |
Contesto | Riferimento della generazione precedente; confronti con H100 e CPU |
Limiti dichiarati | Benchmark del produttore con condizioni di test specifiche; prestazioni proiettate, soggette a modifica |
Fonte: NVIDIA GB200 NVL72.
Specifiche GB200 NVL72#
Il rack GB200 NVL72 collega 36 CPU Grace e 72 GPU Blackwell in un unico sistema a raffreddamento liquido. Il GB200 Grace Blackwell Superchip, che ne è componente chiave, unisce 1 CPU Grace e 2 GPU Blackwell tramite NVLink-C2C.
Configurazione | 36 CPU Grace e 72 GPU Blackwell | 1 CPU Grace e 2 GPU Blackwell |
|---|---|---|
NVFP4 Tensor Core 2 | 1,440 | 720 PFLOPS | 40 | 20 PFLOPS |
FP8/FP6 Tensor Core 2 | 720 PFLOPS | 20 PFLOPS |
INT8 Tensor Core 2 | 720 POPS | 20 POPS |
FP16/BF16 Tensor Core 2 | 360 PFLOPS | 10 PFLOPS |
TF32 Tensor Core 2 | 180 PFLOPS | 5 PFLOPS |
FP32 | 5,760 TFLOPS | 160 TFLOPS |
FP64 / FP64 Tensor Core | 2,880 TFLOPS | 80 TFLOPS |
GPU Memory | Bandwidth | 13.4 TB HBM3E | 576 TB/s | 372 GB HBM3E | 16 TB/s |
NVLink Bandwidth | 130 TB/s | 3.6 TB/s |
CPU Core Count | 2,592 Arm® Neoverse V2 cores | 72 Arm Neoverse V2 cores |
CPU Memory | Bandwidth | 17 TB LPDDR5X | 14 TB/s | Up to 480 GB LPDDR5X | Up to 512 GB/s |
Specifiche dichiarate da NVIDIA per il rack GB200 NVL72 e per il superchip GB200: potenza di calcolo per formato numerico, memoria HBM3E e LPDDR5X, banda NVLink e numero di core CPU. Fonte: NVIDIA.
Le righe Tensor Core sono riportate in modalità sparse. Secondo la nota della fonte, il valore dense è la metà di quello sparse. La memoria LPDDR5X della CPU è indicata con 17 TB a livello di rack e fino a 480 GB per il superchip.
Neocloud e cloud sovrani: il white paper#
Cosa propone il documento#
Il white paper, realizzato da theCUBE Research e ospitato sul sito di Cisco, analizza come i neocloud e i cloud sovrani possano far crescere l'offerta di GPUaaS e di AI factory. Le esigenze individuate sono tre: prestazioni deterministiche e senza perdite su larga scala, isolamento multi-tenant con garanzie di sicurezza e rapido deploy di nuovi cluster GPU.
Secondo la tesi di Cisco, un approccio di rete AI integrato e basato su Ethernet, come quello offerto da Cisco Nexus One, riduce il rischio di deploy, semplifica le operazioni e rende le prestazioni più prevedibili.
Come leggere questo documento#
Se gestite infrastrutture GPU o state valutando un cloud sovrano, potete scaricare il white paper e verificare da soli le argomentazioni proposte.
Come leggere questi numeri#
Chi ha misurato i dati#
Quasi tutti i dati arrivano dai produttori: NVIDIA per Vera Rubin NVL72 e GB200 NVL72, Cisco per la linea N9100. Nei documenti letti non risultano misure indipendenti. I benchmark sono quindi test condotti dagli stessi produttori e, in molti casi, dichiarati come proiezioni soggette a modifiche.
Condizioni di test#
Ogni confronto dipende dal modello usato e dalla lunghezza del contesto, indicata con ISL (token in ingresso) e OSL (token in uscita). Il costo per milione di token citato da NVIDIA, per esempio, è misurato sul modello Kimi-K2-Thinking con 32K/8K. Modelli o carichi di lavoro diversi possono dare risultati diversi.
Sparse e dense, FP4 e FP8#
Una specifica può essere «sparse», cioè calcolata tenendo conto di valori nulli, oppure «dense». Nelle schede NVIDIA l'inferenza in NVFP4 è indicata come sparse, mentre training e FP8/FP6 sono dense: confrontare le due cifre direttamente non è corretto. FP4 e FP8 sono formati di calcolo a precisione diversa, quindi i loro valori non sono intercambiabili.
Piccolo glossario#
PFLOPS e ZFLOPS: unità di potenza di calcolo. Lo ZFLOPS è un ordine di grandezza molto superiore al PFLOPS.
Token: frammento di testo elaborato dal modello.
MW (megawatt): potenza elettrica assorbita dal data center.
HBM4: memoria ad alta banda montata sulle GPU Rubin.
MoE (mixture of experts): architettura in cui solo una parte del modello lavora su ogni richiesta.
Cosa significa per un'azienda#
Prima di firmare un contratto per un'infrastruttura AI, potete fare alcune verifiche concrete. Le scelte seguenti si basano su quanto dichiarato dai produttori, che restano da verificare caso per caso.
Chiedete al fornitore quali standard NVIDIA Cloud Partner (NCP) rispettano le soluzioni proposte e se la conformità è documentata con una validazione verificabile.
Verificate che il vostro data center abbia spazio, alimentazione e impianti di raffreddamento a liquido adeguati ai rack previsti, prima di valutare piattaforme come NVIDIA Vera Rubin NVL72.
Stabilite se il vero collo di bottiglia è la banda di rete o il consumo elettrico. USFP è presentato da NVIDIA e Cisco con 4x di densità di banda e circa 1,3x di efficienza energetica rispetto ai moduli a 200Gb/s per corsia, ma si tratta di dati dei produttori e i primi moduli sono ancora in programma.
Chiedete i benchmark con le condizioni di prova, cioè carico di lavoro, configurazione e versioni software, e non solo il numero di marketing. Ad esempio, la capacità di 102,4 Tbps dei switch Cisco N9100 è una dichiarazione del produttore.
Se non possedete un'infrastruttura propria, valutate l'acquisto tramite neocloud: le fonti indicano proprio i neocloud e i sovrani cloud come destinatari delle soluzioni conformi NCP.
Per scegliere il fornitore, consultate Chi fa intelligenza artificiale per le aziende in Italia.
Domande frequenti#
Che cos'è USFP e a quale velocità lavora?
USFP (Ultra-Dense Small Form Factor Pluggable) è un modulo ottico annunciato da NVIDIA e Cisco per lavorare a 400 Gb/s per corsia, con capacità fino a 12,8 Tb/s. La prima versione prevede 16 corsie full-duplex in formato OSFP-sized. Secondo i produttori, offre 4x di densità di banda e circa 1,3x di efficienza energetica rispetto ai moduli a 200 Gb/s per corsia. Sono dichiarazioni del produttore, non verificate da fonti indipendenti.
Per usare Vera Rubin serve un nuovo data center?
Le fonti non parlano di un nuovo edificio. NVIDIA descrive Vera Rubin NVL72 come costruito sul rack MGX NVL72 di terza generazione, con una transizione fluida dalle generazioni precedenti. Per USFP, i produttori dichiarano che l'adozione è possibile senza rifare l'infrastruttura del data center: anche questa è un'affermazione del produttore.
Chi produce i moduli USFP?
TE Connectivity e Amphenol lavorano con NVIDIA e Cisco a cage, connettori e moduli, e sono attesi altri partner. Le aziende prevedono inoltre una specifica aperta, da sviluppare attraverso un progetto multi-source in arrivo.
Quando arriva l'offerta Cisco con Supermicro?
Cisco annuncia che inizierà a offrire le soluzioni di calcolo Supermicro nell'ambito di Secure AI Factory with NVIDIA a partire da ottobre 2026.
Quali prestazioni dichiara NVIDIA per Vera Rubin NVL72?
NVIDIA dichiara un decimo del costo per milione di token rispetto a GB200 NVL72 per inferenza agentica, fino a 10x più token per megawatt e training di modelli MoE con un quarto delle GPU. I risultati dipendono da modelli e configurazioni specifici, sono indicati come soggetti a modifiche e in parte sono proiezioni: sono cifre del produttore.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 7/10 | NVIDIA dichiara per Vera Rubin NVL72 fino a 10x più token per megawatt rispetto a GB200 NVL72 e 72 GPU Rubin con 3.600 PFLOPS NVFP4 Inference, ma sono dati del produttore e le fonti indicano che le prestazioni sono 'subject to change' e… |
Disponibilità | 6/10 | La pagina NVIDIA indica Vera Rubin NVL72 come 'Available Now' e cita la rampa in piena produzione, mentre Cisco avvia l'offerta di sistemi Supermicro solo da ottobre 2026. |
Prezzo | 2/10 | Le fonti non indicano prezzi: la voce di contatto dice solo di contattare le vendite per ottenere il sistema. |
Trasparenza dei dati | 6/10 | La scheda tecnica riporta specifiche dettagliate e note metodologiche (sparse/dense, modello Kimi-K2 usato per i test), ma molti risultati di efficienza sono proiezioni del produttore non verificate da terzi nelle fonti. |
Apertura e licenza | 4/10 | Per USFP NVIDIA e Cisco pianificano una specifica industriale aperta tramite un progetto multi-sorgente futuro, mentre per Vera Rubin NVL72 le fonti non indicano termini di licenza. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Vera Rubin NVL72 è indicato come disponibile ora, con prestazioni dichiarate dal produttore ma prezzi non pubblicati.
Per chi deve decidere, le fonti offrono dati tecnici dettagliati e indicazioni di disponibilità, ma i miglioramenti di prestazione (fino a 10x di token per megawatt rispetto a GB200 NVL72) sono proiezioni del produttore non verificate da terzi. Il costo non è indicato e va richiesto ai venditori. Le offerte Cisco e Supermicro partono da ottobre 2026, mentre USFP resta in fase di annuncio con una specifica aperta ancora da definire.
Punti di forza
- Vera Rubin NVL72 integra 72 GPU Rubin e 36 CPU Vera in un unico rack ed è indicato da NVIDIA come disponibile ora.
- Cisco N9100 supporta sia NX-OS sia SONiC e arriva fino a 102,4 Tbps di banda.
- USFP dichiara 4x la banda e circa 1,3x l'efficienza energetica rispetto ai moduli a 200 Gb/s per corsia, con capacità fino a 12,8 Tb/s.
Limiti
- Prezzi non indicati nelle fonti; per Vera Rubin NVL72 occorre contattare le vendite.
- I dati di prestazione (10x token per MW, 35x di throughput con LPX) sono dichiarati dal produttore e soggetti a modifiche.
- Cisco e Supermicro avviano l'offerta dei sistemi server solo da ottobre 2026.
- Le fonti non indicano termini di licenza per USFP, la cui specifica aperta è solo pianificata.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
6- 1.NVIDIA — NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factoriesnvidianews.nvidia.com
Annuncio ufficiale da cui nasce l’articolo.
- 2.NVIDIA — Cisco Expands Secure AI Factory with NVIDIA for Rack-Scale Eranewsroom.cisco.com
Documento ufficiale collegato all’annuncio.
- 3.
- 4.NVIDIA — Cisco N9100 Series Switches—AI Networking Switchescisco.com
Documento ufficiale collegato all’annuncio.
- 5.
- 6.NVIDIA — Neoclouds: Accelerating GPUaaS and AI Performancecisco.com
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.