OpenAI porta i suoi modelli nella sicurezza informatica con due livelli: Blue per difendere, Red per la ricerca offensiva autorizzata. I numeri pubblicati, cosa non dicono e cosa manca ancora.
OpenAI Daybreak e GPT-5.6-Cyber: differenza tra Blue e Red, benchmark su exploit e zero-day, accesso e limiti. Cosa conta per chi difende un'azienda.
di Andrea Pirazzini
Fonte primaria
OpenAI — Expanding Daybreak as the Cyber Defense Window Narrows
openai.com
Versione audio
2 min 16 s
Perché se ne parla#
Chi difende i sistemi informatici ha sempre contato su un piccolo vantaggio: chiudere una falla prima che qualcuno la sfrutti. Secondo OpenAI quel margine si sta assottigliando, perché gli attacchi aiutati dall'intelligenza artificiale diventano più rapidi, meno costosi e più autonomi. Da qui nasce Daybreak: dare le capacità cyber più avanzate dei modelli a squadre verificate, prima che diventino un'arma comune per chi attacca.
Daybreak non è un nuovo chatbot. È un sistema composto da più pezzi: i modelli, lo strumento Codex Security, le regole su chi può entrare, la revisione fatta da persone e una rete di partner. Con l'ultima espansione del programma arriva anche un modello dedicato, GPT-5.6-Cyber.
Il programma ha due livelli, e non è una distinzione di facciata. Daybreak Blue usa i modelli generalisti più avanzati di OpenAI, tra cui GPT-5.6 Sol, per il lavoro di difesa. Daybreak Red apre le porte a GPT-5.6-Cyber, pensato per la ricerca avanzata e autorizzata, anche offensiva. Tra i due cambiano quanto il modello è disposto a fare, il livello di rischio e il tipo di organizzazione ammessa.
richieste cyber avanzate completate da GPT-5.6-Cyber
test interno, non misura la correttezza
commit esaminati secondo la pagina per le aziende
problemi di sicurezza corretti, dichiarati da OpenAI
tra crediti API e supporto per Patch the Planet
La scheda in breve#
Voce | Cosa dichiara OpenAI |
|---|---|
Cos'è | Una piattaforma di modelli, strumenti, flussi di lavoro e partner per la sicurezza |
Daybreak Blue | Modelli generalisti (tra cui GPT-5.6 Sol) per difesa, revisione del codice e gestione degli incidenti |
Daybreak Red | Aggiunge GPT-5.6-Cyber per ricerca, verifica di exploit e red teaming autorizzati |
Chi può usarlo | Solo persone e organizzazioni approvate dopo una verifica |
Dove si usa | Codex, API per le organizzazioni approvate, Amazon Bedrock (annunciato l'11 agosto 2026) |
Livello di rischio | High per le capacità cyber, sotto la soglia Critical |
Prezzi e SLA | Non pubblicati |
System card di GPT-5.6-Cyber | Promessa, non ancora uscita |
Cosa c'è dentro Daybreak, e cosa non sostituisce#
Il modo più semplice per immaginarlo: il modello è la testa che ragiona sui problemi di sicurezza, Codex Security è la cassetta degli attrezzi. Codex Security conosce il repository (l'archivio del codice di un progetto), usa strumenti, verifica le ipotesi, prepara la correzione e la presenta in una forma che una persona può controllare.
Non va confuso con gli strumenti che un reparto di sicurezza ha già. Un SIEM raccoglie e incrocia i registri degli eventi, un EDR sorveglia i singoli computer, un SOAR automatizza le risposte, gli scanner SAST/DAST analizzano il codice o l'applicazione mentre gira. Daybreak non prende il posto di nessuno di questi, né delle procedure di gestione degli incidenti. Si affianca, come uno strato di agenti che esaminano, controllano e propongono cosa fare. Se il concetto di agente vi è nuovo, qui spiego cosa sono gli agenti AI.
I pezzi documentati sono cinque:
Componente | A cosa serve | Dove si usa |
|---|---|---|
Codex Security plugin | Una prima prova, la revisione di un ramo di sviluppo, l'esplorazione di un progetto | Codex |
Codex Security Cloud | Analisi gestite e continue sui repository GitHub collegati | Cloud |
Codex Security CLI | Analisi in locale e dentro la catena di rilascio (CI/CD) | Terminale e pipeline |
Daybreak Blue | Protezione, revisione sicura del codice, risposta agli incidenti, gestione delle vulnerabilità | Accesso su approvazione |
Daybreak Red | Penetration test, red teaming e verifica di exploit autorizzati; ricerca avanzata | Accesso su approvazione, con controlli più severi |
Sulla pagina rivolta alle aziende OpenAI rivendica numeri importanti: più di 30 milioni di commit esaminati (un commit è una singola modifica salvata nel codice), oltre 30.000 basi di codice e più di 500.000 problemi corretti. Nelle pagine consultate, però, manca un metodo pubblico per ricostruire quei conteggi: su quale periodo, con quali criteri, eliminando o meno i doppioni.
Blue e Red: due porte diverse#
Blue, il punto di partenza#
Blue copre il lavoro quotidiano di chi difende: scoprire le vulnerabilità, confermarle e correggerle, fare threat modeling (chiedersi chi potrebbe attaccare cosa, e in che modo), analizzare malware, indagare su un'anomalia, reagire a un incidente.
Rispetto alle API normali la differenza è questa: con l'accesso Blue spariscono i filtri di sistema che OpenAI applica di solito alle domande di sicurezza informatica. Resta però il giudizio del modello, che continua a rifiutare le richieste più ambigue, quelle che servono tanto a proteggere quanto ad attaccare (in gergo, dual-use).
Red, per chi attacca su commissione#
Red aggiunge GPT-5.6-Cyber. È costruito su GPT-5.6 Sol e addestrato con due obiettivi: dire di no meno spesso alle attività rischiose quando sono autorizzate, e rendere meglio in compiti come la ricerca di vulnerabilità, la verifica degli exploit (il codice che sfrutta una falla) e il red teaming, cioè l'attacco simulato che un'azienda commissiona contro sé stessa.
Meno rifiuti non vuol dire porte aperte. Entrambi i livelli sono riservati a chi supera un'approvazione, e l'approvazione comporta parecchi obblighi: identità verificata, account protetto, monitoraggio, limiti d'uso e dichiarazioni legali.
Da dove si entra#
Il modulo per le aziende indica tre strade: Codex con l'accesso "Sign in with ChatGPT", Codex tramite API, oppure l'inserimento del modello in un'applicazione propria, sempre via API.
L'11 agosto 2026 OpenAI ha annunciato anche l'arrivo su Amazon Bedrock. Dopo l'approvazione, Blue e Red si usano dalla console di Bedrock oppure con la Responses API sull'endpoint bedrock-mantle. Non è però un servizio che si attiva da soli con un clic: anche da lì bisogna prima superare la verifica di Daybreak Access.
Quale livello per quale lavoro#
Attività | Blue | Red | Come leggerla |
|---|---|---|---|
Revisione sicura del codice e correzioni | Sì, è l'uso principale | Possibile | Blue è la scelta predefinita |
Rilevare e gestire gli incidenti | Sì | Possibile | Va collegato ai dati e agli strumenti del SOC |
Threat modeling | Sì | Possibile | Aiuta l'analista, non produce da solo un inventario completo |
Verifica avanzata di exploit | Frenata dai rifiuti del modello | Sì, se il lavoro è autorizzato | Servono un ambiente isolato e un perimetro scritto |
Red team su sistemi reali | Può rifiutarsi | Accesso qualificato | Solo con regole d'ingaggio e autorizzazione formale |
Il SOC è il centro operativo di sicurezza, la squadra che sorveglia i sistemi. In sintesi: per quasi tutto il lavoro difensivo basta Blue, Red serve quando il mestiere è attaccare con un permesso scritto.
Il 95% che fa notizia, e cosa misura davvero#
Per capire di quanto calano i rifiuti, OpenAI ha costruito un test interno, l'Advanced Cybersecurity Completion Rate. Dentro ci sono scenari delicati: mettere in fila più exploit in una catena, aggirare un sistema di autenticazione, ottenere permessi più alti di quelli concessi (la cosiddetta privilege escalation).
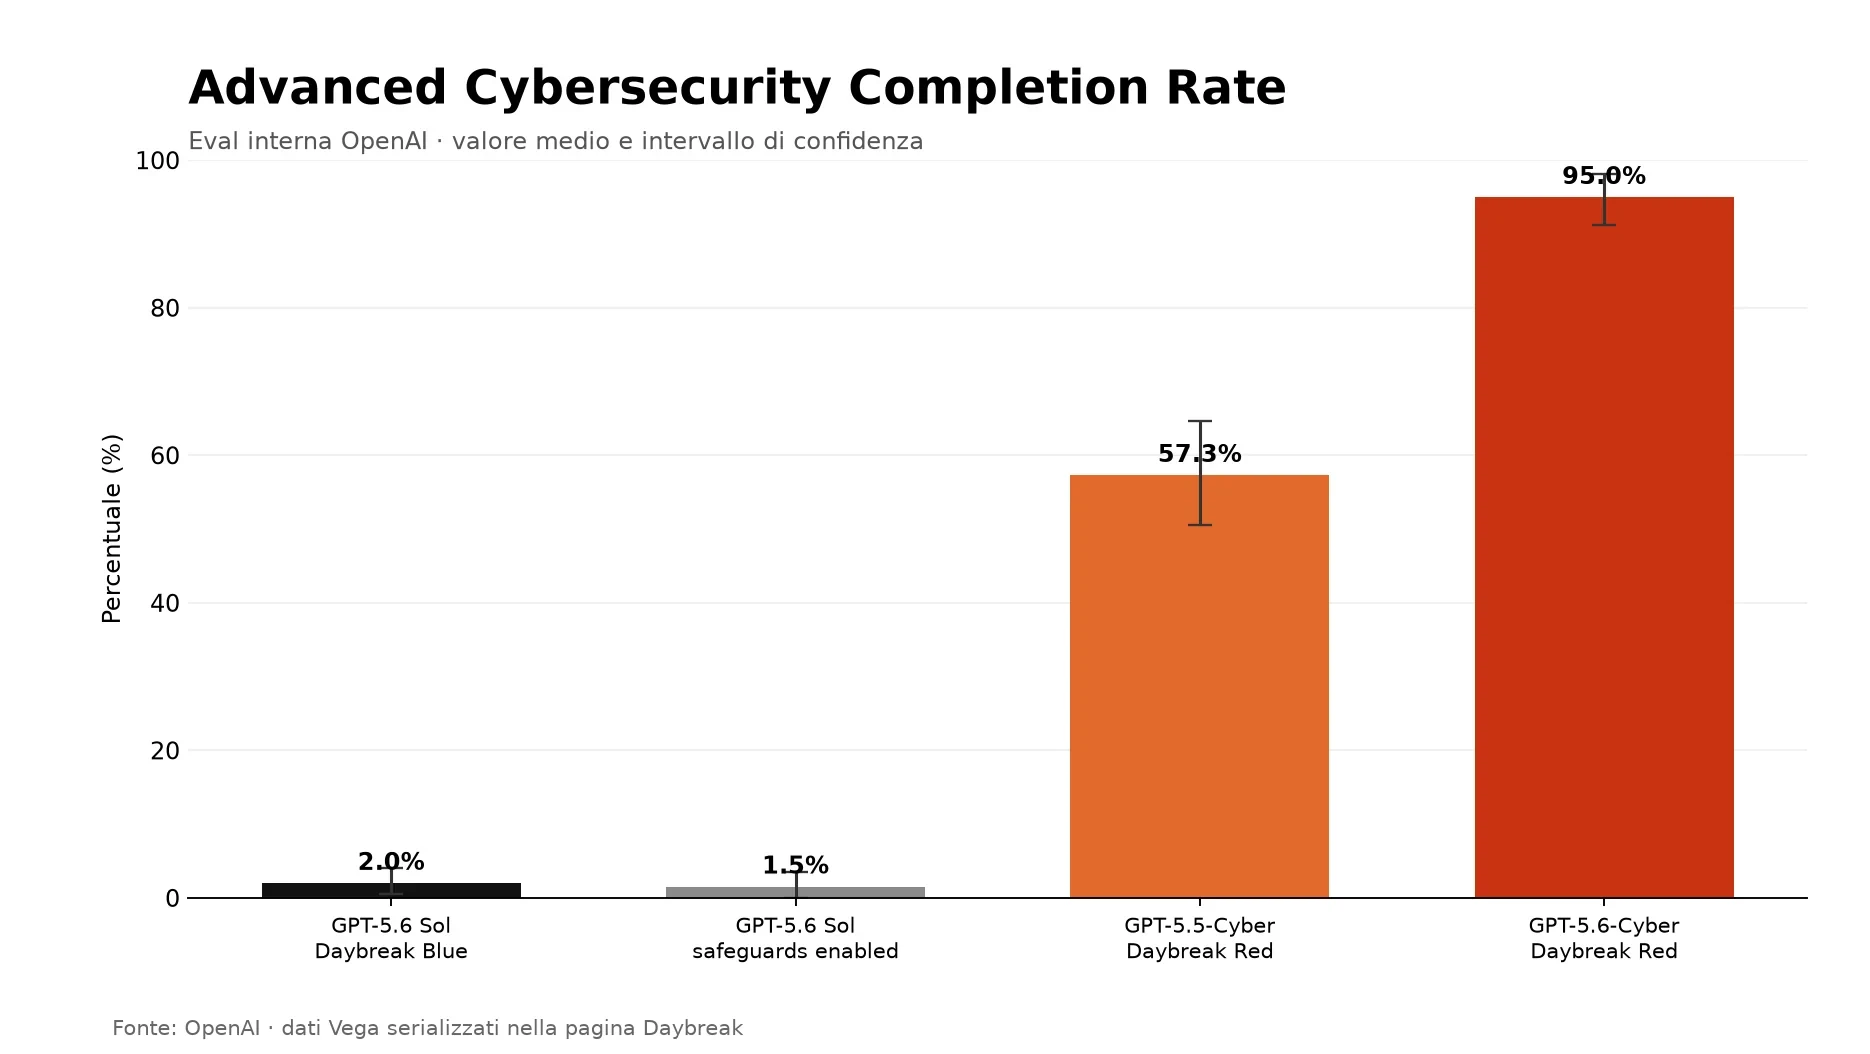
Il punto da non perdere: questo numero dice quanto il modello è disposto a portare a termine la richiesta. Non dice se la risposta è giusta, se è sicura o se funzionerebbe in un'operazione vera. Ed è una prova preparata dal produttore.
Il salto dal 57,3% al 95% è ciò che rende GPT-5.6-Cyber prezioso per un ricercatore autorizzato, ed è anche il motivo per cui OpenAI deve scegliere con cura chi lo usa e stringere i controlli.
I benchmark tecnici: Red non vince sempre#
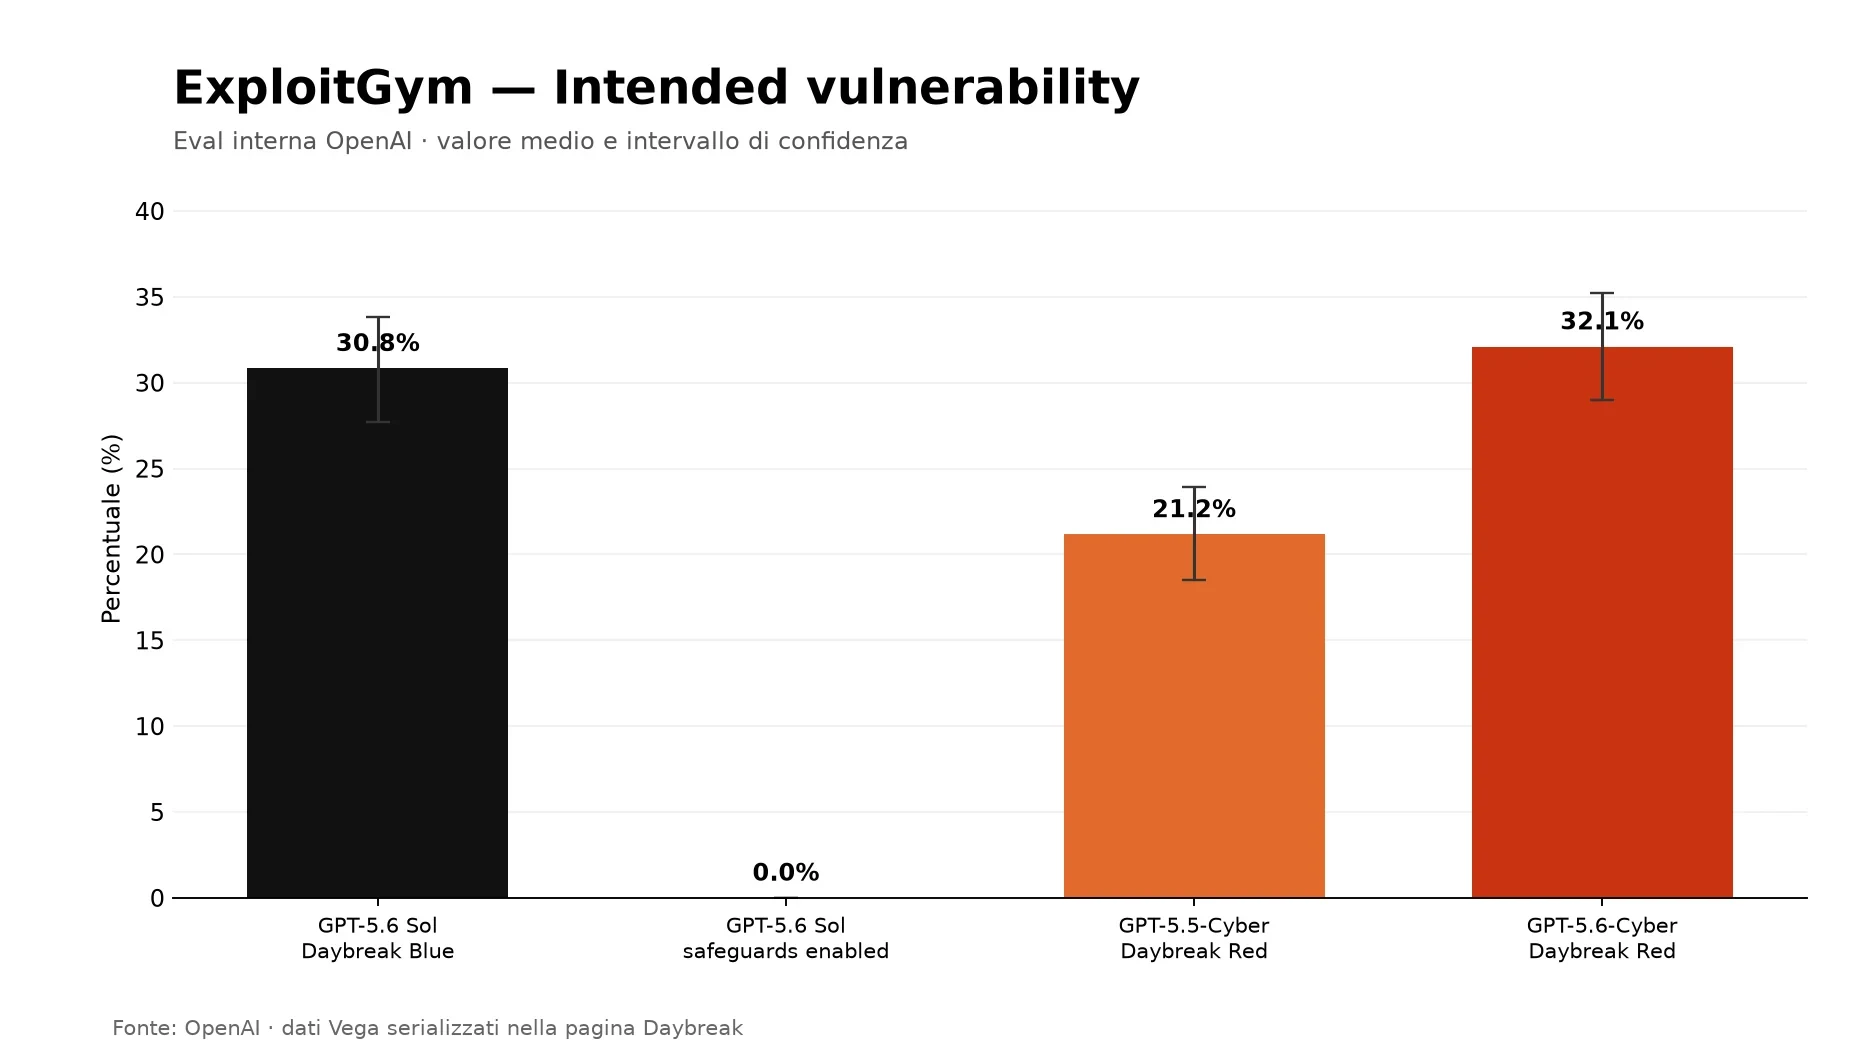
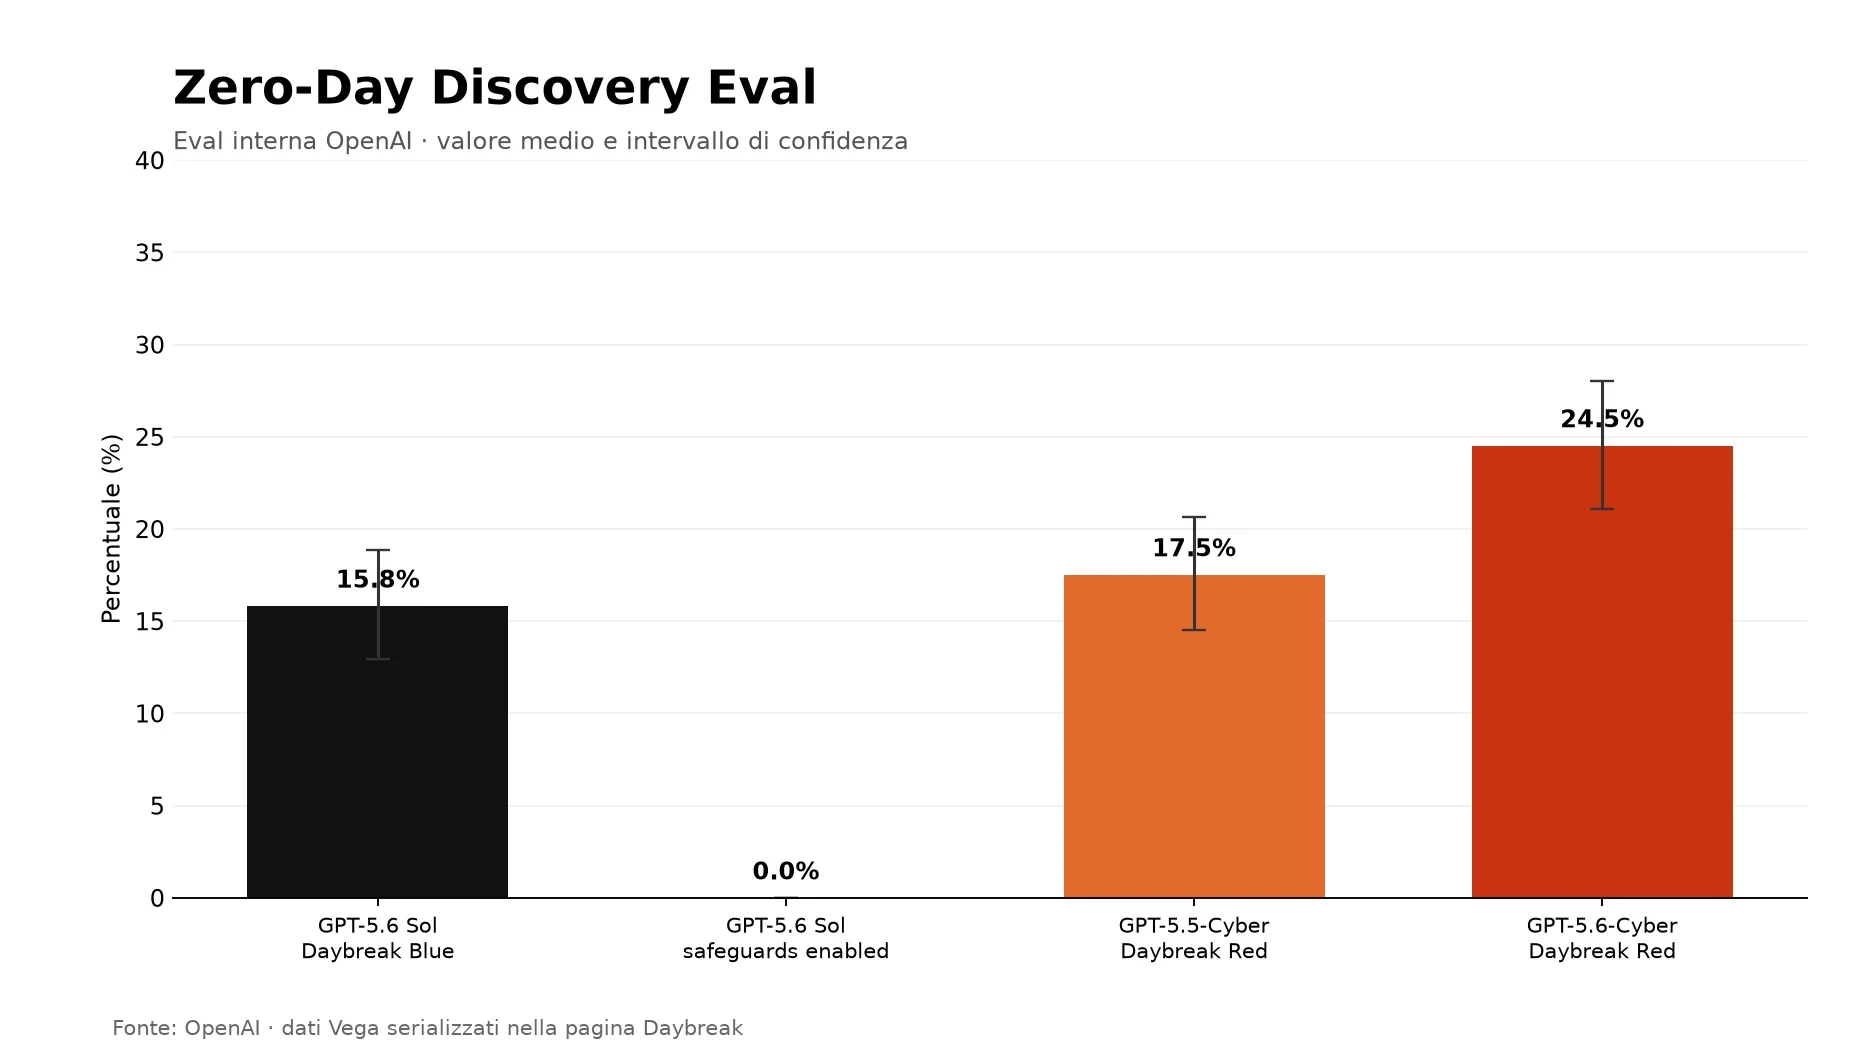
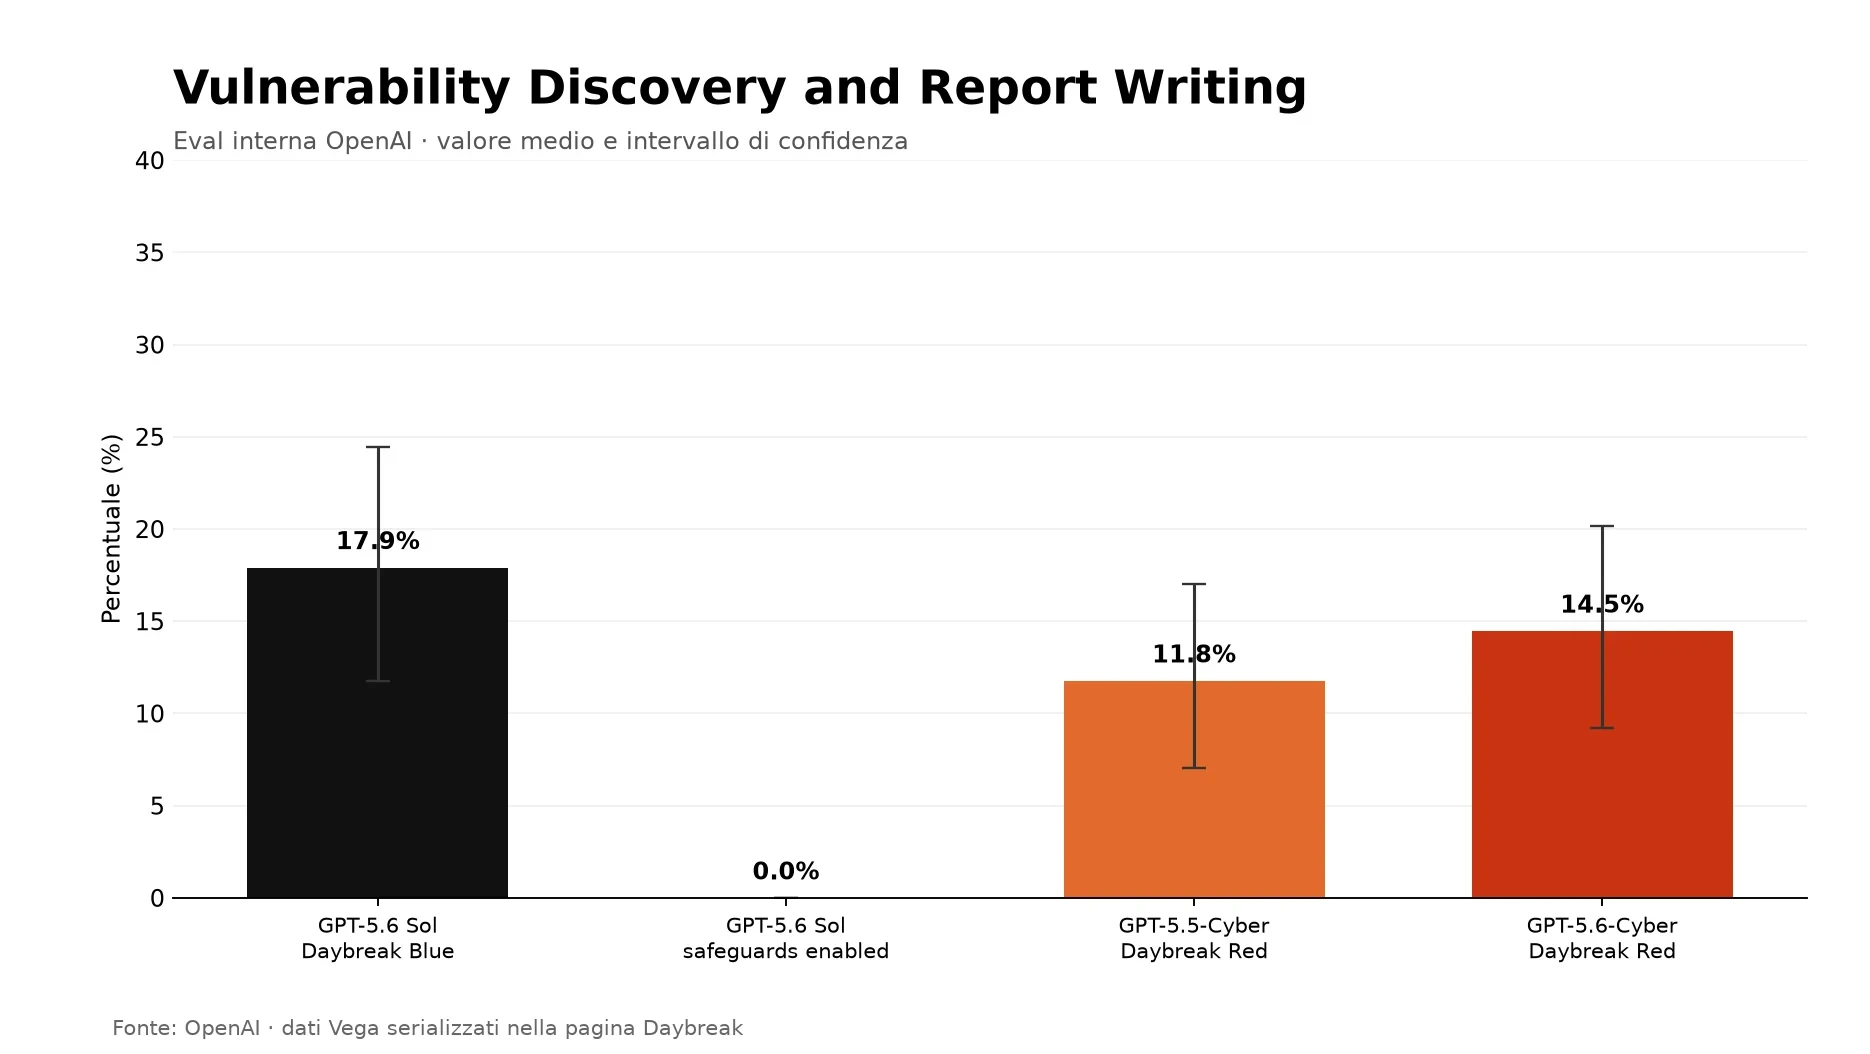
Chi si aspetta che il modello specializzato stravinca ovunque resterà sorpreso. Nei grafici di OpenAI, GPT-5.6-Cyber batte GPT-5.6 Sol in due prove su quattro, e in una terza lo raggiunge solo quando gli si concede più tempo.
Blue contro Red nei test di OpenAI
Punteggi nelle valutazioni interne, in percentuale
- GPT-5.6-Cyber (Red)
- GPT-5.6 Sol (Blue)
- GPT-5.5-Cyber
Fonte: dichiarato da OpenAI, agosto 2026
Tre avvertenze prima di leggere i numeri:
tutte le percentuali vengono dai grafici pubblicati sulla pagina di OpenAI, che riportano anche gli intervalli di confidenza (la fascia di incertezza attorno a ogni media);
OpenAI ha usato il livello di ragionamento più alto disponibile al pubblico, e avverte che GPT-5.6-Cyber tende a consumare più token;
ExploitGym ed ExploitBench girano su versioni interne dei test, in ambienti isolati e sorvegliati: nessuno li ha ancora ripetuti in modo indipendente.
ExploitGym: sfruttare la falla prevista#
Il modello deve sfruttare una vulnerabilità messa apposta nel sistema di prova. GPT-5.6-Cyber arriva al 32,1%, appena sopra Sol (30,8%); la generazione precedente, GPT-5.5-Cyber, resta al 21,2%. Qui la specializzazione sposta poco.
Zero-Day Discovery: trovare ciò che nessuno conosce#
Qui Red si stacca di più: 24,5% per GPT-5.6-Cyber, 17,5% per GPT-5.5-Cyber, 15,8% per Sol, su un set interno costruito con progetti open source. Anche il migliore resta lontano da una copertura completa.
Scoperta e report: le posizioni si invertono#
Se il modello deve trovare il problema e scriverne il rapporto, in testa torna Sol con il 17,9%, davanti a GPT-5.6-Cyber (14,5%) e GPT-5.5-Cyber (11,8%). Più specializzato non vuol dire sempre migliore.
ExploitBench: quanto conta il tempo concesso#
ExploitBench misura quanta parte delle capacità richieste il modello riesce a coprire, con un tetto di 300 oppure di 600 turni, cioè di passaggi dell'agente. A 300 turni Sol è davanti con il 76,5%; GPT-5.6-Cyber si ferma al 73,0%, addirittura dietro a GPT-5.5-Cyber (73,9%). A 600 turni i due GPT-5.6 si ritrovano attorno all'84,5%, mentre GPT-5.5-Cyber sale all'81,4%.
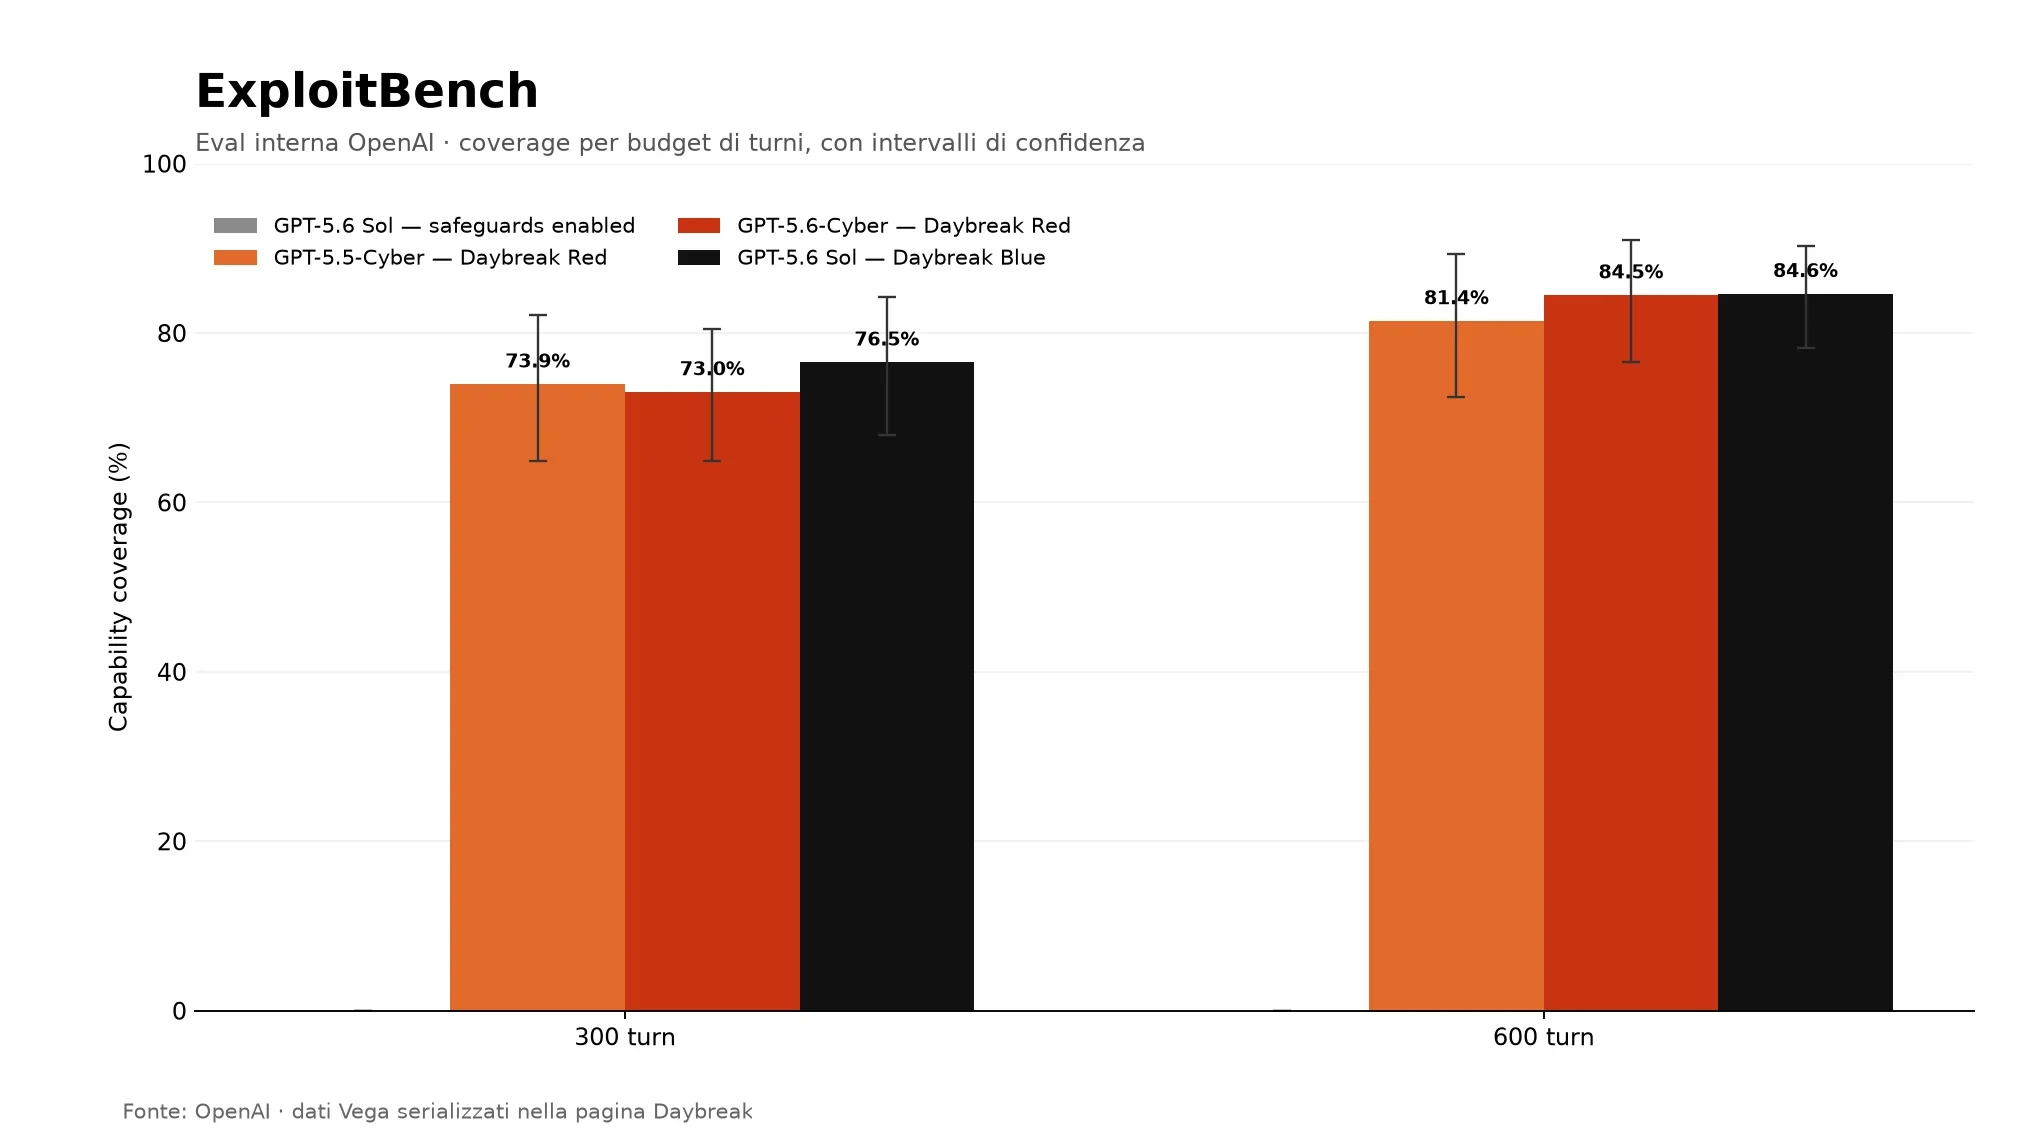
Nei compiti lunghi, insomma, il margine concesso a un agente può pesare quanto la specializzazione del modello.
Un riferimento esterno: la prova dello UK AISI#
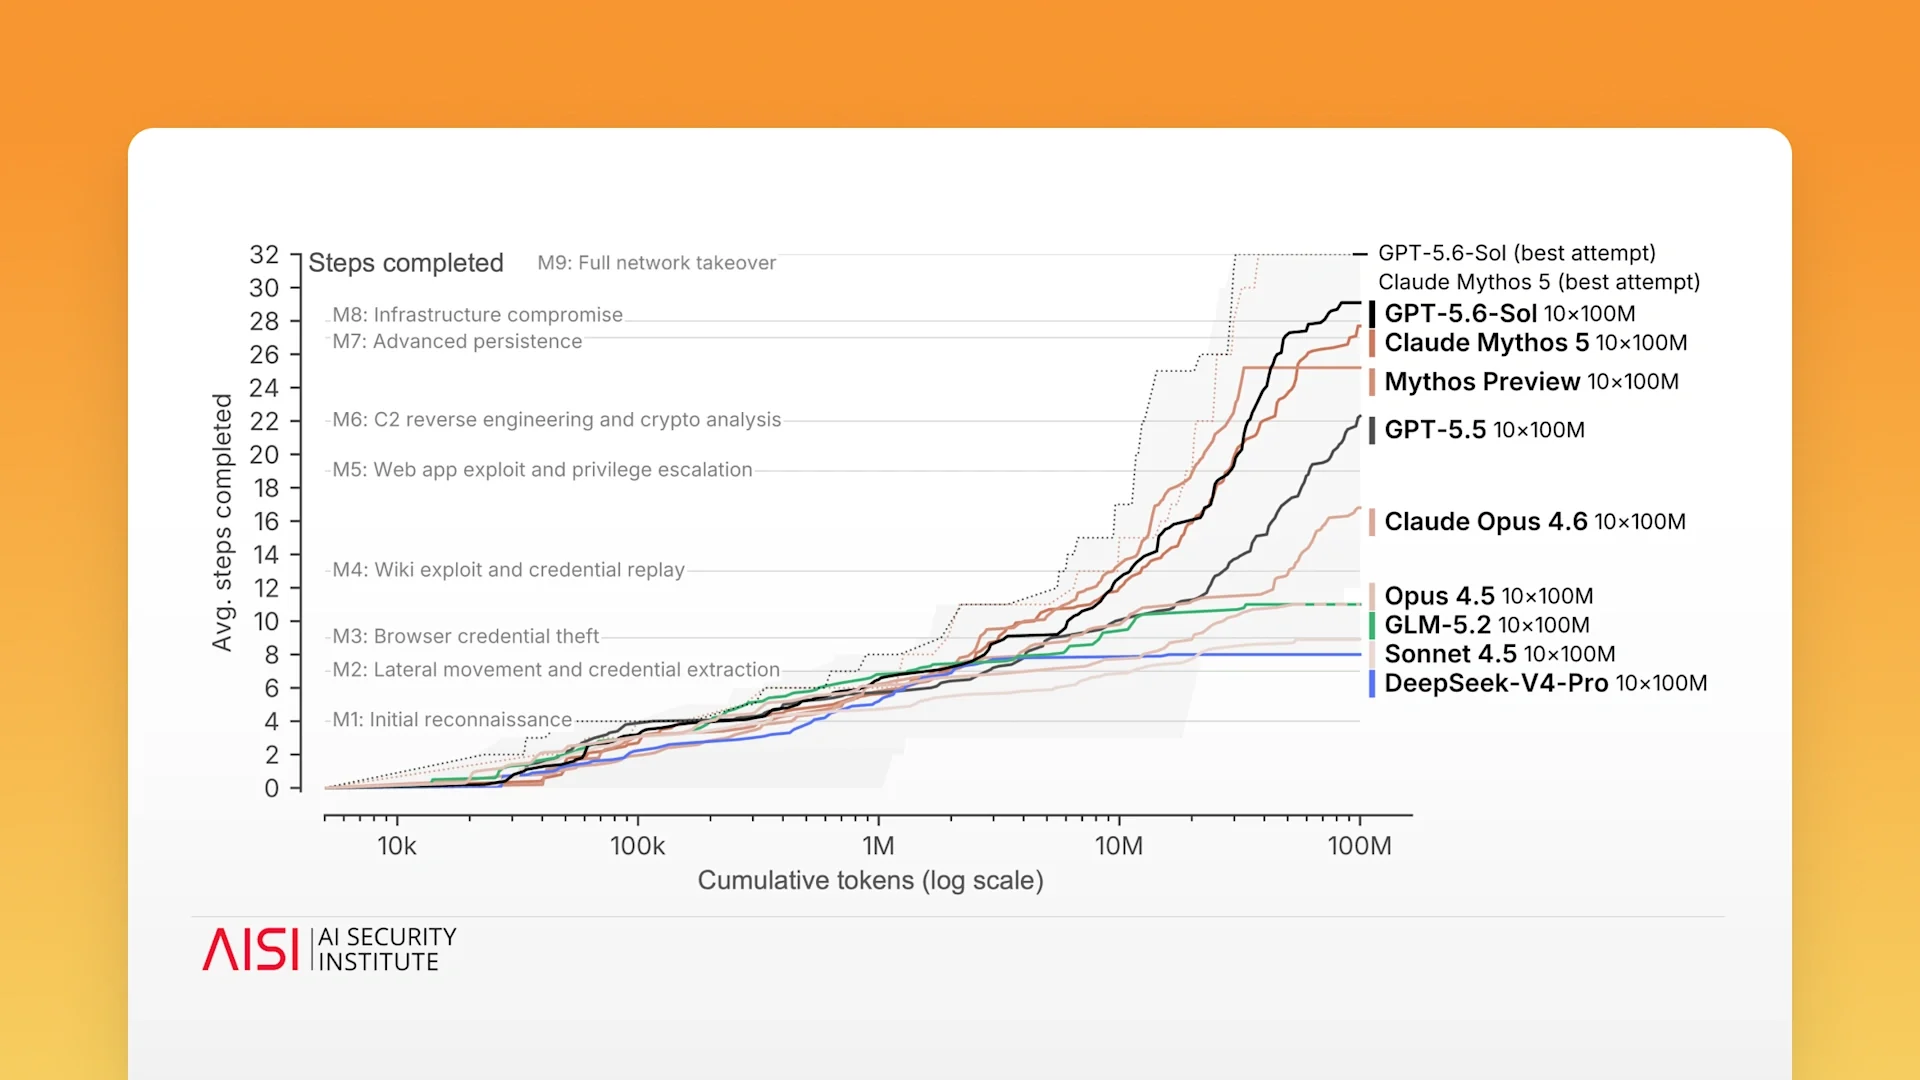
Tra tanti test interni, uno arriva da fuori. La pagina di Daybreak riporta un grafico dello UK AI Security Institute, l'ente britannico che valuta la sicurezza dei modelli. Nella simulazione di attacco chiamata "The Last Ones", lunga 32 passaggi, GPT-5.6 Sol è arrivato fino in fondo in 7 tentativi su dieci; GPT-5.5 ci era riuscito solo 2 volte su dieci.
The Last Ones, la prova dello UK AISI
Tentativi portati fino in fondo, su dieci, in una simulazione di attacco da 32 passaggi
Fonte: UK AI Security Institute, grafico riportato da OpenAI, agosto 2026
Due cautele. La prova riguarda Sol, non GPT-5.6-Cyber. E il risultato dipende molto da quanti token si lasciano spendere al modello: il grafico mostra quanti passaggi vengono completati in media man mano che quel budget cresce, su una scala logaritmica.
Il vero collo di bottiglia: dalla segnalazione alla patch#
Trovare più problemi non rende nessuno più sicuro: una segnalazione non verificata allunga solo la lista degli arretrati. OpenAI insiste invece sul ciclo intero, fatto di sette passi:
capire da quali punti il sistema si può attaccare;
riprodurre il problema in un ambiente separato;
stabilire se la falla è davvero raggiungibile e quanto danno può fare;
raccogliere le prove;
scrivere una correzione mirata;
far girare i test;
consegnare una modifica che una persona può esaminare e approvare.
Per chi vuole provarlo, cambia il modo di giudicare il pilota. Contare le vulnerabilità trovate premia i sistemi più rumorosi; conviene misurare il percorso completo:
quante segnalazioni risultano confermate;
quanti sono i falsi allarmi;
quanto tempo passa prima della correzione;
quanti test vengono superati e quante regressioni si introducono;
quante volte deve intervenire una persona;
quante patch vengono accettate davvero.
Cosa dice di aver trovato: il caso V8#
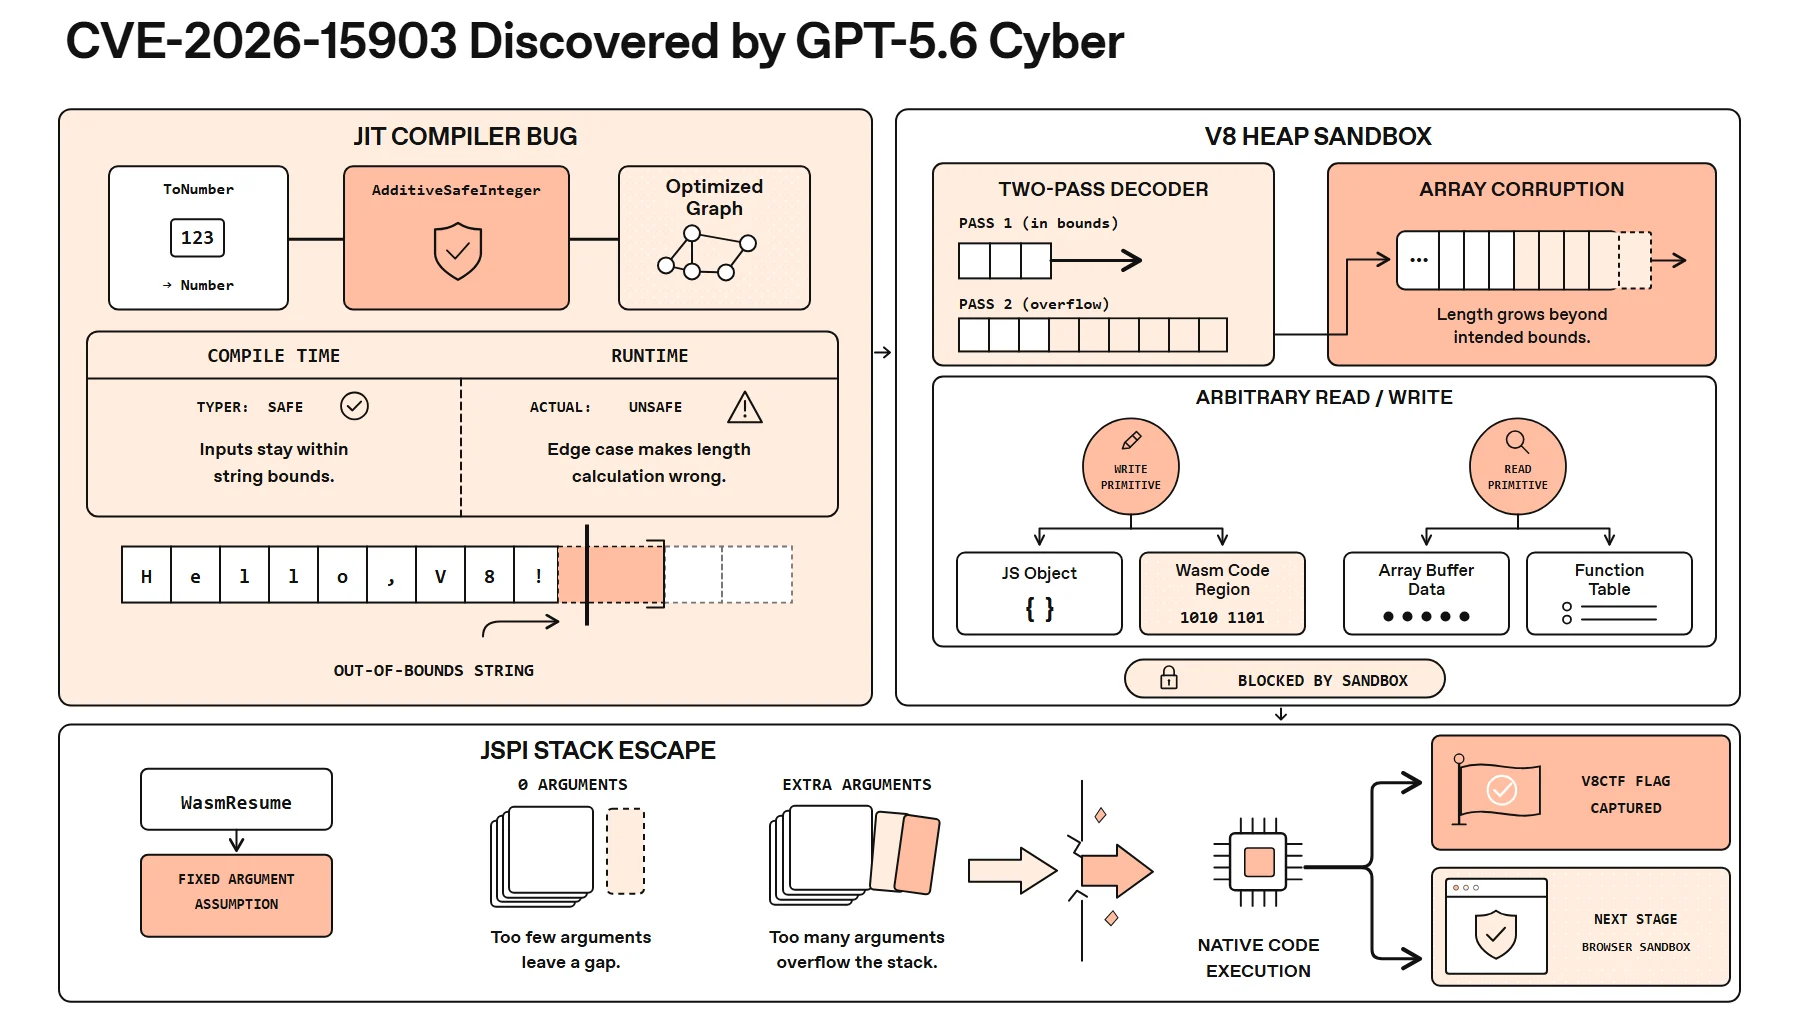
L'esempio più concreto riguarda V8, il motore JavaScript di Google Chrome. OpenAI racconta di aver usato GPT-5.6-Cyber per scoprire due vulnerabilità fino ad allora ignote che, combinate, permettevano di corrompere la memoria e uscire dalla heap sandbox, lo spazio protetto in cui V8 tiene i propri dati. I ricercatori hanno confermato i risultati e avviato con Google una divulgazione coordinata: prima si avvisa chi deve correggere, poi si rende pubblico. La prima falla è stata chiusa ed è registrata come CVE-2026-15903; la seconda, nella pagina del 10 agosto, era ancora in fase di divulgazione.
L'annuncio elenca altri risultati: almeno cinque vulnerabilità in un sistema operativo per dispositivi mobili, tre critiche in un database, oltre 400 casi di privilege escalation dentro un kernel. I prodotti non vengono nominati, perché correzioni e divulgazione erano ancora in corso.
Patch the Planet: le correzioni passano dai maintainer#
Il programma più interessante è Patch the Planet, costruito con Trail of Bits, società specializzata in sicurezza. Il modello lavora sui progetti open source, ma le correzioni passano per la revisione di persone e arrivano ai maintainer, cioè a chi cura quei progetti e decide cosa entra nel codice ufficiale ("upstream").
La pagina di Daybreak parla di 17 milioni di dollari tra crediti per le API e supporto diretto. Per i risultati circolano due fotografie scattate in momenti diversi: quella della pagina OpenAI e quella, aggiornata a parte, della pagina di Trail of Bits.
Patch the Planet in due fotografie
Problemi trovati, patch scritte e patch accettate upstream
- Pagina OpenAI
- Pagina Trail of Bits
Fonte: pagina Daybreak di OpenAI e pagina Patch the Planet di Trail of Bits, agosto 2026
Anche le basi di codice sotto revisione passano da 41 a 50. Non è un errore: sono contatori in movimento, letti in giorni diversi. Il valore sta nel metodo: una settimana di revisione dedicata, patch già pronte e l'ultima parola ai maintainer.
Accanto a Trail of Bits, OpenAI mostra una griglia di altri partner: l'obiettivo dichiarato è portare queste capacità dentro i servizi e gli strumenti che chi difende usa già.
Accesso e regole per usarlo senza farsi male#
OpenAI consiglia di cominciare da Blue. Red è pensato per i team il cui lavoro autorizzato comprende lo sviluppo di exploit, la ricerca avanzata o il red teaming. Per gli account individuali di Daybreak, dal 1° settembre 2026 diventano obbligatorie le chiavi di sicurezza fisiche, le chiavette da inserire per entrare nell'account.
Le raccomandazioni operative sono cinque:
Isolamento: far lavorare il modello in una sandbox, senza accesso ai sistemi di produzione delicati né a internet aperto, e controllare spesso che i confini reggano.
Revisione automatica: preferire la modalità che esamina le azioni con permessi elevati e può fermare quelle distruttive.
Perimetro: mettere per iscritto quali sistemi e quali azioni sono permessi, e assegnare profili di autorizzazione ridotti.
Osservabilità: tenere traccia di chiamate agli strumenti, traffico in uscita, modifiche e risultati; più sale il rischio, più serve una persona che sorveglia.
Regole aziendali: le organizzazioni possono adattare le regole di revisione con la configurazione enterprise.
Nel Preparedness Framework, lo schema con cui OpenAI classifica i rischi dei propri modelli, GPT-5.6 Sol e GPT-5.6-Cyber stanno al livello High per le capacità informatiche, sotto la soglia Critical. La system card di GPT-5.6-Cyber, il documento tecnico che descrive test e protezioni, è stata promessa per un secondo momento: al momento dell'annuncio non era disponibile.
Cosa non sappiamo ancora#
Prezzi: nessun listino pubblico, per nessuno dei due livelli e nemmeno per il modello Cyber.
SLA e assistenza: nessun impegno scritto sulla velocità delle risposte, sulla continuità del servizio o su livelli garantiti.
API: l'accesso è documentato per le organizzazioni approvate e su Bedrock, ma per GPT-5.6-Cyber non risultano endpoint OpenAI pubblici, limiti di chiamata dedicati o un'attivazione self-service.
Regioni e capacità: nessun vincolo geografico, quota o limite pubblico dedicato a Daybreak.
System card: annunciata ma non pubblicata, quindi mancano le valutazioni aggiuntive e i dettagli sulle protezioni promessi.
Privacy: le pagine non chiariscono per quanto tempo si conservano i dati, se vengono usati per addestrare i modelli o se vale la Zero Data Retention. Sono punti da verificare nel contratto e nella configurazione.
Cosa significa per un'azienda#
Daybreak è pensato per chi fa sicurezza di mestiere: team strutturati, società di penetration test, ricercatori. Una piccola impresa senza un reparto dedicato ne sentirà parlare più probabilmente dal proprio fornitore di sicurezza. Per chi sviluppa software in casa, il pezzo più vicino è quello difensivo: Codex Security e Blue per rivedere il codice prima del rilascio, con una persona che approva ogni modifica e niente accesso alla produzione senza permessi scritti.
Il mio parere#
Daybreak affronta il problema giusto. La sfida non è moltiplicare le segnalazioni, ma chiudere il cerchio fino alla correzione e alla divulgazione. La separazione tra Blue e Red, i controlli sull'accesso e il lavoro con Trail of Bits raccontano un progetto pensato con più cura di un "modello per hacker" messo in vetrina. Il mio giudizio è quindi positivo, ma provvisorio.
Non nasce infatti da una prova sul campo. Le prove più importanti le ha fatte OpenAI in casa, il modello Cyber non vince dappertutto e mancano ancora system card, prezzi, SLA e condizioni commerciali. Per un'azienda la scelta non può partire da una classifica: serve un pilota autorizzato, isolato e misurato contro il modo in cui si lavora oggi. Se state valutando strumenti di questo tipo, posso aiutarvi a definire come impostare la prova e cosa misurare prima di cominciare.
Domande frequenti#
Daybreak è già disponibile?
Sì, ma non per chiunque. Blue e Red sono aperti solo a persone e organizzazioni approvate. Codex Security copre i flussi difensivi più comuni, mentre l'accesso avanzato richiede una candidatura e una verifica.
Che differenza c'è tra Blue e Red?
Blue usa i modelli generalisti di OpenAI, come GPT-5.6 Sol, per difesa, analisi e correzione. Red aggiunge modelli addestrati apposta, come GPT-5.6-Cyber, per ricerca offensiva, verifica di exploit e red teaming autorizzati, con controlli più severi.
Daybreak sostituisce SIEM, EDR o SOAR?
No. OpenAI lo presenta come uno strato di agenti da inserire nei flussi esistenti. Raccolta dei dati, rilevamento, contenimento, gestione dei casi e approvazioni restano compito degli strumenti e del team.
Quanto costa?
Non c'è un listino pubblico: né Blue, né Red, né GPT-5.6-Cyber hanno un prezzo dichiarato. Il costo va chiesto al commerciale e valutato insieme a quote, assistenza e condizioni contrattuali.
Si può usare sui sistemi di produzione?
OpenAI raccomanda sandbox, isolamento, revisione automatica delle azioni, perimetro esplicito, permessi ridotti e supervisione. Per toccare la produzione servono in più un permesso formale, regole d'ingaggio scritte e protezioni tecniche all'altezza.
Il mio verdetto
Daybreak propone un percorso credibile dalla segnalazione alla correzione verificata, con due livelli d'accesso ben distinti. Il giudizio resta provvisorio: si basa su fonti e test del produttore, e mancano ancora prezzi, SLA, system card e valutazioni indipendenti.
Cosa mi convince
- Confine netto tra il lavoro difensivo di Blue e la ricerca avanzata di Red
- Modello, conoscenza del codice, verifica, test e correzione nello stesso flusso
- Controlli sull'accesso: verifica, monitoraggio, chiavi fisiche e revisione delle azioni più delicate
- Risultati dichiarati su software reale come V8, con divulgazione coordinata
- Patch the Planet porta le correzioni ai maintainer dopo una revisione esperta
Cosa non mi convince
- I benchmark principali sono interni e nessuno li ha replicati
- GPT-5.6-Cyber non batte GPT-5.6 Sol in tutte le prove
- Prezzi, SLA, quote e regioni non sono pubblici
- La system card del modello Cyber è promessa ma non ancora uscita
- Meno rifiuti vuol dire più rischio di doppio uso: servono regole solide
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
9- 1.OpenAI — Expanding Daybreak as the Cyber Defense Window Narrowsopenai.com
annuncio di GPT-5.6-Cyber, con i grafici dei test e quello dello UK AI Security Institute
- 2.OpenAI — Daybreakopenai.com
- 3.
- 4.
- 5.OpenAI — configurazione di Codex Security Clouddevelopers.openai.com
- 6.OpenAI — revisione automatica delle azioni (Auto-review)learn.chatgpt.com
- 7.OpenAI — permessilearn.chatgpt.com
- 8.OpenAI — configurazione gestita per le aziendedevelopers.openai.com
- 9.Trail of Bits — Patch the Planettrailofbits.com
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.