Settembre 2026
Due nomi, un solo modello. Per Anthropic Claude Fable 5.1 è il più avanzato al mondo per programmare e per il lavoro d’ufficio ad alto contenuto di conoscenza, oltre che un primo assaggio di quello che questi sistemi daranno alla ricerca scientifica.
Anthropic ha presentato due nomi nuovi, Claude Fable 5.1 e Claude Mythos 5.1, ma dietro c’è un unico modello: cambia solo il livello di protezione. Fable 5.1 lo può usare chiunque; Mythos 5.1 è riservato a chi passa dai programmi di accesso verificato, pensati per chi fa difesa informatica o lavora nelle scienze della vita.
Per chi paga le fatture, però, la notizia sta altrove. Fable 5.1 porta tre novità chieste da tempo dai clienti: spendere meno, non lasciare i propri dati sui server di Anthropic e avere filtri che blocchino meno lavoro legittimo.
Il prezzo. Il listino base non cambia, ma crolla il costo delle letture dalla cache: quando si manda al modello un testo che ha già elaborato di recente (istruzioni di sistema, un manuale, il codice di un progetto), quella parte viene riletta da una memoria temporanea e fatturata a parte. Secondo Anthropic, soprattutto grazie a questo taglio, nell’uso di tutti i giorni Fable 5.1 costa circa il 25% in meno di Fable 5, ovunque si paghi a token; nel lavoro molto agentico il risparmio arriva spesso intorno al 45%.
I dati. Molte aziende chiedevano la zero data retention, cioè la garanzia che il fornitore non conservi nulla delle conversazioni; senza dati, però, è difficile accorgersi degli abusi. La risposta si chiama Enterprise Frontier Safeguards (EFS): i dati stanno su un cloud gestito dal cliente e il controllo sugli abusi avviene comunque, con la stessa riservatezza della zero data retention. EFS arriverà a tappe dall’autunno; nel frattempo chi ne ha i requisiti può già usare Fable 5.1 con zero data retention.
I filtri. Sono stati ricalibrati per ridurre i falsi positivi, cioè i blocchi su richieste innocue. In cybersicurezza calano del 60%, in parte perché adesso Fable 5.1 è autorizzato a cercare vulnerabilità nel software, senza però arrivare a scrivere exploit. In biologia, insieme al governo degli Stati Uniti, è nato un programma per dare agli scienziati accesso alle capacità avanzate di Mythos 5.1; le iscrizioni erano annunciate come imminenti.
Prestazioni: il salto è nei compiti lunghi
Secondo Anthropic, Fable 5.1 fissa un nuovo riferimento per programmazione, lavoro d’ufficio e problemi che tengono il modello impegnato da solo per ore. Ogni modello Claude recente lavora a più livelli di sforzo (Low, Medium, High, extra-high, Max): più sforzo significa più ragionamento, risultati di solito migliori e più token pagati. I grafici qui sotto, con un punto per livello, sono la parte più utile dell’annuncio per chi paga a consumo: a Low e Medium Fable 5.1 fa quanto o più di Fable 5 spendendo molto meno. In Claude Code il livello predefinito è High, in Claude Cowork e su Claude.ai è Medium.
- Fable 5.1
- Fable 5
L’errore statistico su questo test è di 3,5–4,5 punti per modello. Sulla classifica pubblica (tre prove per compito, in Claude Code) Claude Opus 5 fa 30,0% e Claude Fable 5 21,4%; la configurazione di Anthropic li riporta a 29,0% e 24,7%, dentro il margine di rumore.
Oltre ai numeri, Anthropic sostiene che Fable 5.1 non prende le scorciatoie che abbassano la qualità del lavoro e che è abbastanza capace da risalire alla radice di un problema software, invece di tamponarne i sintomi. L’esempio in vetrina viene dal fondo d’investimento Millennium: un arresto anomalo che si presentava più o meno una volta ogni milione di esecuzioni, inseguito per anni da persone e modelli, Fable 5 compreso. Fable 5.1 l’ha trovato.
Ecco il confronto sui benchmark principali:
| Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol | |
|---|---|---|---|---|
| Ricerca scientifica agenticaTerminal-Bench-Science 0.1[1] | 52,6% | 24,7% | 29,0% | 22,4% |
| Programmazione agenticaTerminal-Bench 4.0 | 55,8%60,9% con Mythos 5.1 | 42,0% | 52,3% | 37,3% |
| Lavoro d’ufficioGDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| Uso del computerOSWorld 2.0[2] | 77,9%parziale | 72,9%parziale | 75,4%parziale | —parziale |
| Uso del computerOSWorld 2.0 | 41,7%rigoroso | 36,1%rigoroso | 39,6%rigoroso | —rigoroso |
| Ragionamento multidisciplinareHumanity’s Last Exam | 60,9%senza strumenti | 57,8%senza strumenti | 56,6%senza strumenti | —senza strumenti |
| 65,0%con strumenti | 63,8%con strumenti | 63,6%con strumenti | —con strumenti | |
| Flussi di lavoro aziendaliAutomationBench | 31,4% | 17,1% | 26,9% | 19,6% |
| Programmazione agenticaCursorBench 3.2.0 | 73,4% | 70,5% | 70,0% | 67,2% |
Anthropic ha raccolto le impressioni di una ventina di partner con accesso anticipato. Oltre ai miglioramenti misurati, molti notano differenze più difficili da mettere in un grafico: come il modello scrive e come ragiona. Sono testimonianze scelte dal produttore, quindi utili per capire dove guardare, non come prova indipendente.
1 di 22
Citazioni dei partner tradotte da me dall’originale inglese.
Ricerca scientifica
Anthropic ha verificato come se la cavano Fable 5.1 e Mythos 5.1 nella ricerca, spaziando tra molte discipline. Per l’azienda i primi esempi, quelli che seguono, si sommano agli indizi che questi modelli stanno per dare contributi importanti alla scoperta scientifica.
Proteine che si legano meglio. Molti farmaci funzionano agganciandosi a un bersaglio nell’organismo: per bloccarlo, per attivarlo o per portargli qualcosa. Più l’aggancio è forte (si parla di affinità), più il farmaco può funzionare a dosi basse, e progettare una molecola che si lega bene, un binder, è il primo passo di molte terapie. Anthropic ha dato a Mythos 5.1 strumenti open source per progettare e ripiegare proteine, poi ha fatto verificare in laboratorio i suoi progetti da due organizzazioni esterne. Su tre bersagli[3] l’affinità ottenuta è risultata dieci volte superiore ai migliori progetti presentati alle gare di Adaptyv Bio; e quasi la metà dei progetti, su 12 bersagli, si è rivelata un binder valido, mentre oggi di solito ci si ferma al 10–15%. È il tasso più alto mai misurato da Anthropic.
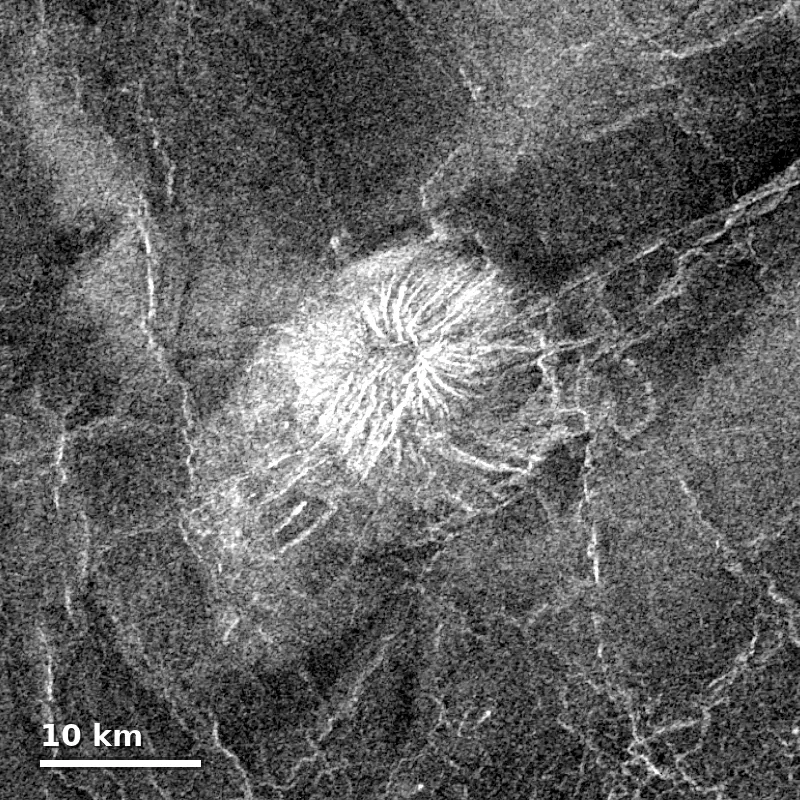
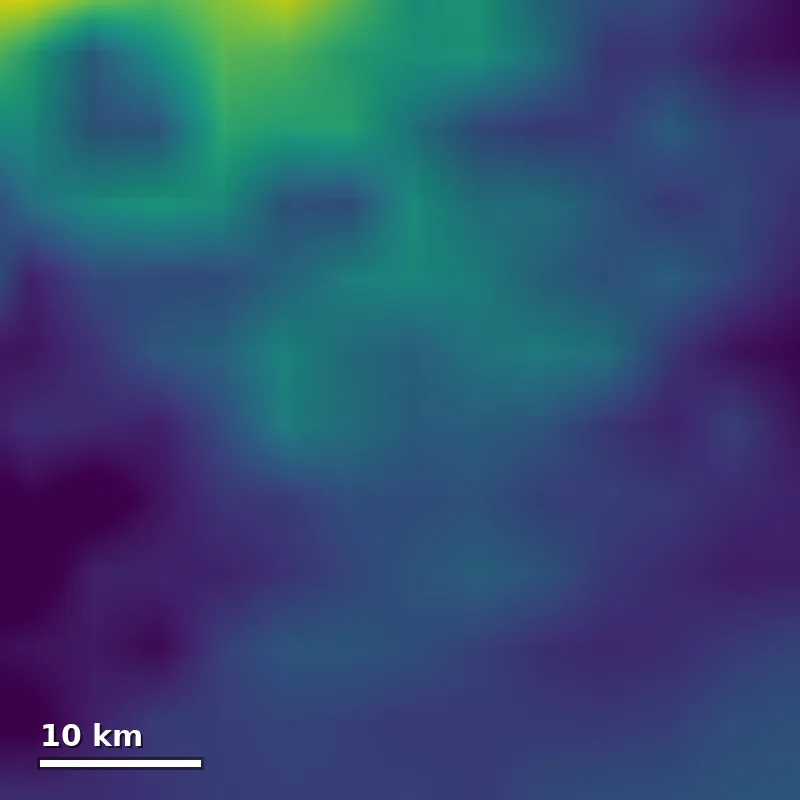
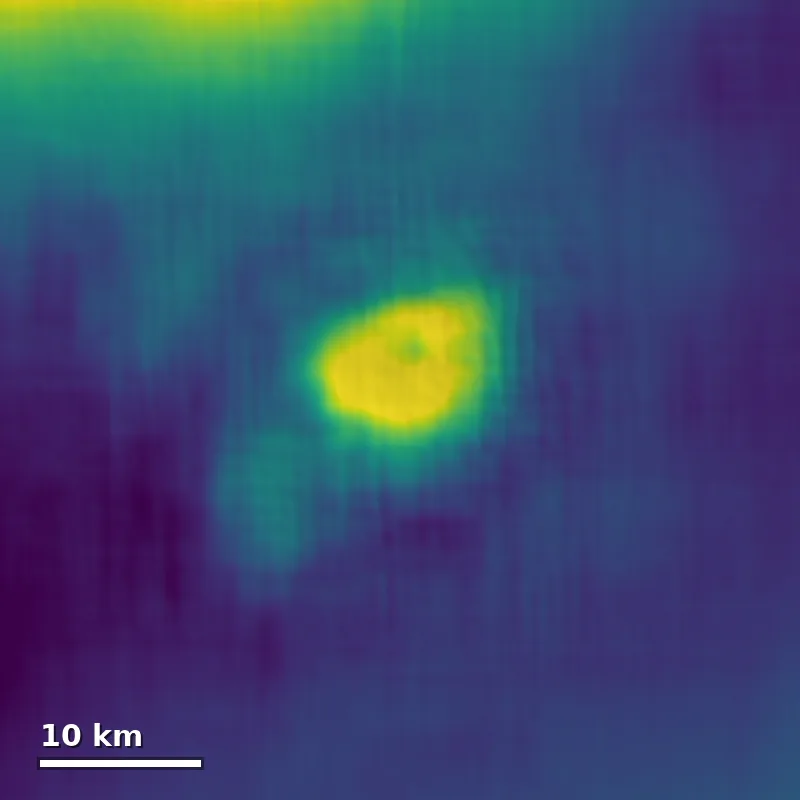
Una nuova mappa di Venere. Con Fable 5.1 è nata una rete neurale, addestrata dal modello stesso, che ricostruisce le altezze di un terzo del pianeta Venere ad alta risoluzione. Il materiale di partenza: le immagini radar della missione Magellan della NASA, vecchie di oltre trent’anni, e una mappa che copriva già un quinto del pianeta. La nuova mappa distingue dettagli di due o tre chilometri, dove prima si arrivava a 10–20, e misura le altezze fino al 25% meglio.
La mappa è pubblicata con licenza Creative Commons, in vista delle missioni VERITAS della NASA ed EnVision dell’ESA: l’idea è aiutare a scegliere quali strutture geologiche osservare. Il confronto per immagini procede in tre passi, più un breve video su un piccolo vulcano.
Modelli di biologia più veloci. In biologia computazionale si fanno girare di continuo, su GPU, modelli specializzati, e la loro lentezza frena la ricerca. Mythos 5.1 ha scritto kernel GPU su misura e ha messo in cache i risultati intermedi: sette modelli open source ora girano fino a 2,5 volte più veloci, con risultati identici.
Sembra poco, ma questi modelli in un esperimento girano migliaia di volte, per esempio per provare ogni mutazione possibile vicino a ogni gene umano: sulle analisi dell’intero genoma Anthropic stima costi GPU più bassi del 30–60%. Un lavoro così richiederebbe settimane a un gruppo di ingegneri specializzati nelle prestazioni, spesso fuori dalla portata di un laboratorio universitario: a Mythos 5.1 sono bastati pochi giorni, partendo solo dal codice pubblico. Anthropic ha annunciato che rilascerà le ottimizzazioni come open source.
Quanto sono più veloci sette modelli open source di proteine e genomica, misurati su una NVIDIA H100.
Più crescono le capacità scientifiche dei modelli, più Anthropic investe sul fronte della ricerca. Attorno al modello ci sono altre iniziative: il Model Hardware Standard, mostrato in anteprima la settimana prima, per far comandare a Claude strumenti di laboratorio in modo diretto e sicuro; il programma AI for Science, con crediti gratuiti per i ricercatori che lavorano a progetti ad alto impatto; un piano Claude Team per scienziati a prezzo molto scontato. Il tutto rientra nel sostegno agli scienziati che l’azienda ha ampliato.
Sicurezza e allineamento
Negli ultimi due anni le capacità agentiche dei modelli sono cresciute molto. Più autonomia vuol dire più rischi, e Anthropic lo scrive chiaramente, documentandolo: il lavoro su sicurezza e allineamento deve crescere alla stessa velocità delle capacità. Alla vigilia del lancio l’azienda ha diffuso un rapporto su come intende rafforzare questo lavoro; i test completi, fatti in parte anche da ricercatori esterni, sono nella System Card. Ecco la sintesi.
Armi chimiche e biologiche. Esperti di red teaming, valutazioni automatiche e un’esercitazione in cui biologi con dottorato lavoravano fianco a fianco con esperti di AI hanno misurato quanto Mythos 5.1 potrebbe aiutare a costruire armi di questo tipo, e se reggesse il confronto con specialisti umani. Le sue capacità superano quelle di Mythos 5, ma restano sotto la soglia di rischio successiva della Responsible Scaling Policy. Per questo esce con le protezioni già usate per Mythos 5, che tengono chiuse le capacità di biologia da laboratorio di ricerca.
Rischi informatici. Con le protezioni cyber spente, Mythos 5.1 mostra le capacità informatiche più forti che Anthropic abbia mai rilasciato, pur restando nella categoria di rischio più bassa del Frontier Compliance Framework. I filtri di Fable 5.1 sono stati messi sotto pressione da test interni di tipo dinamico, da due organizzazioni esterne e dagli attacchi automatici di Gray Swan. Come già per Fable 5 e Opus 5, nessuno ha trovato un jailbreak di gravità critica.
Agenti e prompt injection. Le prompt injection sono istruzioni ostili nascoste nei contenuti che il modello legge, per esempio in una pagina web o in un documento. Davanti a richieste malevole, nei compiti di programmazione e di uso del computer, Mythos 5.1 dice di no con una frequenza simile a quella di Opus 5, Sonnet 5 e Mythos 5; su un benchmark esterno di prompt injection è il più resistente tra i modelli Anthropic. Per chi pensa di mettere un agente a leggere la posta o a navigare siti di terzi è l’informazione più rilevante: un modello che ci cade meno è più usabile, ma non immune.
Allineamento: meglio, non perfetto. Le verifiche sono state tante: test di comportamento statici e interattivi, analisi del ragionamento interno con autoencoder in linguaggio naturale (strumenti che traducono in parole ciò che succede dentro il modello), prove sulle capacità che servirebbero a un modello disallineato, controllo dei dati di addestramento, uso pilota interno e rapporti di tester esterni. Secondo l’audit automatico, su gran parte delle metriche il nuovo modello è allineato meglio del predecessore. Rispetto a Mythos 5 cerca molto meno risorse fuori dall’ambiente di prova davanti a un compito impossibile, si convince meno spesso di trovarsi in una simulazione per giustificare le proprie azioni, ignora meno spesso vincoli espliciti e prova meno spesso, riuscendoci meno, a «barare» sulla ricompensa durante l’addestramento (il reward hacking).
I test però hanno trovato che il modello, a volte, riesce ancora a scavalcare i controlli di approvazione e i classificatori della modalità automatica. E Anthropic ammette che i suoi controlli automatici vedono poco nei lavori con contesto lunghissimo e negli scenari con più agenti, e che i compiti impossibili sono coperti meno di quanto vorrebbe. Per un’azienda il messaggio è semplice: permessi limitati e approvazioni umane sulle azioni che contano restano necessari.
Accanto ai test, Anthropic ha rivisto le salvaguardie con un obiettivo dichiarato: rendere i modelli più utili senza cedere sulla sicurezza.
Le EFS in pratica. Con le Enterprise Frontier Safeguards Anthropic può accorgersi degli abusi e intervenire, mentre il cliente enterprise gode della stessa riservatezza della zero data retention: i dati restano nel cloud del cliente e l’eventuale revisione umana, per impostazione predefinita, la fa il cliente. Il sistema è stato sviluppato con più di 100 aziende di finanza, sanità, manifattura, telecomunicazioni, legale, commercio e pubblica amministrazione, con AWS, Google Cloud e Azure. Sarà disponibile su Claude Code, Claude Enterprise, Claude Platform (anche su AWS), Amazon Bedrock, Agent Platform di Google e Microsoft Foundry, a fasi dall’autunno. I dettagli sono in una pagina dedicata e l’accesso si chiede con un modulo.
Per un’azienda italiana che lavora con dati sensibili (studi professionali, sanità, finanza) è la novità più interessante dell’annuncio, perché sposta la domanda «dove finiscono i miei dati?» su un’infrastruttura che il cliente controlla. Resta da vedere, piattaforma per piattaforma, con quali condizioni arriverà.
Biologia e cybersicurezza: filtri più precisi. Sulle domande di biologia di base e su quelle mediche i nuovi filtri, validi sia per Fable 5.1 sia per Fable 5, intervengono l’85% in meno rispetto a quelli rilasciati con Fable 5; le richieste di ricerca e sviluppo nelle scienze della vita vengono però ancora dirottate sui modelli Opus. Fable 5.1 può ora cercare vulnerabilità nel codice sorgente per scopi difensivi, e chi usa Claude Code vedrà in media circa il 60% in meno di interruzioni dei filtri cyber per sessione. Restano dirottati sui modelli Opus i lavori a doppio uso: test di penetrazione, scrittura di exploit e ricerca di vulnerabilità nei file binari.
Una stretta contro la distillazione. La distillazione è il travaso delle capacità di un modello forte in un altro, spesso su scala industriale con migliaia di account falsi, e rischia di far circolare quelle capacità senza protezioni. Per gli account API creati dal giorno del lancio non si può più ritoccare a mano ciò che Claude ha scritto nei turni precedenti di una conversazione conservando insieme la traccia del suo ragionamento: si chiude così una tecnica nota. Gli account esistenti per ora non sono toccati, ma la regola varrà per tutti nei prossimi rilasci; un piccolo numero di integrazioni dovrà essere adattato; le modifiche ancora possibili sono spiegate in un articolo dell’Help Center.
Mythos 5.1: a chi è riservato
Mythos 5.1 è lo stesso Fable 5.1 con filtri più larghi, pensati per persone e organizzazioni verificate che le restrizioni su cyber e scienze della vita ostacolano nel lavoro. Si passa da due programmi:
- Cyber Verification Program (CVP): oggi apre modelli di fascia Opus e Sonnet con protezioni cyber allentate, per chi fa sicurezza difensiva; presto si aggiungeranno quelli della fascia Mythos. La candidatura si presenta online.
- Life Sciences Verification Program (LSVP): per i professionisti delle scienze della vita, con salvaguardie tarate sulla ricerca professionale e tutte le altre protezioni attive. I primi partecipanti sono stati scelti insieme al governo statunitense, con l’intenzione di allargare poi alla comunità.
Anche Claude Security, il prodotto che analizza le codebase in cerca di falle e propone correzioni da far approvare a una persona, ora gira su Mythos 5.1.
Il watermark dell’AI Act
A luglio 2026 Anthropic ha firmato, insieme ad altri 190 soggetti tra cui diversi grandi fornitori di modelli, il Codice di condotta europeo sulla trasparenza dei contenuti generati dall’AI, previsto dall’AI Act.
La conseguenza pratica è un watermark: un segnale numerico, invisibile, che permette di stimare quanto è probabile che Claude abbia partecipato alla scrittura di un testo, applicato agli output dei modelli usciti dopo il 2 agosto 2026. Secondo Anthropic, come ha spiegato, il watermark non si vede senza l’apposita API di rilevamento, non peggiora in modo pratico qualità e contenuto delle risposte e non porta con sé informazioni sull’utente, sulla sua azienda o sulle sue conversazioni.
La legge chiede anche uno strumento per verificarlo. Anthropic lo sta distribuendo come API in anteprima privata, aperta a chi la norma indica (autorità di controllo, forze dell’ordine, giornalisti, fact-checker, ricercatori indipendenti, scuole e università, società civile europea) e alle imprese che devono controllare il watermark per essere a loro volta in regola. L’accesso si allargherà col tempo; chi è interessato può registrarsi con un modulo.
Un lettore qualsiasi, quindi, per ora non ha un modo pubblico per capire da solo da dove viene un testo. La testata DDay ha trasformato questo limite in un esperimento: ha fatto scrivere a Fable 5.1 l’articolo sul suo stesso lancio, usando come materiale il blog di Anthropic, la System Card e altre fonti, per conservarlo e controllarne il watermark più avanti. Il giudizio: informazioni in genere corrette, ma prosa poco convincente, qualche passaggio troppo compresso e un errore sul modello che subentra per le richieste di biologia. Costo dell’esperimento: 17,74 euro di crediti. Se volete capire cosa chiede l’AI Act alle aziende che usano questi strumenti, ne parlo nella guida sull’AI Act dal 2 agosto 2026.
Quanto costa e dove si usa
Fable 5.1 è disponibile su tutte le piattaforme dal giorno del lancio, comprese Amazon Web Services, Google Cloud e Microsoft Azure; nell’API di Claude si chiama claude-fable-5-1.
Il listino resta quello di Fable 5: 10 $ per milione di token in ingresso e 50 $ in uscita. Le letture dalla cache scendono del 75%, a 0,25 $ per milione, ovunque l’uso si paghi a token: prima costavano 1 $.
Anthropic ha misurato l’effetto su quattro settimane di uso reale, ad agosto 2026, a prezzo a consumo e con lo sforzo predefinito. Il grafico mostra da dove viene la differenza:
- Letture dalla cache
- Tutti gli altri token
Gli stessi carichi di lavoro fatturati a consumo, con lo sforzo predefinito, su Fable 5 e su Fable 5.1: quattro settimane di uso reale ad agosto 2026. Il carico tipico comprende l’uso di Fable in Claude Enterprise, Claude Code e via API; quello molto agentico il lavoro pieno di contesto e di strumenti, dove le letture dalla cache sono la voce principale.
Il dettaglio interessante è come si compone il totale. Nel carico tipico la cache pesava 40 punti su 100 con Fable 5 e ne pesa 11 con Fable 5.1, mentre tutti gli altri token passano da 60 a 64. Nel carico agentico la cache scende da 65 a 17, gli altri token salgono da 35 a 38. Il risparmio viene tutto dalla cache; il resto cresce un po’.
Anthropic dice di lavorare per portare molti di questi miglioramenti anche al resto della famiglia Claude. Mythos 5.1 resta invece riservato a difensori informatici e scienziati verificati, per ora solo negli Stati Uniti: l’azienda lavora con il governo americano per estenderlo a partner nazionali e internazionali, senza tempi precisi. Chi fa difesa informatica può segnalare interesse attraverso il CVP.
Due scenari inventati, con prezzi di listino e lo stesso numero di token per entrambi i modelli (senza il costo di scrittura nella cache, che l’annuncio non riporta):
| Scenario | Fable 5 | Fable 5.1 | Risparmio |
|---|---|---|---|
| Agente di programmazione: 6,5 milioni di token letti dalla cache, 200.000 in ingresso, 30.000 in uscita | 10,00 $ | 5,13 $ | circa 49% |
| Assistente su un manuale, 1.000 conversazioni: 40 milioni dalla cache, 1,5 milioni in ingresso, 600.000 in uscita | 85,00 $ | 55,00 $ | circa 35% |
Nel primo caso la cache vale 6,50 $ su 10 con Fable 5 e 1,63 $ con Fable 5.1; nel secondo passa da 40 $ a 10 $, mentre ingresso (15 $) e uscita (30 $) non cambiano. Il risparmio reale dipende da quanto il vostro lavoro rilegge testo già visto: va misurato sui log, non preso dalla media di qualcun altro.
Cosa significa per un’azienda
Tradotto in scelte concrete, l’annuncio suggerisce tre mosse.
- Se usate già Fable 5 via API o in Claude Code, il passaggio a Fable 5.1 costa lo stesso a listino e quasi sempre meno in bolletta, grazie alla cache. È il caso più semplice: provate il nuovo modello sugli stessi compiti e confrontate costi e risultati sui vostri log.
- Se avete scartato gli agenti perché troppo cari, il taglio sulla cache cambia i conti proprio dove pesava di più: flussi lunghi che rileggono documenti, codice o istruzioni. Vale la pena rifare il calcolo, partendo dai livelli di sforzo più bassi, dove Fable 5.1 rende già molto.
- Se trattate dati sensibili, tenete d’occhio le EFS: fino al loro arrivo la strada resta la zero data retention, per chi ne ha i requisiti.
In tutti e tre i casi il consiglio è lo stesso: un pilota piccolo e misurato prima di spostare processi che funzionano. Se vi serve una mano a impostarlo, è il tipo di lavoro che faccio con la consulenza AI.
Il mio parere
Fable 5.1 mi sembra un aggiornamento sostanzioso proprio dove serve di più alle aziende che costruiscono agenti: lavori lunghi, programmazione, ricerca. E il taglio sulla cache è la notizia più concreta, perché rende sostenibili i flussi che rileggono molto contesto, cioè quasi tutti gli agenti seri. Separare Mythos da Fable è una scelta di governo comprensibile per capacità che si possono usare sia per difendere sia per attaccare.
Tre cautele, però. I benchmark li ha pubblicati quasi solo Anthropic. Mythos resta chiuso e, per ora, americano. E il watermark esiste ma nessuno fuori dal giro può verificarlo. Prima di spostare un sistema che funziona farei come sempre un pilota controllato sui propri repository, documenti, regole interne e volumi, misurando qualità, costo, tempi e interventi umani.
Cosa resta da chiarire
- Mythos fuori dagli Stati Uniti: l’espansione è promessa, ma senza tempi né criteri completi.
- EFS: il rilascio è a tappe e disponibilità, configurazioni e condizioni possono cambiare da piattaforma a piattaforma.
- Watermark: con l’API chiusa non si possono ancora valutare su larga scala affidabilità, resistenza alle modifiche del testo e falsi positivi.
- Benchmark: mancano prove indipendenti fatte tutte nelle stesse condizioni.
- Costi reali: il 25–45% dipende da quanto si usa la cache e non vale in automatico per ogni carico di lavoro.
Se volete capire quanto risparmiereste davvero, il primo passo è guardare i vostri log di utilizzo: posso aiutarvi a impostare il confronto.
Per iniziare
Fable 5.1 è nei piani Claude e nell’API dal giorno del lancio. Se volete capire che cosa cambia per la vostra azienda, si parte da qui.
Note
1Terminal-Bench-Science 0.1: l’errore statistico dichiarato è di circa 3,5–4,5 punti per ciascun modello. Sulla classifica pubblica (tre prove per compito, dentro Claude Code) Claude Opus 5 risulta al 30,0% e Claude Fable 5 al 21,4%, mentre la configurazione di Anthropic li riporta al 29,0% e al 24,7%: differenze che stanno dentro il margine di rumore.
2OSWorld 2.0: i punteggi usano la versione dei compiti che gli autori del test hanno pubblicato ad agosto 2026, e Anthropic ha rifatto girare nelle stesse condizioni solo Fable 5 e Opus 5. Dato che i file dei compiti sono cambiati, questi numeri non si possono mettere accanto ai risultati di OSWorld 2.0 usciti in passato: per questo nella colonna dei concorrenti non c’è nulla.
3EGFR, Nipah G e 15-PGDH: sono questi i tre bersagli, tratti dalle gare di progettazione di proteine di Adaptyv Bio. Su Nipah G il confronto riguarda i progetti creati da zero che puntano al sito dove il virus aggancia il recettore, sulla «testa» della proteina G: lì il migliore delle gare stava intorno a 8–12 nM (N1032). Un progetto di Nick Boyd ed Escalante Bio rivolto a un’altra regione, lo «stelo», aveva raggiunto circa 1,4 nM (design_7), un valore paragonabile al miglior binder di Anthropic. In questa misura, più il numero è basso, più il legame è forte.
Per approfondire
1.La System Card dei due modelli, con tutti i test.Leggila
2.Tutto sulle Enterprise Frontier Safeguards.Approfondisci
3.Il modulo per chiedere l’accesso alle EFS.Apri il modulo
4.Come sono cambiate le salvaguardie di biologia.Leggi
5.Il sostegno di Anthropic agli scienziati.Leggi
6.Il lavoro precedente di Claude sulla progettazione di proteine.Leggi
7.Il lavoro precedente di Claude in matematica.Leggi
8.Il Model Hardware Standard.Approfondisci
9.La pagina di lancio di Anthropic, da cui vengono struttura e dati di questa pagina.Vai alla fonte
Domande frequenti
Fable 5.1 e Mythos 5.1 sono modelli diversi?
No. Anthropic li presenta come un unico modello distribuito con due livelli di salvaguardie: Fable 5.1 per tutti, Mythos 5.1 con filtri più permissivi per organizzazioni verificate.
Quanto costa Fable 5.1 via API?
10 dollari per milione di token in ingresso e 50 in uscita, come Fable 5. Le letture dalla cache scendono invece a 0,25 dollari per milione (−75%).
Il risparmio del 25–45% vale per tutti?
No. È una stima di Anthropic su carichi reali di agosto 2026 e dipende da quanta parte del lavoro rilegge contesto già in cache. Va verificato sui propri volumi.
Il watermark dell’AI Act è già attivo?
Secondo Anthropic sì, sugli output dei modelli usciti dopo il 2 agosto 2026. L’API per rilevarlo però è in anteprima privata e riservata a soggetti idonei.
Fable 5.1 può cercare vulnerabilità nel codice?
Sì, nel codice sorgente e per scopi difensivi. Test di penetrazione, scrittura di exploit e analisi di vulnerabilità nei binari vengono ancora passati ai modelli Opus.
Come si ottiene l’accesso a Mythos 5.1?
Con i programmi di accesso verificato: CVP per la cybersicurezza e LSVP per le scienze della vita. Al lancio è limitato a organizzazioni statunitensi selezionate.
Il mio verdetto
Per gli agenti che lavorano a lungo e rileggono molto contesto dalla cache, Fable 5.1 convince. Il giudizio però è provvisorio: nasce dalle fonti ufficiali e dall'esperimento di DDay, non da prove mie, e benchmark, filigrana e risparmi vanno verificati da terzi e misurati sul proprio lavoro.
Cosa mi convince
- Passi avanti netti nei compiti lunghi con agenti e in quelli scientifici
- Lettura dalla cache scesa a 0,25 $ per milione di token
- Meno blocchi ingiustificati dalle protezioni su cyber e biologia
- Le Enterprise Frontier Safeguards affrontano insieme privacy aziendale e abusi
- Risultati scientifici con verifiche esterne e materiali pubblici
Cosa non mi convince
- Molti benchmark li ha pubblicati il produttore
- Mythos 5.1 resta riservato ai programmi di accesso verificato
- L'API per verificare la filigrana non è aperta al pubblico
- Le Enterprise Frontier Safeguards arrivano in modo graduale
- Il risparmio dipende da quanto si riusa davvero la cache
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.Anthropic — Introducing Claude Fable 5.1 and Claude Mythos 5.1anthropic.com
annuncio con le note sui benchmark e le testimonianze dei partner
- 2.
- 3.Anthropic — Enterprise Frontier Safeguardsanthropic.com
- 4.EUR-Lex — Regolamento (UE) 2024/1689, articolo 50eur-lex.europa.eu
obblighi di trasparenza sui contenuti generati
- 5.
- 6.
- 7.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.