Anthropic porta su Claude Max e Pro il suo Opus più capace: risultati dichiarati su programmazione, ragionamento e lavoro d'ufficio, i casi raccontati dai partner e i punti ancora scoperti.
Claude Opus 5 si avvicina a Fable 5 costando circa la metà: benchmark dichiarati da Anthropic, esempi di autonomia, limiti e cosa cambia per un'azienda.
di Andrea Pirazzini
Fonte primaria
Anthropic — Introducing Claude Opus 5: annuncio, grafici dei benchmark, testimonianze dei partner, video e demo
anthropic.com
Versione audio
2 min 28 s
Perché se ne parla#
Il 24 luglio 2026 Anthropic ha messo a disposizione Claude Opus 5, il modello più capace mai uscito nella famiglia Opus. La promessa è semplice da riassumere: prestazioni che si avvicinano a quelle di Claude Fable 5, il modello di punta della casa, spendendo più o meno la metà.
Per chi usa Claude tutti i giorni la novità è già visibile. Su Claude Max Opus 5 diventa il modello predefinito, quello che si apre senza toccare nulla. Su Claude Pro è il modello più potente che si possa scegliere.
Anthropic lo presenta come il nuovo riferimento per due mestieri in particolare: scrivere e mantenere software, e il cosiddetto knowledge work, cioè il lavoro d'ufficio fatto di documenti, dati, ricerche e fogli di calcolo. Se avete letto il mio articolo su Claude Fable 5 e i piani Max e Team, Opus 5 è il tassello che mancava tra il modello di punta e quelli di tutti i giorni.
su Frontier-Bench v0.1, contro il 34% di Fable 5
circa, letto dal grafico
su ARC-AGI 3, dove GPT-5.6 Sol si ferma all'8%
circa, letto dal grafico
del costo di Fable 5, secondo Anthropic
punti percentuali in chimica organica rispetto a Opus 4.8
La scheda in breve#
Voce | Cosa sappiamo al lancio |
|---|---|
Data di rilascio | 24 luglio 2026 |
Posizione nella gamma | Sopra Opus 4.8, un gradino sotto Fable 5 |
Costo | Circa la metà di Fable 5, secondo Anthropic |
Listino API per milione di token | Non pubblicato |
Claude Max | Modello predefinito |
Claude Pro | Il modello più potente disponibile nel piano |
API per sviluppatori | Disponibile |
Dimensioni del modello | Non dichiarate |
Dove resta indietro | Compiti estremamente complessi (Fable 5), sicurezza informatica (Mythos 5) |
Dove si colloca nella famiglia Claude#
Pensate alla gamma di un'auto: c'è l'allestimento di punta, costoso, che si compra quando serve davvero il massimo; e c'è quello appena sotto, che fa quasi tutto allo stesso modo e costa molto meno. Opus 5 vuole essere il secondo. Anthropic lo definisce near-frontier: vicino alla frontiera, senza pretendere di esserci sopra.
Modello | Ruolo | Costo indicativo (Fable 5 = 100%) | Dove si trova |
|---|---|---|---|
Claude Fable 5 | Il modello di frontiera | 100% | Claude Max |
Claude Opus 5 | Quasi frontiera | circa 50% | Predefinito su Max, il più forte su Pro |
Claude Opus 4.8 | Generazione precedente | circa 50% | Claude Max e Pro |
Claude Sonnet 5 | Fascia più leggera | circa 20% | Claude Pro |
Quanto costa ogni modello rispetto a Fable 5
Costo relativo, Fable 5 = 100% (valori indicativi)
Fonte: tabella di posizionamento pubblicata con l'annuncio, luglio 2026
I costi relativi sono indicativi: l'unico riferimento ufficiale è "metà di Fable 5". Il dato interessante è un altro: Opus 5 dovrebbe costare quanto Opus 4.8, ma con risultati molto più alti. Chi oggi paga Opus 4.8, in pratica, riceve un modello migliore allo stesso prezzo.
Nella descrizione di Anthropic tornano tre comportamenti: il modello controlla da solo il proprio lavoro, riprova finché non arriva al risultato e, quando gli manca un attrezzo, se lo scrive. È su quest'ultimo punto che torneremo più avanti, perché è quello che cambia di più nell'uso reale.
Programmazione: i risultati dichiarati#
Frontier-Bench v0.1, il test più duro sul codice#
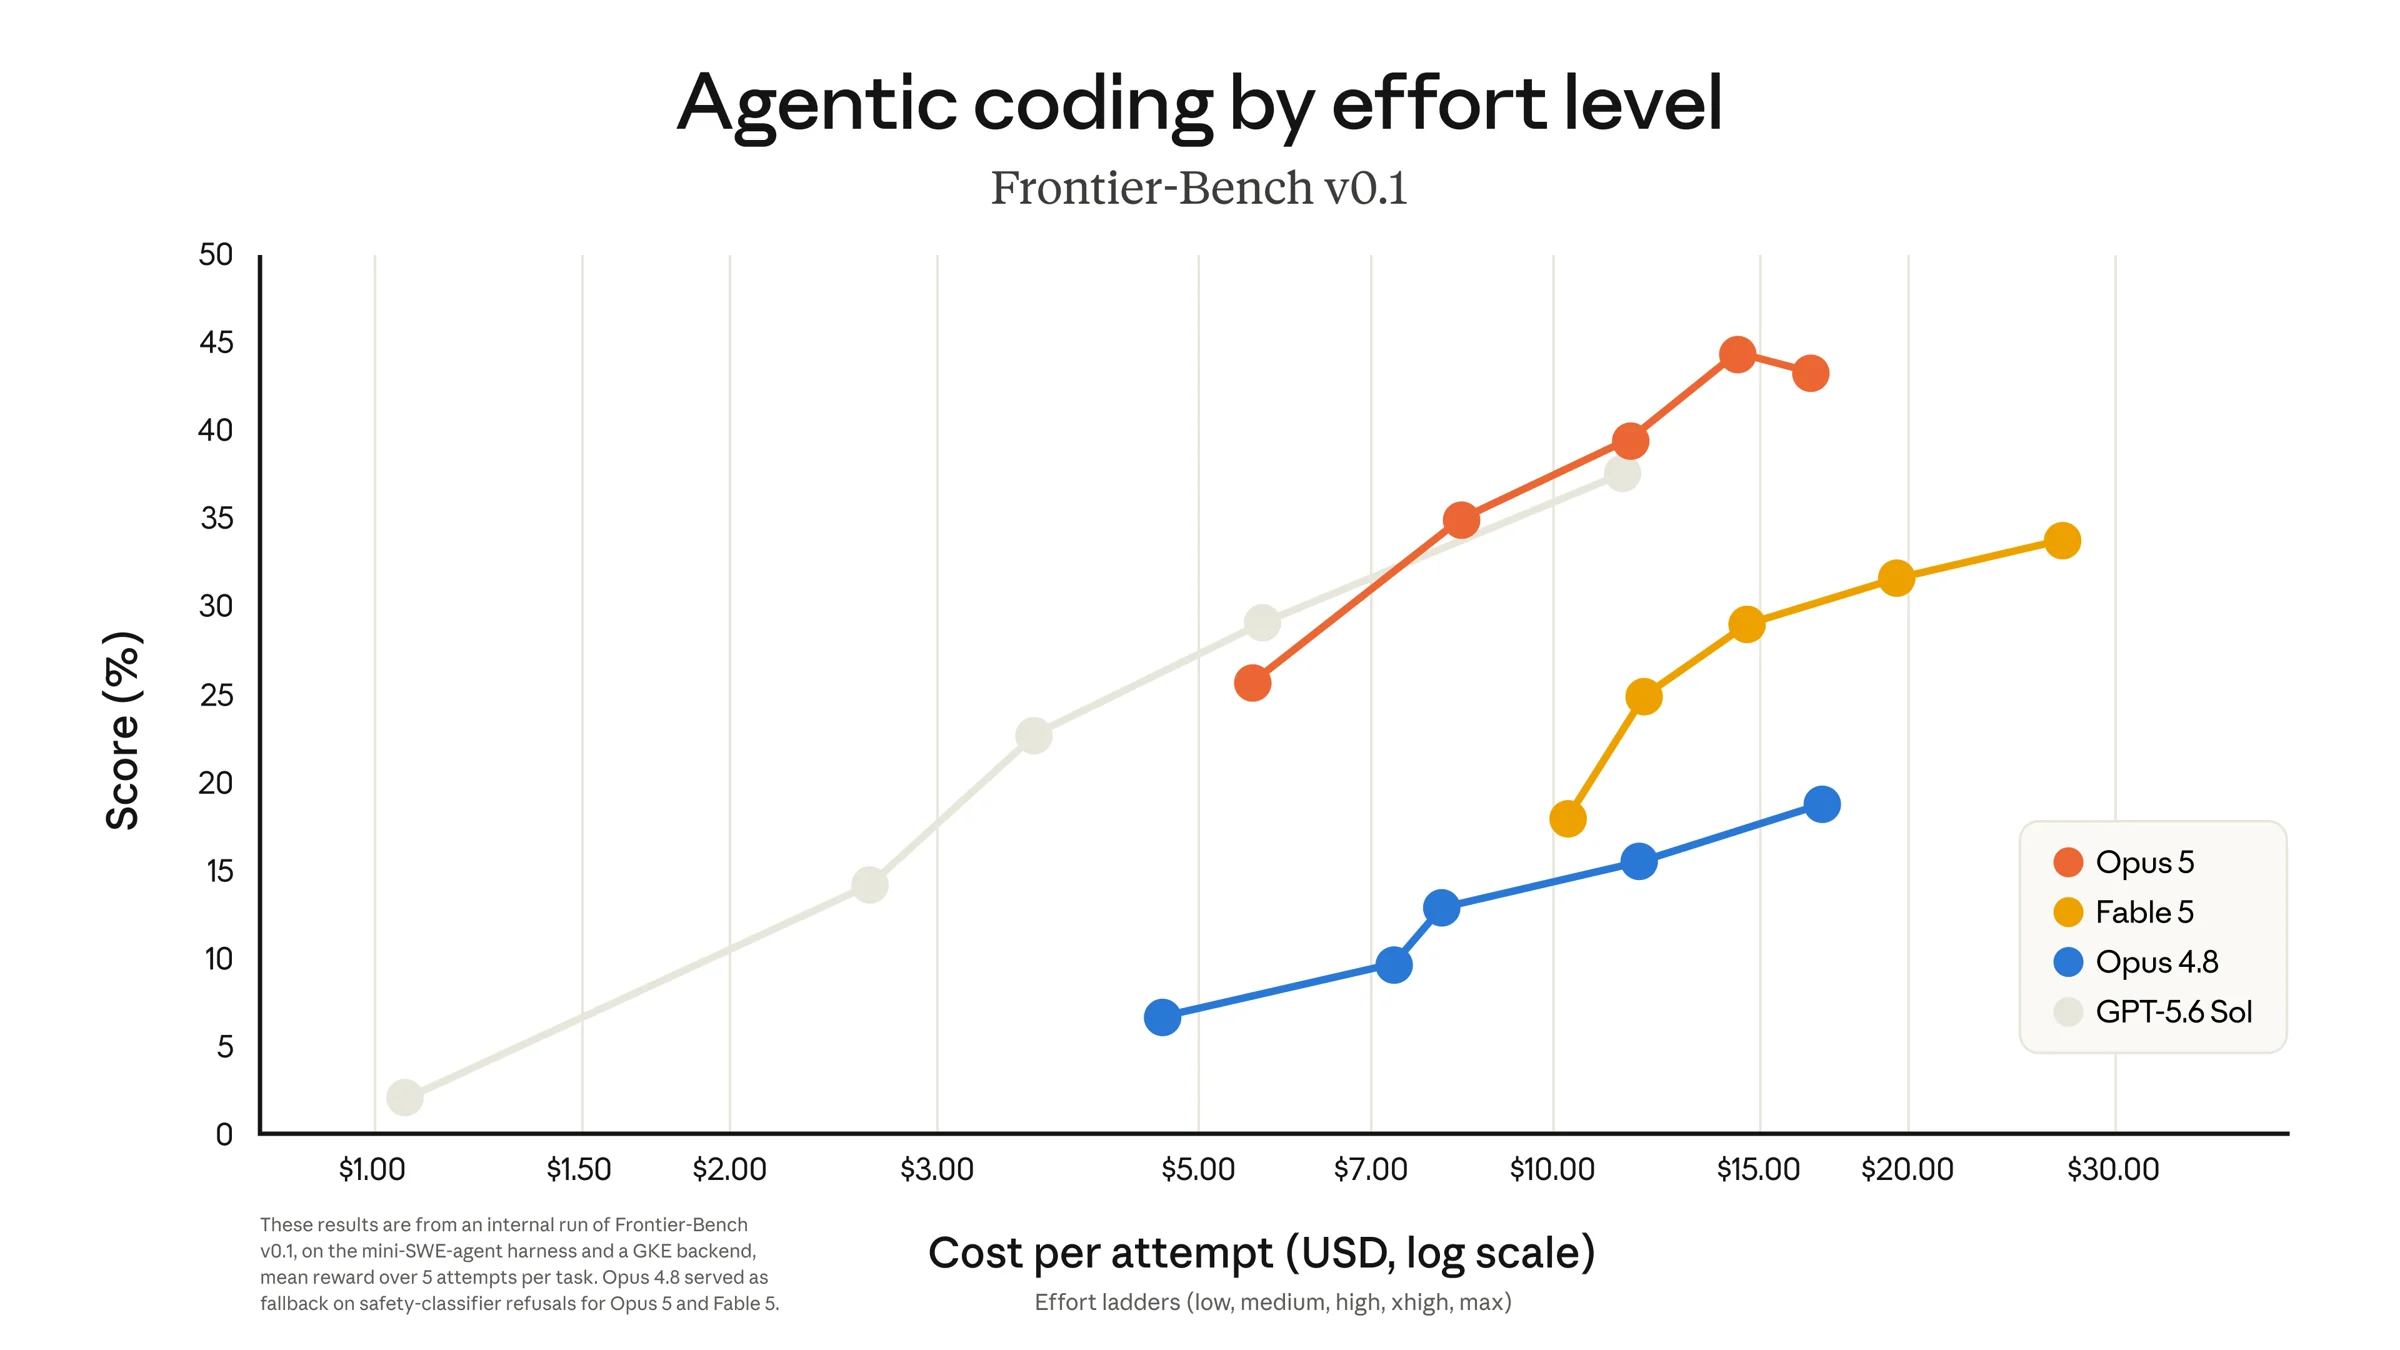
Frontier-Bench misura il coding agentico: non si chiede al modello di completare una riga, ma di lavorare su un progetto vero, lanciando comandi, leggendo errori e correggendo, fino a consegnare una soluzione funzionante. È oggi uno dei banchi di prova più esigenti.
Frontier-Bench v0.1
Coding agentico, punteggio al massimo sforzo (valori approssimati)
Fonte: grafico pubblicato da Anthropic, luglio 2026
Il punteggio da solo racconta metà della storia. Anthropic ha pubblicato anche quanto costa ogni tentativo, perché i modelli si possono far "pensare" di più o di meno (è il livello di sforzo), e più pensano più spendono.
Quanto costa un tentativo su Frontier-Bench
Dollari per tentativo al massimo sforzo (valori approssimati)
Fonte: grafico pubblicato da Anthropic, luglio 2026
Letto così, il risultato è netto: Opus 5 ottiene il punteggio più alto spendendo la metà di Fable 5, e rispetto a Opus 4.8 fa più del doppio con un costo per attività più basso. GPT-5.6 Sol costa un po' meno per tentativo, ma resta sotto di circa cinque punti.
CursorBench 3.2 e AA Coding Agent Index#
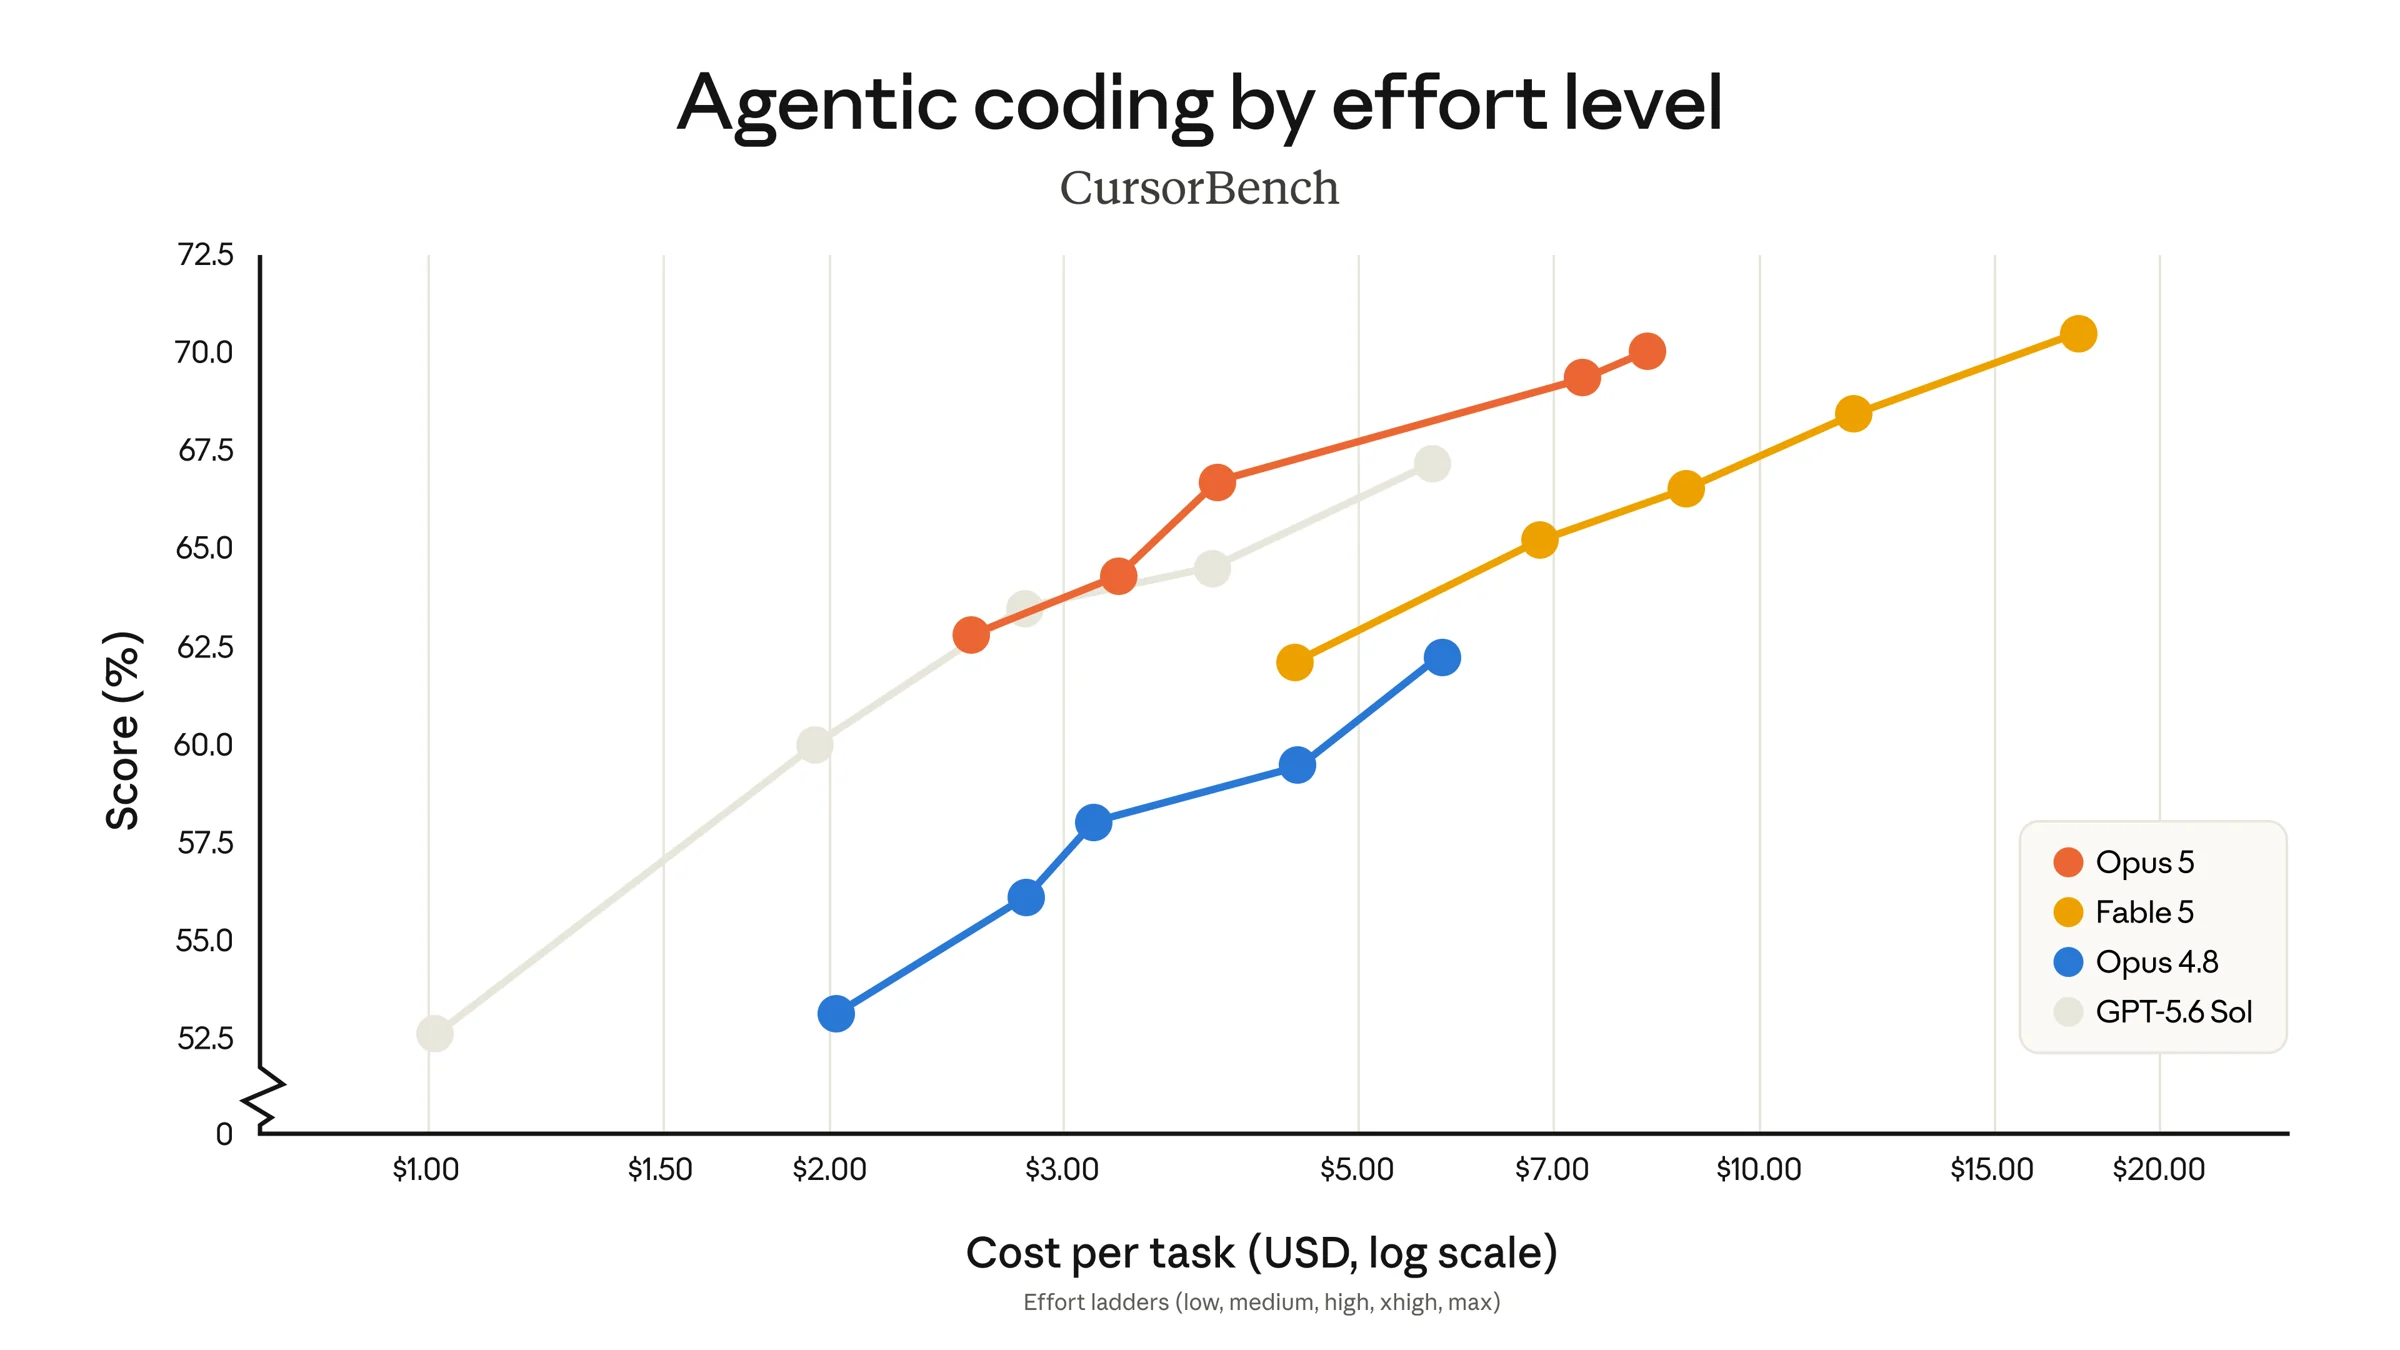
Su CursorBench 3.2, il test legato all'editor di codice Cursor, Opus 5 al massimo sforzo arriva entro lo 0,5% del punteggio di Fable 5, di nuovo con metà della spesa. Sull'AA Coding Agent Index, un indice che confronta gli agenti di programmazione, Anthropic dichiara un nuovo primato.
Ragionamento e lavoro d'ufficio#
ARC-AGI 3: il salto più vistoso#
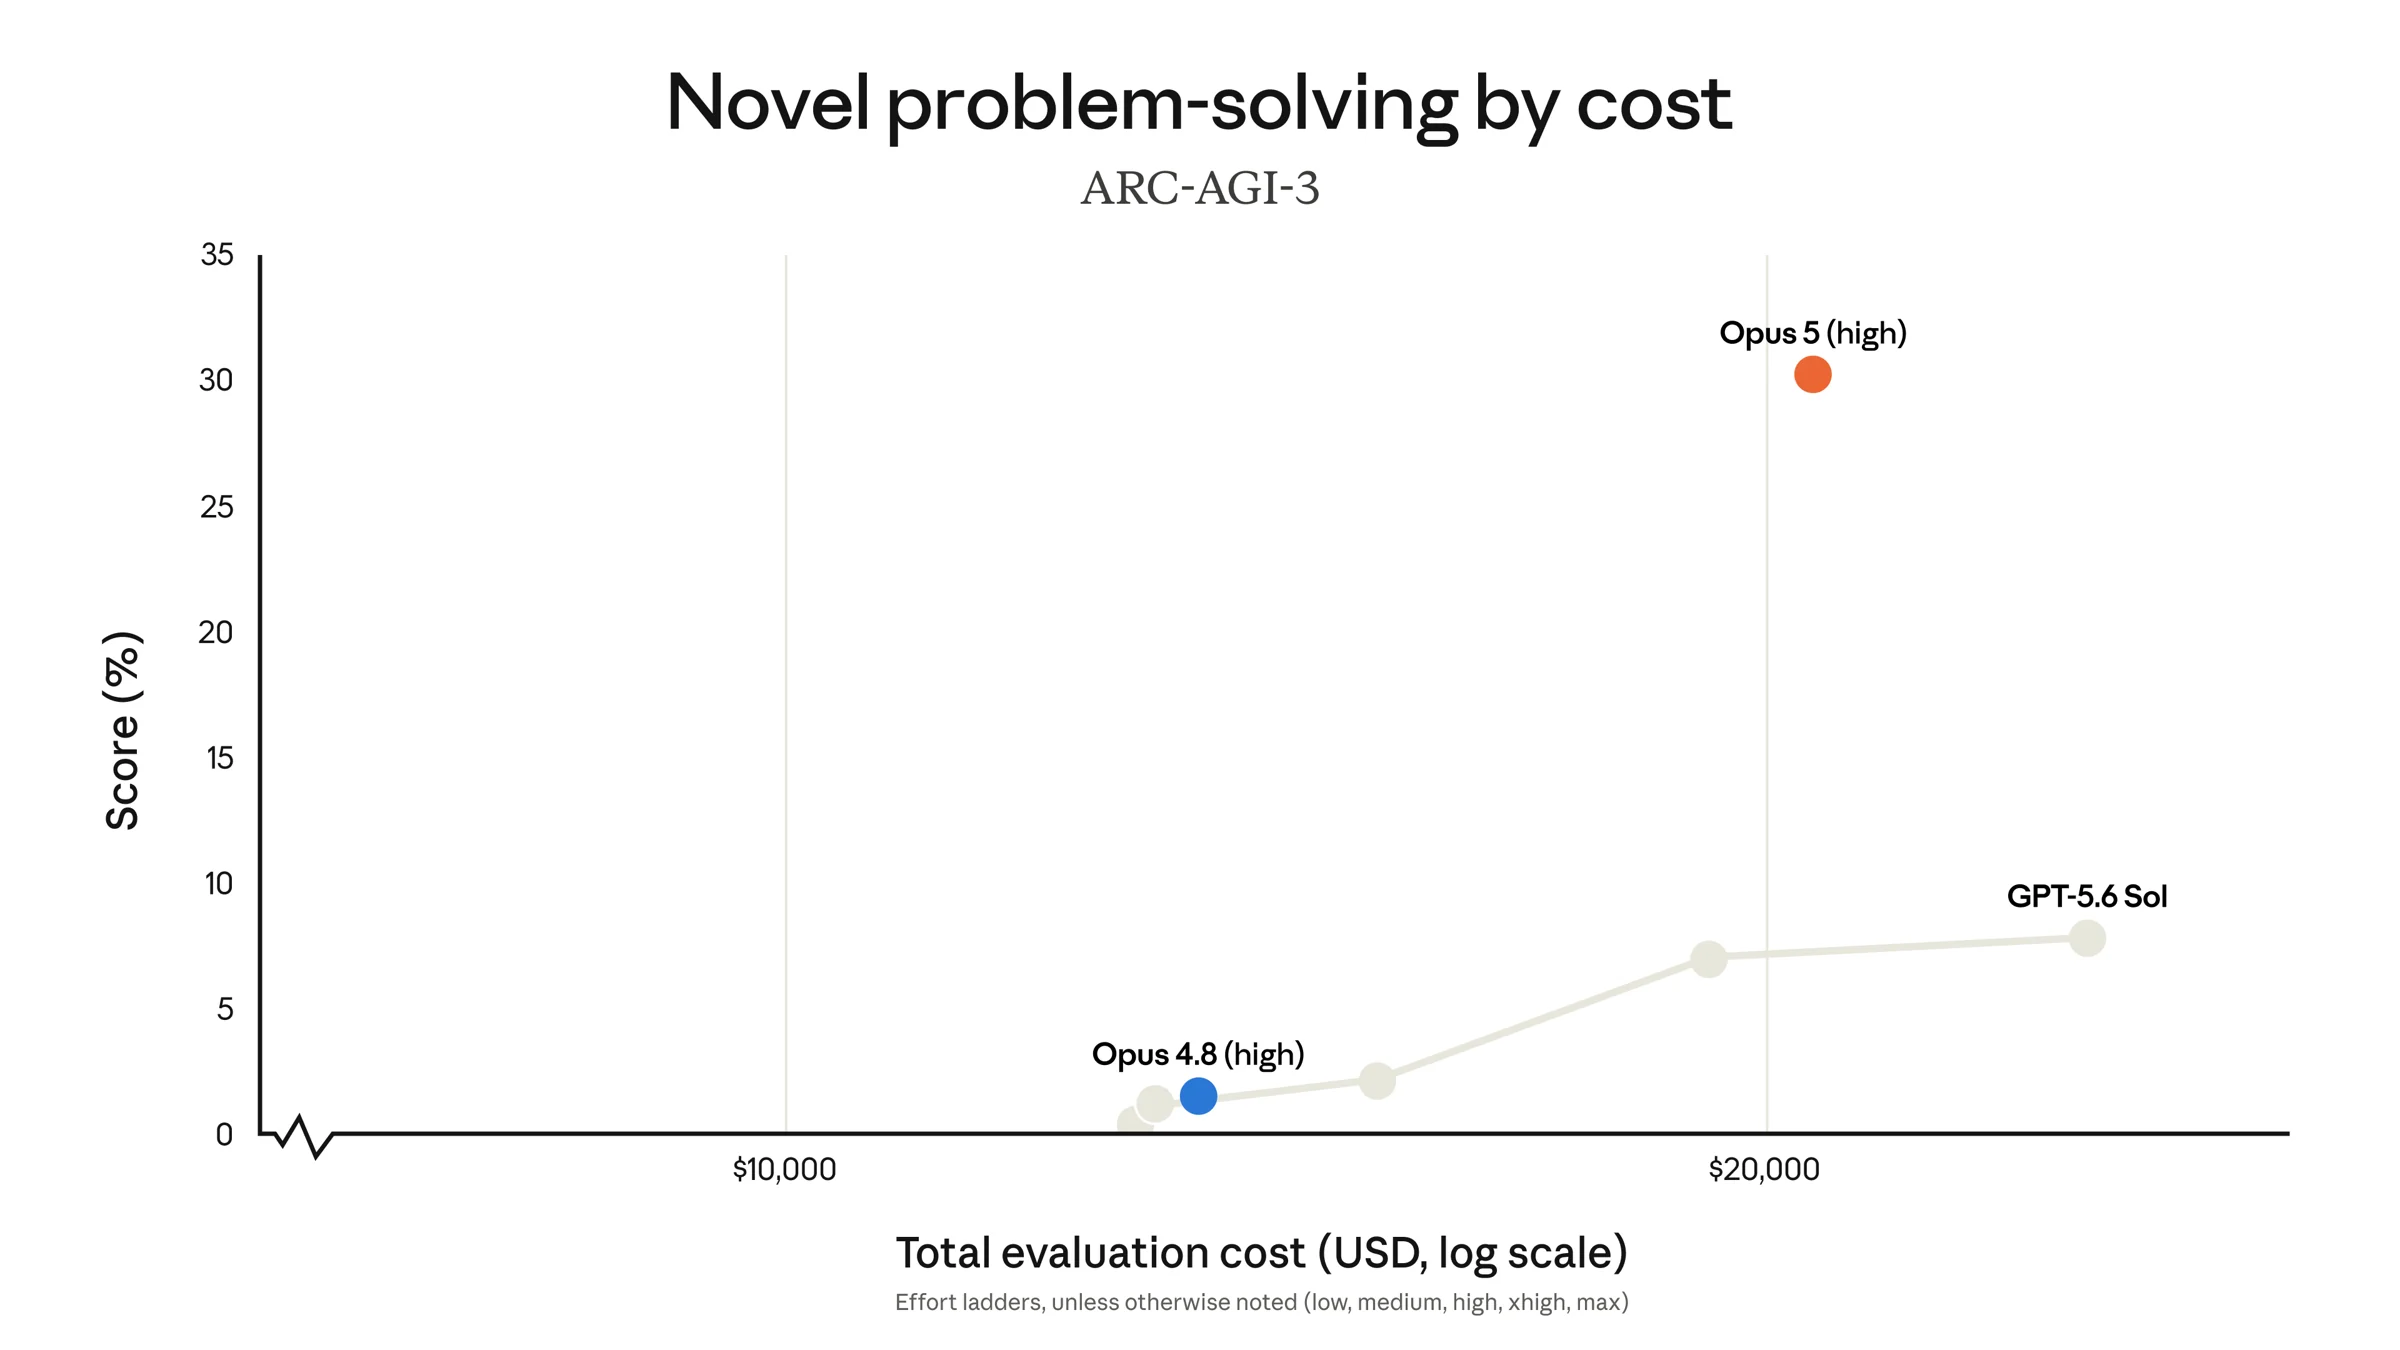
ARC-AGI 3 è una raccolta di rompicapi astratti pensati per essere nuovi: non si risolvono ricordando qualcosa letto in addestramento, ma capendo la regola al momento. È considerato uno dei test di ragionamento più difficili in circolazione.
ARC-AGI 3
Problemi nuovi risolti (valori approssimati)
Fonte: grafico pubblicato da Anthropic, luglio 2026
Anche qui il grafico affianca a ogni punteggio una spesa: circa 20.000 dollari per il 30% di Opus 5, circa 25.000 per l'8% di GPT-5.6 Sol. Non è il costo di una vostra richiesta: serve a capire quanto rende ogni dollaro speso nella prova, e anche su questo Opus 5 esce meglio.
Gli altri test sul lavoro di tutti i giorni#
Test | Cosa misura, in parole semplici | Risultato dichiarato |
|---|---|---|
Zapier AutomationBench | Automazioni tra applicazioni aziendali | Circa 1,5 volte il miglior concorrente a parità di costo; 100% su un caso reale |
OSWorld 2.0 | Usare un computer come una persona: finestre, clic, programmi | Supera Fable 5 con un terzo della spesa |
GDPval-AA v2 | Compiti professionali di valore economico | Nuovo primato |
DeepSearchQA | Ricerche approfondite con molte fonti | Nuovo primato |
Humanity's Last Exam (HLE) | Domande difficilissime da molte discipline | Nuovo primato |
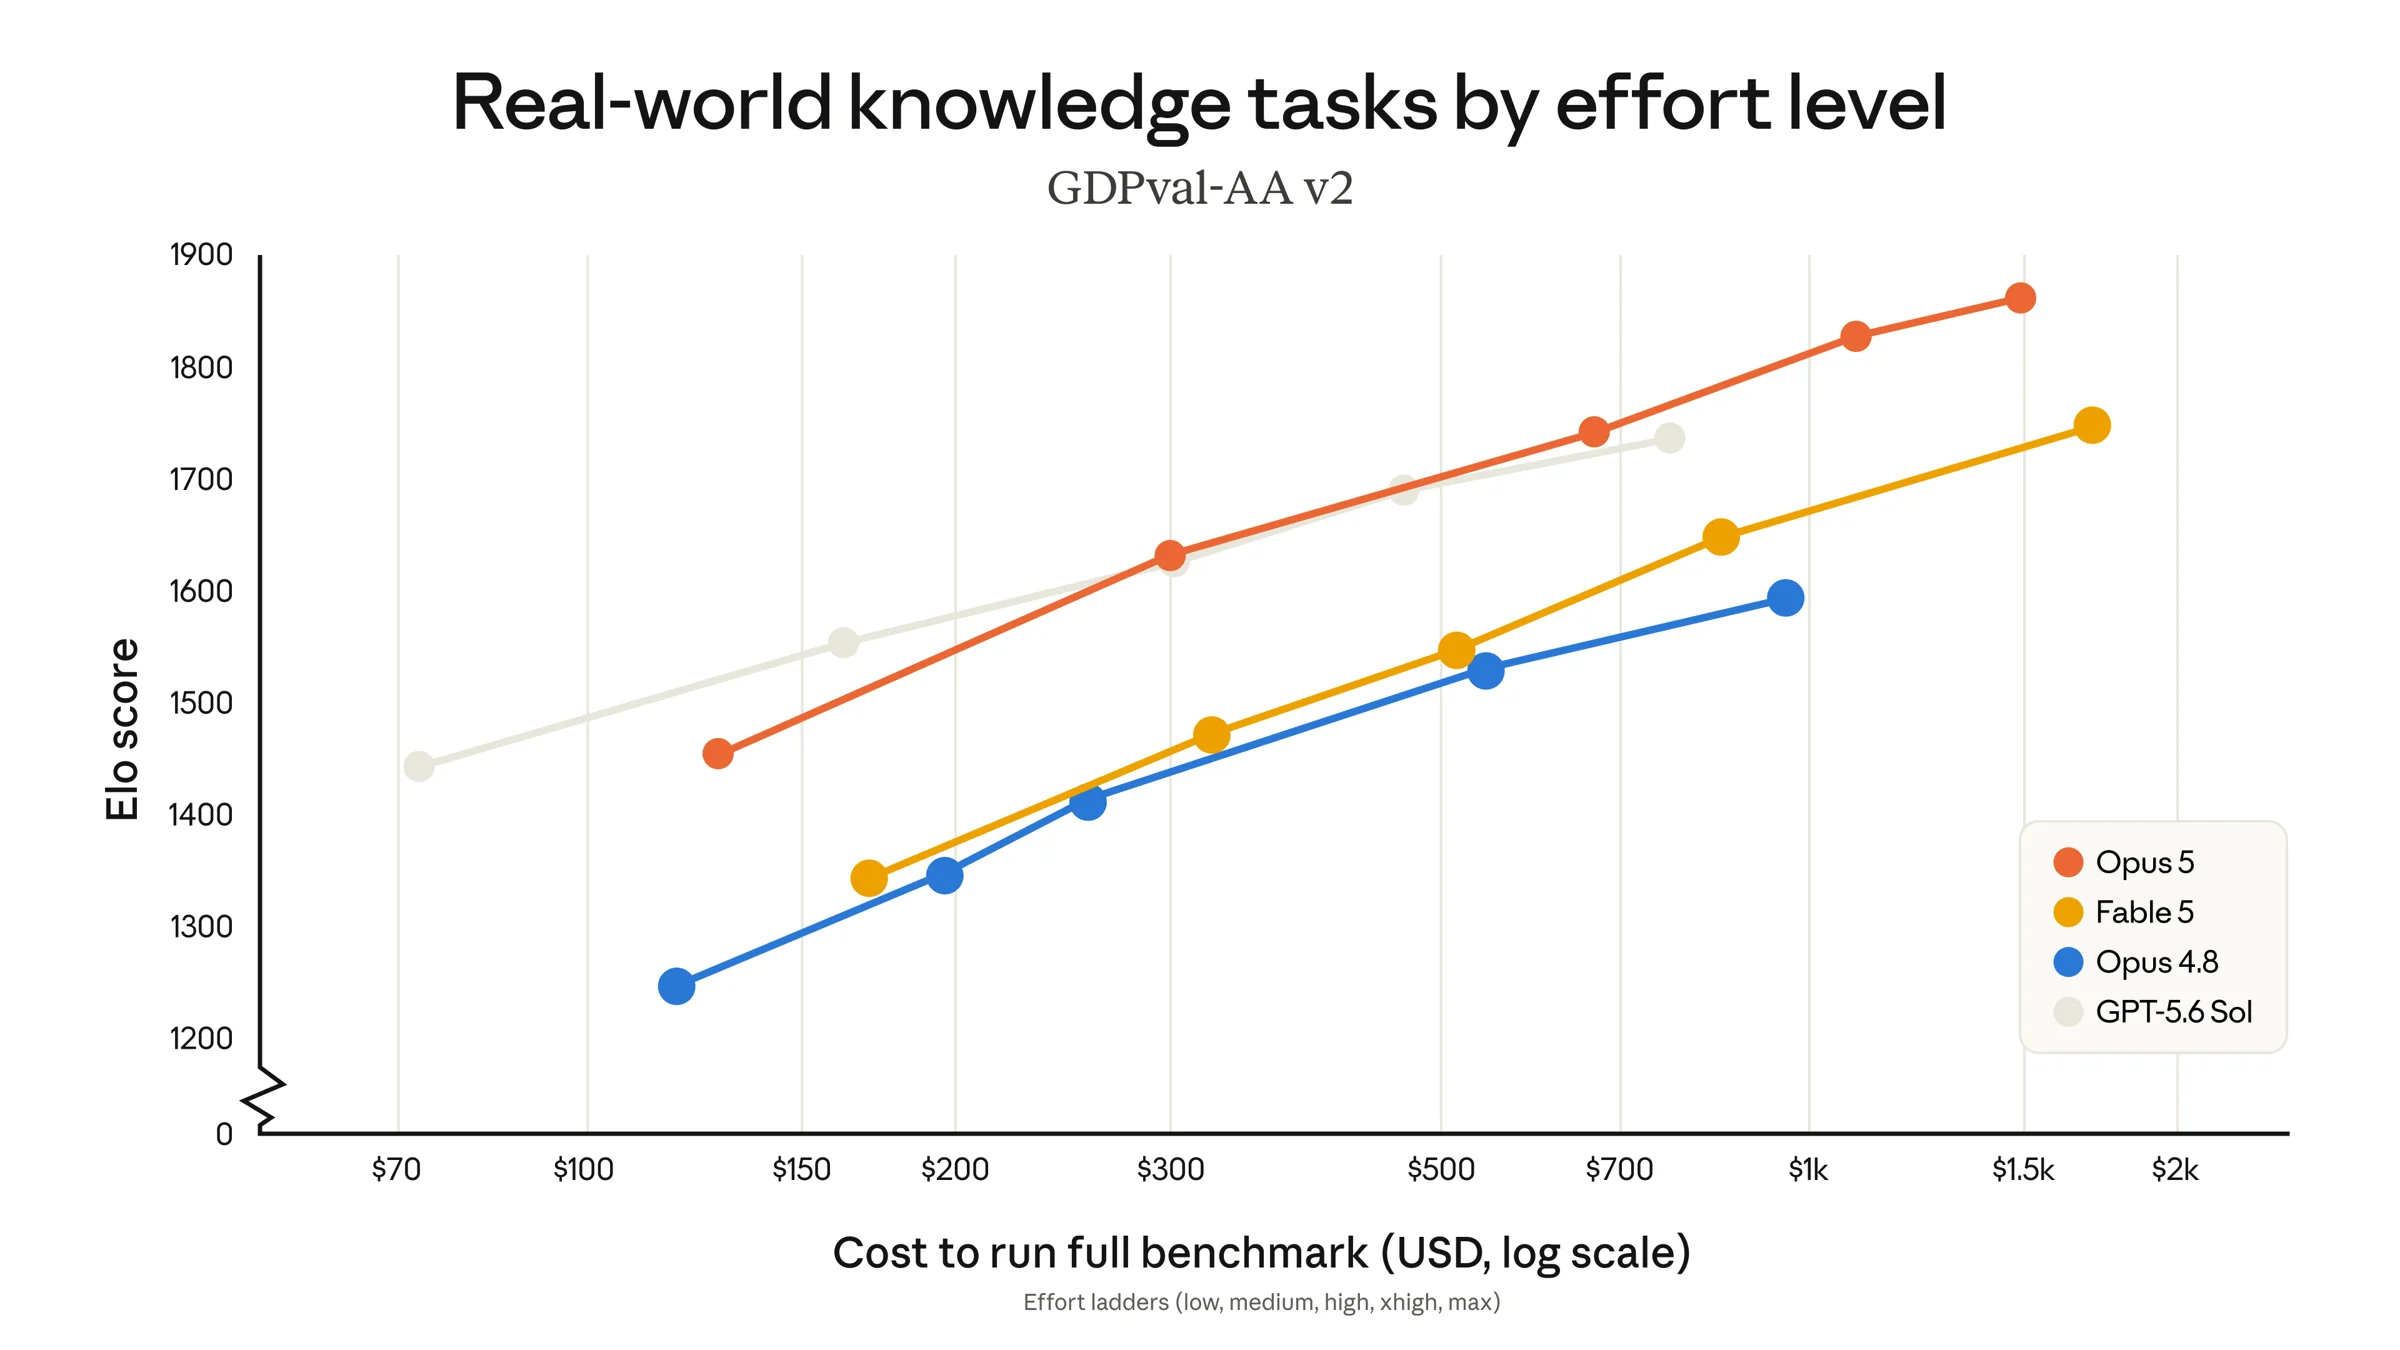
Due dettagli meritano attenzione. Su AutomationBench, anche al livello di sforzo più basso Opus 5 porta a termine più attività di qualsiasi altro modello: è il dato più utile per chi pensa ad automazioni che girano tante volte al giorno, dove si usa lo sforzo minimo per contenere i costi. Su OSWorld 2.0, a qualunque livello di spesa Opus 5 batte tutti gli altri modelli: significa che la curva costo-risultato è migliore lungo tutto il percorso, non solo al massimo.
Scienze della vita#
Anthropic segnala miglioramenti su tutte le sue valutazioni di area scientifica, dalla biologia strutturale alla bioinformatica. Due numeri, entrambi rispetto a Opus 4.8:
Chimica organica: +10,2 punti percentuali nel ricavare la struttura di una molecola a partire dai dati spettroscopici, cioè dalle "impronte" che una sostanza lascia negli strumenti di analisi di laboratorio.
Proteine: +7,7 punti percentuali nel prevedere come una modifica nella sequenza di una proteina ne cambia la funzione.
Per biologia strutturale e bioinformatica non ci sono cifre pubbliche, solo l'indicazione di progressi su ogni test interno. Per un laboratorio o un'azienda farmaceutica è un segnale da tenere d'occhio; per una PMI di altri settori conta soprattutto come indizio di un ragionamento più preciso su dati tecnici.
La vera novità: si costruisce gli attrezzi#
Più dei punteggi, a colpire sono i tre episodi che Anthropic racconta. Hanno in comune un comportamento: quando l'ambiente non offre il modo di controllare il lavoro, Opus 5 quel modo lo crea.
1. Un pezzo meccanico ricostruito da un disegno#
Durante una prova di Frontier-Bench, il modello ha ricevuto il disegno di un componente meccanico, senza alcuno strumento per guardarlo. Ha scritto una sua procedura di visione artificiale per ricavare la forma direttamente dai pixel e poi ha ricostruito l'intero pezzo in FreeCAD, il programma di disegno 3D open source. Con le stesse condizioni, nessun modello concorrente ci è riuscito in cinque tentativi; Opus 5 ci è riuscito più volte.
2. La causa del problema, non il sintomo#
Su un bug reale di un noto gestore di pacchetti open source, Opus 5 ha individuato l'origine del difetto e sistemato anche un caso limite che la correzione proposta dalla comunità aveva lasciato scoperto. Un modello concorrente, alla stessa prova, ha tappato il sintomo visibile e ha dato il problema per risolto. Chi ha avuto a che fare con un fornitore che "chiude il ticket" senza capire il guasto sa quanto valga questa differenza.
3. Un flusso di dati di borsa in una sola sessione#
Un ingegnere di una società di trading ha chiesto a Opus 5 di costruire da zero il flusso di dati di mercato per una nuova borsa. I modelli precedenti non ci arrivavano nemmeno con un piano dettagliato. Opus 5 ha chiuso il lavoro in una sessione e, non avendo dati in tempo reale con cui controllarsi, si è costruito un banco di prova per verificare che la lettura dei dati fosse corretta.
C'è poi un aneddoto interno. Cristian Rivera, ingegnere di Anthropic, racconta di avergli affidato per un fine settimana il ruolo di chief of staff, una specie di braccio destro, sui suoi ambienti di sviluppo: il modello si è scritto un sistema di monitoraggio, ha gestito tutte le macchine e lo ha chiamato in causa solo per le scelte importanti.
Le demo: un'auto 3D, una galleria del vento, una cellula#
Anthropic ha pubblicato un video in cui Opus 5 genera una scena 3D interattiva: un'auto sportiva rossa appoggiata su una griglia in prospettiva, che l'utente fa girare a 360 gradi con un cursore chiamato "TURN THE CAR". L'intera interfaccia, grafica compresa, è scritta dal modello in WebGL con la libreria Three.js.
Accanto al video ci sono due demo interattive, anche queste realizzate da Opus 5 e raggiungibili dalla pagina dell'annuncio:
Wind Tunnel, una galleria del vento virtuale: si caricano delle forme e si osserva come l'aria scorre intorno a oggetti aerodinamici e non.
Cell Artifact, un'illustrazione semplificata di una cellula in cui si possono esplorare le singole parti.
Il senso non è l'effetto speciale: è mostrare che il modello consegna applicazioni web complete, con grafica 3D in tempo reale, non frammenti di codice da assemblare.
Una curiosità sulla copertina scelta da Anthropic: uova di uccelli disegnate come nelle tavole scientifiche dell'Ottocento, disposte a formare il numero 5. L'idea è quella della nascita, di qualcosa che si schiude.
Cosa dicono i partner che l'hanno provato in anteprima#
Prima del lancio alcune aziende hanno avuto accesso anticipato. Sono commenti scelti da Anthropic, quindi vanno letti come testimonianze, non come prove indipendenti.
Chi parla | Cosa ha notato |
|---|---|
Scott Wu, Devin | Su FrontierCode 1.1 si avvicina a Fable a metà costo; forte nel debugging difficile e nella ricerca delle cause |
Fabian Hedin, Lovable | Il salto più grande della famiglia Opus dai tempi di Opus 4.5; ottimo su animazioni, giochi e 3D, e costante nei risultati |
Izzy Miller, Hex | Meglio di Opus 4.8 su tutta la linea nell'analisi aperta; guadagni maggiori sui compiti più vaghi, risposte più chiare e sintetiche |
Shirley Zhang, Hex | Nella ricerca finanziaria spicca su calcoli, tabelle e senso critico |
Wade Foster, Zapier | 100% su AutomationBench in un processo completo di prevenzione degli abbandoni |
Ben Kus, Box | +8% su Opus 4.8, con +11% nell'analisi dati e +17% nella due diligence |
Il caso di Zapier è il più vicino alla vita di un'azienda: partendo da un file con lo stato di salute dei clienti, il modello ha svolto tutta la sequenza contro gli abbandoni, cioè individuare i clienti a rischio, mandare gli avvisi e scrivere i riepiloghi, senza interventi a metà strada.
Opus 5 rispetto a Opus 4.8, test di Box
Miglioramento percentuale dichiarato
Fonte: dichiarato da Box (Ben Kus), luglio 2026
Box ricorda che sono attività quotidiane in tecnologia, sanità e pubblica amministrazione. La due diligence, per uno studio o un ufficio acquisti, è lo spulciare contratti in cerca di rischi: lì un +17% pesa più di un record su un test astratto.
Cosa significa per un'azienda#
Per chi usa già Claude, il passaggio è quasi automatico: con Max Opus 5 è il predefinito, con Pro basta selezionarlo. La domanda vera riguarda chi ha costruito processi o applicazioni sulle API.
Se usate Opus 4.8, conviene provare Opus 5 subito: a parità di costo dichiarato, i risultati attesi sono più alti. Il cambio va comunque collaudato sulle vostre richieste reali, perché un modello nuovo può rispondere in modo diverso anche agli stessi prompt.
Se usate Fable 5 per programmazione, analisi di documenti o automazioni, vale la pena misurare se Opus 5 basta: potreste dimezzare la spesa. Tenete Fable 5 per i casi davvero estremi.
Se lavorate sulla sicurezza informatica, sappiate che Anthropic stessa colloca Opus 5 dietro a Mythos 5 su questi compiti.
Se state pensando alle prime automazioni, Opus 5 è un buon candidato per flussi che toccano più applicazioni, come quello descritto da Zapier. In questi casi la parte difficile non è il modello ma il disegno del processo: ne parlo nella pagina sulle automazioni con l'AI.
Cosa manca ancora#
Anthropic è chiara su due limiti: Opus 5 non raggiunge Fable 5 sui compiti estremamente complessi e resta dietro a Mythos 5 sulla sicurezza informatica. A questi si aggiungono le informazioni che al momento dell'annuncio non c'erano:
il prezzo API esatto per milione di token, in ingresso e in uscita;
le dimensioni del modello, sia totali sia attive;
classifiche indipendenti come LMArena, LiveBench e Artificial Analysis;
un confronto diretto con GPT-5.6 Sol su test non scelti da Anthropic;
tempi e modalità precisi di disponibilità in Europa.
Finché mancano i punti 3 e 4, i grafici restano quelli del produttore: attendibili come indicazione, non come verdetto.
Il mio parere#
Per il rapporto tra quello che fa e quello che costa, Opus 5 è il modello Anthropic più convincente uscito finora. Non è Fable 5, e Anthropic è la prima a dirlo, ma per la gran parte del lavoro quotidiano (codice, analisi, documenti, automazioni) sembra la scelta più sensata della gamma. I numeri colpiscono meno per il loro valore assoluto che per l'efficienza: stesso livello o meglio, a metà spesa.
Quello che mi interessa di più, però, è il comportamento. Un modello che si costruisce una procedura di visione artificiale o un banco di prova quando l'ambiente non glieli dà si comporta come un collaboratore autonomo, non come un assistente che aspetta istruzioni. È un vantaggio enorme nei lavori lunghi e un rischio se nessuno ha deciso i confini.
Il metodo che consiglio resta lo stesso: prendere cinque o dieci attività vere, farle eseguire al modello attuale e a Opus 5, e confrontare qualità, costo, tempi e numero di correzioni necessarie. Il listino API definitivo ancora non c'è, quindi i conti precisi vanno rifatti quando Anthropic lo pubblica. Se volete impostare questo confronto sui vostri processi, possiamo farlo insieme.
Domande frequenti#
Claude Opus 5 sostituisce Fable 5?
No. È un gradino sotto Fable 5 e costa circa la metà. Anthropic lo propone come modello di tutti i giorni per programmazione e lavoro d'ufficio, mentre Fable 5 resta il riferimento per i compiti più complessi e Mythos 5 per la sicurezza informatica.
Quanto costa rispetto a Opus 4.8?
Secondo le informazioni disponibili al lancio, lo stesso di Opus 4.8, con risultati molto superiori. Il listino API esatto per milione di token però non è stato pubblicato: Anthropic parla solo di "metà del prezzo di Fable 5".
Dove si può usare?
Su Claude Max, dove è il modello predefinito, su Claude Pro, dove è il più potente disponibile, e tramite le API di Anthropic per chi sviluppa applicazioni.
Le demo 3D sono state fatte davvero dal modello?
Secondo Anthropic sì: l'auto rossa girevole è un'interfaccia WebGL e Three.js scritta da Opus 5, così come le demo Wind Tunnel e Cell Artifact pubblicate insieme all'annuncio.
I benchmark sono verificati da terzi?
Non ancora al momento del lancio. I punteggi vengono da Anthropic e dai partner in anteprima; mancano classifiche indipendenti e confronti diretti su test esterni.
Il mio verdetto
Per rapporto tra prestazioni e prezzo è il modello Anthropic più riuscito finora: vicino alla frontiera a metà costo, e nuovo riferimento per programmazione e lavoro d'ufficio. Il salto vero però è l'autonomia: si costruisce gli strumenti che gli mancano, controlla il proprio lavoro e riprova finché non arriva al risultato.
Cosa mi convince
- Nuovo primato su Frontier-Bench v0.1: più del doppio di Opus 4.8, spendendo meno
- ARC-AGI 3 intorno al 30%, il triplo del miglior concorrente
- Su CursorBench 3.2 resta a mezzo punto da Fable 5 con metà della spesa
- Su OSWorld 2.0 supera Fable 5 costando un terzo
- Lavora da solo: si scrive strumenti di visione e banchi di prova, e cerca la causa dei bug
- Predefinito su Claude Max e il modello più forte disponibile su Pro
Cosa non mi convince
- Sulla sicurezza informatica resta dietro a Mythos 5
- Sui compiti più complessi non arriva al livello di Fable 5
- Il listino API esatto non è stato pubblicato
- Le dimensioni del modello non sono dichiarate
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
1- 1.Anthropic — Introducing Claude Opus 5: annuncio, grafici dei benchmark, testimonianze dei partner, video e demoanthropic.com
I valori indicati con «circa» sono letti dai grafici dell'annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.