Un milione di token di contesto, testo, immagini e video, sessioni di lavoro che durano ore. Cosa ha annunciato Moonshot AI, cosa resta da verificare e quando ha senso provarlo in azienda.
Kimi K3 di Moonshot AI: 2,8 trilioni di parametri, contesto da 1 milione di token, prezzi API e limiti dichiarati. Cosa conta davvero per un’azienda.
di Andrea Pirazzini
Fonte primaria
Moonshot AI — Kimi K3: Open Frontier Intelligence, blog tecnico di lancio
kimi.com
Versione audio
2 min 40 s
Perché se ne parla#
Moonshot AI ha presentato Kimi K3, e il titolo che gira ovunque è il numero: 2,8 trilioni di parametri. È un numero enorme, ma da solo dice poco. La domanda che conta è un'altra: il modello riesce a restare coerente mentre lavora per ore su un progetto grande, passando dal terminale al browser agli strumenti esterni senza perdere il filo?
È esattamente lì che Moonshot vuole portare K3: programmazione di lunga durata, analisi di grandi raccolte di documenti, ricerca e compiti che mescolano testo, immagini e video.
Si può già usare su Kimi.com, dentro Kimi Work e Kimi Code, e via API. I pesi completi, invece, al momento dell'annuncio erano solo promessi entro il 27 luglio 2026, senza una licenza definitiva. Per ora quindi è corretto parlarne come di un modello con apertura annunciata, non ancora avvenuta.
parametri totali
16 esperti attivi su 896
token di contesto dichiarati
per milione di token generati
3 $ in ingresso, 0,30 $ se in cache
acceleratori minimi per installarlo in proprio
consigliati da Moonshot
La scheda tecnica, in una tabella#
Voce | Cosa dichiara Moonshot |
|---|---|
Parametri totali | 2,8 trilioni |
Architettura | Mixture of Experts: 16 esperti attivi su 896 |
Finestra di contesto | 1 milione di token |
Cosa legge | Testo, immagini e video |
Ragionamento | Sempre attivo; al lancio c'è solo il livello massimo |
Dove si usa | Kimi.com, Kimi Work, Kimi Code, API |
Pesi del modello | Annunciati entro il 27 luglio 2026 |
Prezzo API | 0,30 $ input in cache · 3 $ input · 15 $ output (per milione di token) |
Come è fatto dentro#
Tanti specialisti, pochi al lavoro per volta#
K3 è un Mixture of Experts. Immaginate uno studio con 896 specialisti: per ogni parola da elaborare non li chiamate tutti, ne scegliete 16. Così il modello può avere una capacità totale enorme senza pagare il costo di usare ogni parametro a ogni passo.
Il punto delicato è lo smistamento: il sistema deve capire ogni volta quali specialisti coinvolgere, senza sovraccaricarne alcuni e lasciarne altri inutilizzati. Da quanto è fatto bene dipende gran parte della qualità.
Due novità per i testi molto lunghi#
Moonshot abbina a questa struttura due componenti suoi:
Kimi Delta Attention (KDA): un meccanismo di attenzione in parte lineare, pensato per non rallentare troppo quando la sequenza da leggere diventa lunghissima.
Attention Residuals (AttnRes): invece di sommare sempre allo stesso modo ciò che ogni livello del modello produce, sceglie quali rappresentazioni portarsi avanti.
Nel diagramma pubblicato nella documentazione delle API i pezzi sono tre: accanto a KDA e AttnRes compare Stable LatentMoE, il blocco che gestisce gli esperti. Per chi usa il modello sono dettagli invisibili, ma spiegano perché Moonshot insista tanto sulla tenuta nei testi lunghi.
L'azienda parla di un'efficienza di scaling circa 2,5 volte migliore rispetto a Kimi K2. Attenzione a come si legge: il dato mescola architettura, addestramento e dati, quindi non significa che K3 risponda due volte e mezzo più veloce.
Farlo girare in casa? Per quasi tutti, no#
Quantizzare un modello vuol dire scriverne i numeri in un formato più compatto, per occupare meno memoria e girare più in fretta. K3 viene addestrato tenendone conto già dalla fase di fine-tuning supervisionato (in gergo quantization-aware training), con pesi in formato MXFP4 e attivazioni in MXFP8. Nonostante questo, per usarlo direttamente Moonshot consiglia supernodi con almeno 64 acceleratori. Tradotto: anche quando i pesi saranno pubblici, installarlo sui propri server resterà fuori portata per la grande maggioranza delle aziende, e per loro la strada concreta sarà l'API. Se tenere i dati in casa è un requisito, conviene ragionare su modelli più piccoli: ne parlo nella guida all'AI locale in azienda.
Il vero punto di forza: lavori di programmazione lunghi#
K3 non viene venduto come l'assistente che completa una funzione o corregge un errore. Moonshot lo racconta come un collega che affronta sessioni di ingegneria lunghe: apre il terminale, esplora progetti enormi, prova, guarda il risultato e corregge. Nel blog tecnico ci sono tre casi che rendono l'idea.
Kernel GPU ottimizzati in 24 ore#
La prova: quattro kernel, hardware diversi, un giorno intero di tempo per studiarli, riscriverli e misurarne la velocità. Secondo Moonshot, K3 se l'è giocata alla pari con i migliori modelli proprietari.
Un piccolo compilatore scritto dal modello#
K3 avrebbe costruito MiniTriton, un compilatore compatto ispirato a Triton: rappresentazione intermedia, passaggi di ottimizzazione, generazione di codice PTX. Su alcuni test, sempre secondo Moonshot, regge il confronto con Triton e torch.compile e riesce perfino a sostenere l'addestramento di nanoGPT.
Tra i materiali c'è un grafico roofline, il diagramma che mostra quanto un programma si avvicina al limite teorico della scheda su cui gira: riguarda i kernel generati con MiniTriton su una NVIDIA L20, e anche in questo caso i risultati li ha misurati Moonshot.
Una prova del genere incuriosisce, ma non basta a dire che MiniTriton possa sostituire gli strumenti usati in produzione. Per arrivarci servirebbero il codice sorgente, test che chiunque possa ripetere e verifiche su più famiglie di hardware.
Un chip progettato in 48 ore, in simulazione#
Il caso più spettacolare: in due giorni di lavoro K3 avrebbe disegnato un chip in grado di far girare una versione ridotta della sua stessa architettura, e l'avrebbe collaudato in simulazione. Gli attrezzi? Software di progettazione elettronica gratuito e la libreria di celle Nangate da 45 nanometri.
Risultato dichiarato | Valore |
|---|---|
Celle standard | 1,46 milioni |
Memoria SRAM | 0,277 MB |
Frequenza | 100 MHz |
Velocità in simulazione | oltre 8.700 token al secondo |
Il chip non è stato fabbricato né provato fisicamente. Il valore dell'esperimento è un altro: far vedere un agente che porta a termine un processo tecnico fatto di centinaia di decisioni e verifiche in fila.
Vede quello che produce: immagini e video#
Testo, immagini e video passano tutti dallo stesso modello, senza pezzi separati. Nelle demo guarda lo screenshot di ciò che ha appena costruito, modifica il codice e ricontrolla: Moonshot la chiama vision in the loop. È utile ovunque il risultato si giudica a occhio: interfacce web, videogiochi, CAD.
Sulla pagina ufficiale Moonshot ha messo otto demo, quasi tutte costruite attorno a videogiochi e scene in 3D. Conviene guardarle una per una, perché ognuna mette alla prova un'abilità diversa.
1. Un bosco da esplorare#
Una scena in terza persona: un personaggio che si guida con i comandi, in mezzo a un bosco con vegetazione e acqua. Qui si vede la capacità di mettere in piedi un ambiente in cui ci si può muovere davvero, e di rifinirlo a più riprese sistemando scena, controlli e resa grafica.
2. Una console portatile che funziona#
Un oggetto 3D a forma di console tascabile, sul cui schermo gira un gioco che ricorda Campo Minato. In una sola demo si sommano quattro lavori diversi: disegnare l'oggetto, costruire l'interfaccia, gestire i tasti e scrivere la logica del gioco che si vede sul display.
3. La macchina da scrivere#
Su uno sfondo scuro compare una macchina da scrivere con tasti, foglio e un pannello di comandi. La difficoltà sta nel far combaciare tre cose: la forma tridimensionale dell'oggetto, quello che succede quando si preme un tasto e i controlli laterali.
4. Il Colosseo a blocchi#
Un'arena in stile voxel, cioè fatta di cubetti come nei videogiochi a blocchi, con gradinate, personaggi e moltissimi oggetti di scena. Il punto qui è la quantità: generare un ambiente affollato e tenere in ordine tanti elementi visibili nello stesso momento.
5. Il picchiaduro spaziale#
Due combattenti si affrontano in uno scenario fantascientifico, con barre della salute, effetti speciali e una telecamera che segue l'azione. La demo mette insieme animazioni, collisioni, regole del combattimento e i segnali a schermo che dicono al giocatore cosa sta succedendo.
6. Il gioco di ruolo wuxia#
Il wuxia è il genere cinese dei cavalieri erranti e delle arti marziali. Il personaggio corre sui tetti di una città disegnata in quello stile, con indicatori e informazioni di gioco sovrapposti alla scena. Si vedono il movimento in 3D, la costruzione di un mondo coerente e il rispetto di una direzione artistica precisa.
7. L'arena dello sparatutto#
Uno sparatutto in prima persona in un'arena dai colori accesi: arma, mirino, mappa, contatore delle munizioni e avversari da affrontare. Qui si controllano i comandi, l'interfaccia, la logica degli scontri e soprattutto che l'azione resti leggibile mentre succede tutto in fretta.
8. Gargantua, il buco nero#
L'unica demo che non è un gioco: una simulazione scientifica di un buco nero supermassiccio, con i raggi di luce che si piegano vicino alla sfera fotonica. È anche la più lunga delle otto, e mostra il codice al servizio di una visualizzazione tecnica invece che dell'intrattenimento.
Due dettagli pratici per chi lo integra: i video si caricano come file e si passano al modello con un riferimento ms://; le immagini invece non si possono indicare con un link pubblico, vanno inviate in Base64 o caricate come file.
Un milione di token: cosa ci sta e cosa non garantisce#
Un milione di token vuol dire poter mettere nella stessa conversazione intere raccolte di contratti, un progetto software completo o mesi di corrispondenza. È una capacità vera, ma non è una promessa: il fatto che un'informazione entri nel contesto non vuol dire che il modello la ritrovi sempre con la stessa precisione.
Moonshot racconta casi di ricerca in finanza e in ambito scientifico in cui K3 avrebbe consultato migliaia di pagine, costruito visualizzazioni interattive e portato avanti più attività in parallelo. Il più curioso viene dall'astrofisica: per riprodurre le relazioni universali I-Love-Q, K3 avrebbe letto più di venti articoli scientifici, costruito una pipeline di calcolo numerico e analizzato oltre trecento equazioni di stato. Per il lavoro d'ufficio l'azienda ha pubblicato anche un grafico con tre test interni (Online Exp Bench, DECK-Bench e Finance-Bench), in cui K3 è messo accanto a GPT 5.5 e Claude Opus 4.8. I valori precisi stanno solo nell'immagine e, soprattutto, sono misure fatte in casa: non una valutazione indipendente.
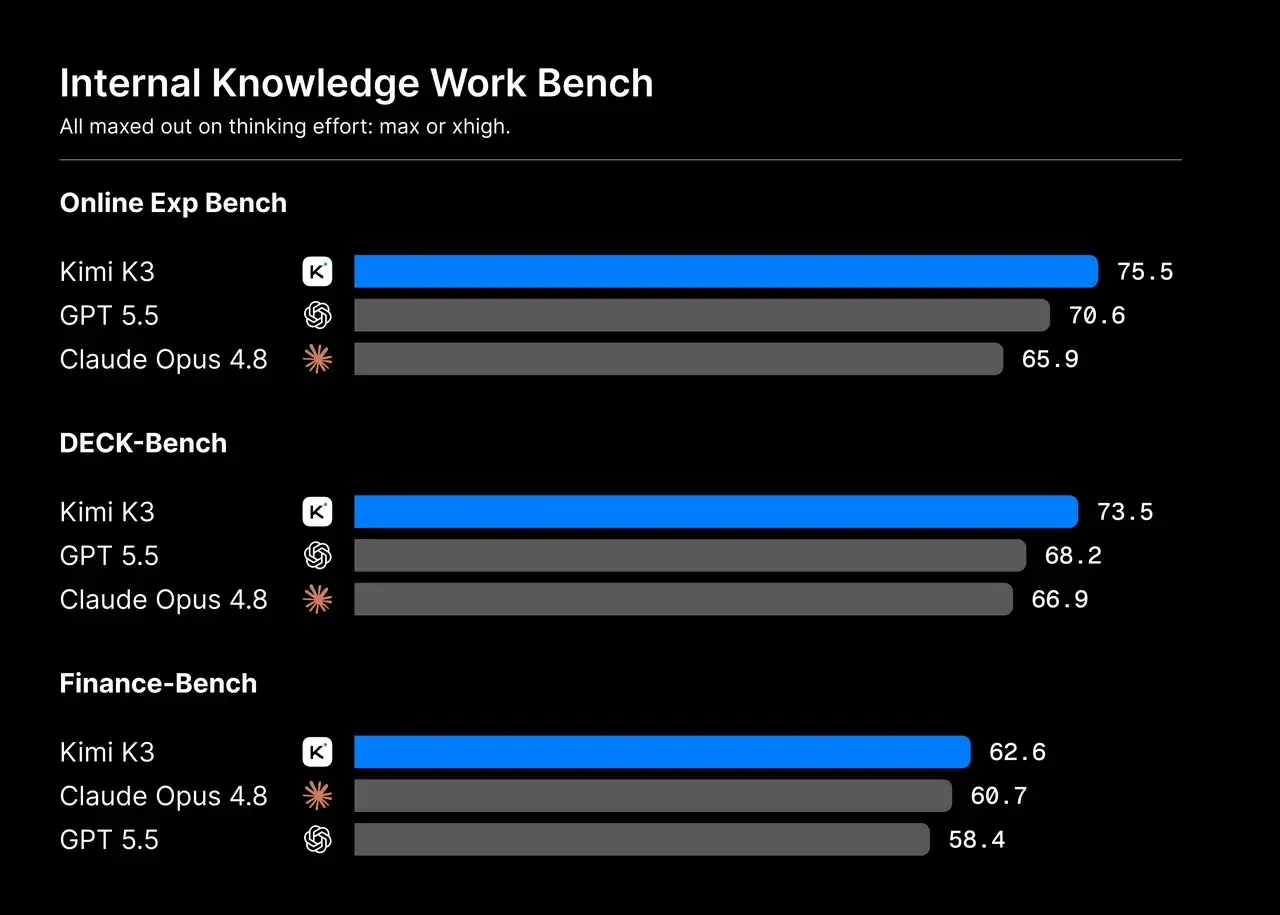
Questi casi servono a capire che tipo di lavoro Moonshot ha in mente per K3. Restano però esempi scelti dal produttore. Per fidarsi bisognerebbe poter rifare le prove: le richieste esatte, i registri delle sessioni, il codice prodotto e i criteri usati per giudicarlo.
Come leggere i benchmark#
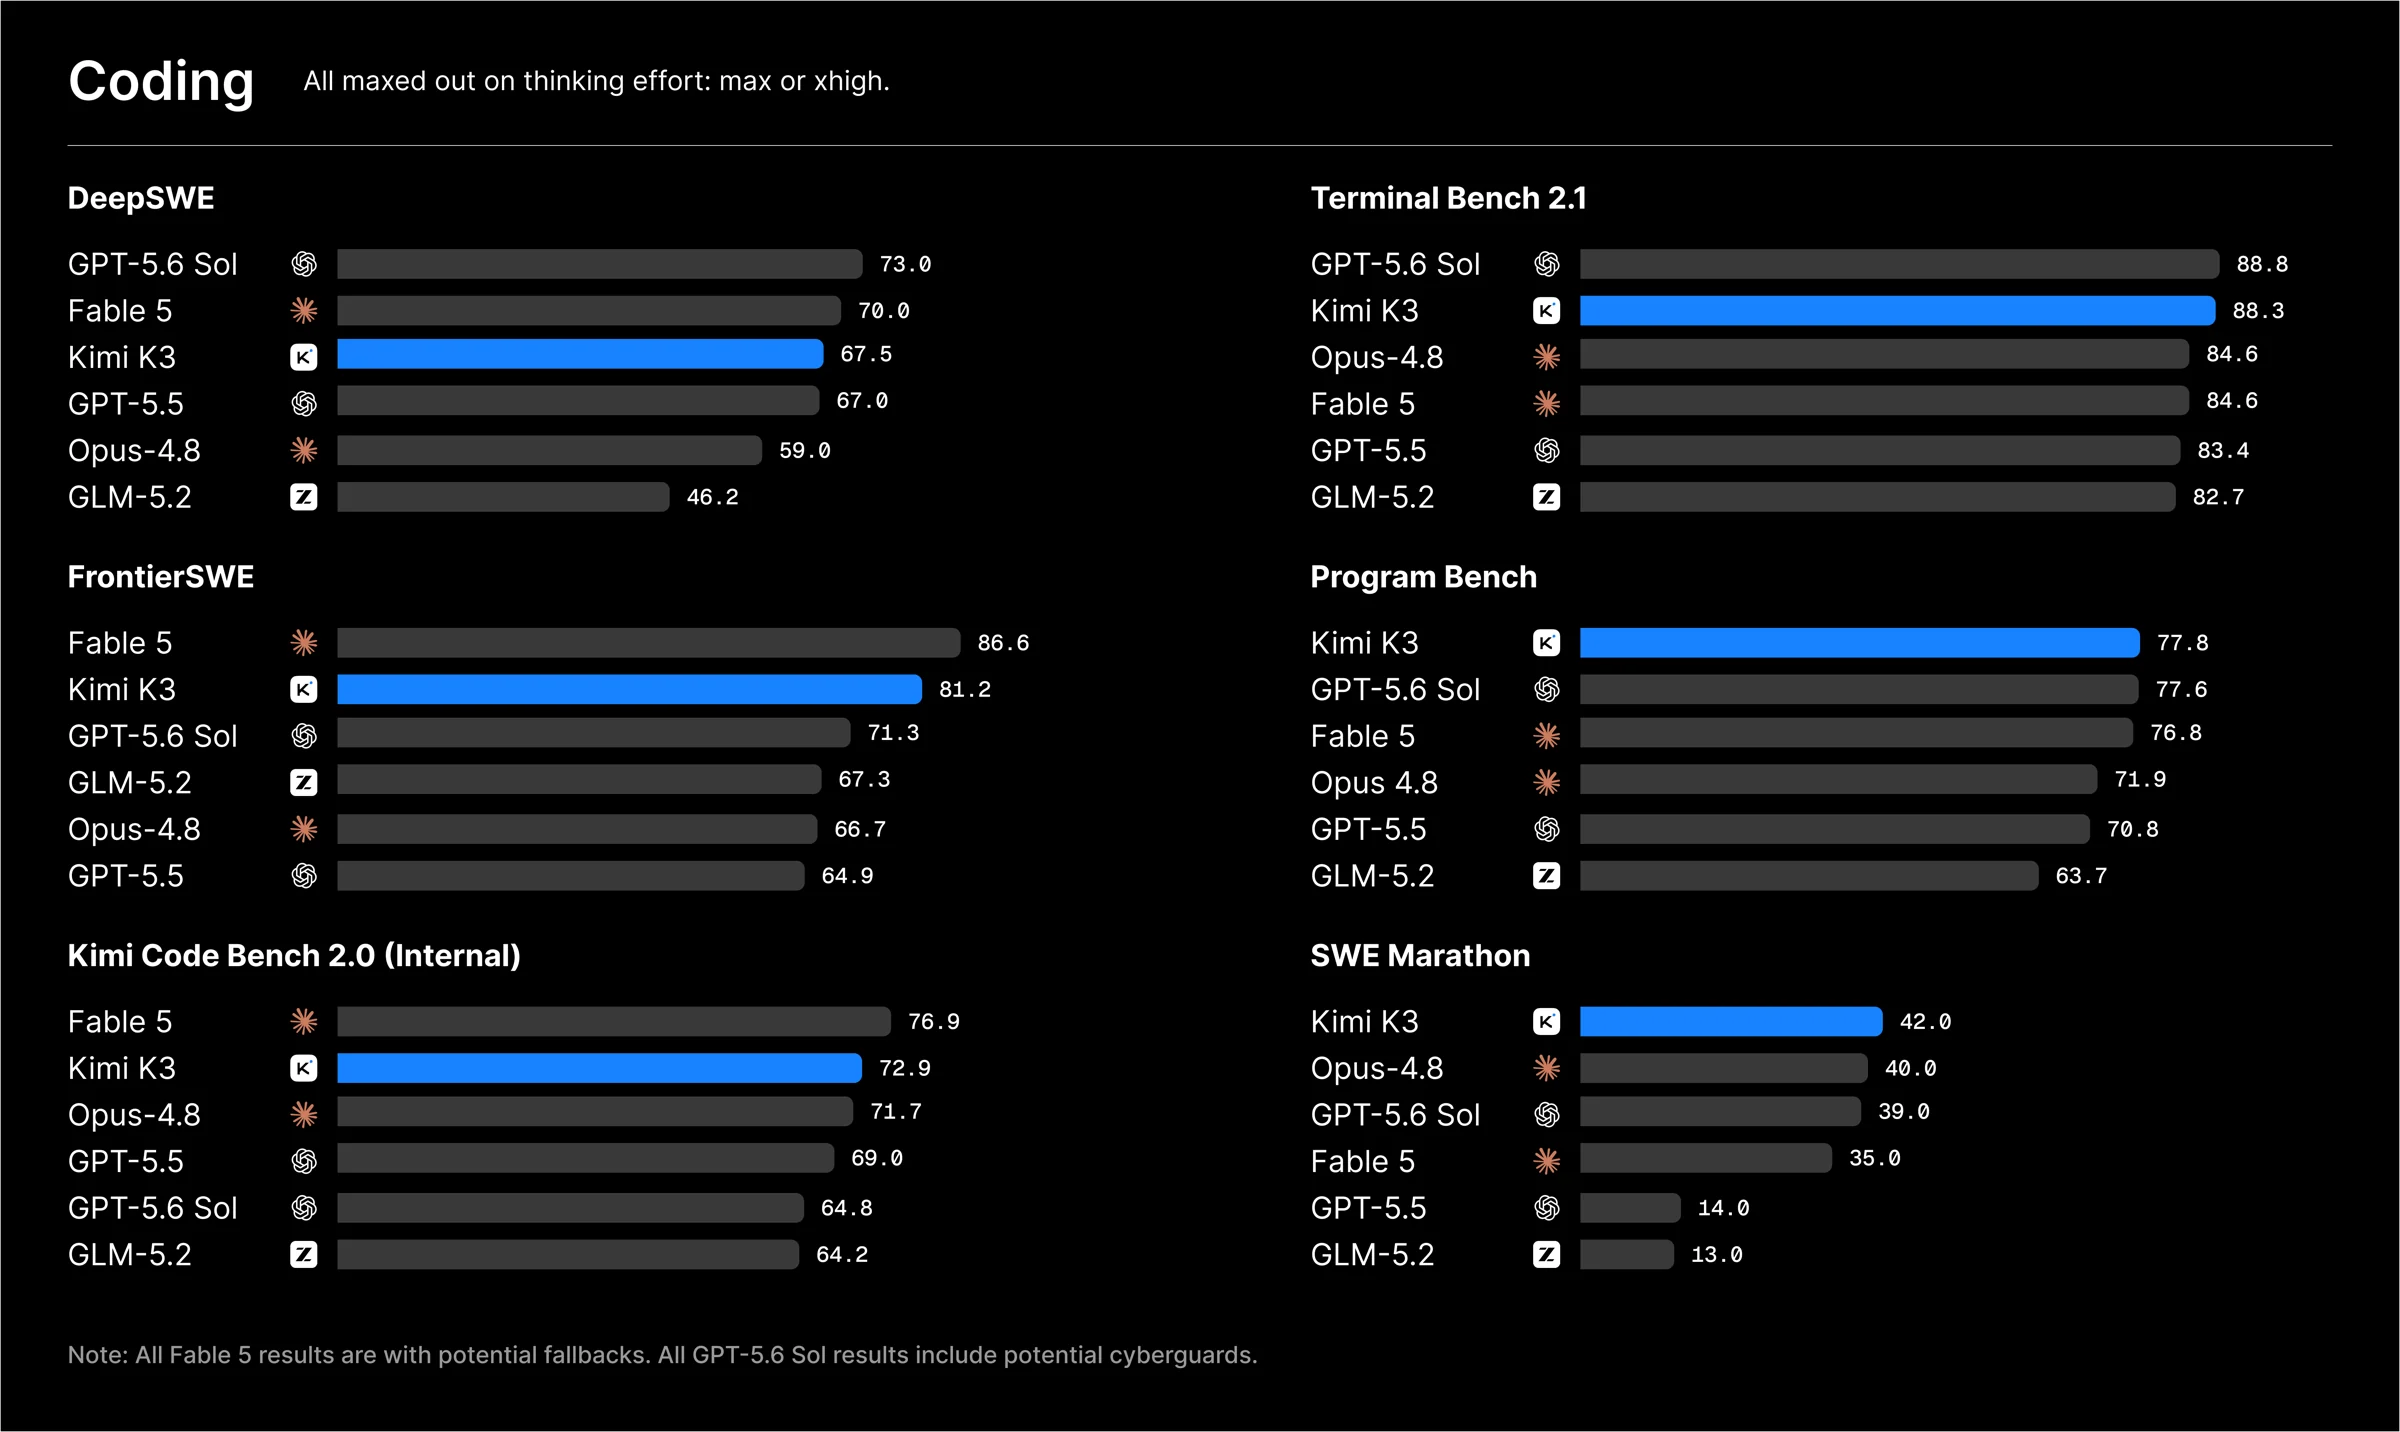
La tabella di lancio è lunghissima: programmazione, automazione, fogli di calcolo, ricerca sul web, comprensione visiva. Solo per la programmazione ci sono SWE Marathon, DeepSWE, FrontierSWE, Terminal Bench 2.1, Program Bench e il test di casa, Kimi Code Bench 2.0. Nella maggior parte delle prove K3 sta a ridosso dei modelli chiusi più forti; in alcune li sorpassa.
I grafici di lancio si dividono in due gruppi. Il primo riguarda la programmazione: le barre di K3 sono colorate di blu per farle risaltare, ma le condizioni di prova non sono identiche per tutti i modelli confrontati.
Il secondo gruppo copre gli agenti generici, l'automazione, i fogli di calcolo, BrowseComp (un test in cui bisogna scovare sul web informazioni difficili da trovare) e i compiti visivi. Moonshot accompagna tutto con note sul metodo, ed è lì che si capisce quanto pesare ogni numero.
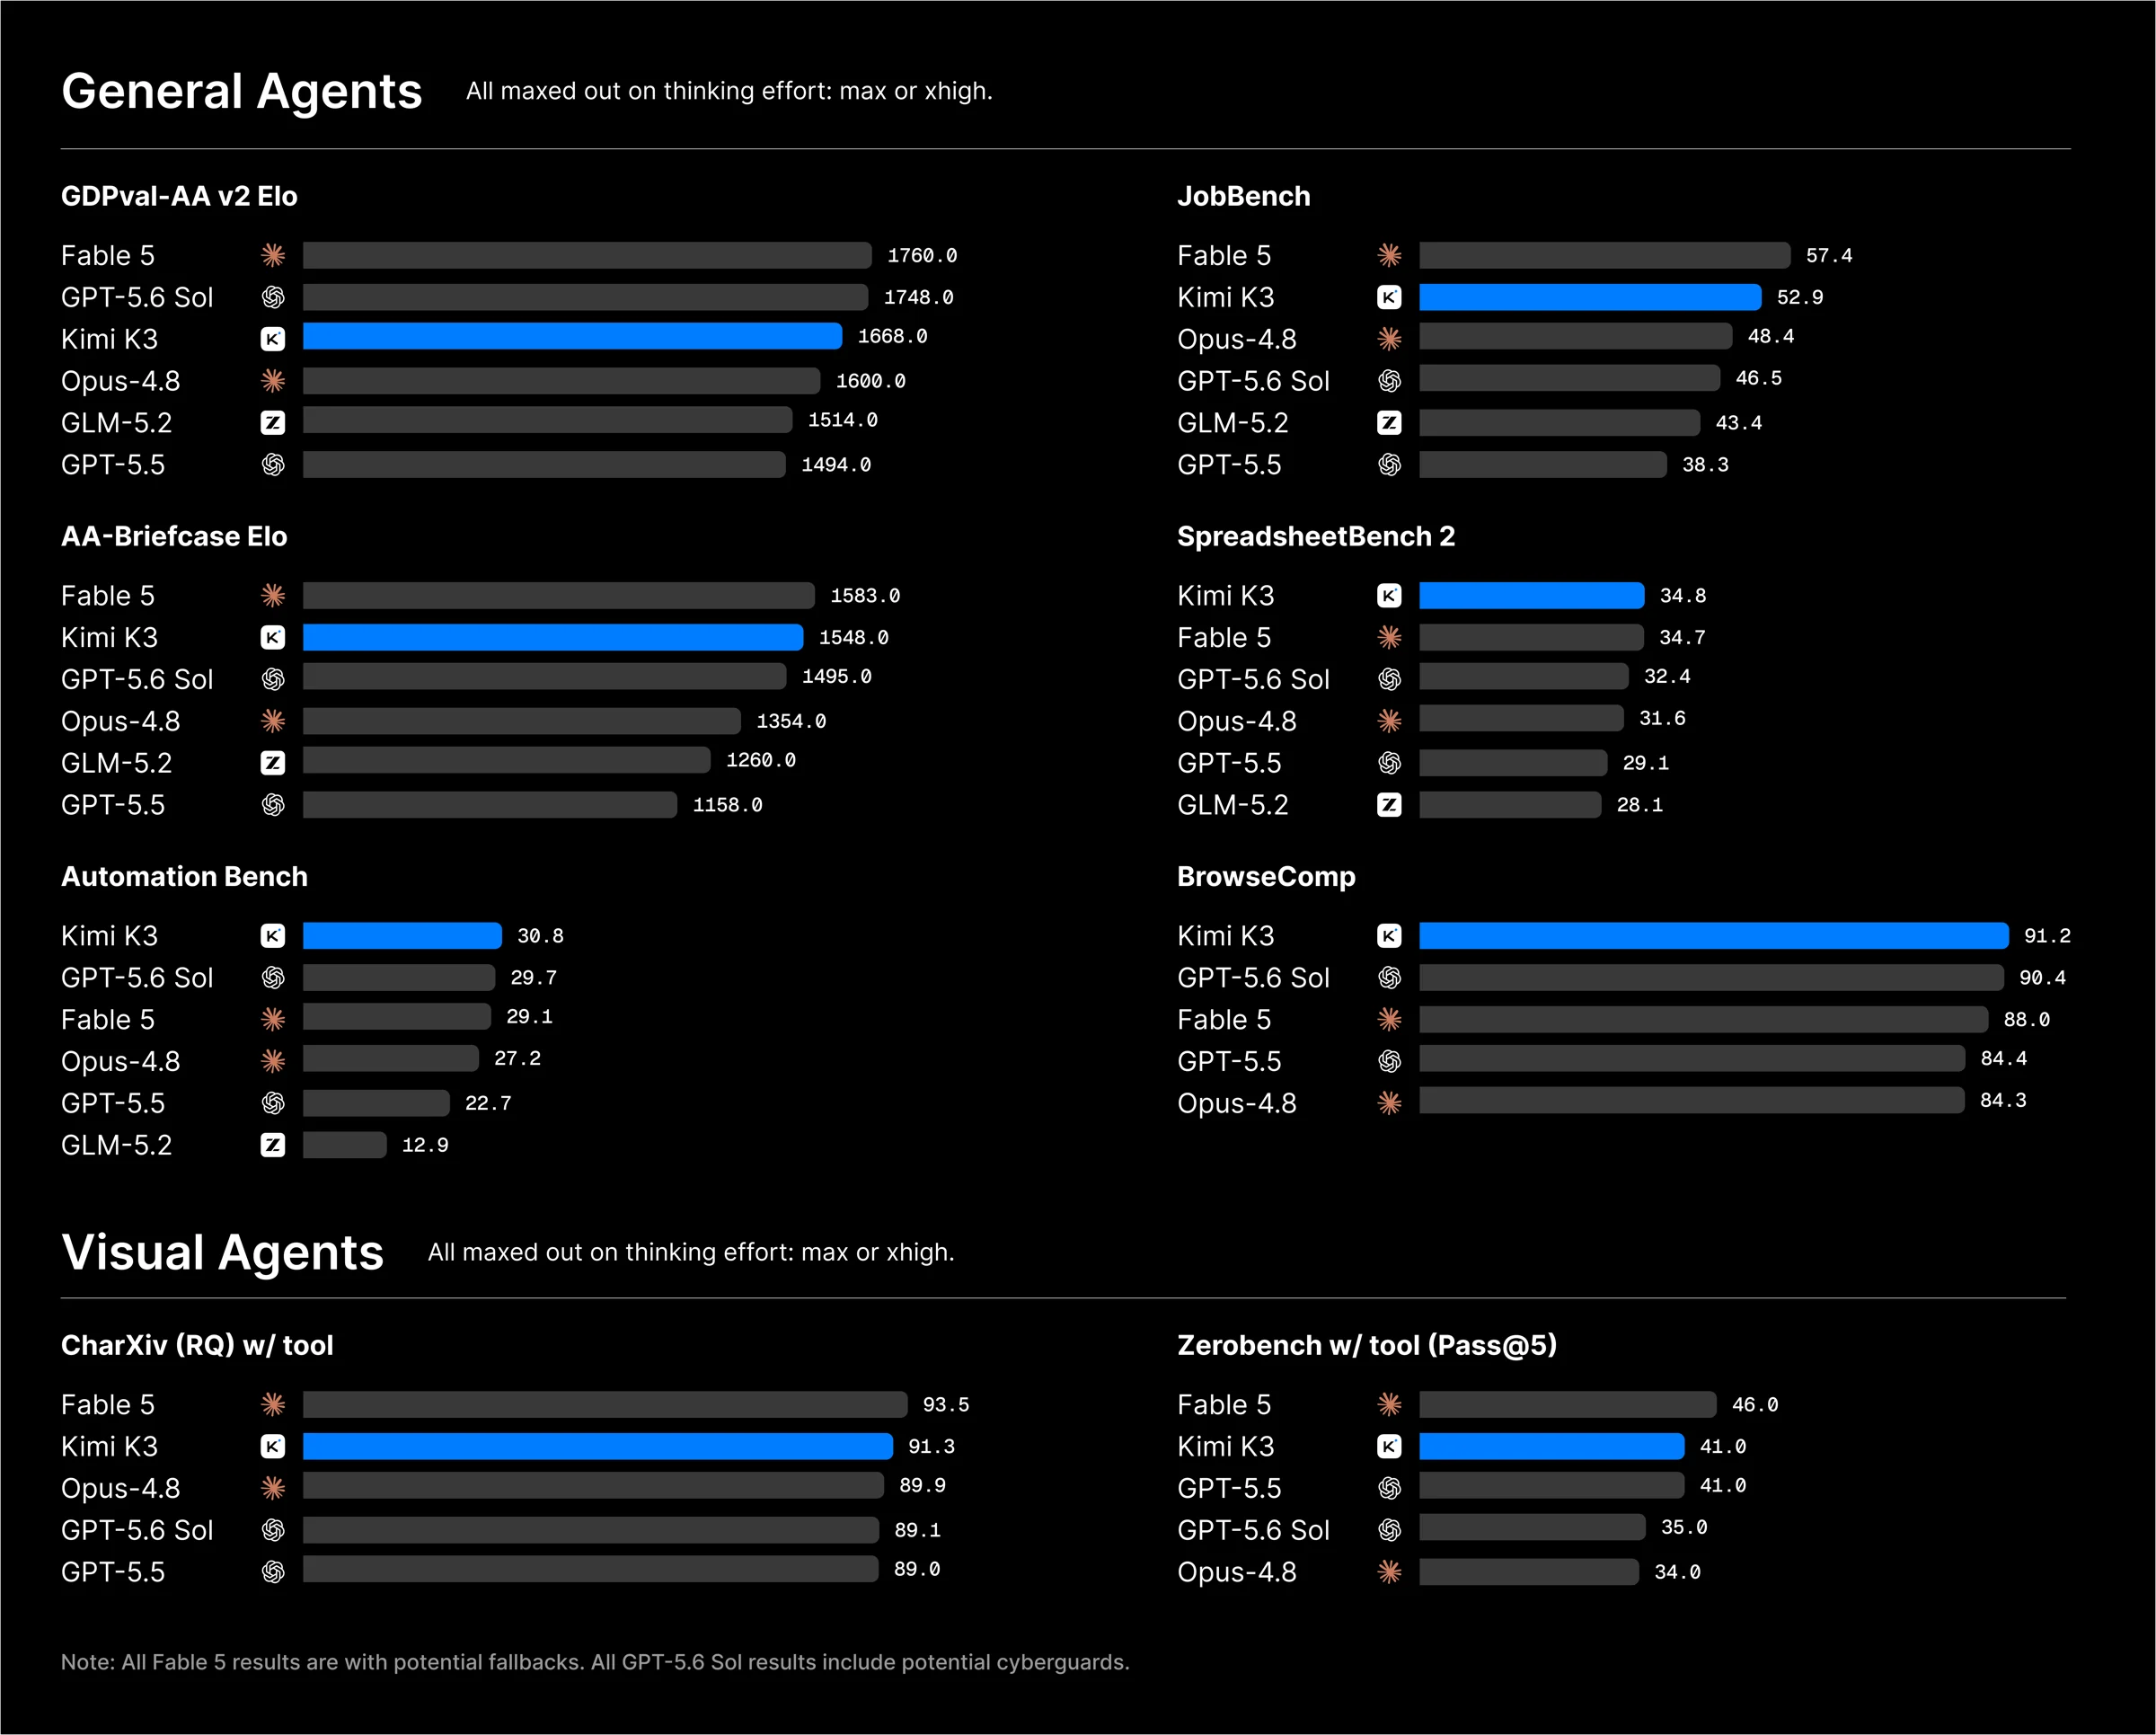
Il messaggio da portarsi a casa non è "K3 batte GPT e Claude". È più sfumato:
K3 è stato provato al livello di ragionamento più alto;
alcuni concorrenti girano in ambienti di prova diversi;
una parte dei test è interna a Moonshot;
molti punteggi dei concorrenti arrivano da fonti esterne;
ripieghi, limiti di sicurezza e hardware pesano sui risultati.
Anche la BBC cita valutazioni indipendenti che mettono K3 vicino ai principali modelli americani. È un buon segnale, non una certificazione. Per un'azienda la prova che conta di più resta quella fatta sui propri documenti e processi, con criteri di qualità decisi prima di cominciare.
Quanto rende per ogni dollaro speso#
Due grafici di Moonshot mettono sullo stesso piano il punteggio ottenuto e il costo stimato di ogni singola attività. Sono forse i più utili dell'annuncio, perché mostrano una cosa che le classifiche nascondono: la modalità di ragionamento scelta cambia sia il risultato sia la spesa.
Kimi Code Bench V2: K3 compare in tre modalità, low, high e max, accanto a GLM-5.2 e a diversi modelli Claude.
BrowseComp: qui le modalità di K3 sono medium, high e max, e il confronto è con modelli GPT e Claude.
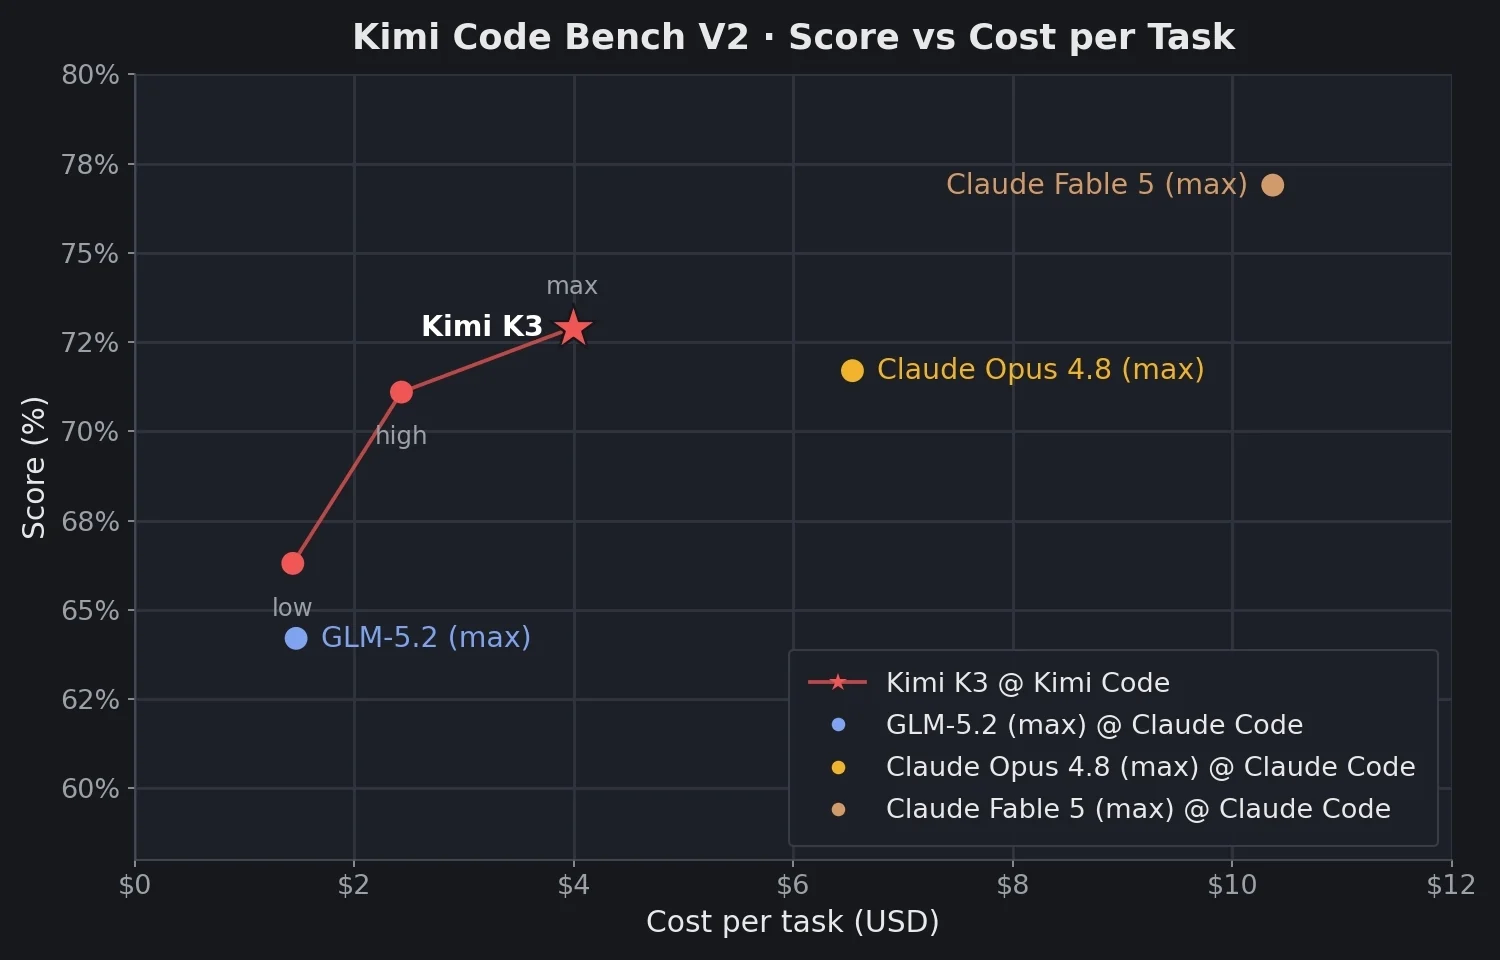
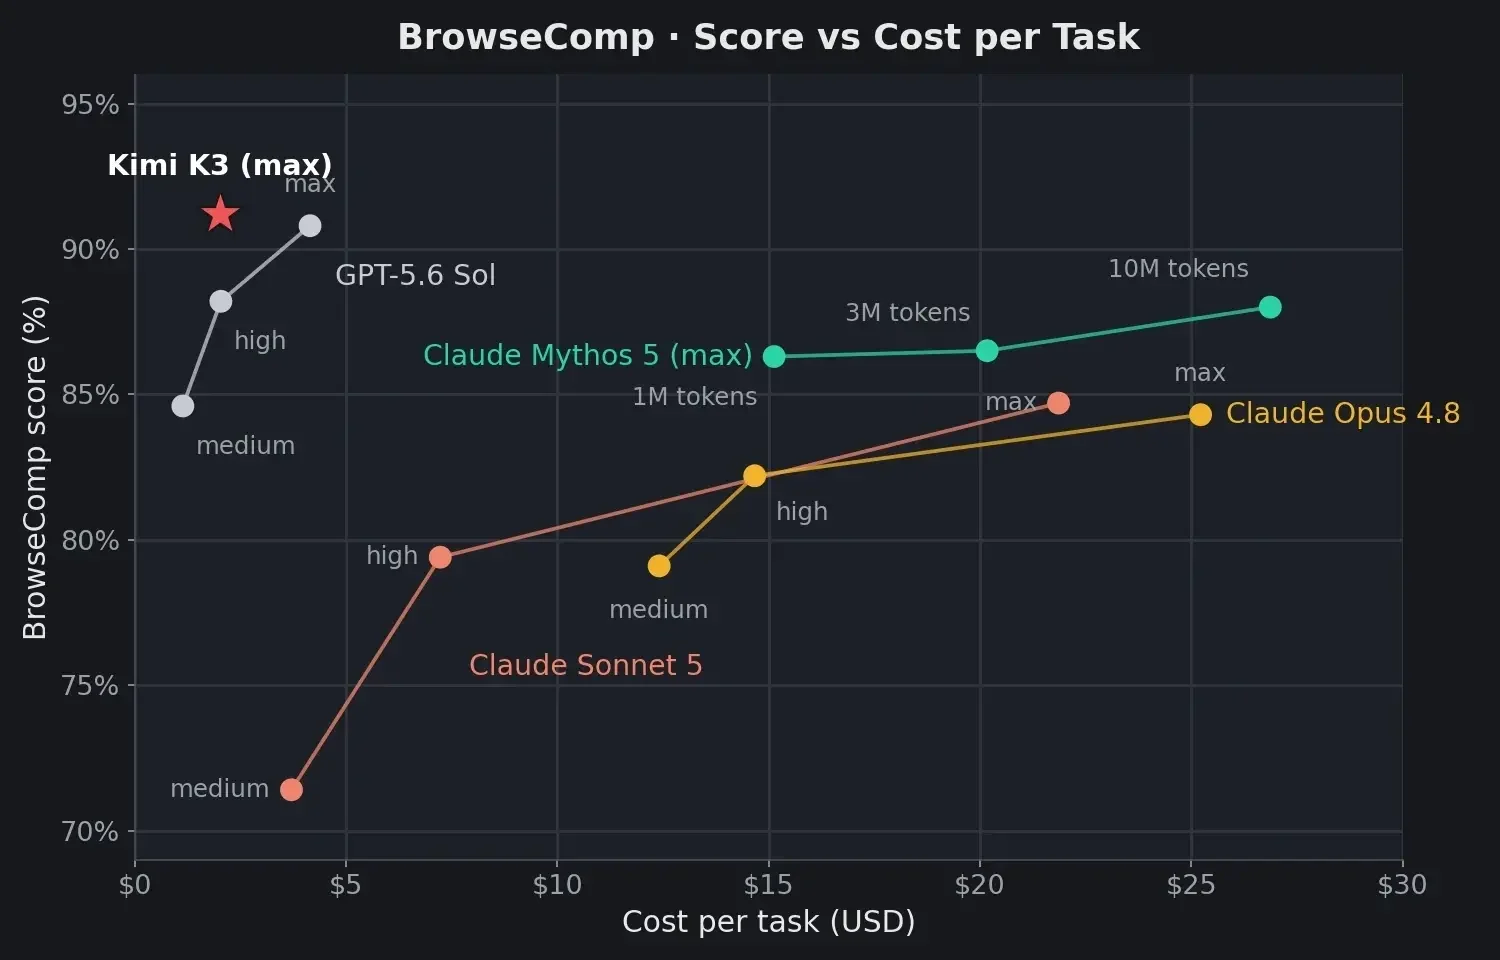
In entrambi i casi costi e punteggi dipendono da come Moonshot ha impostato la valutazione. Sono un buon modo di ragionare, non un preventivo: quanto costa davvero un risultato si scopre solo misurandolo sul proprio carico di lavoro.
Quanto costa usarlo#
Kimi K3 via API
Dollari per milione di token
Fonte: listino annunciato da Moonshot AI, luglio 2026
L'API è compatibile con l'SDK di OpenAI: per una prima prova cambiano solo tre cose.
from openai import OpenAI

client = OpenAI(
    api_key="LA_TUA_CHIAVE_MOONSHOT",   # 1. la chiave
    base_url="URL_DELLE_API_MOONSHOT",  # 2. l'indirizzo delle API
)
risposta = client.chat.completions.create(
    model="NOME_DEL_MODELLO_K3",        # 3. il nome del modello
    messages=[{"role": "user", "content": "Riassumi questo capitolato in 10 punti."}],
)
Attenzione però: stessa interfaccia non vuol dire stesso comportamento. Prompt che funzionano bene con un modello possono dare risultati diversi con un altro.
Un esempio di calcolo#
La cache si gestisce da sola, ed è lì che si risparmia: se il testo iniziale resta uguale (un archivio di documenti, un progetto software), dalla seconda domanda in poi si paga la tariffa ridotta. Un esempio con 200.000 token di documenti e cinque domande, ognuna con una risposta da 2.000 token:
Cinque domande su 200.000 token
Costo in dollari, risposte da 2.000 token
- Senza cache
- Con la cache
Fonte: mio calcolo sul listino Moonshot AI, luglio 2026
È un caso ideale, con la cache che funziona sempre. Nella realtà va misurato quante richieste la sfruttano davvero, prima di metterlo nel preventivo.
Quando ha senso provarlo in azienda#
K3 merita una prova quando il lavoro richiede di:
leggere e confrontare grandi quantità di documenti;
intervenire su progetti software estesi;
unire codice e controllo visivo del risultato;
far lavorare un agente per molti passaggi di fila;
gestire immagini o video in ingresso;
restituire dati strutturati secondo uno schema JSON.
Per una PMI italiana il vantaggio non sta nei trilioni di parametri. Sta nel risparmiare tempo su un processo preciso: analizzare un capitolato, controllare documentazione tecnica, mantenere un gestionale, produrre report che si possono verificare.
Prima di adottarlo, poi, ci sono domande che non riguardano la tecnologia: dove finiscono i dati, dove girano i server, cosa dice il contratto, quanto è garantita la continuità del servizio, come si registrano e si controllano le azioni dell'agente. Moonshot stessa lo descrive come molto intraprendente: un pregio nei compiti lunghi, un rischio se i confini non sono scritti nero su bianco.
I limiti che Moonshot stessa ammette#
La memoria del ragionamento. K3 è addestrato per ricevere di nuovo tutta la cronologia del proprio ragionamento. Se il sistema che lo usa taglia dei pezzi di quella cronologia, o passa a un altro modello nel mezzo del lavoro, i risultati diventano altalenanti.
Troppa iniziativa. Davanti a una richiesta ambigua, può prendere decisioni che nessuno gli ha chiesto. In azienda servono permessi chiari, strumenti consentiti, condizioni di arresto e passaggi che richiedono l'approvazione di una persona.
L'esperienza d'uso. Moonshot riconosce di essere ancora dietro ai migliori modelli proprietari: buoni punteggi non significano automaticamente risposte più chiare, più prevedibili o più facili da controllare.
A questi si aggiunge un punto provvisorio ma decisivo: pesi completi e documentazione tecnica definitiva erano attesi per il 27 luglio. Licenza, requisiti per l'installazione e riproducibilità dei risultati si potranno giudicare solo dopo il rilascio vero.
Il mio parere#
Tra i lanci di quest'estate, K3 è uno di quelli che guarderei con più attenzione se costruissi agenti o sistemi che devono lavorare su montagne di testo. Architettura, vista e tenuta nei lavori lunghi sono le tre cose da tenere d'occhio.
Però non cambierei il modello di un sistema che già funziona solo perché lo dicono i grafici di chi lo vende. Il metodo che uso è sempre lo stesso: preparare un piccolo insieme di attività vere, farle eseguire a K3 e al modello che si usa oggi, e misurare quattro cose. Qualità del risultato, costo, tempo di risposta e quante volte una persona deve intervenire. Solo a quel punto il confronto serve a decidere.
Se volete fare questa prova sui vostri documenti, la imposto con voi: metriche e controlli si decidono prima di cominciare.
Domande frequenti#
Kimi K3 è già open source?
Non ancora, al momento dell'annuncio. Moonshot lo presenta come un modello aperto e ha promesso di pubblicare tutti i pesi entro il 27 luglio 2026, ma pesi e licenza non c'erano: per chiamarlo open source bisogna aspettare il rilascio vero e leggere le condizioni.
Quanti parametri usa per ogni risposta?
In totale ne ha 2,8 trilioni, ma essendo un Mixture of Experts ne attiva solo una parte: 16 esperti su 896 per ogni passaggio, secondo Moonshot.
Quanto è grande la finestra di contesto?
Un milione di token dichiarati, e il modello può anche scrivere risposte molto lunghe. Qualità, costi e tempi di risposta però dipendono da quanto testo si carica davvero e da come lo si interroga.
Legge immagini e video?
Sì, in modo nativo. Le API accettano immagini (in Base64 o come file) e file video caricati sulla piattaforma.
Quanto costa usarlo via API?
3 $ per milione di token in ingresso, che scendono a 0,30 $ quando il testo è già in cache, e 15 $ per milione di token generati. La cache si attiva da sola, ma quanto si risparmia davvero va misurato sulle proprie richieste.
Si può installare sui propri server?
In teoria sì, dopo il rilascio dei pesi. In pratica Moonshot consiglia supernodi con almeno 64 acceleratori: per quasi tutte le aziende l'API resta la strada praticabile.
Il mio verdetto
Kimi K3 è tra i lanci più ambiziosi di questa stagione di modelli pensati per gli agenti. Contesto lunghissimo, lettura di immagini e video e sessioni di programmazione che durano ore ne fanno un candidato serio per prove impegnative; la decisione di adottarlo, però, va presa solo dopo verifiche indipendenti e test sui processi veri dell'azienda.
Cosa mi convince
- Un milione di token di contesto dichiarati: ci stanno archivi di documenti e progetti software interi
- Legge testo, immagini e video con un solo modello
- Costruito per programmare e lavorare in autonomia per molte ore di fila
- API compatibile con l'SDK di OpenAI e listino competitivo
Cosa non mi convince
- Benchmark e casi d'uso arrivano quasi tutti da Moonshot
- Al lancio pesi e licenza definitiva non erano ancora pubblici
- Per installarlo in proprio servono almeno 64 acceleratori
- È Moonshot stessa ad ammettere troppa iniziativa e dipendenza dalla cronologia del ragionamento
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
4- 1.Moonshot AI — Kimi K3: Open Frontier Intelligence, blog tecnico di lanciokimi.com
Da qui arriva quasi ogni numero dell'articolo; dove manca una verifica indipendente, lo segnalo nel testo.
- 2.Kimi API Platform — guida introduttiva a Kimi K3platform.kimi.ai
- 3.
- 4.VentureBeat — analisi del lancio di Kimi K3venturebeat.com
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.