Meta entra nella sfida degli agenti di programmazione con una CLI in beta per macOS e Linux. Come funziona il runtime, cosa dicono davvero i benchmark, quanto costa e quali limiti ha.
Muse Code è la CLI in beta di Meta: agenti in parallelo, ripresa dopo i crash e Muse Spark 1.2 con 1M di token. Benchmark, prezzi e limiti da conoscere.
di Andrea Pirazzini
Fonte primaria
Meta AI Research — la presentazione di Muse Code e Muse Spark 1.2
research.meta.ai
Versione audio
2 min 10 s
Perché se ne parla#
Il 5 agosto 2026 Meta ha presentato Muse Code, un agente di programmazione che si usa dal terminale, in beta per macOS e Linux. Sotto c'è un modello nuovo, Muse Spark 1.2, con un milione di token di contesto e, secondo Meta, addestrato insieme all'agente stesso.
La cosa interessante è che Meta non punta tutto sulla bravura del modello. Muse Code è costruito attorno a un runtime persistente, cioè al "motore" che tiene in piedi il lavoro: salva in locale tutto quello che succede, fa lavorare altri agenti in background e sa riprendere un compito dopo un riavvio.
Il lancio conta per tre motivi:
tecnico: crash, lavoro in parallelo e memoria delle operazioni sono trattati come problemi del prodotto, non come dettagli lasciati al modello;
economico: nel piano Standard un milione di token costa 1,25 dollari in ingresso e 4,25 in uscita, e c'è un piano Contributor molto più economico, in cambio dei dati;
strategico: dopo Muse Spark 1.1, che era un modello da usare via API, Meta offre un'esperienza completa e sfida apertamente Claude Code, Codex e il resto degli agenti che lavorano nel terminale.
token di contesto di Muse Spark 1.2
su Terminal-Bench 2.1, secondo posto dietro Opus 5
per milione di token in input, piano Standard
per milione di token in input, piano Contributor
La scheda#
Voce | Cosa dichiara Meta |
|---|---|
Prodotto | Muse Code, agente da riga di comando in beta |
Sistemi supportati | macOS e Linux; Windows non c'è |
Modello | Muse Spark 1.2, un milione di token di contesto |
Dove si usa il modello | Meta Model API; OpenRouter secondo la scheda ufficiale |
Prezzi | A consumo, piani Standard e Contributor (dettagli più sotto) |
Pesi aperti | Non annunciati |
Cos'è Muse Code, in pratica#
Non è un editor e non è il completamento automatico che suggerisce la riga successiva. È un agente che lavora nel terminale: legge il repository, decide cosa cambiare, scrive i file, lancia comandi e test, controlla com'è andata e continua finché ritiene raggiunto l'obiettivo.
Per installarlo Meta indica un solo comando:
curl -fsSL https://dev.meta.ai/install.sh | bashLe pagine ufficiali parlano di macOS e Linux; Windows non compare tra i sistemi del lancio. E trattandosi di una beta, l'accesso può dipendere dall'account e dai tempi di distribuzione.
Il metro giusto per giudicarlo quindi non è quante righe di codice produce, ma quanto bene regge un lavoro intero fatto di esplorazione, esecuzione, controllo e correzione. È lì che Meta ha messo le novità più concrete.
Un motore pensato per non perdere il lavoro#
Il registro degli eventi#
Il cuore del sistema è un registro locale in sola aggiunta (append-only event log): un diario in cui si scrive sempre in fondo e non si cancella mai. Muse Code non si limita a conservare la chat: annota eventi strutturati come le richieste al modello, le chiamate agli strumenti, i risultati, le modifiche ai file e l'avanzamento dell'agente. Meta lo chiama restart-safe: se il programma si blocca o il computer si riavvia, lo stato viene ricostruito rileggendo quel diario.
Sembra un dettaglio, non lo è. Basta poco per fermare un lavoro lungo: la CLI che va in errore, la connessione che cade, il computer che si riavvia. Se lo stato vive solo nella memoria del programma, contesto e intenzioni vanno ricostruiti da capo; con il diario si vede cosa è successo e ripartire costa meno. Non tutto andrà sempre liscio, ma la continuità è progettata, non sperata.
Anche l'interfaccia va in questa direzione: nella demo ufficiale l'agente mostra stati come reviewing e building, per distinguere il lavoro che avanza dal semplice testo che scorre.
Più agenti in parallelo, ognuno nella sua copia#
Muse Code può avviare agenti asincroni persistenti che lavorano in background. Le guide ufficiali spiegano anche come usare i git worktree: copie di lavoro separate dello stesso repository, così più attività possono modificare file senza calpestarsi a vicenda nella stessa cartella.
Un flusso verosimile: l'agente principale fa un piano, affida ricerca, scrittura del codice e verifica a processi diversi, ciascuno nella sua copia del repository, e alla fine rimette insieme i pezzi. Tenerli separati non cancella conflitti ed errori di logica, ma è molto più governabile di quattro agenti che scrivono sugli stessi file nello stesso istante.
Nella demo di Meta una richiesta viene divisa tra quattro ruoli, researcher, planner, coder e verifier, che passano da queued a done prima dell'unione finale. È la rappresentazione di uno schema (dividere il lavoro e poi ricomporlo), e non significa che quattro agenti siano la dose giusta per qualsiasi progetto.
Tre comandi per il lavoro di tutti i giorni#
Sono documentate tre skill integrate:
/planscrive un piano di implementazione prima di toccare il codice;/grillmette quel piano sotto torchio con una revisione critica;/goaltiene in vista l'obiettivo mentre l'agente lavora.
La sequenza ha senso: pianificare, contestare la strategia, non perdere di vista cosa significa "fatto". Non sostituisce però la revisione di una persona, soprattutto su sicurezza, migrazioni, permessi e logica che tocca soldi.
Due demo da prendere per quello che sono#
In una demo Muse Code parte da un video di riferimento, genera i file necessari e chiude con una landing page visualizzata nel browser: utile per capire che il sistema lavora anche su input visivi. In un'altra costruisce Embervault, un piccolo gioco isometrico che si vede girare, per mostrare che sa coordinare logica, interfaccia e grafica fino a un risultato interattivo e non solo a una patch di codice.
Sono esempi scelti dal produttore. Qualità del codice, accessibilità e manutenibilità vanno comunque verificate con una revisione del repository.
Muse Spark 1.2: modello e agente cresciuti insieme#
Per Meta, Muse Spark 1.2 è una versione pensata soprattutto per programmare, che però non rinuncia a essere un agente generalista. Legge fino a un milione di token e si usa dalla Meta Model API, oltre che (dice la scheda ufficiale) da OpenRouter. Ma la differenza che Meta rivendica è un'altra: modello e agente sono nati insieme.
I meccanismi descritti sono due:
Co-addestramento. Le sessioni registrate nell'ambiente di lavoro dell'agente, con l'uso di strumenti, obiettivi, compattazione del contesto e subagenti, servono ad allineare il modello all'ambiente in cui dovrà operare.
Auto-miglioramento. Muse Spark 1.1 ha generato ambienti di programmazione e modelli di esercizi per seguire istruzioni; le soluzioni proposte e i relativi voti hanno prodotto i segnali per il giro successivo. Le fonti non dicono che ogni passaggio di questa seconda catena sia avvenuto dentro Muse Code.
L'idea regge: un modello può ragionare benissimo in astratto e inciampare quando deve usare terminale, editor e test per decine di passaggi, e allenarlo dentro quel ciclo dovrebbe rendere più coerenti pianificazione e uso degli strumenti. Ma descrizione e risultati vengono da Meta, e nelle fonti manca uno studio indipendente che misuri quanto del miglioramento dipenda davvero dal co-addestramento.
I benchmark di programmazione: vicino, ma Opus 5 resta davanti#
Meta ha pubblicato una metodologia di tre pagine, e conviene leggerla prima dei grafici. Su Terminal-Bench 2.1 e DeepSWE 1.1 ogni modello ha lavorato dentro il suo agente: Muse Code per Muse Spark 1.2, Claude Code per Opus, Codex per GPT, Grok Build per Grok, Antigravity per Gemini e mini-swe-agent per Muse Spark 1.1. Non si confrontano quindi i soli modelli, e l'ambiente di prova non è lo stesso per tutti.
Terminal-Bench 2.1#
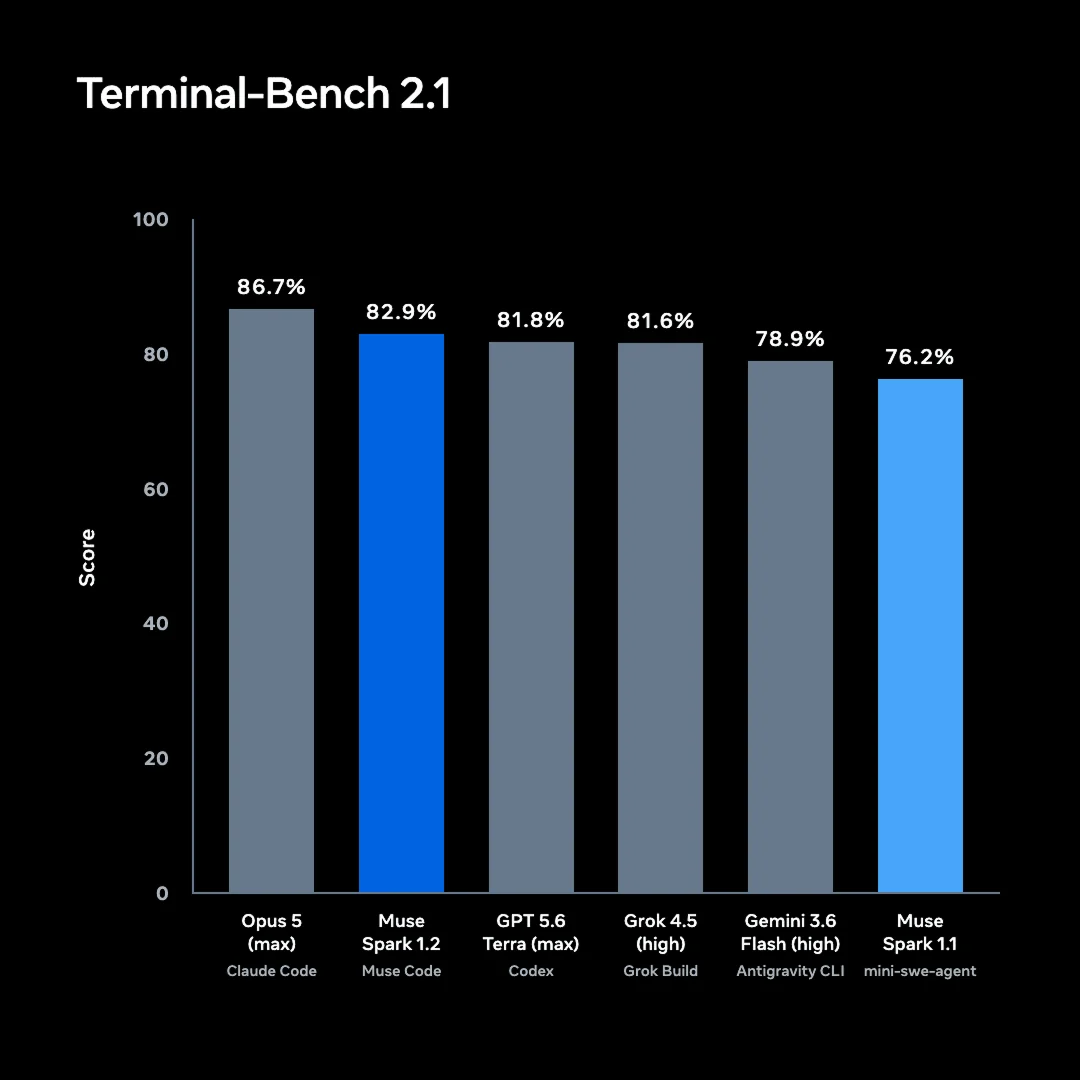
Qui Muse Spark 1.2 arriva all'82,9%: dietro Opus 5 con Claude Code, davanti a GPT-5.6 Terra con Codex, a Grok 4.5 e a Gemini 3.6 Flash. La prova comprende 89 compiti, ognuno tentato cinque volte, e il valore riportato è la media pass@1 (la percentuale di compiti risolti al primo colpo).
Terminal-Bench 2.1
Compiti risolti, media pass@1 su 5 tentativi; ogni modello con il proprio agente
Fonte: dichiarato da Meta, agosto 2026
DeepSWE 1.1 e il test interno di Meta#
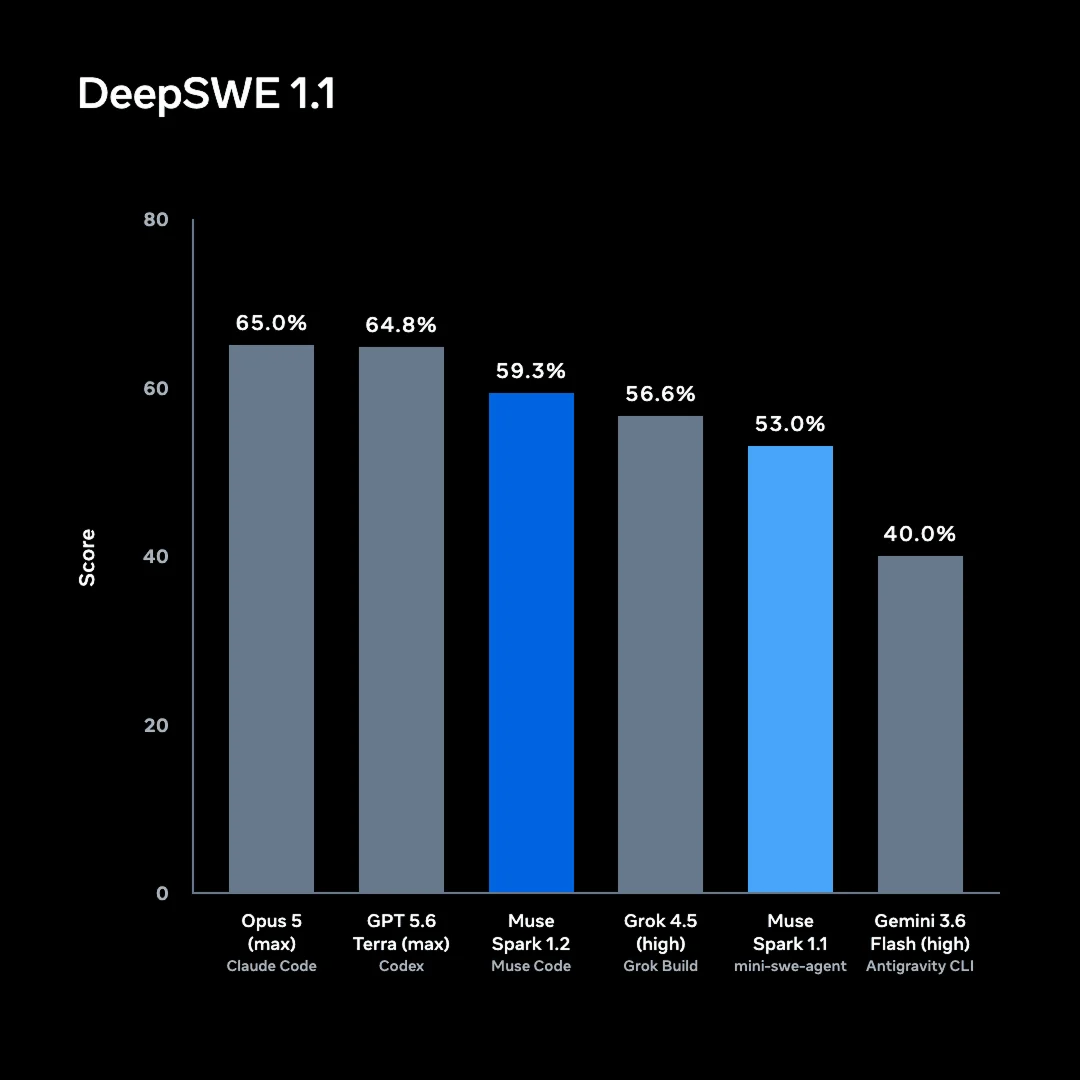
Su DeepSWE 1.1 Muse Spark 1.2 è terzo con il 59,3%, dietro Opus 5 (65,0%) e GPT-5.6 Terra (64,8%). Meta ha usato 113 compiti presi da 91 repository in cinque linguaggi, con internet bloccato sia durante l'esecuzione sia durante la correzione. Attenzione: nella classifica ufficiale di DeepSWE tutti i modelli girano nello stesso agente, mini-swe-agent, mentre nel confronto di Meta ognuno usa il prodotto della propria azienda, come ammette il rapporto stesso.
Nel Meta Internal Coding Bench Muse Spark 1.2 risolve il 70,6% dei compiti contro il 79,4% di Opus 5. Sono 440 compiti ricavati da pull request interne di Meta, con due tentativi ciascuno; codice, casi di prova e verificatori non sono pubblici. Dice qualcosa sul lavoro dentro i progetti di Meta, ma nessuno fuori può rifarlo.
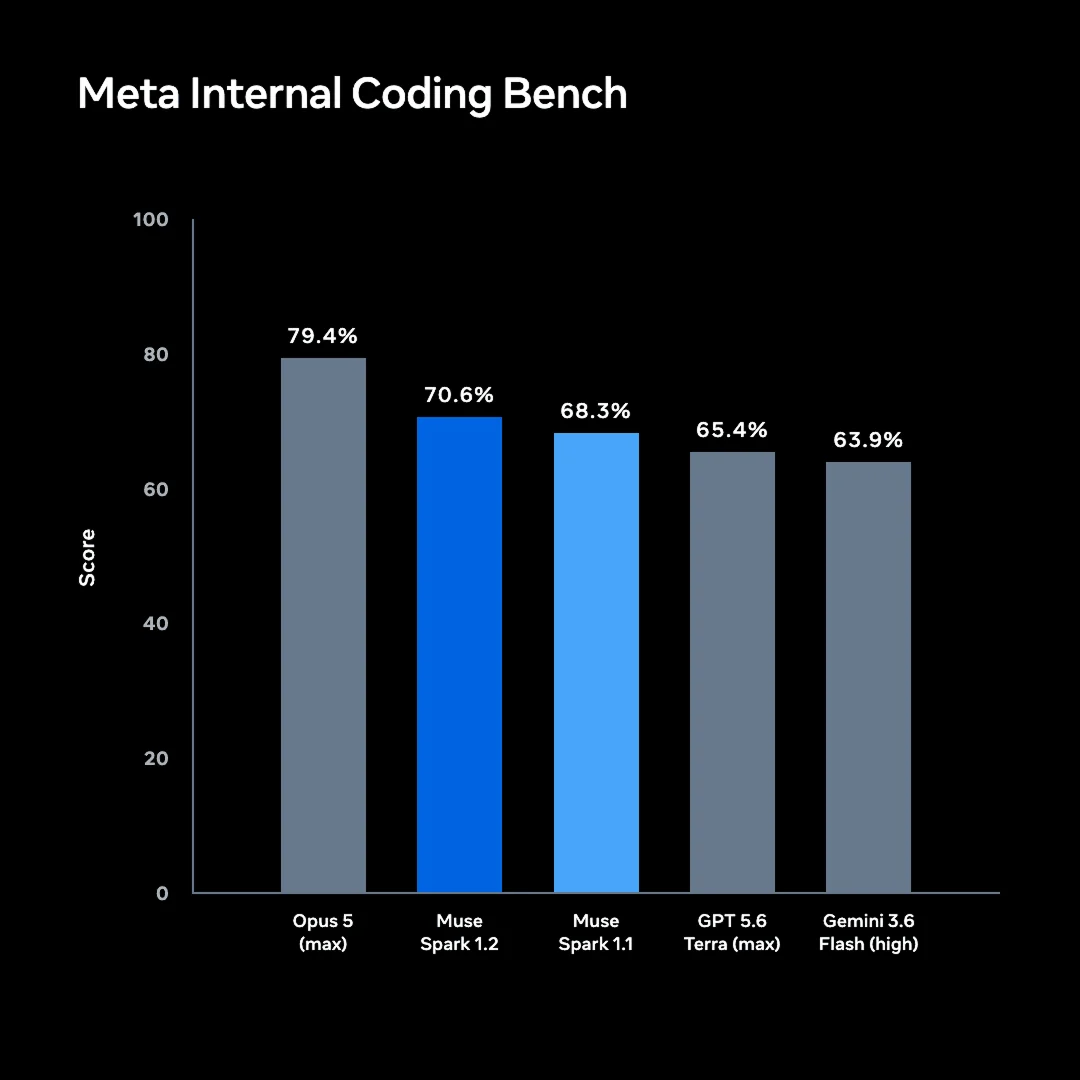
DeepSWE 1.1 e test interno Meta
Percentuale di compiti risolti
- Muse Spark 1.2
- Claude Opus 5
- GPT-5.6 Terra
Fonte: dichiarato da Meta, agosto 2026
Fuori dalla programmazione: GDPVal e MCP Atlas#
Muse Spark 1.2 viene presentato anche come modello generalista.
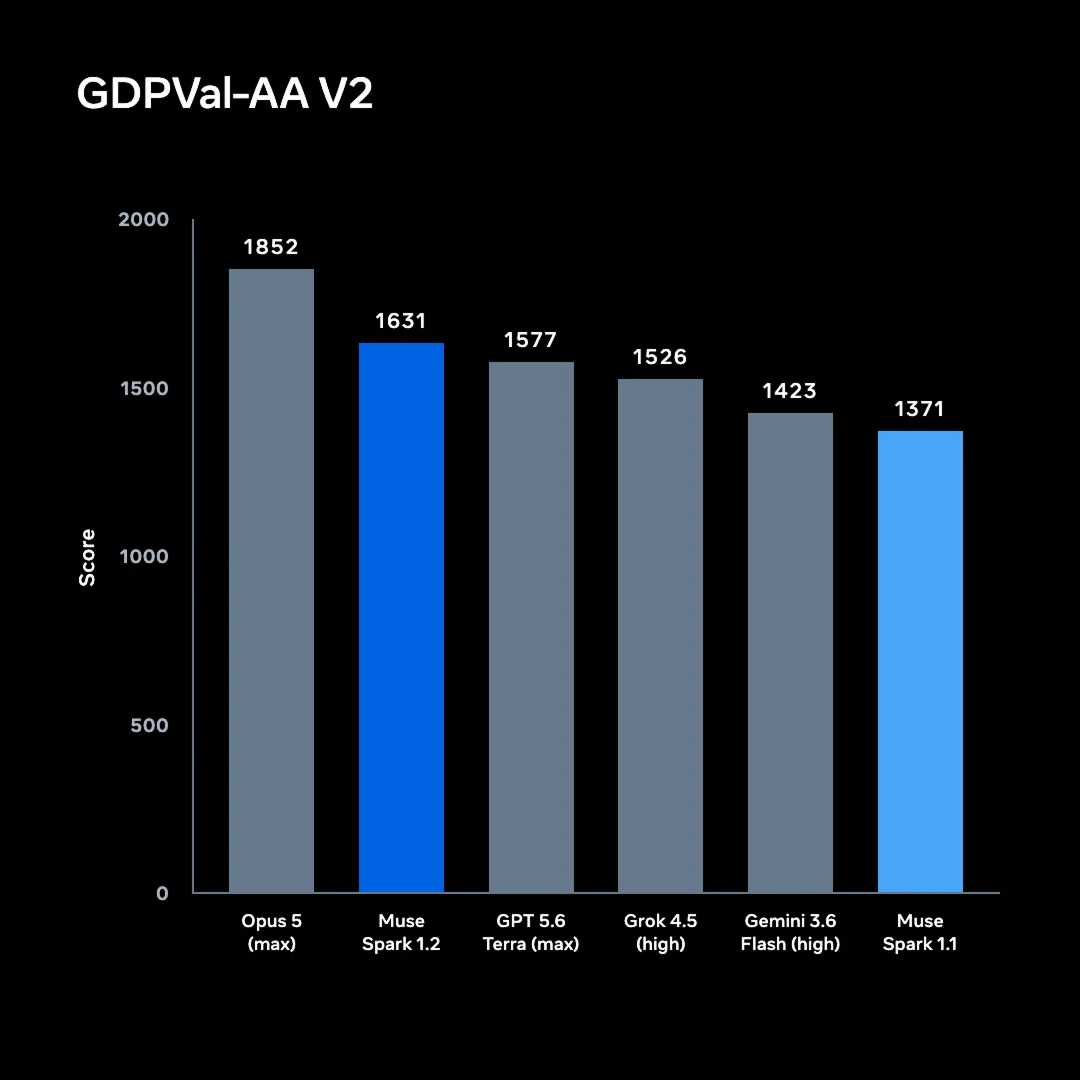
Su GDPVal-AA V2, una prova su 220 compiti da ufficio (documenti, fogli di calcolo, presentazioni, report), ottiene un punteggio Elo di 1.631. Il sistema Elo è quello degli scacchi: nasce da confronti a coppie anonimi tra i lavori prodotti, e più è alto meglio è. Qui c'è una conferma esterna: la pagina di Artificial Analysis riporta lo stesso valore, con un margine di -25/+18. Nel confronto che Meta ha scelto di mostrare, Opus 5 fa meglio e GPT-5.6 Terra peggio.
GDPVal-AA V2
Punteggio Elo su 220 attività professionali
Fonte: Meta e Artificial Analysis, agosto 2026
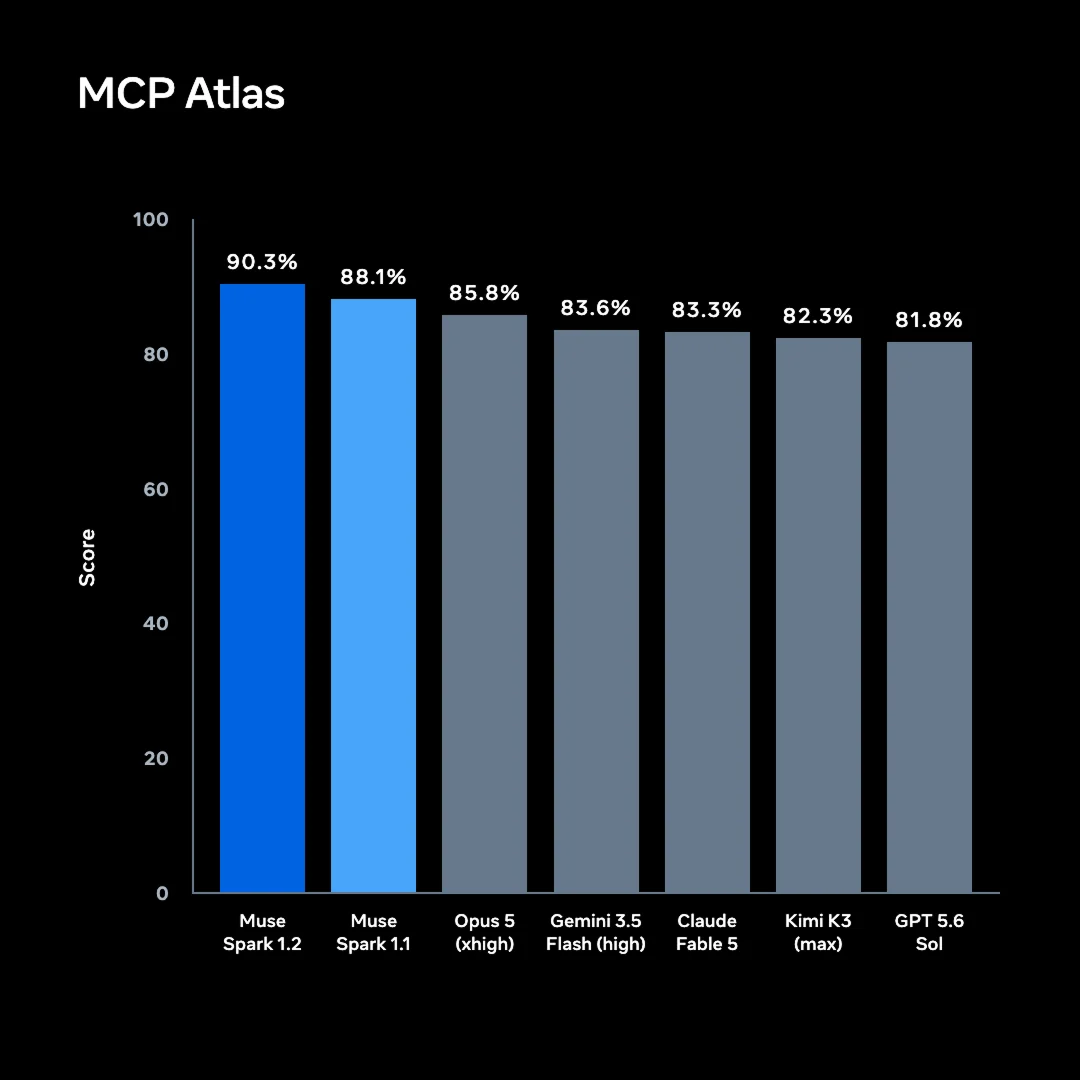
Su MCP Atlas, una prova con 1.000 compiti scritti da persone, 36 server MCP e 220 strumenti, Meta dichiara un tasso di successo del 90,3%, il migliore nel suo grafico. Qui però serve cautela: al controllo del 6 agosto, la classifica pubblica di Scale mostrava Muse Spark 1.1 all'88,1%, ma nessuna riga per la versione 1.2. Il 90,3% va quindi letto come dato di lancio di Meta, in attesa che la pagina di chi gestisce il test si aggiorni.
MCP Atlas
Tasso di successo su 1.000 compiti, 36 server MCP e 220 strumenti
Fonte: Meta (1.2) e classifica pubblica di Scale (1.1), 6 agosto 2026
Ottimizzare i kernel: buoni risultati, non i migliori#
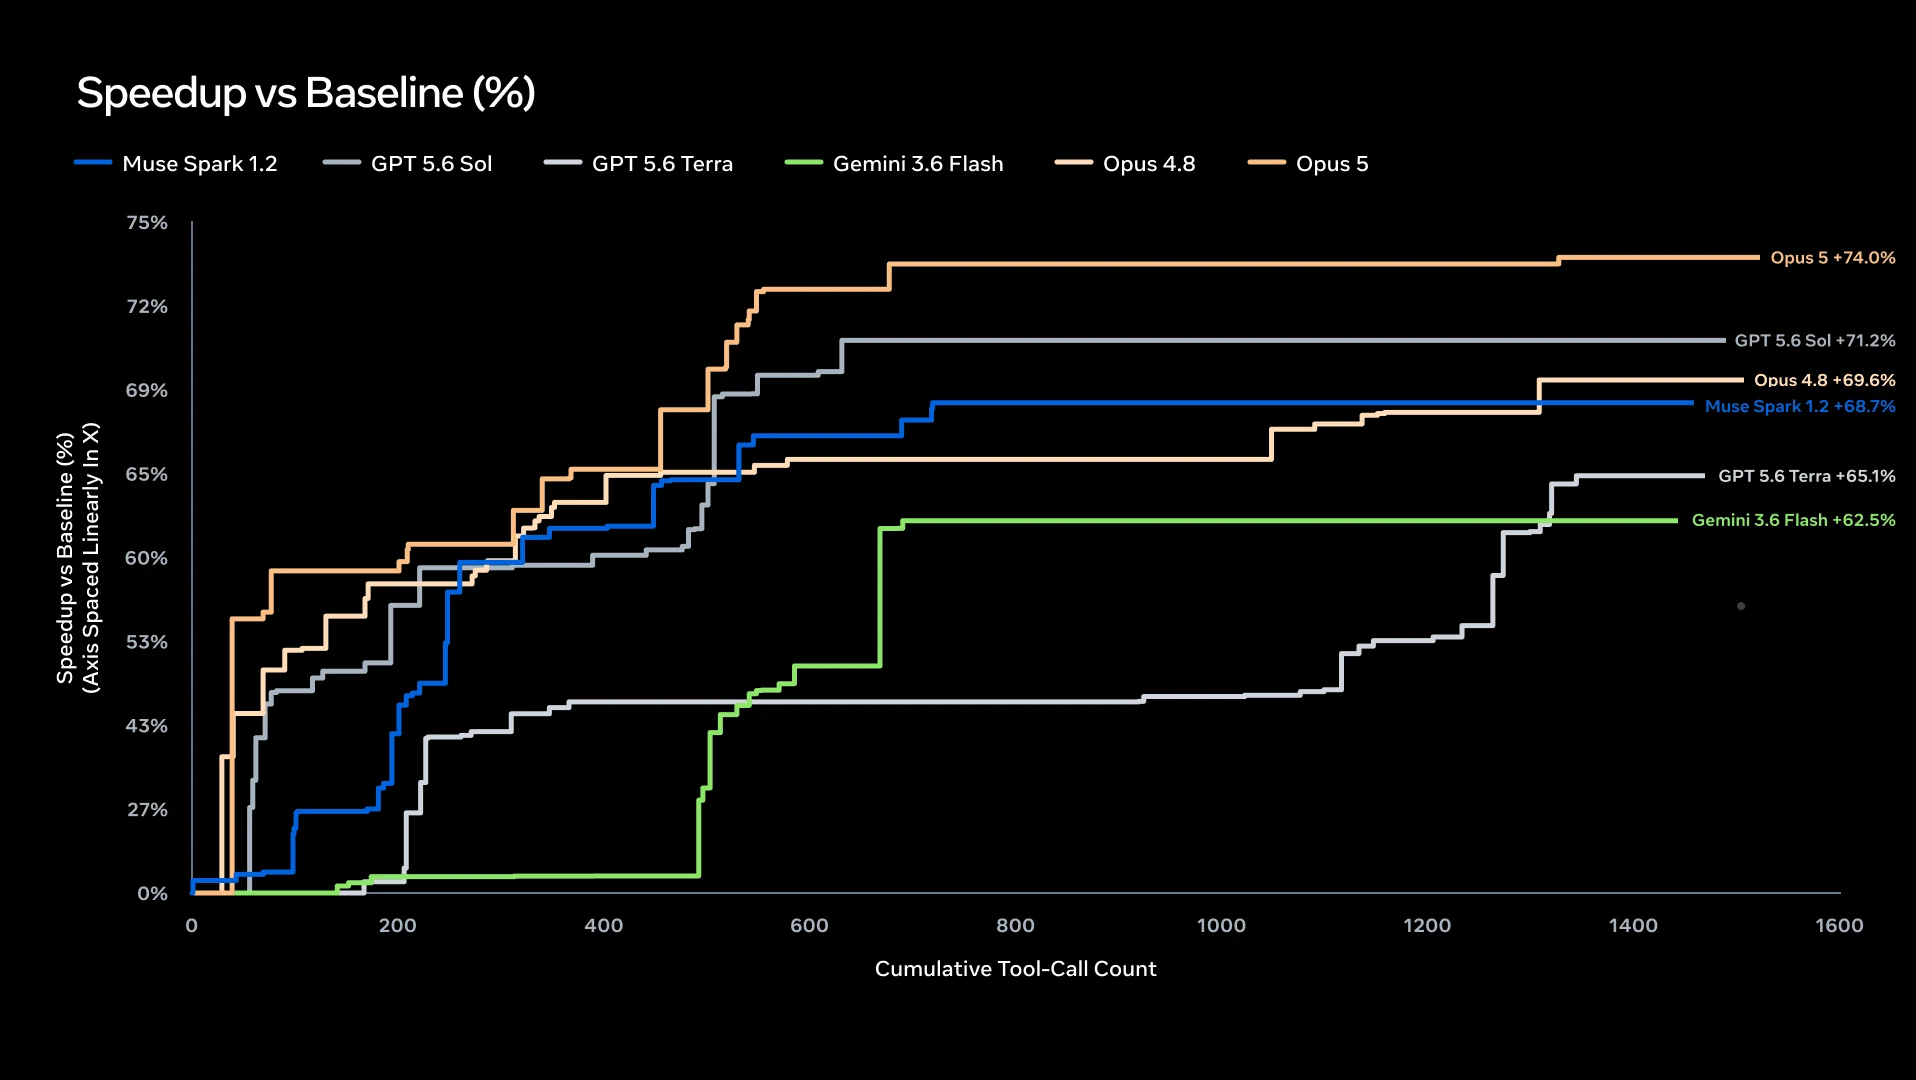
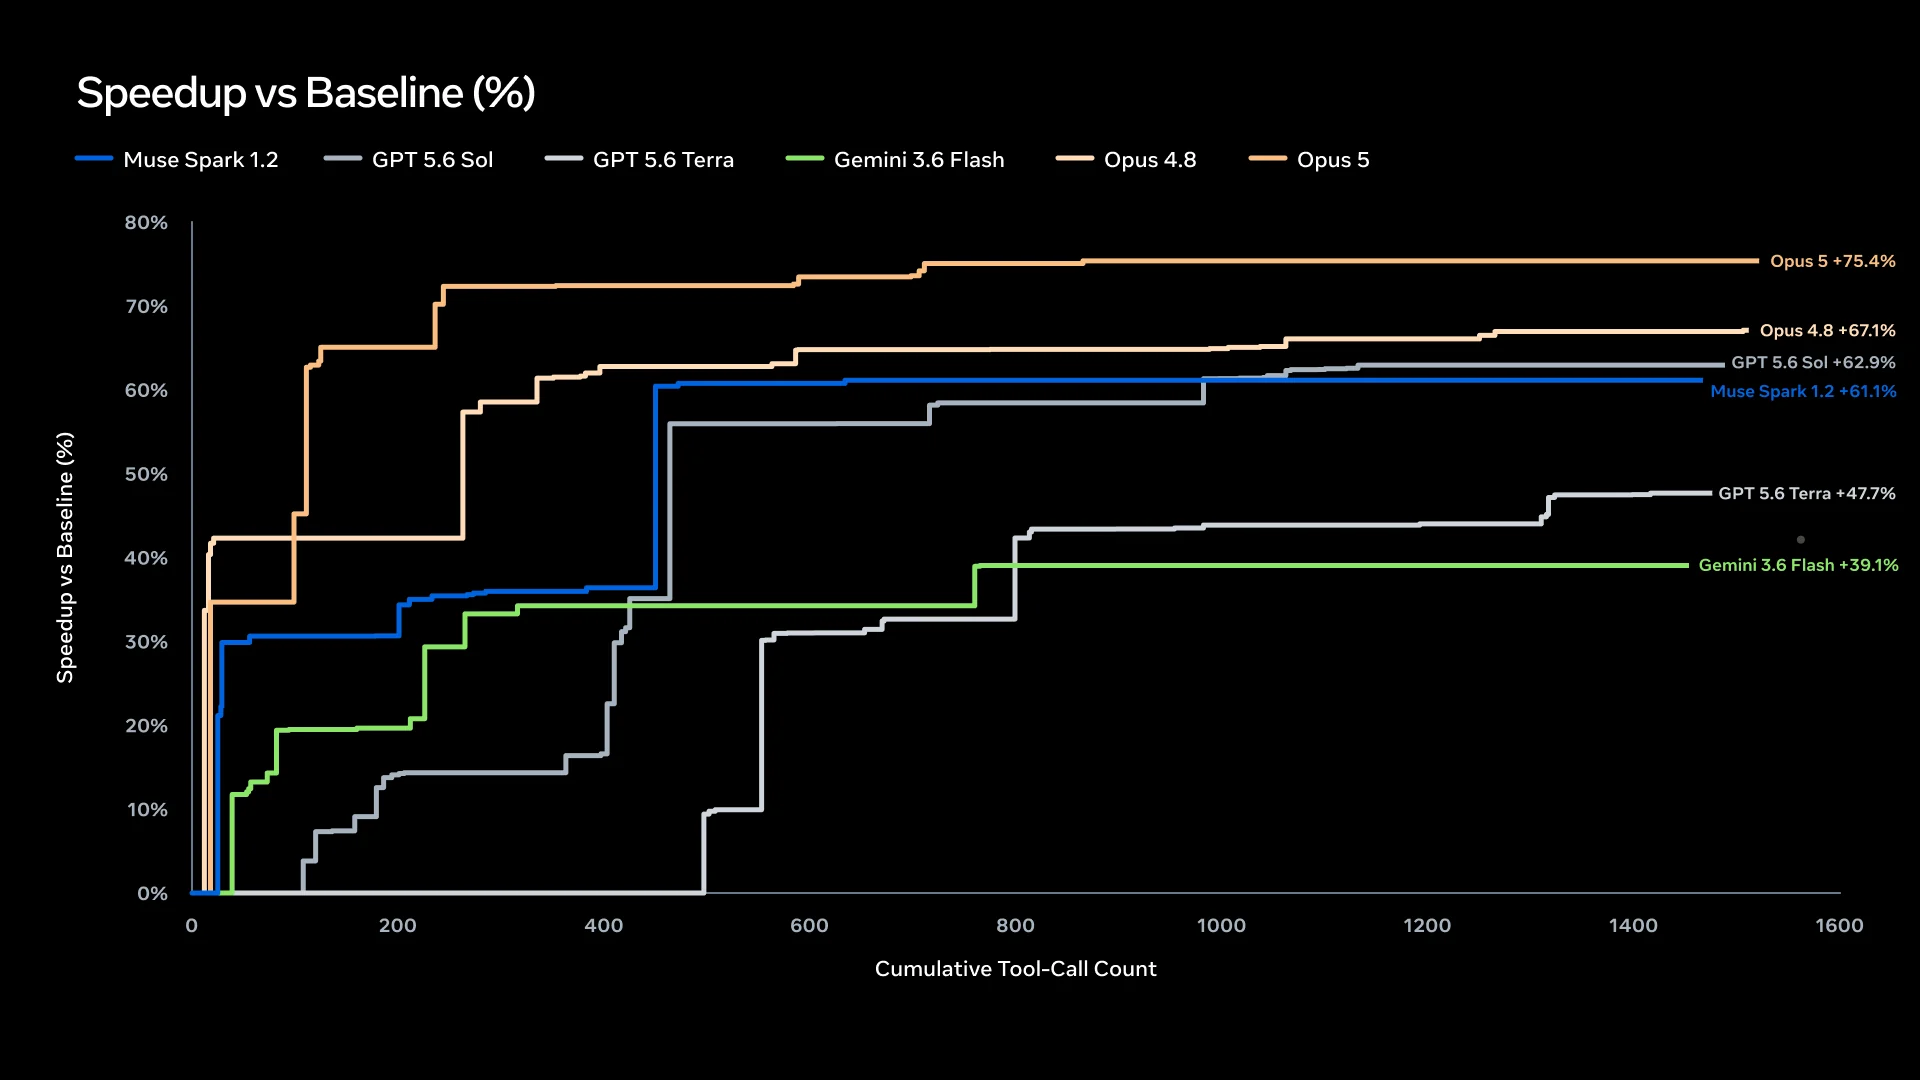
Meta mostra anche due esperimenti su kernel GPU, i piccoli programmi che fanno i calcoli pesanti sulla scheda grafica: l'agente li riscrive e li misura per centinaia di chiamate agli strumenti, e conta quanto diventano più veloci rispetto al punto di partenza.
Ottimizzazione di kernel GPU
Accelerazione finale rispetto alla versione di partenza
- Muse Spark 1.2
- Claude Opus 5
- GPT-5.6 Sol
- Claude Opus 4.8
Fonte: dichiarato da Meta, agosto 2026
I grafici originali mostrano anche l'andamento nel tempo, non solo il punto d'arrivo: il modello di Meta raggiunge presto un livello competitivo e poi si stabilizza, senza arrivare in cima.
La metodologia, prima della classifica#
Il PDF pubblicato con il lancio spiega quali compiti sono stati usati, in quali ambienti, con quanti tentativi e con quali limiti. C'è anche un'ammissione onesta: strumenti e istruzioni di sistema dell'ambiente di Meta potrebbero non essere su misura per i modelli dei concorrenti. Prima di leggere quelle barre come una classifica assoluta, conviene leggere come sono state costruite.
Prezzi: qui Meta attacca davvero#
Piano | Input (1M token) | Output (1M token) | Input in cache (1M token) | Uso dei dati |
|---|---|---|---|---|
Standard | 1,25 $ | 4,25 $ | 0,15 $ | Non usati per migliorare i prodotti |
Contributor | 0,10 $ | 0,20 $ | 0,002 $ | Usati per migliorare i prodotti |
Rispetto allo Standard, il Contributor costa 12,5 volte meno sull'input e più di 21 volte meno sull'output. Lo sconto però si paga in un'altra moneta: chi lo sceglie accetta che Meta usi i suoi dati per migliorare i propri prodotti.
Standard contro Contributor
Dollari per milione di token con Muse Spark 1.2
- Standard
- Contributor
Fonte: listino Meta, agosto 2026
Un esempio di calcolo#
Per dare un ordine di grandezza, immaginiamo un mese in cui l'agente legge 10 milioni di token (il codice del progetto, riletto molte volte) e ne scrive 1 milione. Con la cache, supponiamo che 8 milioni su 10 siano testo già visto.
Piano | Senza cache | Con 8 milioni in cache |
|---|---|---|
Standard | 16,75 $ | 7,95 $ |
Contributor | 1,20 $ | 0,42 $ |
È un esempio costruito sui prezzi di listino, non una misura reale: quanti token consuma davvero un agente dipende dal progetto, e più agenti in parallelo moltiplicano i consumi.
Alcune testate parlano di conservazione zero dei dati e di limiti di throughput, ma le pagine ufficiali consultate non riportano queste condizioni. Prima di adottarlo in azienda vanno verificati documentazione e accordi aggiornati del proprio account.
Cosa non sappiamo ancora#
È una beta: comportamento, stabilità e compatibilità possono ancora cambiare.
Niente Windows al lancio: le istruzioni citano solo macOS e Linux.
Nessun peso aperto: Muse Spark 1.2 si usa via API, senza repository dei pesi né licenza pubblica annunciati.
Benchmark di casa: molti risultati vengono dal framework di Meta e vanno letti insieme al PDF della metodologia.
Governance: più agenti in parallelo vuol dire più velocità, ma anche più cose da controllare, più token consumati e più occasioni di unire modifiche sbagliate.
Sicurezza: un agente con accesso al terminale e al repository chiede ambienti isolati, segreti tenuti a parte, permessi minimi e revisioni obbligatorie.
Per un'azienda conta soprattutto l'ultimo punto: un agente che esegue comandi è come un collaboratore nuovo con le chiavi dell'ufficio, e prima si decide cosa può toccare e chi controlla il suo lavoro. Ne parlo nella guida su cosa sono gli agenti AI.
Il mio parere#
Muse Code è un esordio credibile, perché Meta ha costruito il prodotto attorno ai problemi veri degli agenti: non perdere il lavoro, dividerlo tra più esecutori, tenerli isolati, verificare il risultato. Il listino Standard è aggressivo, e il Contributor può spingere molti a provarlo, purché cedere i dati sia una scelta consapevole.
Dove convince di più: l'architettura del motore e il prezzo. Dove è più indietro: la maturità del prodotto e la trasparenza su governance e sicurezza. Il modello sta nel mezzo, competitivo ma non primo.
È un giudizio costruito leggendo documentazione e risultati pubblicati, senza averlo provato di persona. Tre cose mi frenano: la beta si ferma a macOS e Linux; Muse Spark 1.2 non guida i test di programmazione pubblicati dalla stessa Meta, dove Opus 5 resta davanti su Terminal-Bench, DeepSWE e test interno; e non c'è ancora un racconto pubblico convincente su sicurezza per le aziende, amministrazione centralizzata e pesi o licenza aperti.
Se lavorate già con un agente da terminale, il modo serio di valutarlo è lo stesso di sempre: qualche compito vero, fatto su un repository non sensibile, confrontando qualità, costo, tempi e quante volte serve l'intervento di una persona.
Domande frequenti#
Muse Code è gratuito?
Le pagine di lancio mostrano un prezzo a consumo per Muse Spark 1.2, con i piani Standard e Contributor. Crediti o prove gratuite della beta vanno verificati sul proprio account.
Funziona su Windows?
Al lancio no: le istruzioni ufficiali citano solo macOS e Linux.
È open source?
No. Nelle pagine di lancio Meta non presenta né Muse Code né Muse Spark 1.2 come open source o a pesi aperti: il modello si usa tramite API.
Riprende davvero il lavoro dopo un crash?
Meta documenta un registro locale degli eventi in sola aggiunta e definisce il runtime restart-safe, quindi lo stato si può ricostruire. Non è una garanzia che ogni compito riparta senza errori di logica o senza bisogno di una persona.
I subagenti modificano tutti gli stessi file?
No, ognuno può lavorare in un git worktree separato. I risultati vanno comunque rivisti e uniti con attenzione, soprattutto quando toccano parti collegate del codice.
Muse Spark 1.2 batte Claude Opus 5?
Non nei principali test di programmazione mostrati da Meta: Opus 5 lo supera su Terminal-Bench 2.1, su DeepSWE 1.1 e nel test interno. Muse Spark 1.2 è primo solo nel grafico Meta su MCP Atlas, con la cautela sulla classifica pubblica non ancora aggiornata.
Il piano Contributor va bene per il codice aziendale?
Solo se la policy aziendale accetta che Meta usi i dati per migliorare i suoi prodotti, dopo aver verificato contratto, privacy, segreti e sensibilità del repository.
Il mio verdetto
Un esordio serio: Meta tratta la ripresa dopo i guasti, il lavoro in parallelo e l’isolamento degli agenti come parti del prodotto, non come problemi da scaricare sul modello. Muse Spark 1.2 regge il confronto e costa poco, ma nei test di programmazione non è primo e, da beta qual è, va messo alla prova su governance e affidabilità prima di fidarsi.
Cosa mi convince
- Un registro degli eventi che permette di riprendere il lavoro dopo un crash
- Più agenti in background, ognuno nella propria copia del repository
- Modello addestrato insieme all’ambiente in cui deve lavorare
- Un milione di token di contesto
- Listino Standard molto aggressivo
- Piano Contributor quasi regalato, adatto a codice non riservato
Cosa non mi convince
- Beta solo per macOS e Linux, senza Windows
- Nei test di programmazione scelti da Meta, Opus 5 resta davanti
- Il test interno di Meta non si può rifare dall’esterno
- Il 90,3% su MCP Atlas non compariva ancora nella classifica pubblica
- Nessun peso aperto né licenza pubblica annunciati
- Con il Contributor, Meta usa i dati per migliorare i suoi prodotti
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.
- 2.Meta for Developers — la pagina di Muse Codedeveloper.meta.com
- 3.Meta for Developers — la scheda di Muse Spark 1.2developer.meta.com
- 4.
- 5.Artificial Analysis — GDPVal-AAartificialanalysis.ai
- 6.
- 7.Reuters, via TradingView — Meta lancia Muse Codetradingview.com
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.