ML4 in anteprima pubblica: benchmark, cybersicurezza, prezzi e pesi in arrivo a fine mese
Mistral ha avviato l'anteprima pubblica di Mistral Large 4, un modello open-weight da un trilione di parametri. Ecco cosa dicono i benchmark, cosa manca ancora e cosa conta per voi in azienda.
di Andrea Pirazzini
Fonte primaria
Mistral AI — Introducing Mistral Large 4 | Mistral
mistral.ai
Matteo e Vittorio
Il Narratore a due voci · 2 min 41 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Mistral AI — Introducing Mistral Large 4 | Mistral.
Perché se ne parla#
Il 6 ottobre 2026 Mistral ha lanciato un'anteprima pubblica di Mistral Large 4, soprannominato internamente ML4. Il modello è accessibile tramite API su Mistral Studio, mentre i pesi saranno rilasciati entro la fine del mese. Mistral lo presenta come il suo modello più grande e capace finora, e come un passo avanti nella frontiera delle prestazioni open-weight.
Per le imprese il punto rilevante è che l'azienda afferma che ML4 superi in modo significativo qualsiasi modello open-weight sviluppato negli Stati Uniti o in Europa, restando competitivo con i modelli open-source più forti a livello globale. Si tratta di dichiarazioni del produttore, che la fonte non accompagna con valutazioni indipendenti.
Il primo esempio concreto riguarda la sicurezza informatica, dove il produttore collega le prestazioni alla possibilità di lavorare senza i rifiuti dei modelli chiusi. Il widget seguente anticipa questo tema con una gara animata di tipo CTF.
La scheda#
Ecco i dati essenziali del modello, come riportati dalla pagina del prodotto di Mistral AI e dal comunicato di lancio. I prezzi sono in dollari per milione di token: per ogni voce compaiono il listino e lo sconto applicato nell'anteprima.
Voce | Dettaglio |
|---|---|
Tipo | Modello multimodale generico a pesi aperti, architettura Mixture-of-Experts granulare |
Parametri | 1 trilione totali, 52 miliardi attivi |
Encoder visivo | 1,6 miliardi di parametri |
Contesto | 1 milione di token |
Input | Multimodale |
Disponibilità | Anteprima pubblica tramite API; pesi aperti previsti entro la fine del mese |
Prezzo input | Listino 1,36 $, scontato 0,68 $ |
Input in cache | Listino 0,14 $, scontato 0,07 $ |
Output | Listino 4,18 $, scontato 2,09 $ |
Limiti dichiarati | Il produttore indica che il modello sta ancora migliorando durante la messa a punto |
Il produttore precisa che la versione attuale è un'anteprima: la valutazione dei suoi risultati va quindi letta come provvisoria.
I numeri di testa#
Riproduzione e patch di una vulnerabilità
Dichiarazione di Mistral: il punteggio più alto tra i modelli testati
Sfide Cybench risolte (40 esercizi)
Dichiarazione di Mistral
Attacchi respinti nel B3 di Lakera
Benchmark di terzi, risultato riportato da Mistral
DeepSWE v1.1
Dichiarazione di Mistral
Tutti e quattro i valori arrivano dall'annuncio di Mistral. Il dato più forte è l'82% nel test di riproduzione e patch di una vulnerabilità, che il produttore presenta come il punteggio più alto tra i modelli testati. Il 93% delle sfide Cybench, un set di 40 esercizi tratti da competizioni di sicurezza, è indicato da Mistral come uno dei valori più alti per un modello open-weight. Il 93,3% di attacchi respinti nel B3 di Lakera è un benchmark di terzi, ma il risultato è quello comunicato dal produttore. Il 61,7% su DeepSWE v1.1 riguarda la programmazione agentica. Mistral ha annunciato che pubblicherà pesi, architettura e ulteriori benchmark entro la fine del mese, quindi questi numeri potranno essere verificati solo in seguito.
Coding agentico: DeepSWE e Terminal-Bench#
DeepSWE 1.1: il confronto di Artificial Analysis#
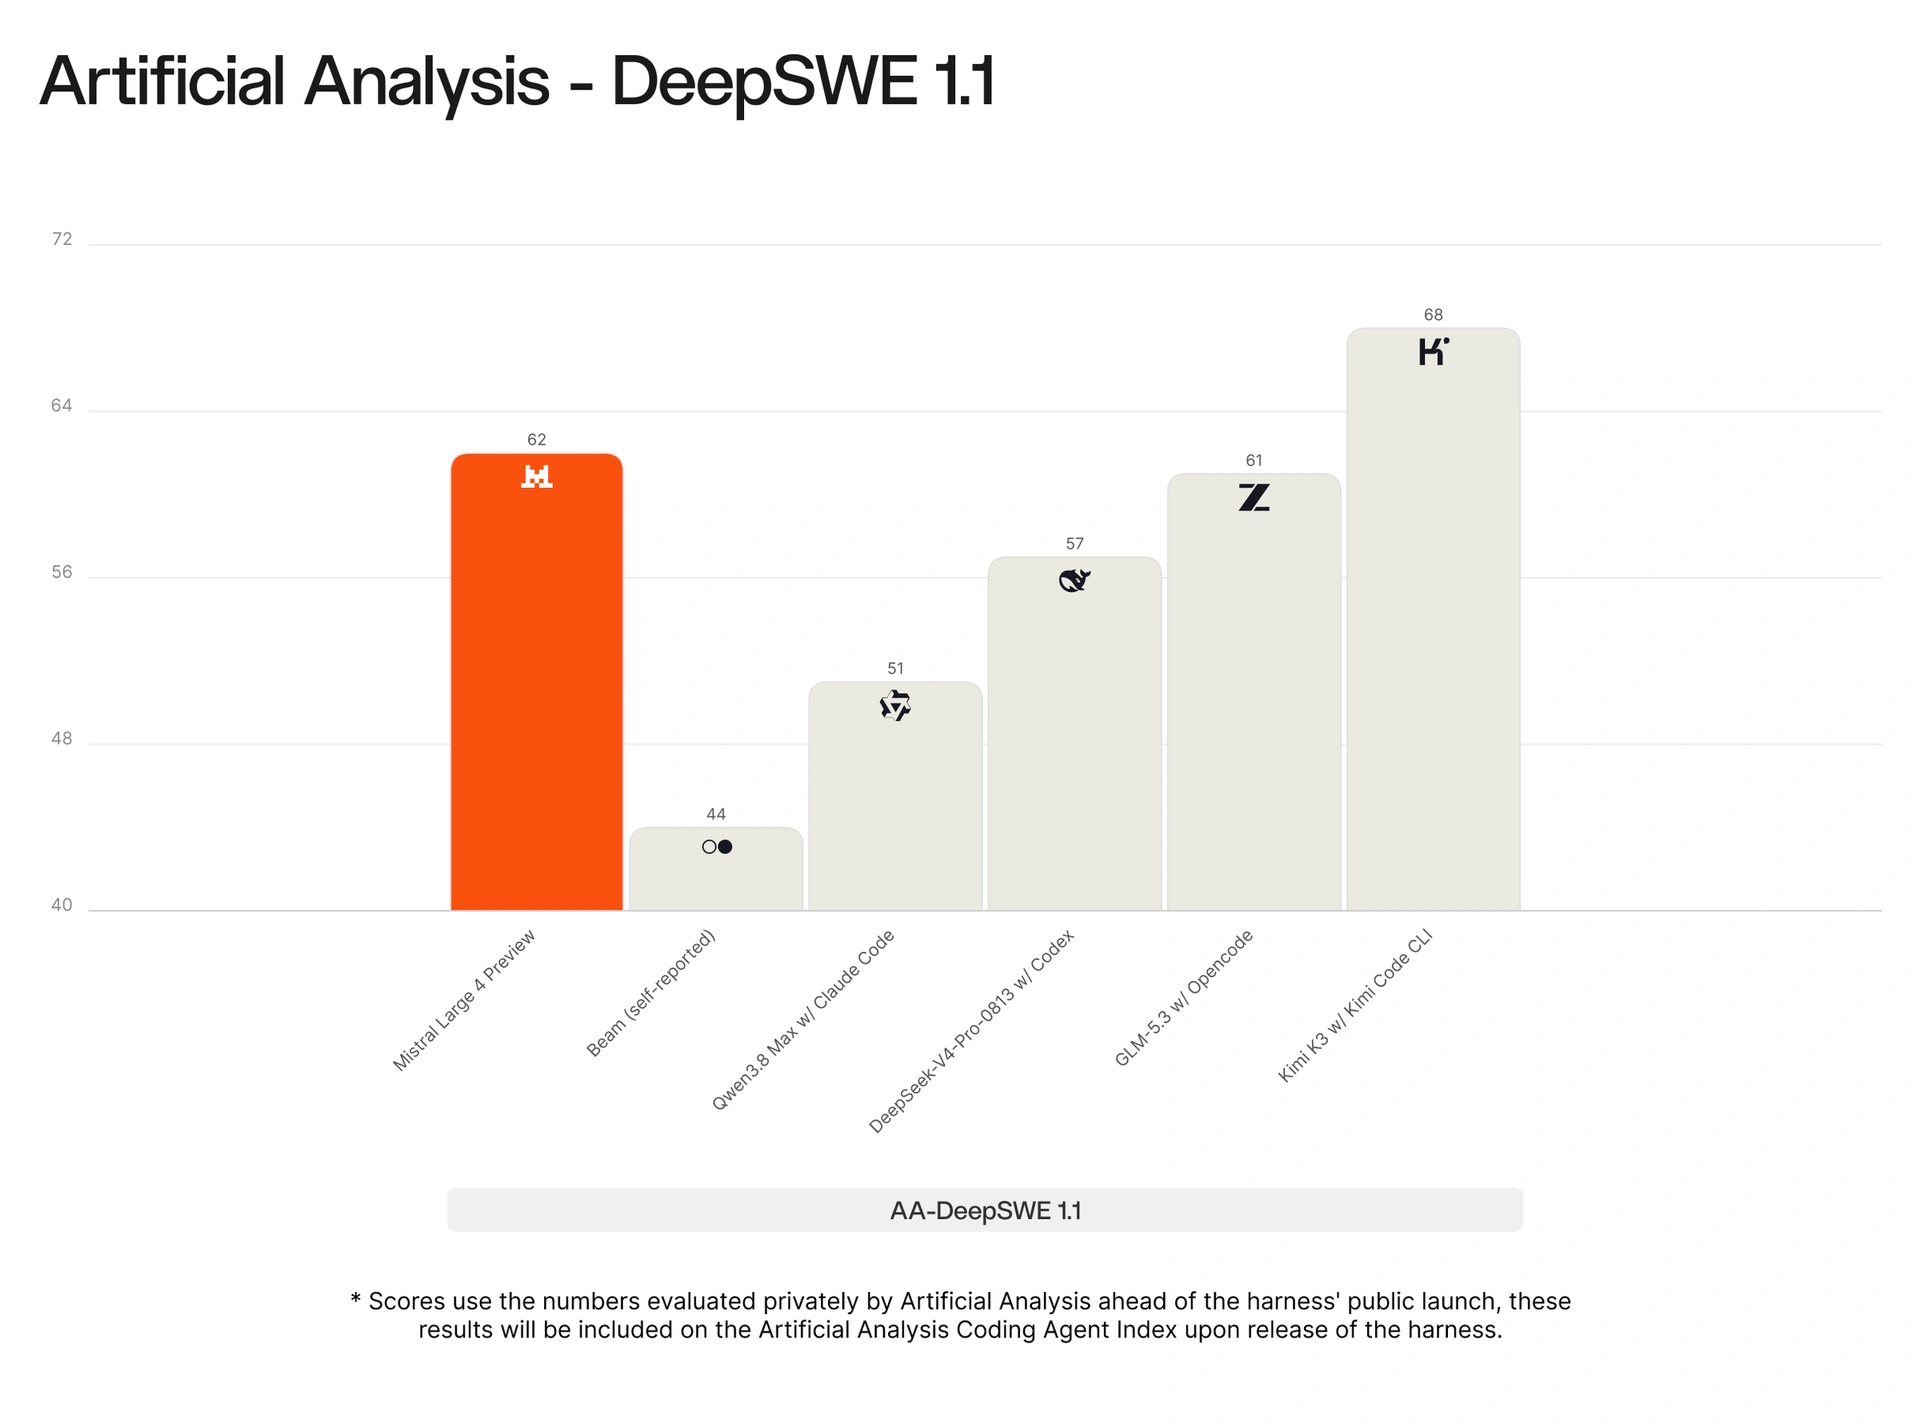
Nel grafico DeepSWE 1.1 di Artificial Analysis, Mistral Large 4 Preview ottiene 62. Davanti c'è solo Kimi K3 con Kimi Code CLI (68), mentre GLM-5.3 con Opencode si ferma a 61 e DeepSeek-V4-Pro-0813 con Codex a 57. Qwen3.8 Max con Claude Code arriva a 51. Il valore di Beam, 44, è dichiarato dal fornitore. I punteggi del grafico sono arrotondati: il testo di Mistral riporta 61,7% su DeepSWE v1.1.
DeepSWE 1.1: punteggi per modello
Valori arrotondati dal grafico ufficiale di Artificial Analysis
Fonte: Mistral AI, valori letti dal grafico ufficiale
Terminal-Bench 4#
Su Terminal-Bench 4 il grafico arrotonda a 28 il valore 28,3% riportato dal testo di Mistral per Mistral Large 4 Preview. Nel grafico, Mistral resta dietro al solo GLM-5.3, mentre gli altri modelli confrontati sono più bassi. I punteggi sono stati valutati privatamente da Artificial Analysis prima del lancio dell'harness e saranno inclusi nel Coding Agent Index al suo rilascio, quindi per voi conviene attendere quella pubblicazione prima di confrontarli in modo definitivo.
Cyber Index: successi e blocchi#
Successi e blocchi nell'AA Cyber Index#
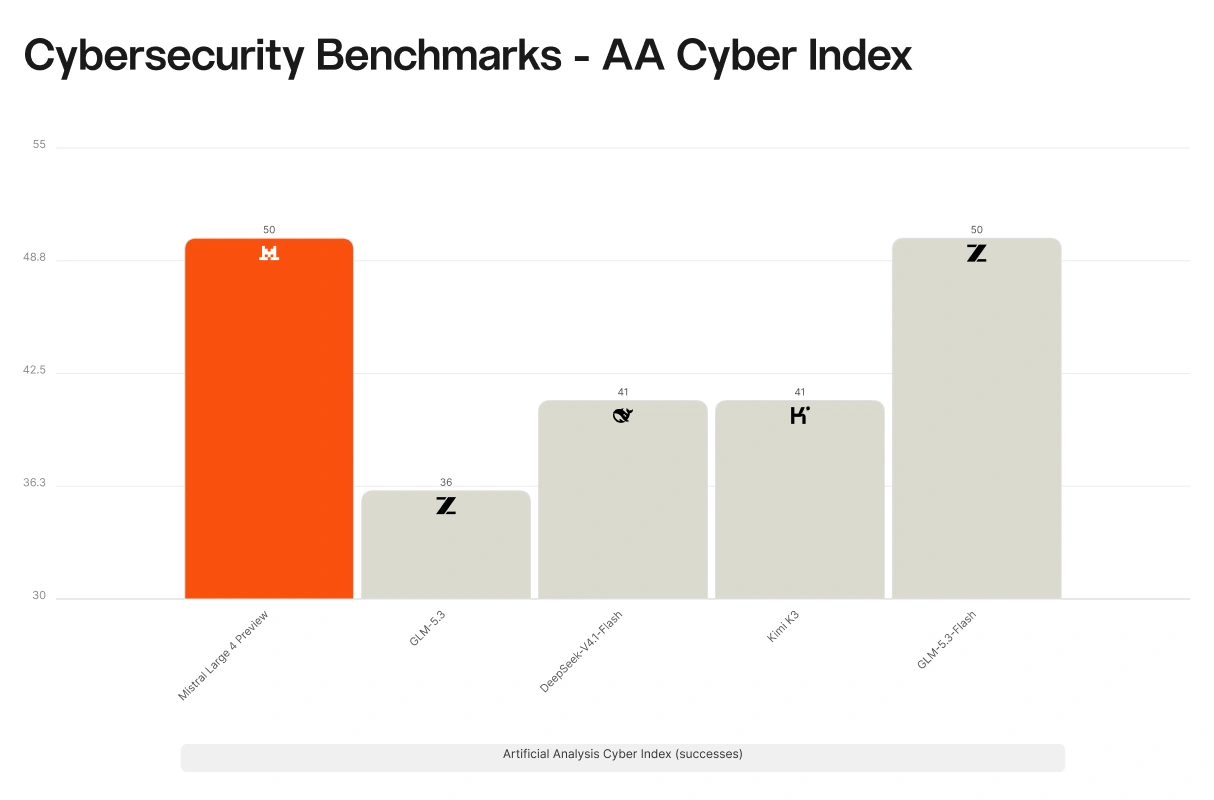
Secondo Mistral, l'Artificial Analysis Cyber Index misura quante volte un modello trova e corregge difetti reali nel software. Nel grafico ufficiale Mistral Large 4 Preview e GLM-5.3-Flash sono entrambi a 50, mentre DeepSeek-V4.1-Flash e Kimi K3 arrivano a 41 e GLM-5.3 a 36.
Artificial Analysis Cyber Index: successi e blocchi
Successi e blocchi di sicurezza per modello
- SUCCESS
- SAFETY BLOCKS
Fonte: Mistral AI, valori letti dal grafico ufficiale
Il grafico separa i successi dai blocchi di sicurezza. Mistral Large 4 Preview ha 50 successi e nella fonte non c'è un dato sui blocchi; Qwen3.8 2.4T A95B registra 13 successi e 63 blocchi. Mistral sostiene che i modelli chiusi rifiutano il compito: cita Claude Opus 5.5 e GPT-6 Astra, ma si tratta di una dichiarazione del produttore. Per chi valuta questi modelli, conviene leggere separatamente le due colonne.
Modello | Successi | Blocchi di sicurezza |
|---|---|---|
Mistral Large 4 Preview | 50 | — |
Qwen3.8 2.4T A95B | 13 | 63 |
Opus 5.5 | 29 | 36 |
GPT-6 Astra | 33 | 38 |
GLM-5.3 | 36 | — |
Kimi K3 | 41 | — |
DeepSeek-V4.1-Flash | 41 | — |
Valori dell'Artificial Analysis Cyber Index per modello, letti dal grafico ufficiale. Fonte: Mistral AI.
Cybersicurezza: CTF e malware#
Benchmark di cybersicurezza#
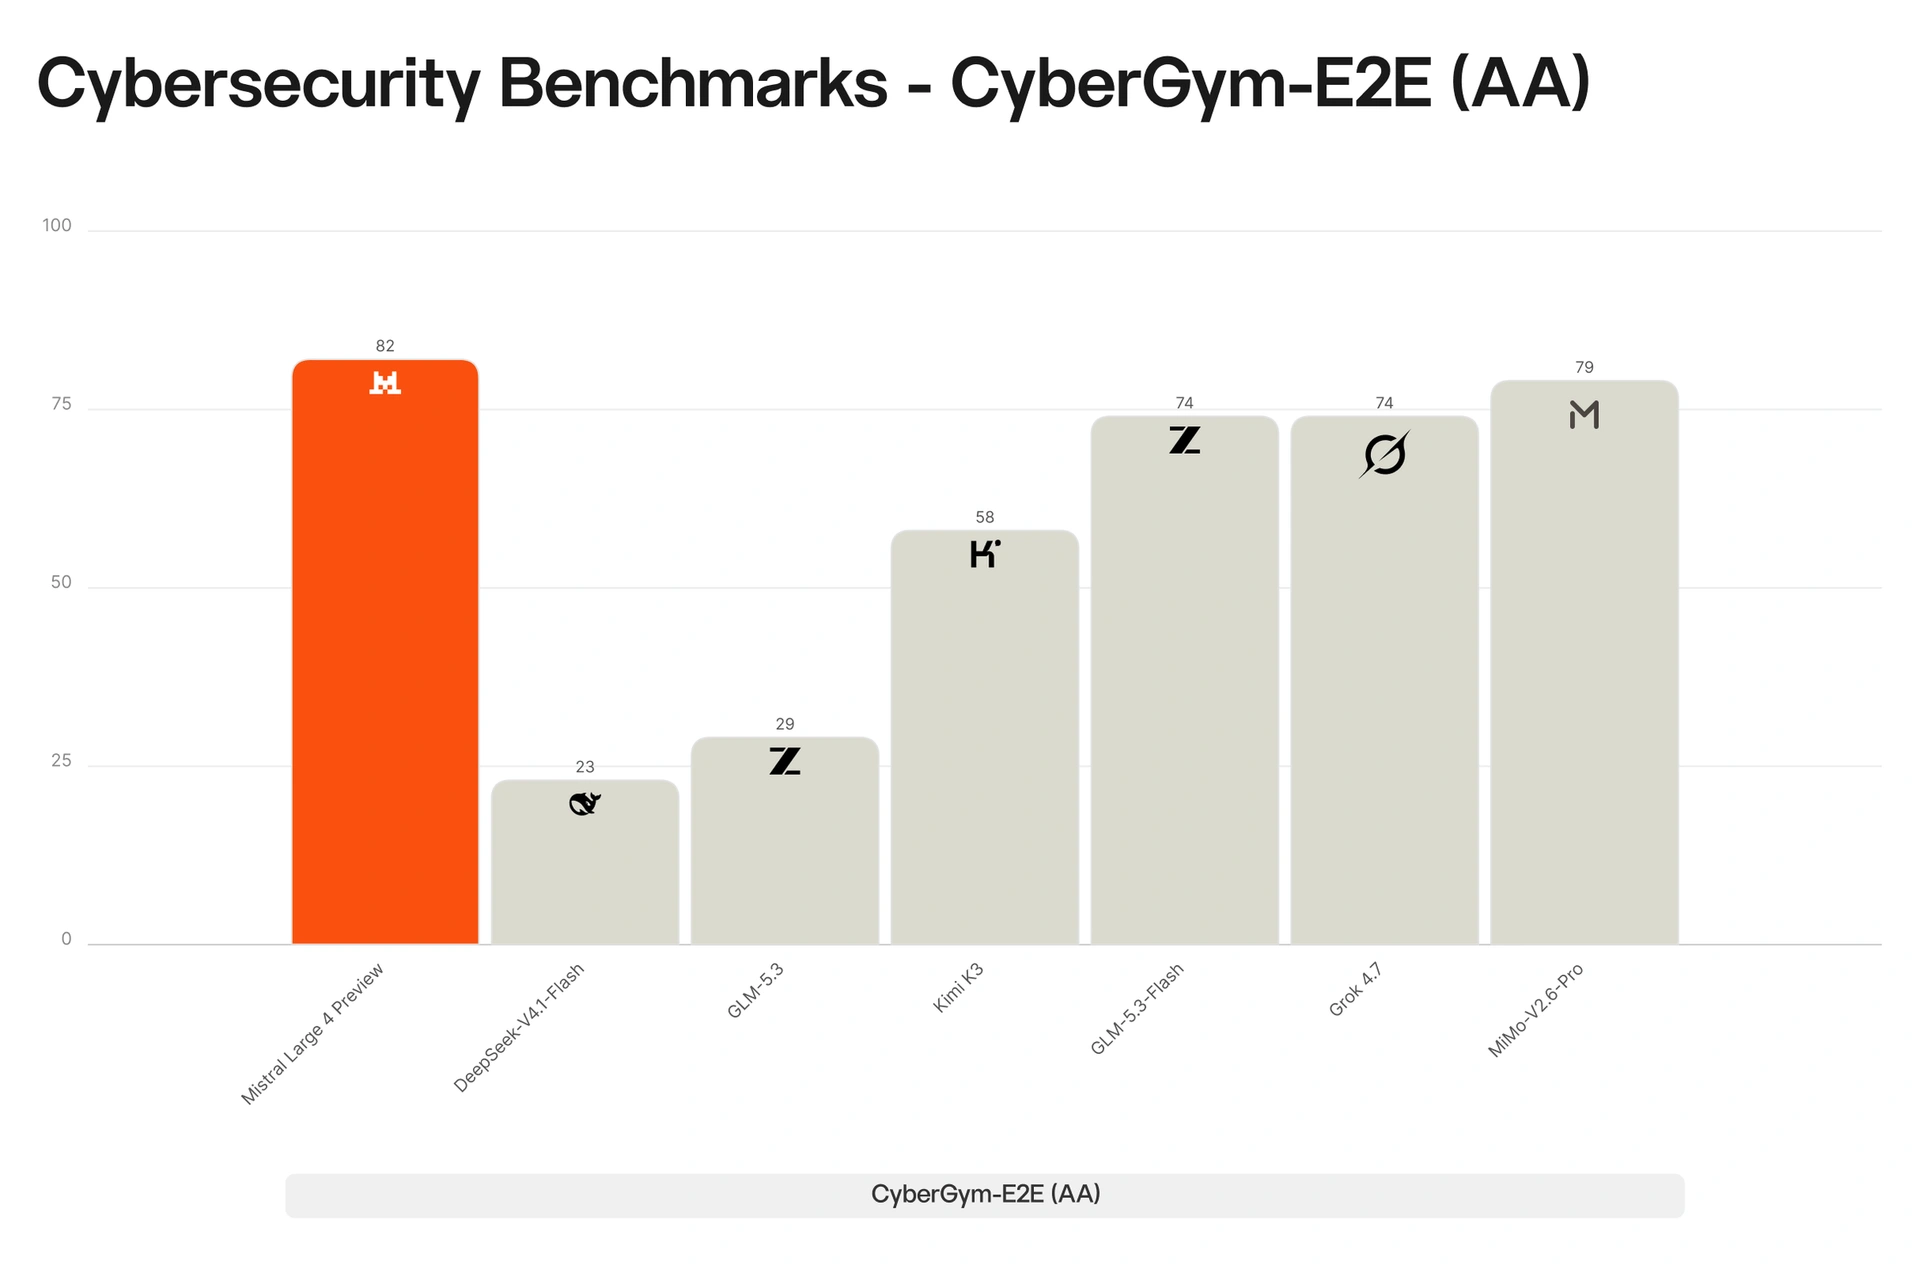
Mistral dichiara che ML4 risolve il 93% delle 40 sfide di Cybench, esercizi tratti da competizioni di sicurezza, e lo definisce tra i punteggi più alti per un modello open-weight. Nel test CyberGym-E2E dell'Artificial Analysis Cyber Index, che chiede di riprodurre una vulnerabilità reale in software open source e poi correggerla, ML4 arriva all'82%, valore che il produttore indica come il più alto tra i modelli. Sono dichiarazioni di Mistral, riportate nella pagina ufficiale.
I due grafici confrontano ML4 con i modelli scelti da Mistral in ciascun test. Nel primo ML4 è in testa; nel secondo è al primo posto, con Kimi K3 molto vicino.
CyberGym-E2E (AA)
Punteggi dichiarati da Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
Cybench
Sfide risolte dichiarate da Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
Malware triage passo passo#
Il widget ricostruisce la traiettoria di un agente davanti a un loader CobaltStrike senza etichetta, senza intervento umano: 5 fasi, 56 passi e 7 risultati. Mistral lo presenta come esempio di reverse engineering su malware, un compito fuori dalla distribuzione di addestramento.
Agenti di lavoro: AutomationBench e AA-Briefcase#
AutomationBench: 657 flussi di lavoro aziendali#
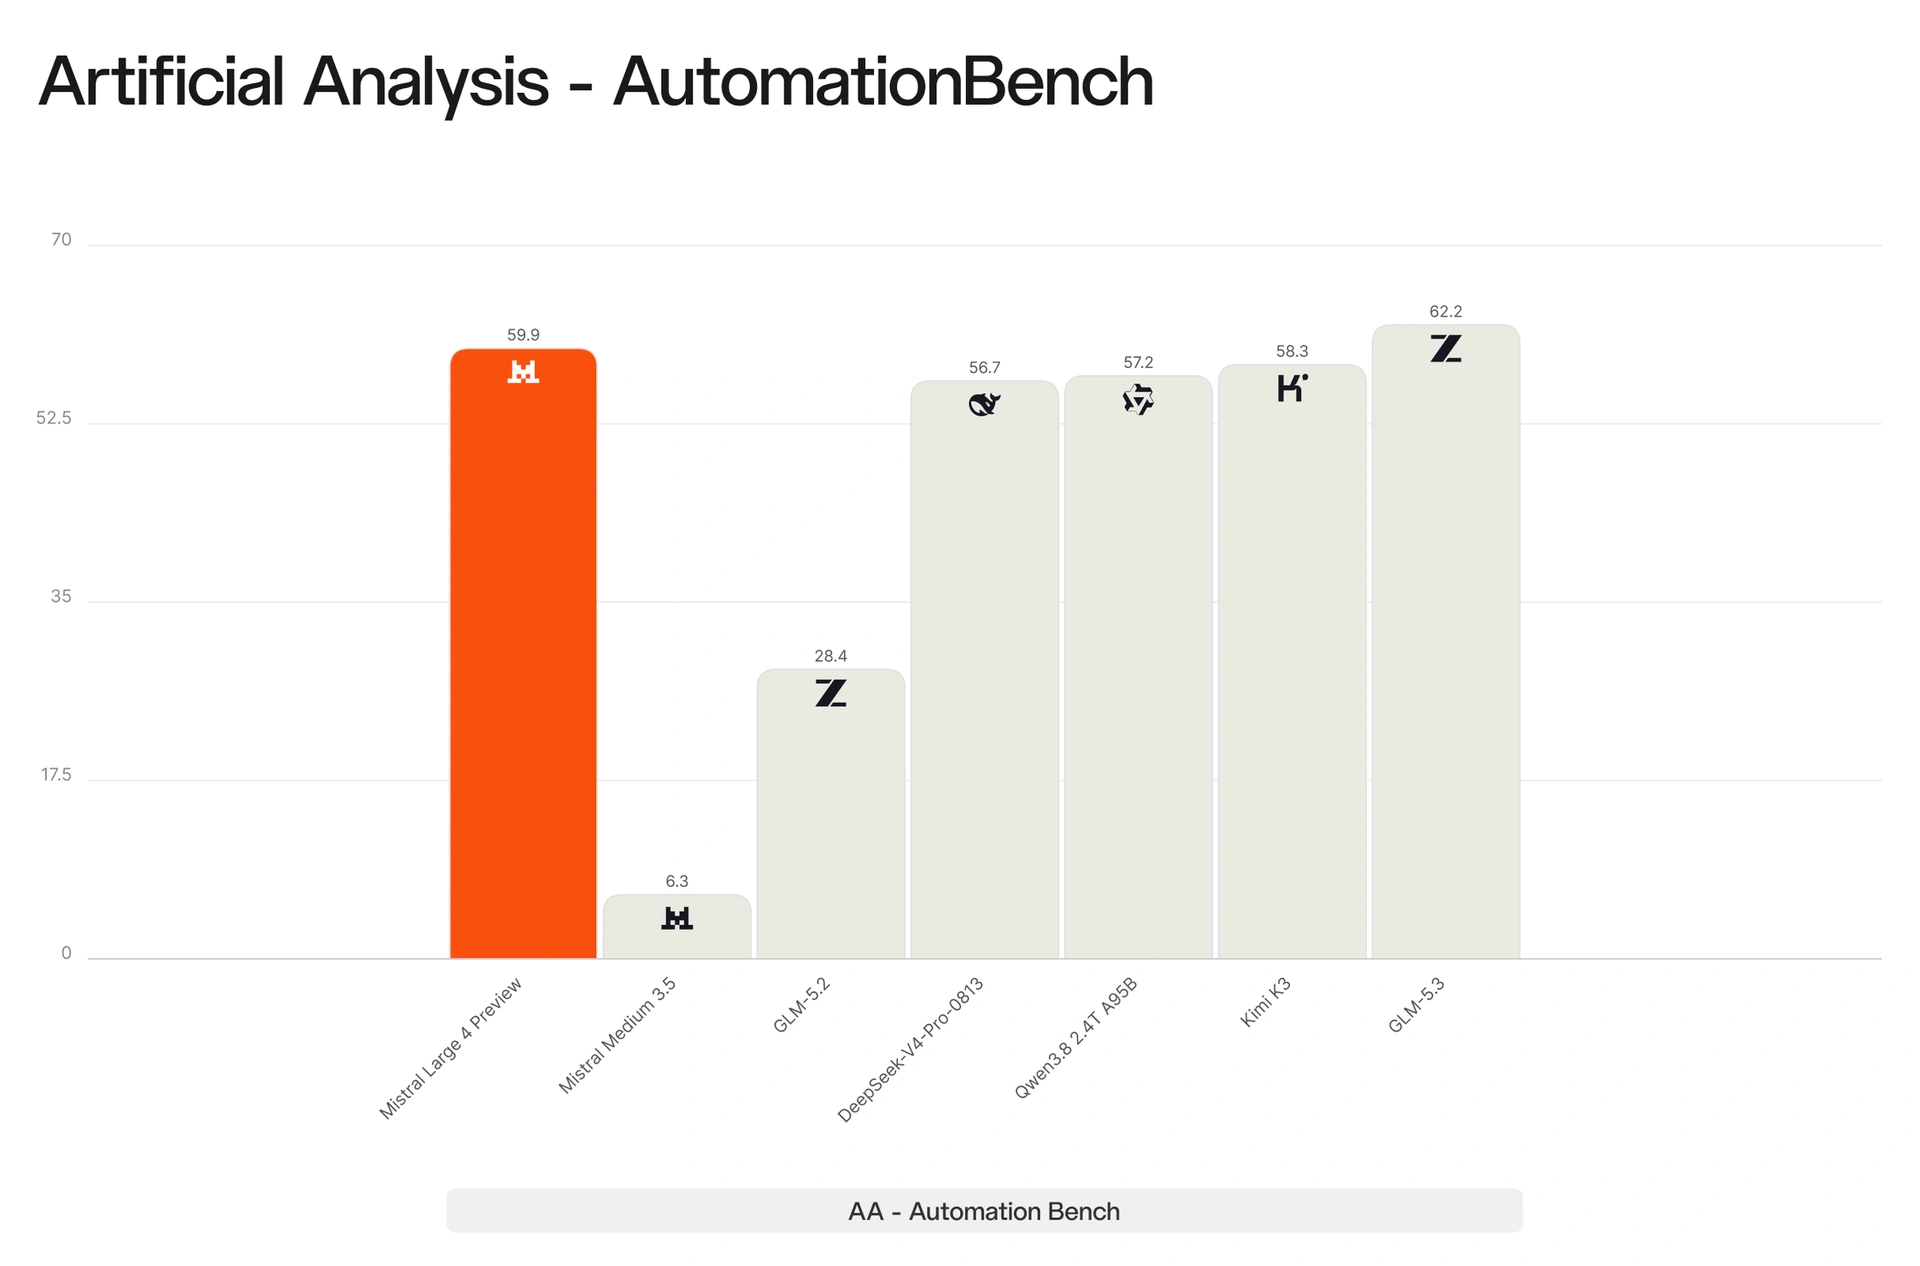
Su AutomationBench, che include 657 flussi di lavoro tra app come Gmail, Google Sheets, Slack e Salesforce, il produttore riporta 59,9% per Mistral Large 4 Preview. Vi segnaliamo che il testo del produttore cita Kimi K3 (58,3%), MiMo-V2.6-Pro e DeepSeek V4 Pro (56,7%), ma non GLM-5.3, che nel grafico risulta più alto con 62,2%. Il grafico mostra anche GLM-5.2 a 28,4% e Mistral Medium 3.5 a 6,3%.
AA - AutomationBench
Obiettivi completati senza violazioni
Fonte: Mistral AI, valori letti dal grafico ufficiale
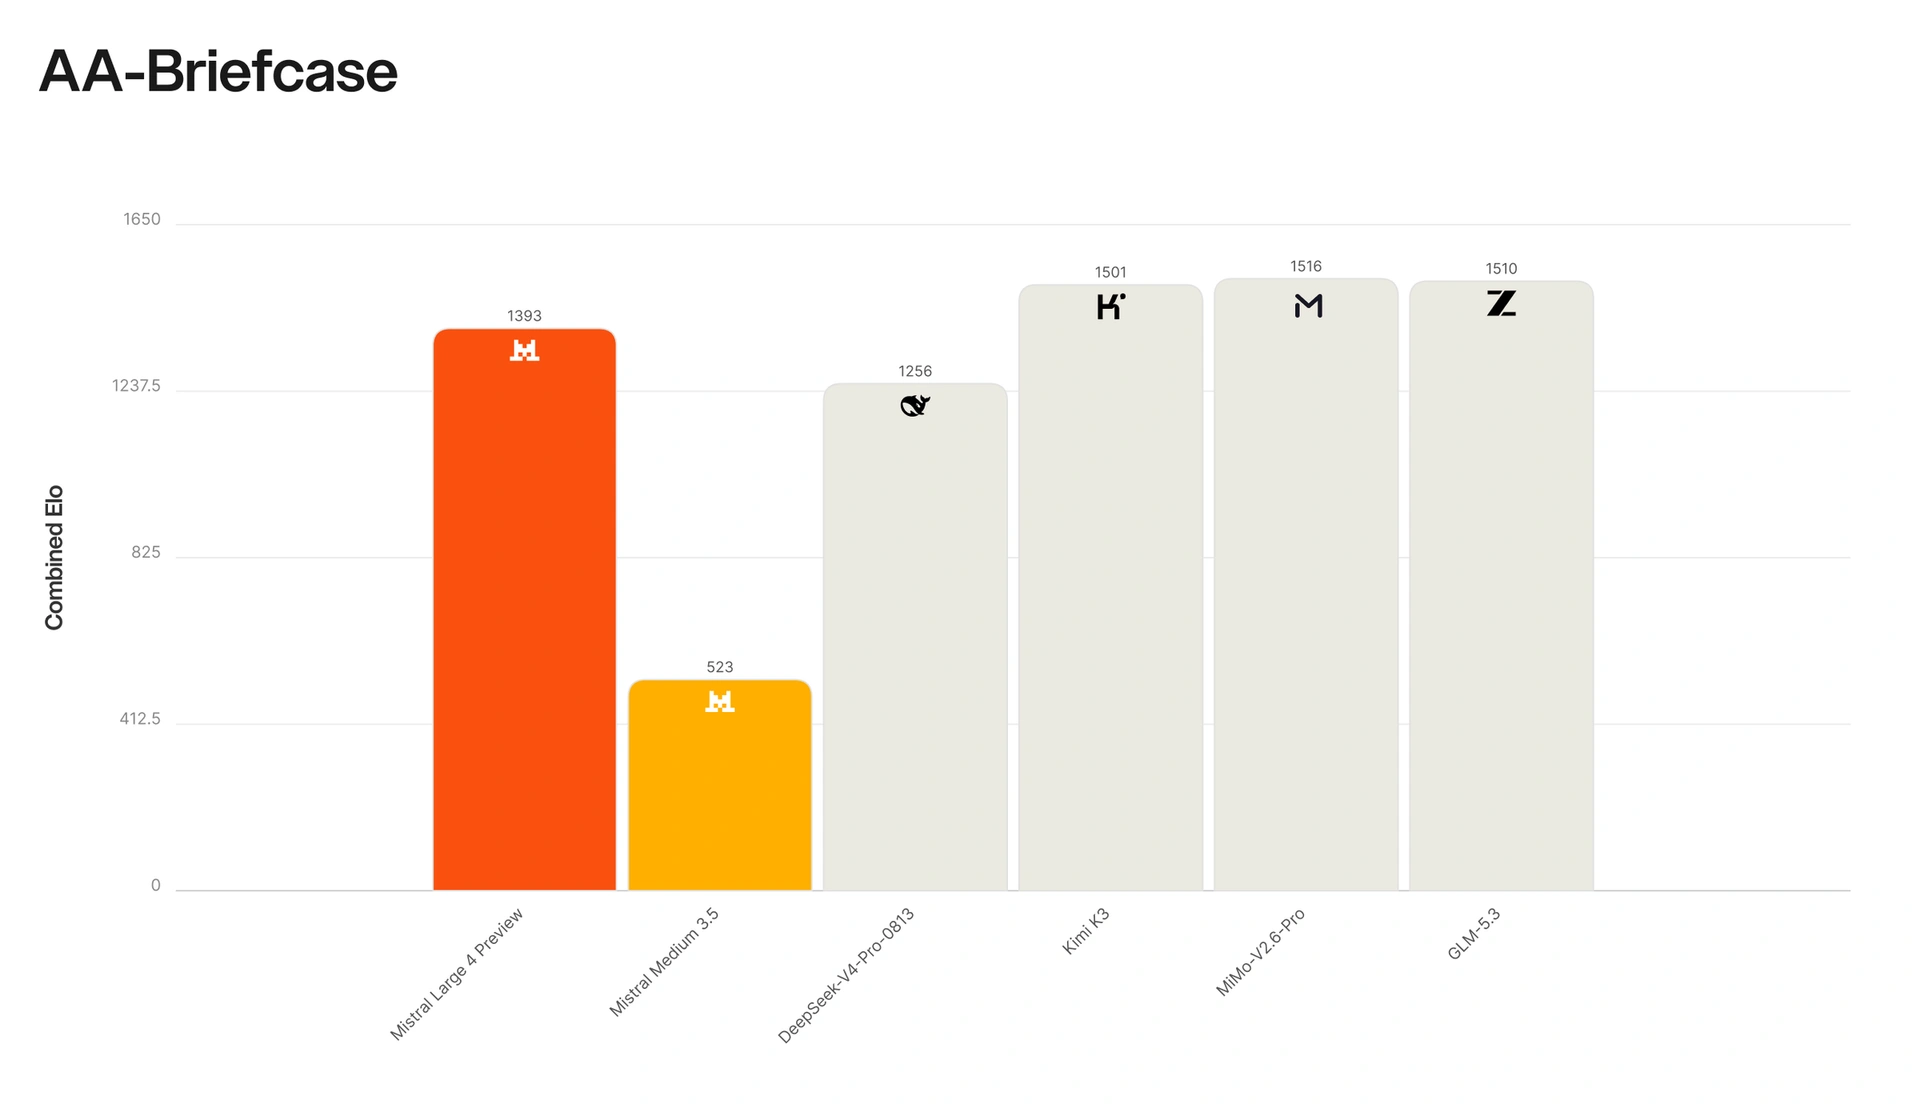
AA-Briefcase: lavori di conoscenza a lungo orizzonte#
Su AA-Briefcase, che valuta il lavoro di conoscenza su fogli di calcolo, slide e PDF, Mistral Large 4 Preview raggiunge 1.393 Elo combinato, come dichiarato nel testo di presentazione. Il grafico lo colloca sopra DeepSeek V4 Pro (1.256) ma sotto Kimi K3 (1.501), MiMo-V2.6-Pro (1.516) e GLM-5.3 (1.510). Mistral Medium 3.5 è a 523.
AA-Briefcase
Combined Elo
Fonte: Mistral AI, valori letti dal grafico ufficiale
Finanza e diritto#
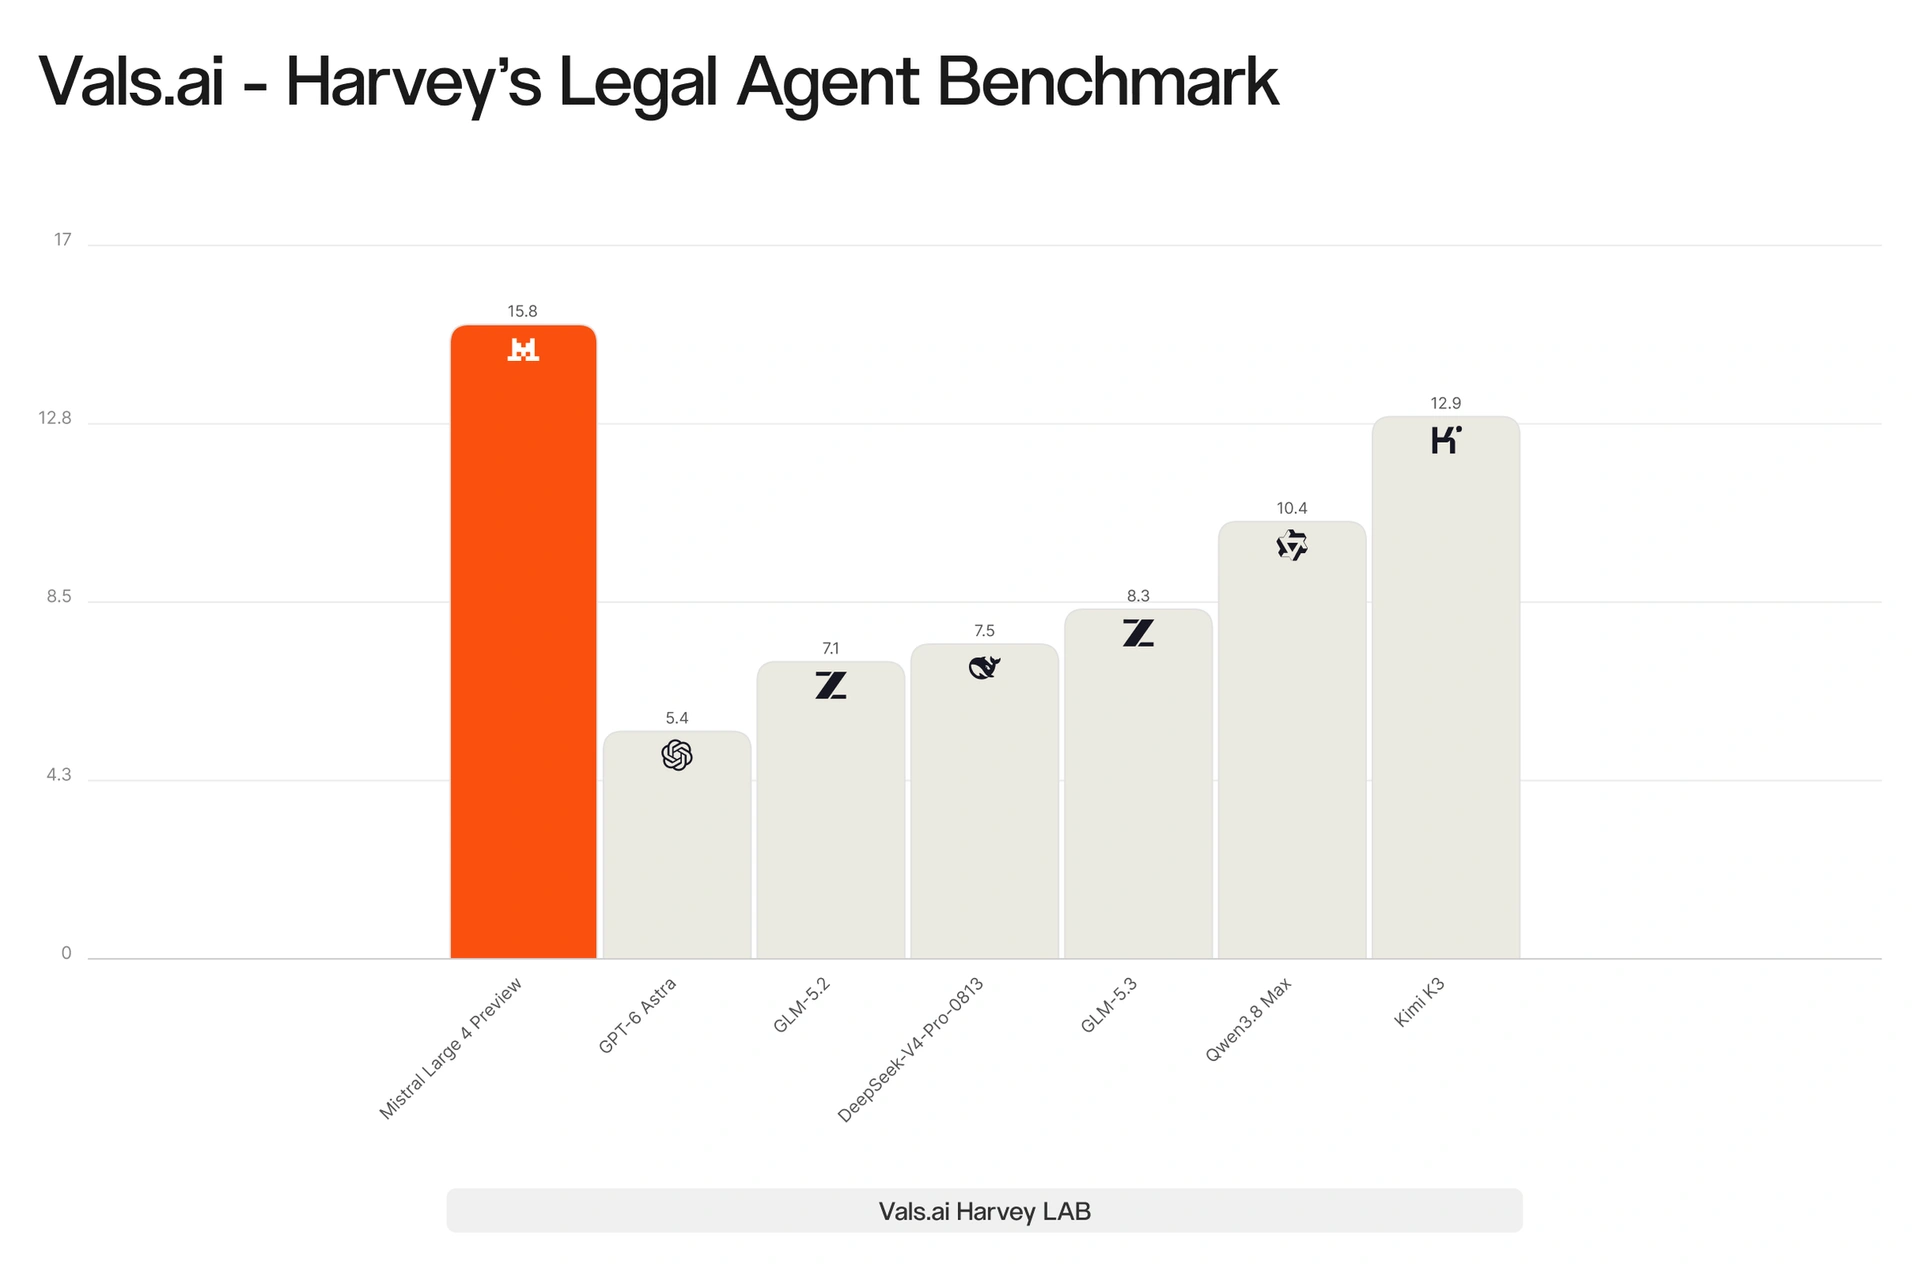
Il produttore dichiara che Mistral Large 4 Preview supera GPT-6 Astra sia in finanza sia nel diritto, e nel test legale di Harvey afferma il primato tra i modelli open-source. Questi tre test usano scale diverse, quindi i grafici sono separati.
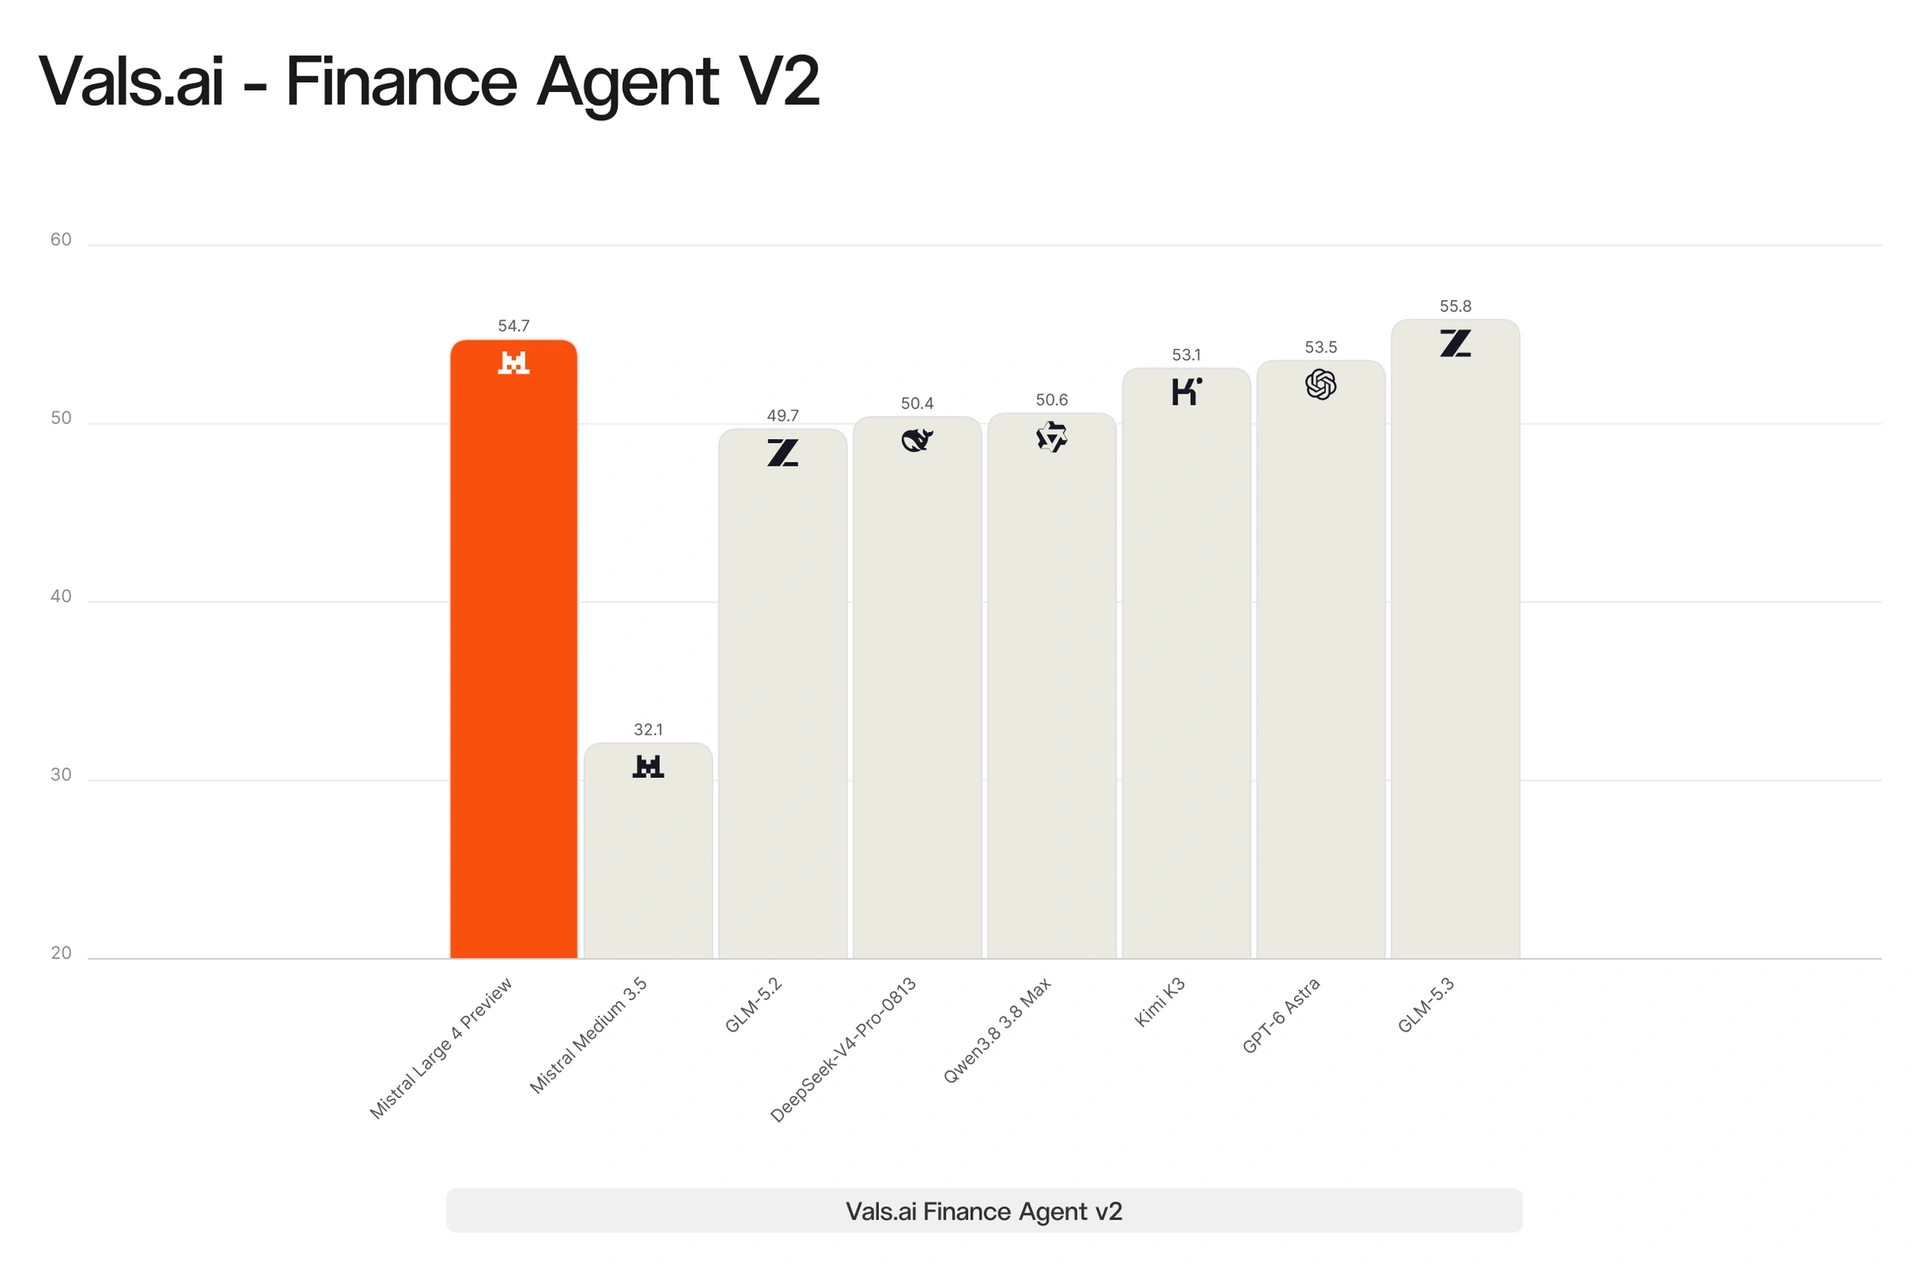
Finanza: Vals.ai Finance Agent v2#
ML4 ottiene 54,7, sopra GPT-6 Astra (53,5) e Kimi K3 (53,1). Il grafico conferma il confronto con GPT-6 Astra, ma mostra GLM-5.3 in testa con 55,8. Mistral Medium 3.5 si ferma a 32,1.
Vals.ai Finance Agent v2
Punteggi dei modelli nel test finanziario
Fonte: Mistral AI, valori letti dal grafico ufficiale
Diritto: Harvey's Legal Agent Benchmark#
ML4 raggiunge 15,8, contro 12,9 di Kimi K3 e 5,4 di GPT-6 Astra, il valore più alto del grafico tra quelli mostrati. Il primato tra gli open-source è una dichiarazione del produttore, basata su questo test.
Harvey's Legal Agent Benchmark
Punteggi dei modelli nel test legale
Fonte: Mistral AI, valori letti dal grafico ufficiale
FinWorkBench (Finch)#
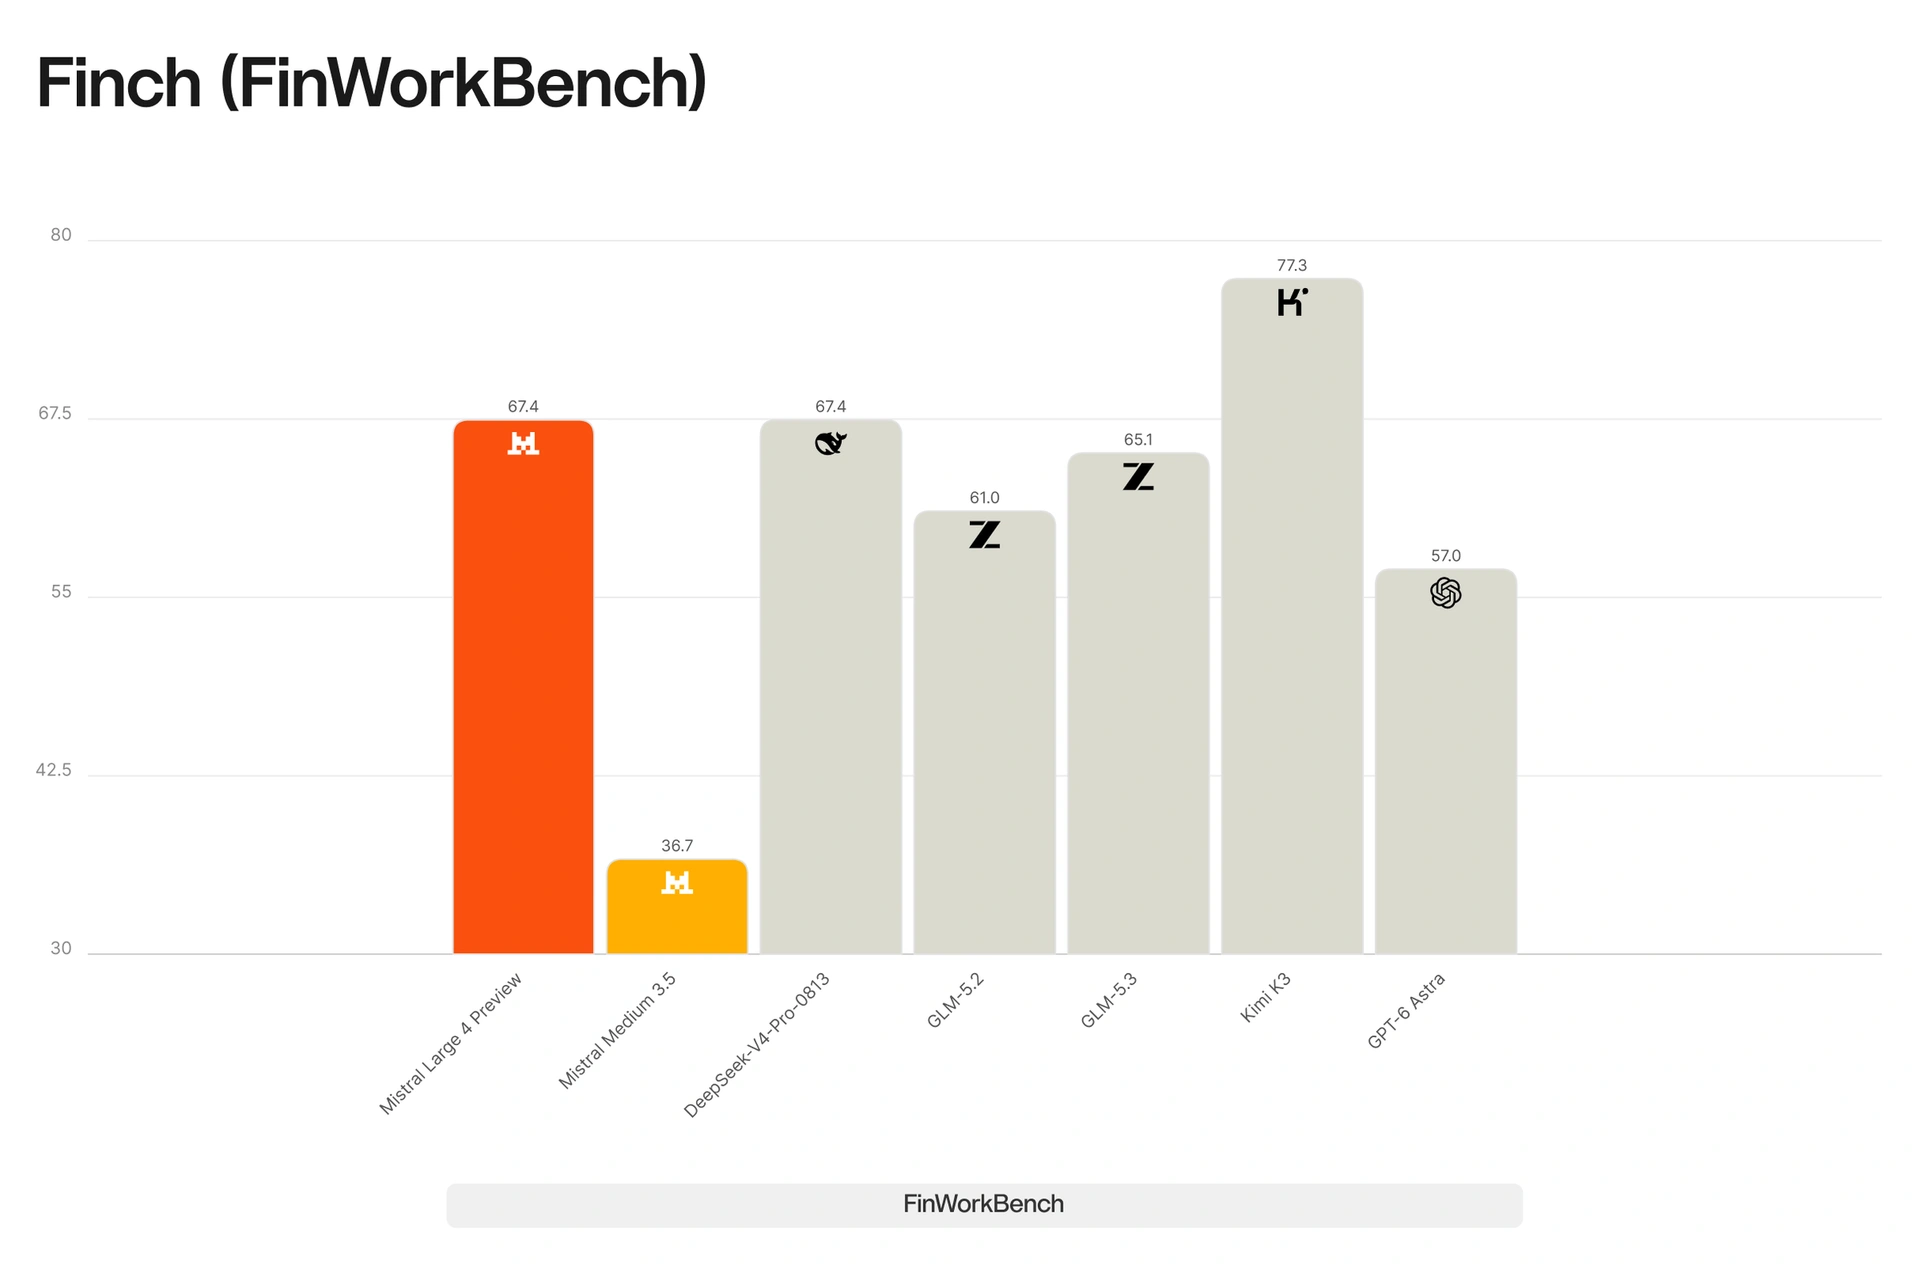
Il test misura la creazione e la modifica di fogli di calcolo su casi reali di finanza e contabilità. ML4 e DeepSeek-V4-Pro-0813 pareggiano a 67,4, mentre Kimi K3 arriva a 77,3 e GPT-6 Astra a 57.
Finch (FinWorkBench)
Punteggi dei modelli nel test su fogli di calcolo finanziari
Fonte: Mistral AI, valori letti dal grafico ufficiale
Coding: SWE-Atlas e valutazione umana#
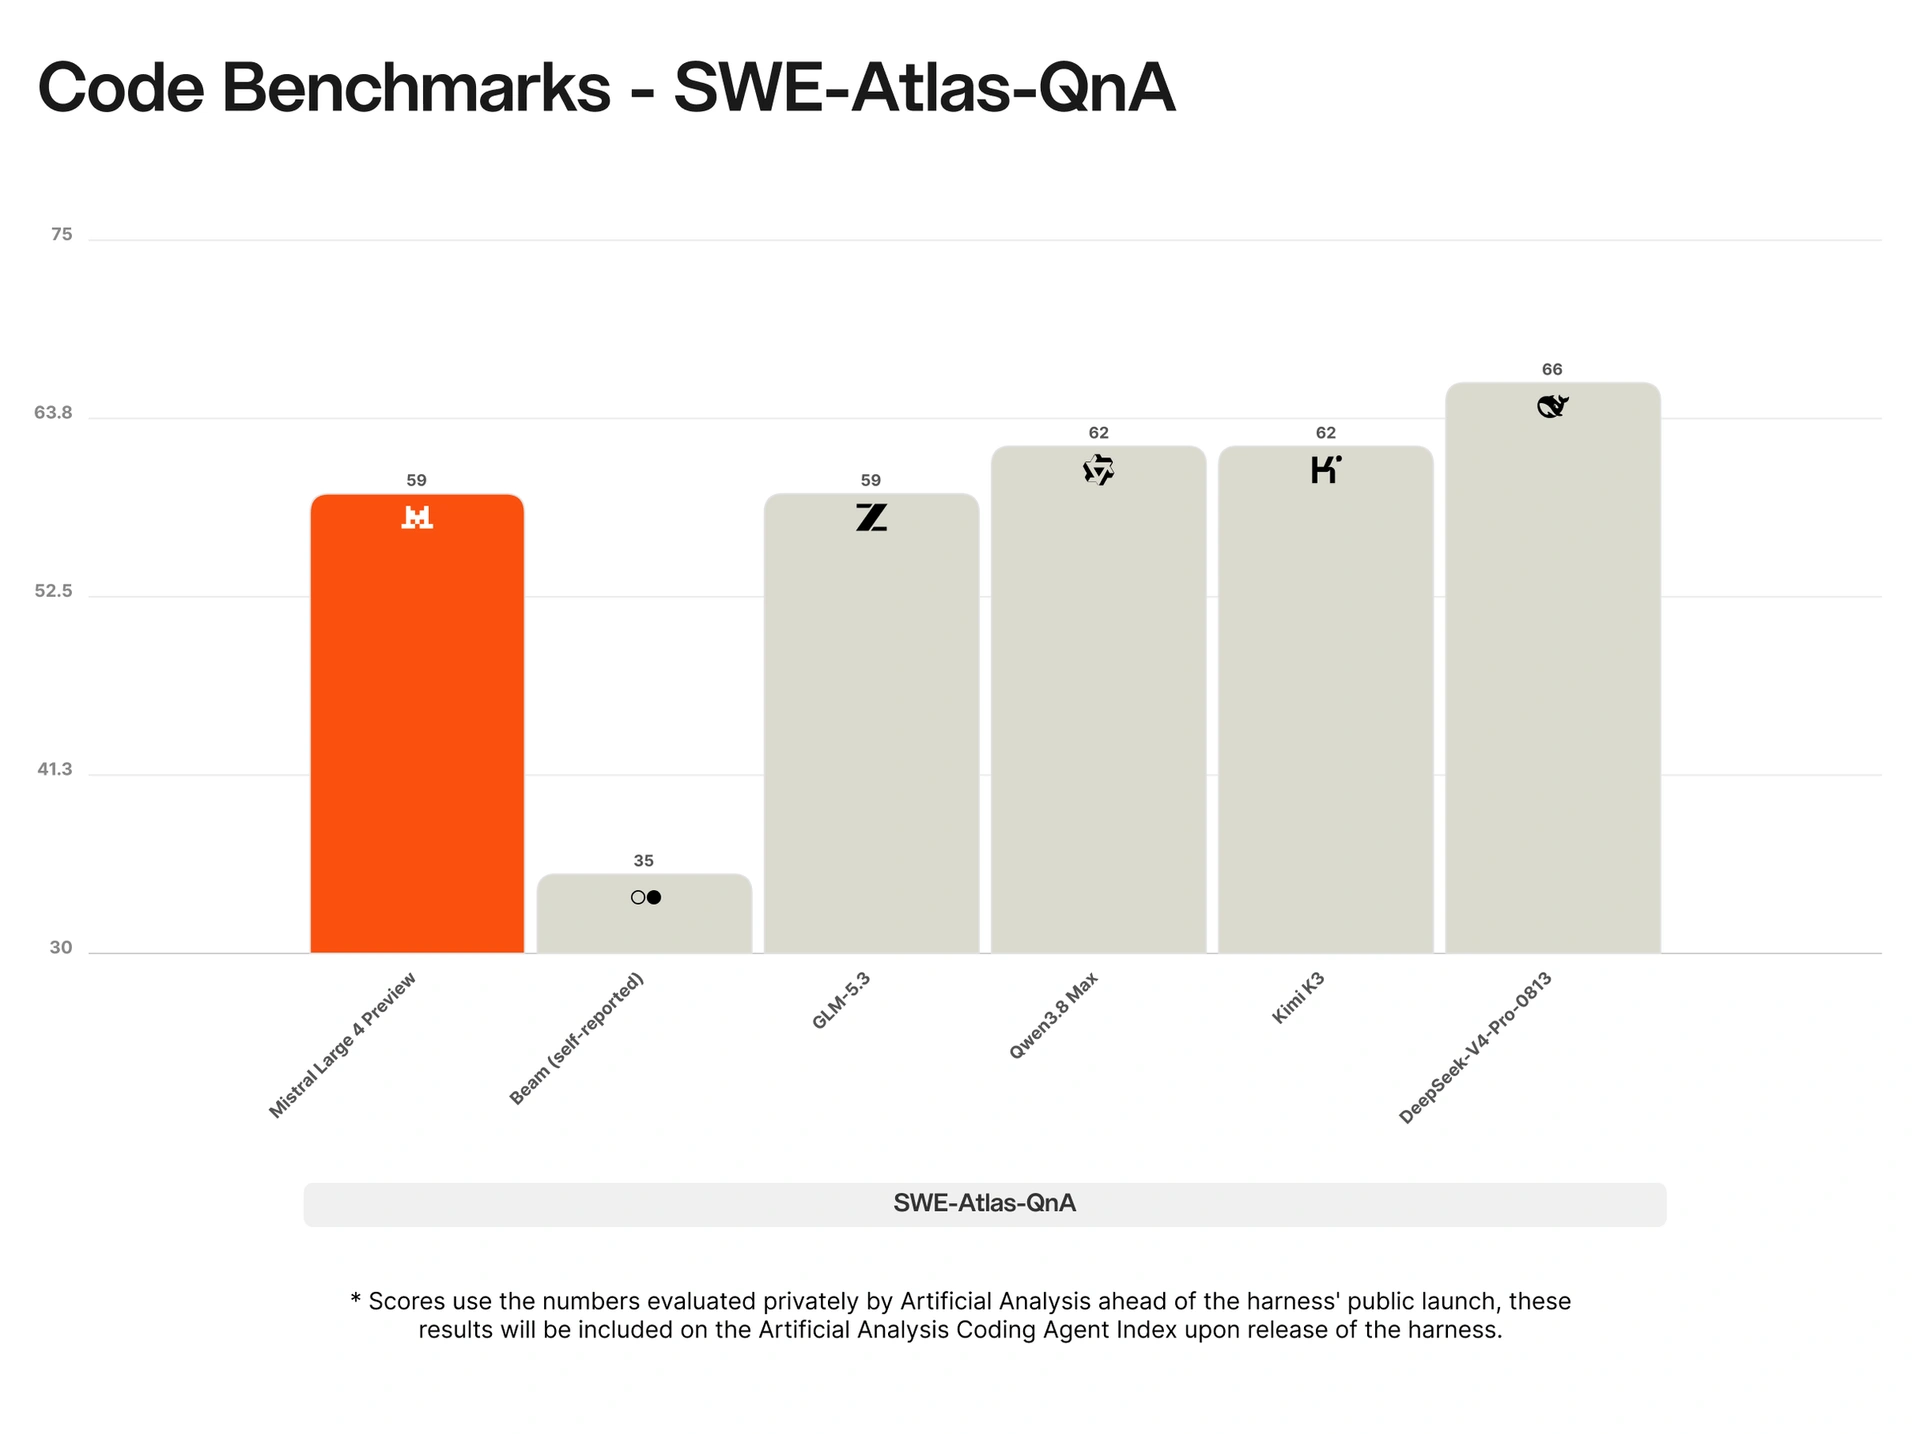
SWE-Atlas-QnA#
Mistral dichiara 59,4% su SWE-Atlas-QnA, uno dei tre risultati di coding agentico citati nel comunicato. Nel grafico ufficiale il valore è riportato come 59, mentre 66 spetta a DeepSeek-V4-Pro-0813, il punteggio più alto del gruppo.
SWE-Atlas-QnA
Punteggi per modello
Fonte: Mistral AI, valori letti dal grafico ufficiale
Modello | SWE-Atlas-QnA |
|---|---|
Mistral Large 4 Preview | 59 |
Beam (self-reported) | 35 |
GLM-5.3 | 59 |
Qwen3.8 Max | 62 |
Kimi K3 | 62 |
DeepSeek-V4-Pro-0813 | 66 |
Valori letti dal grafico ufficiale SWE-Atlas-QnA di Mistral. Fonte: Mistral AI.
Valutazione umana di Surge AI#
Annotatori professionisti di Surge AI hanno valutato la qualità del codice su una scala da 1 a 5, senza conoscere l'identità dei modelli. ML4 Preview ottiene 3,74, secondo su cinque modelli: davanti a GLM-5.3 (3,60), Kimi K3 (3,59) e GLM-5.2 (3,40), dietro solo a Claude Opus 5 (4,22).
Modello | Punteggio (1–5) |
|---|---|
Mistral Large 4 Preview | 3.7 |
GLM-5.2 | 3.4 |
Kimi K3 | 3.6 |
GLM-5.3 | 3.6 |
Opus 5 | 4.2 |
Valori letti dal grafico ufficiale della valutazione umana di Surge AI sul codice. Fonte: Mistral AI.
Visione e documenti#
Visione e documenti#
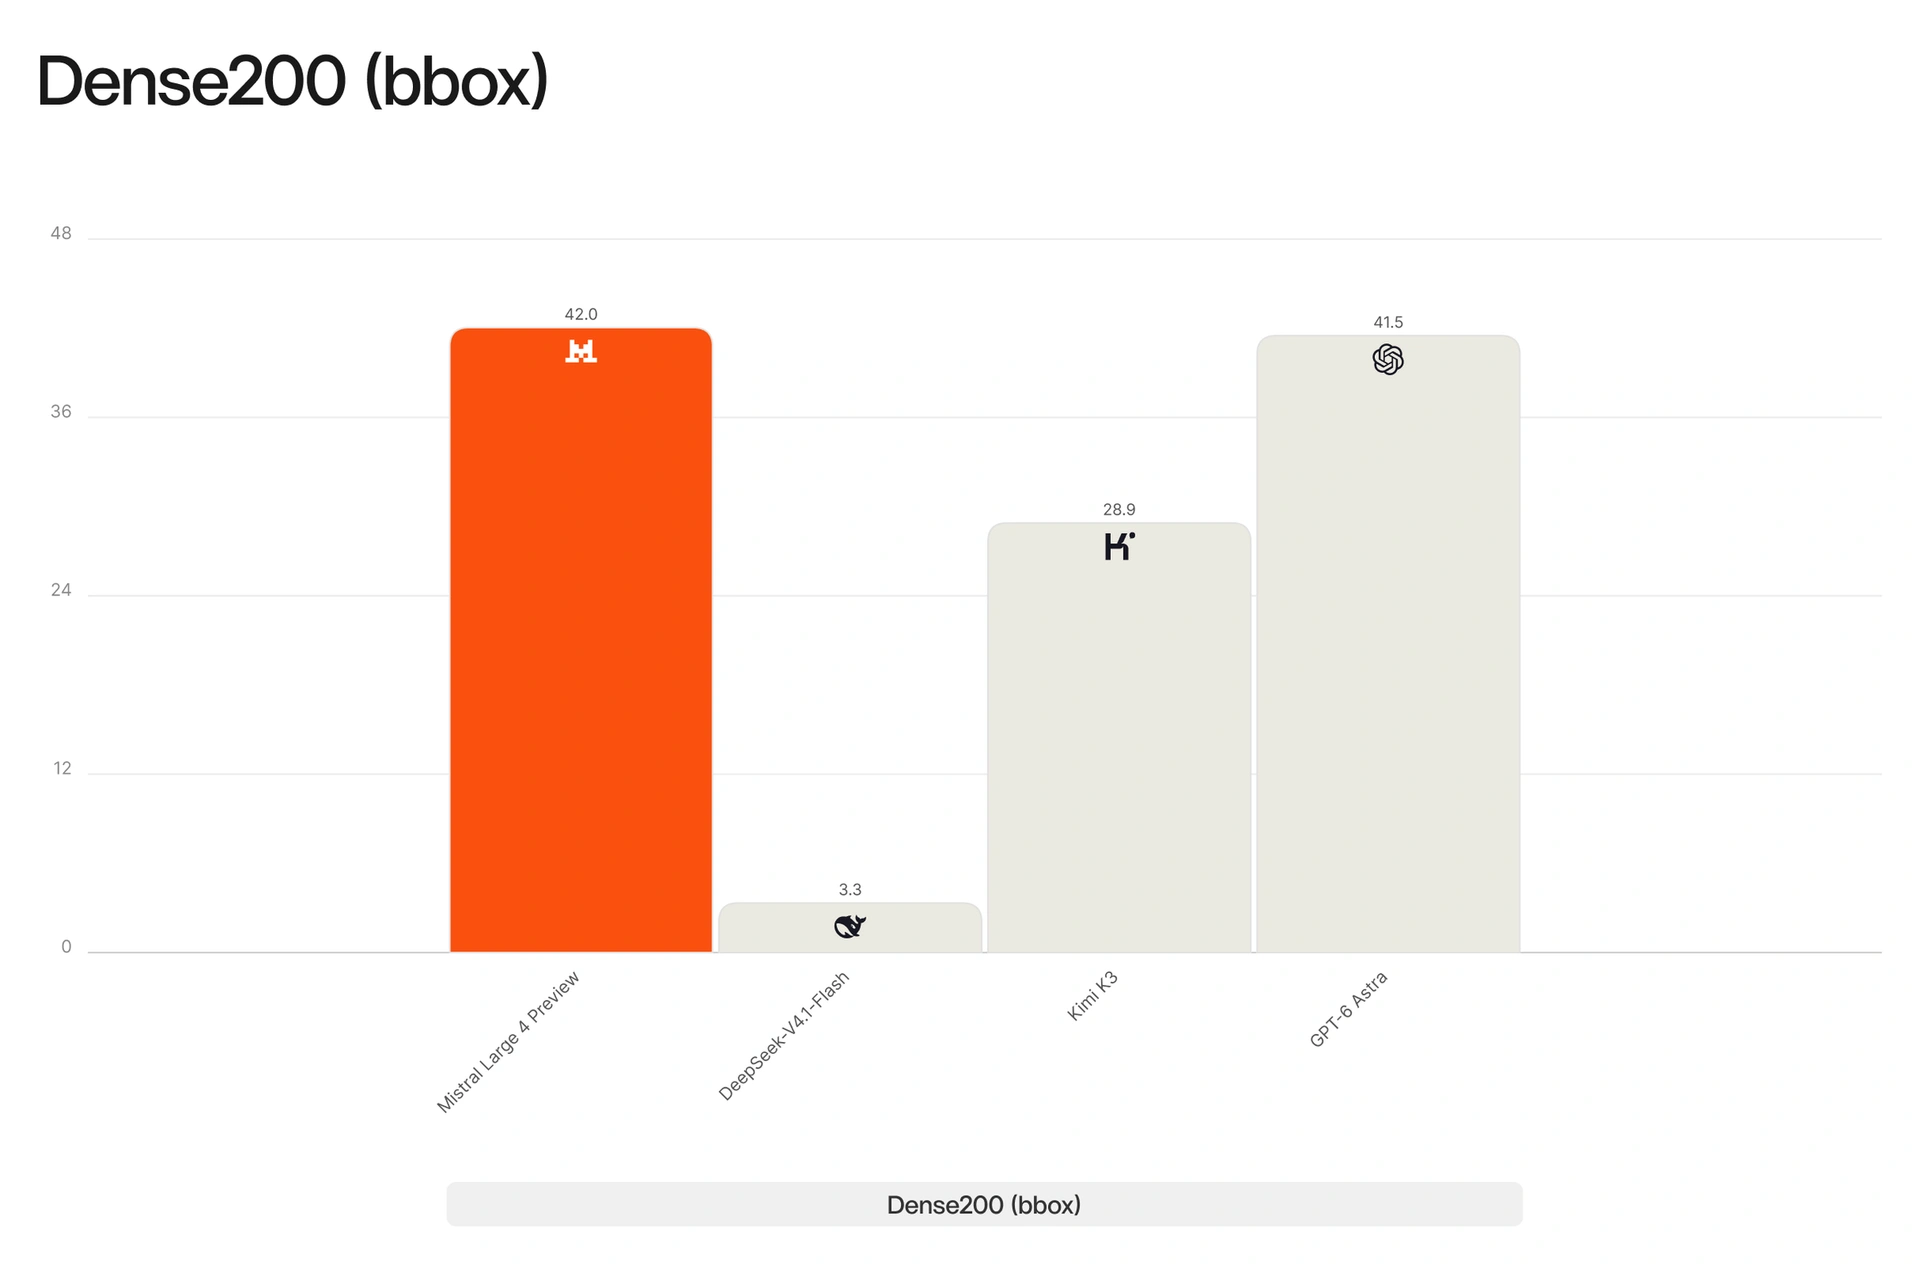
Per Mistral la visione è un punto di forza dichiarato. Nel test Dense200 (rilevamento di bounding box), il produttore riporta 42% per Mistral Large 4 Preview contro 41% di GPT-6 Astra, secondo la pagina di Mistral. Il grafico ufficiale mostra 42 per ML4 e 41,5 per GPT-6 Astra.
Dense200 (bbox)
Punteggi per modello, grafico ufficiale di Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
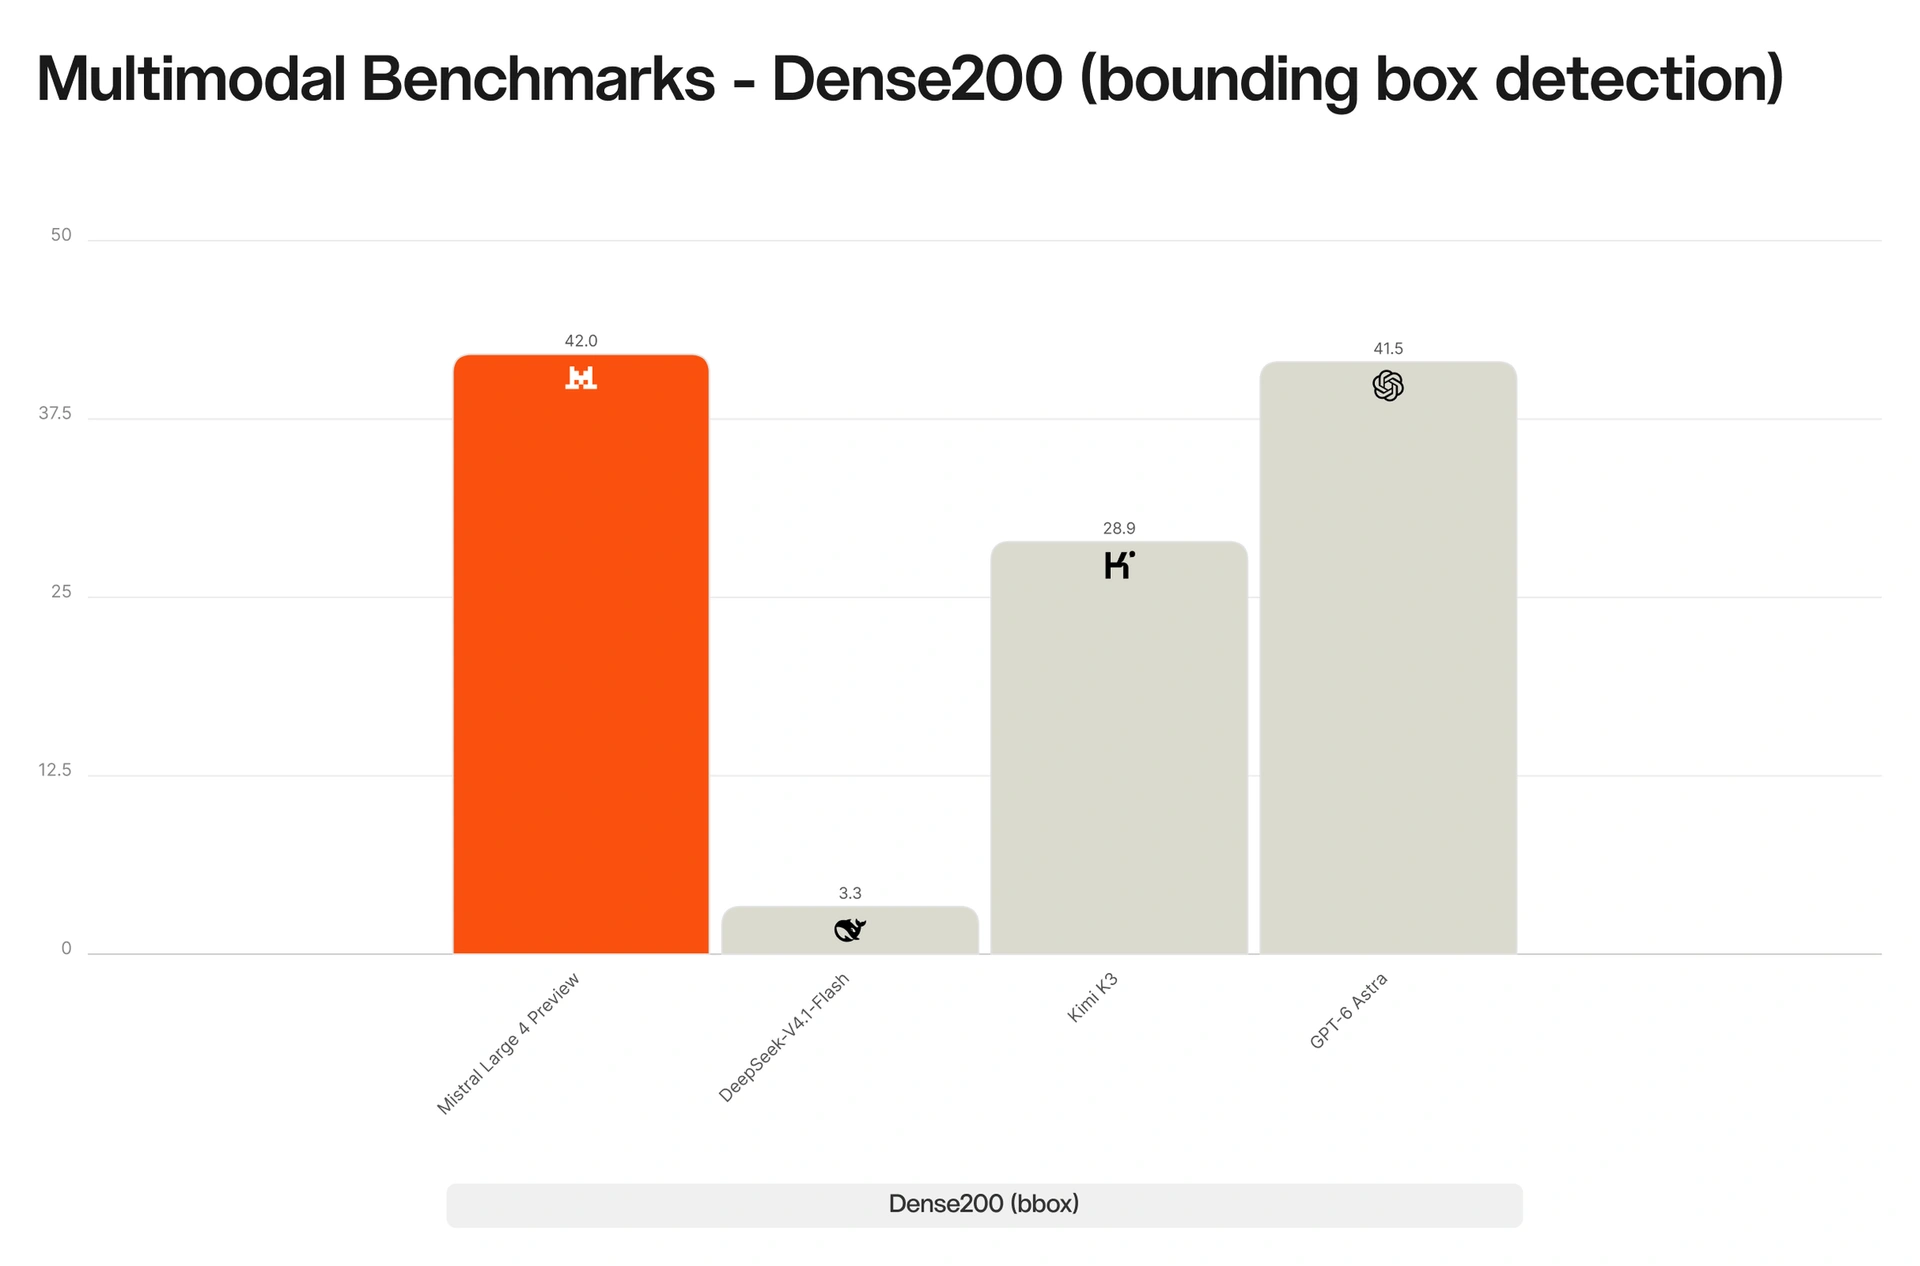
La versione multimodale dello stesso test, con la stessa scala di punteggi, riporta gli stessi valori per ML4, GPT-6 Astra, Kimi K3 e DeepSeek-V4.1-Flash.
Dense200 (bounding box detection), versione multimodale
Punteggi per modello, grafico ufficiale di Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
Su ChartQA Pro ML4 segna 63.1, dietro a GPT-6 Astra (65.1) e davanti a Kimi K3 (61.7). Su GDP.pdf di Artificial Analysis ML4 ottiene 18.6, contro i 22 di Kimi K3.
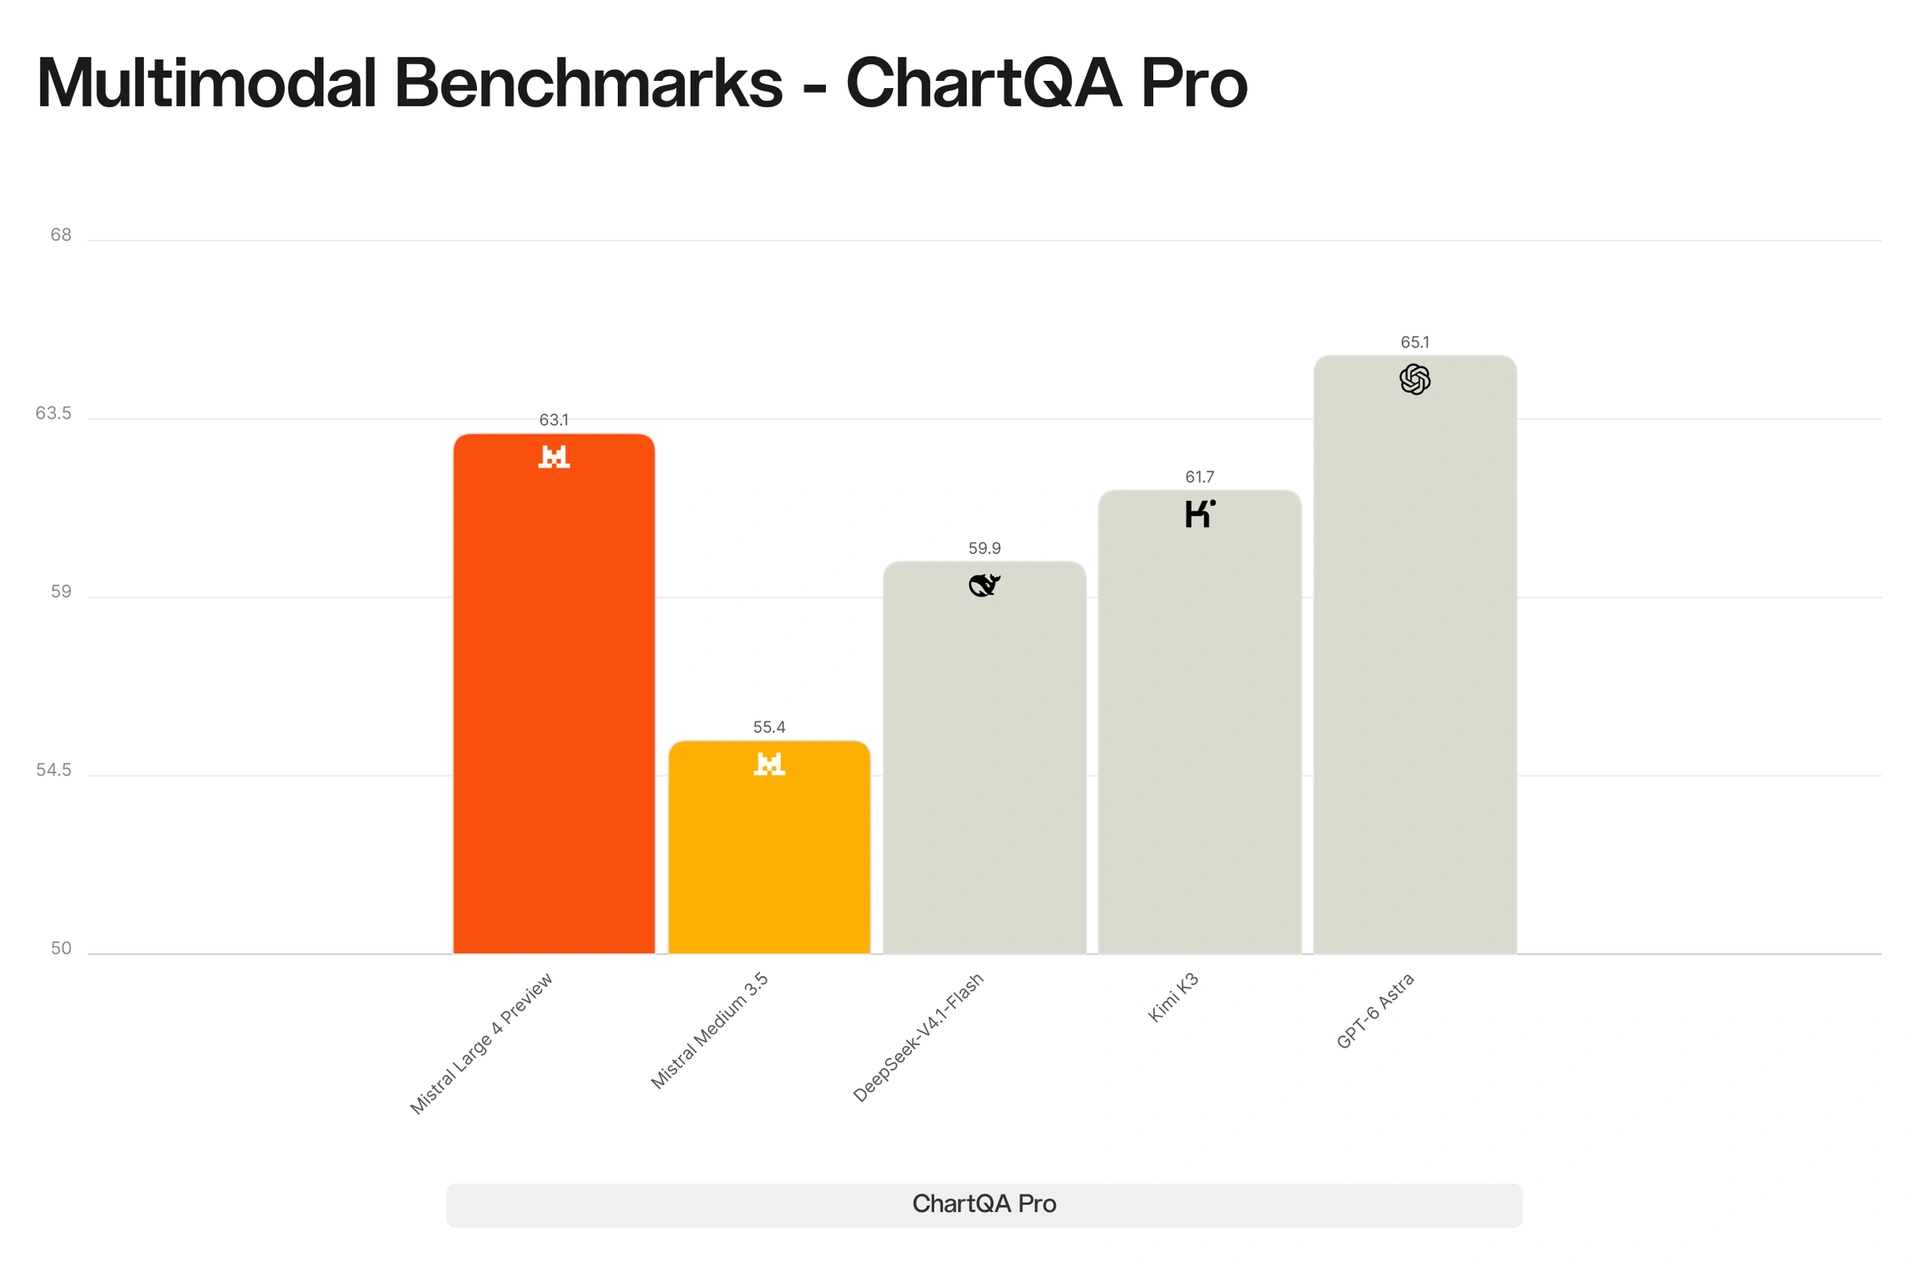
ChartQA Pro
Punteggi per modello, grafico ufficiale di Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
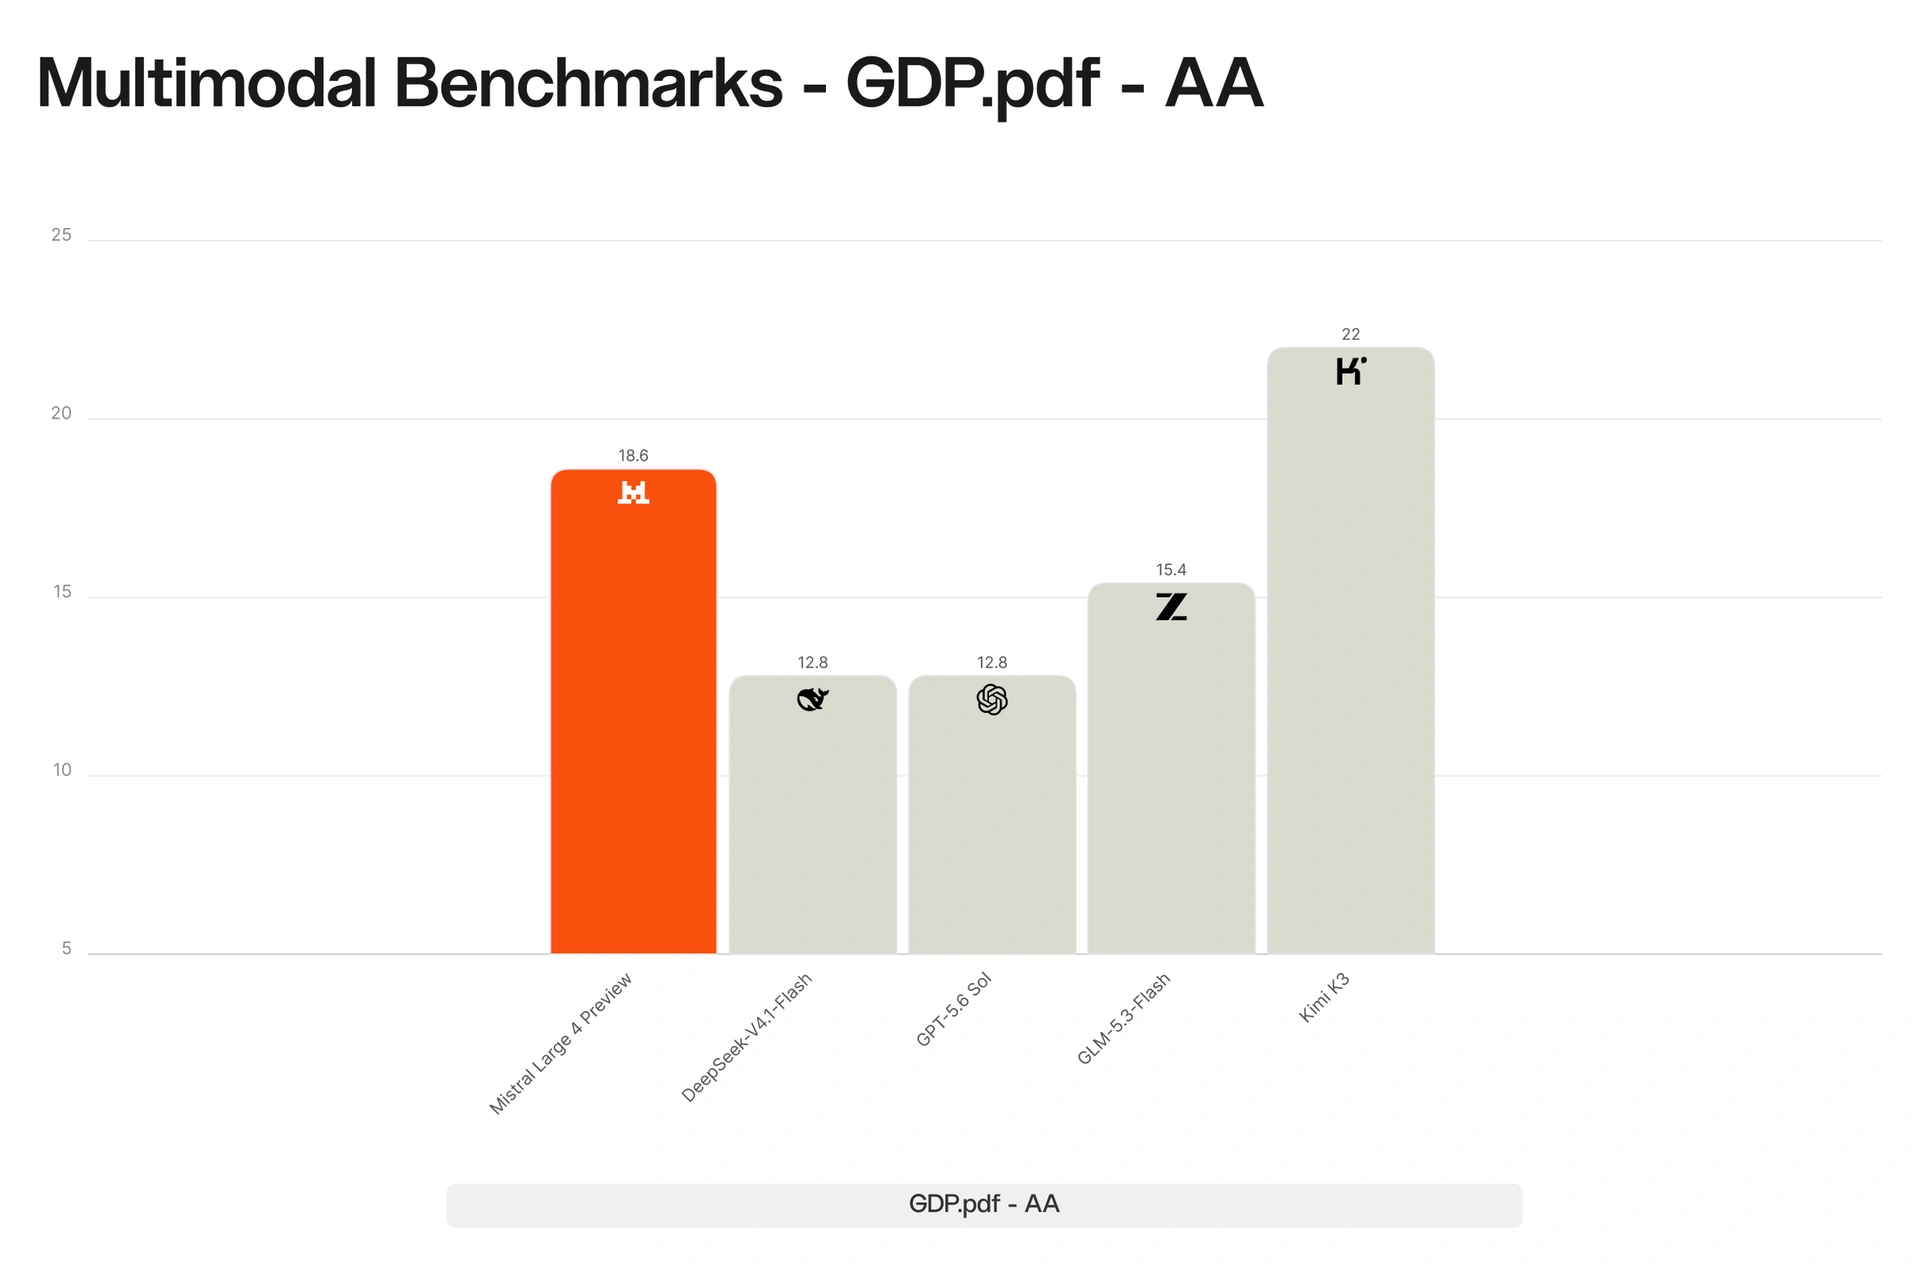
GDP.pdf - Artificial Analysis
Punteggi per modello, grafico ufficiale di Mistral
Fonte: Mistral AI, valori letti dal grafico ufficiale
Scienza e matematica#
SciCode-Verified#
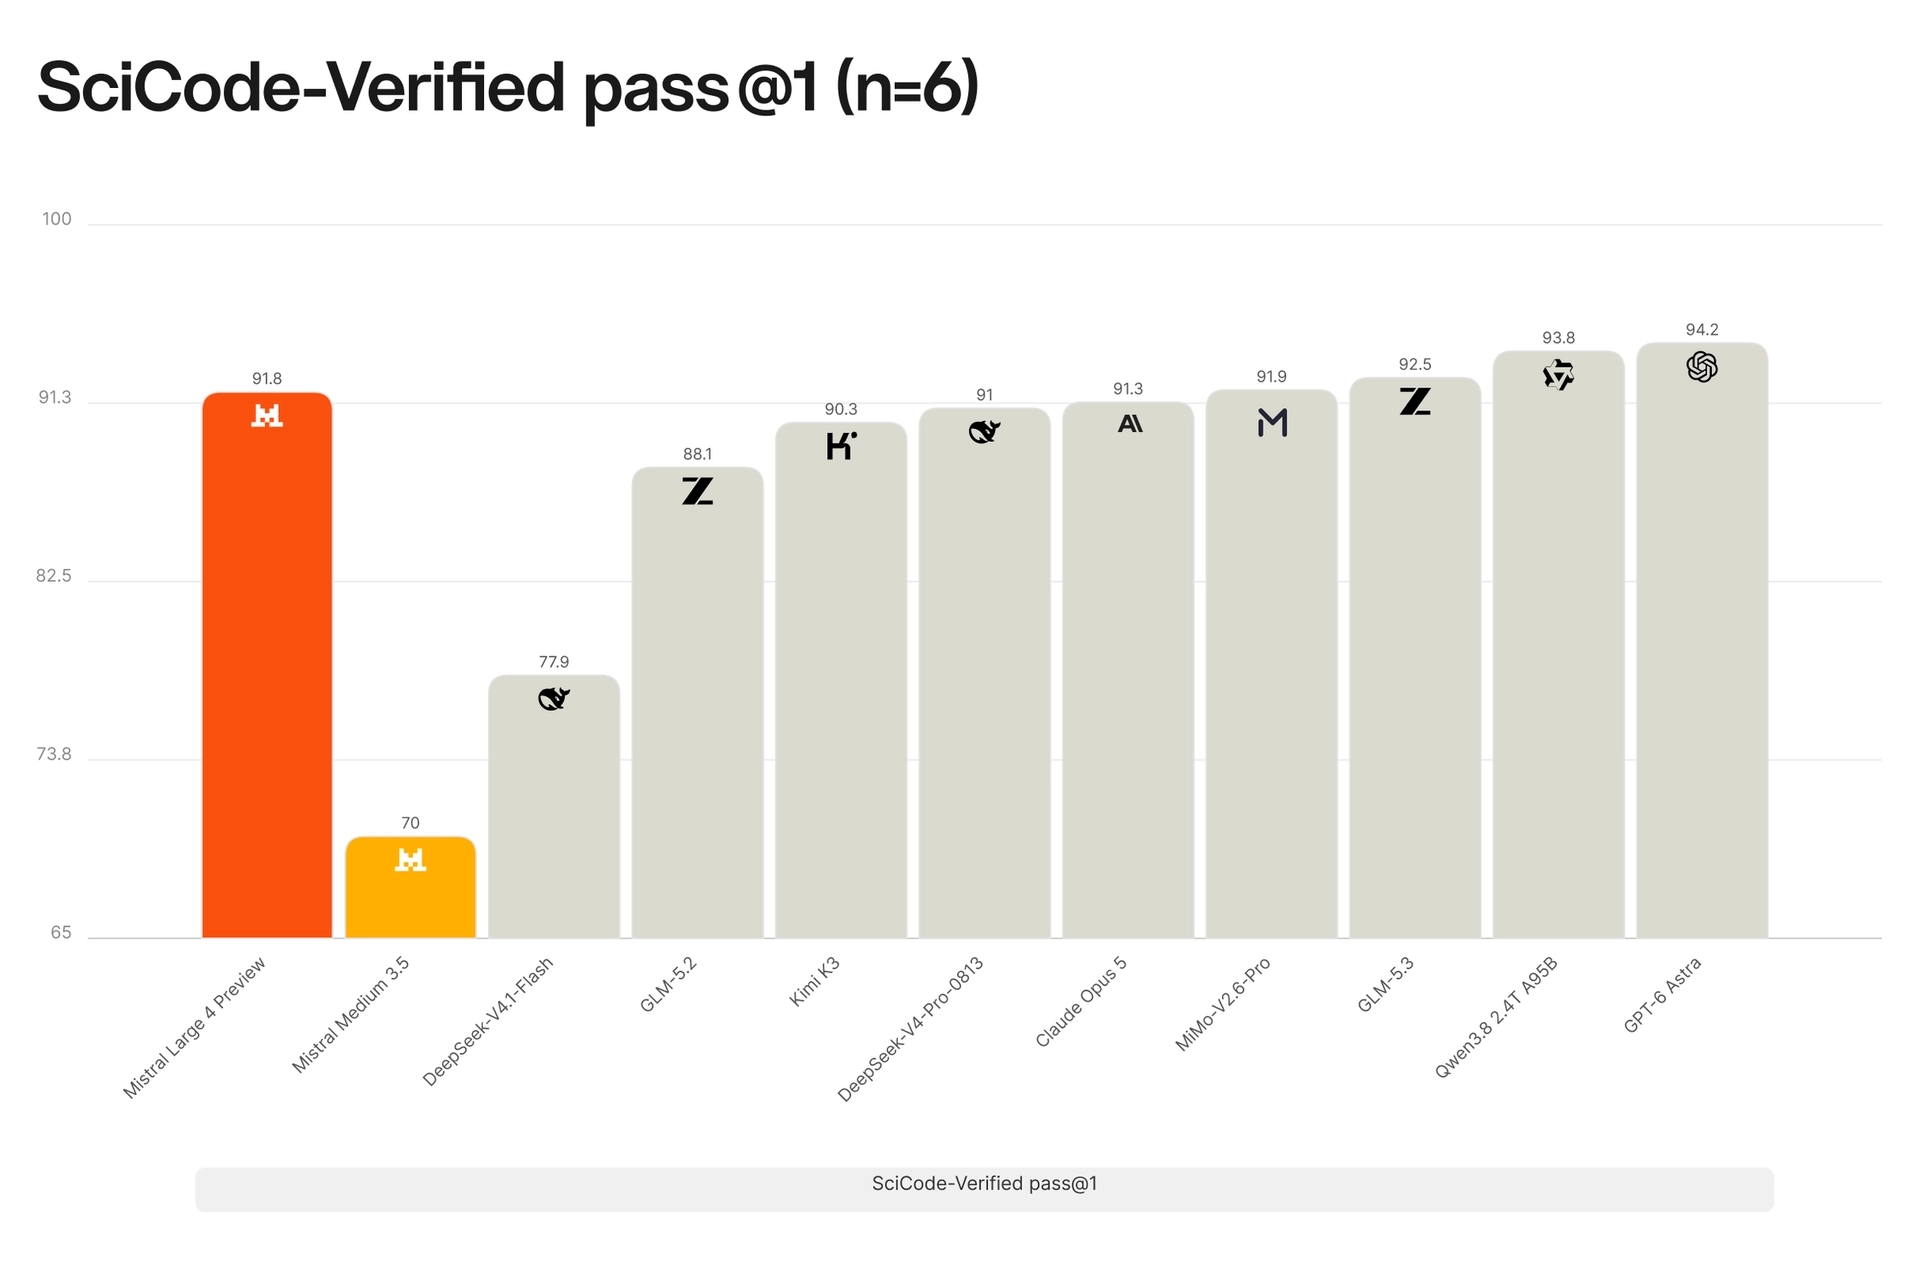
Su SciCode-Verified pass@1 (n=6), test sull'implementazione in codice di flussi di lavoro scientifici in fisica, matematica, scienza dei materiali e biologia, Mistral Large 4 Preview ottiene 91,8. Il produttore dichiara il primato tra i modelli open-weight, ma nel grafico Qwen3.8 2.4T A95B arriva a 93,8 e GPT-6 Astra a 94,2; la fonte non indica quali modelli siano open-weight. Dettagli nella fonte.
SciCode-Verified pass@1 (n=6)
Punteggio per modello
Fonte: Mistral AI, valori letti dal grafico ufficiale
STEM contro GLM-5.3#
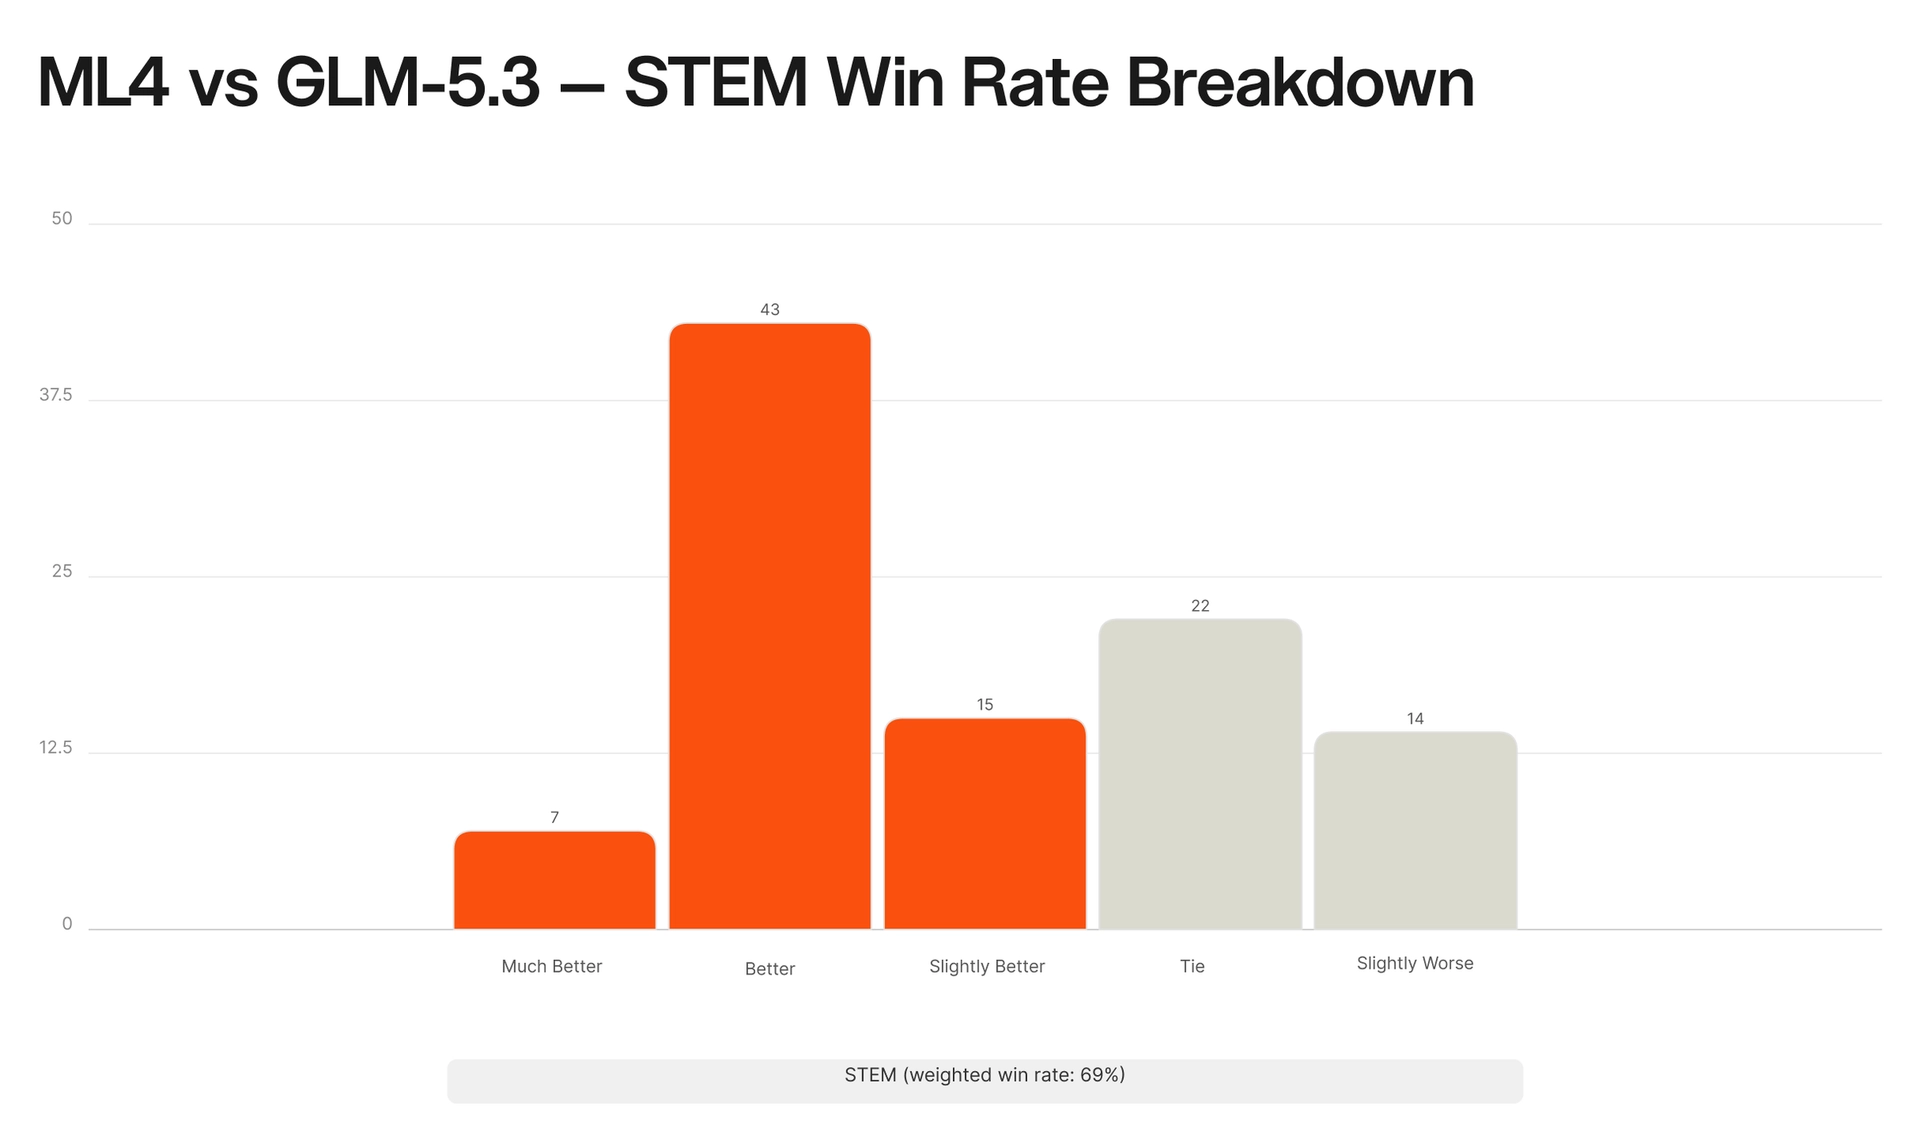
Il secondo grafico è una valutazione interna di Mistral, non indipendente, su matematica e fisica, confrontando ML4 con GLM-5.3 tramite annotatori esperti. La categoria più frequente è «Better» con 43, seguita da «Tie» con 22 e «Slightly Better» con 15; «Much Better» è 7 e «Slightly Worse» è 14. Il produttore afferma che ML4 è stato preferito nelle valutazioni STEM.
ML4 vs GLM-5.3 — STEM
Distribuzione dei giudizi, valutazione interna
Fonte: Mistral AI, valori letti dal grafico ufficiale
Sicurezza del modello#
Resistenza agli attacchi#
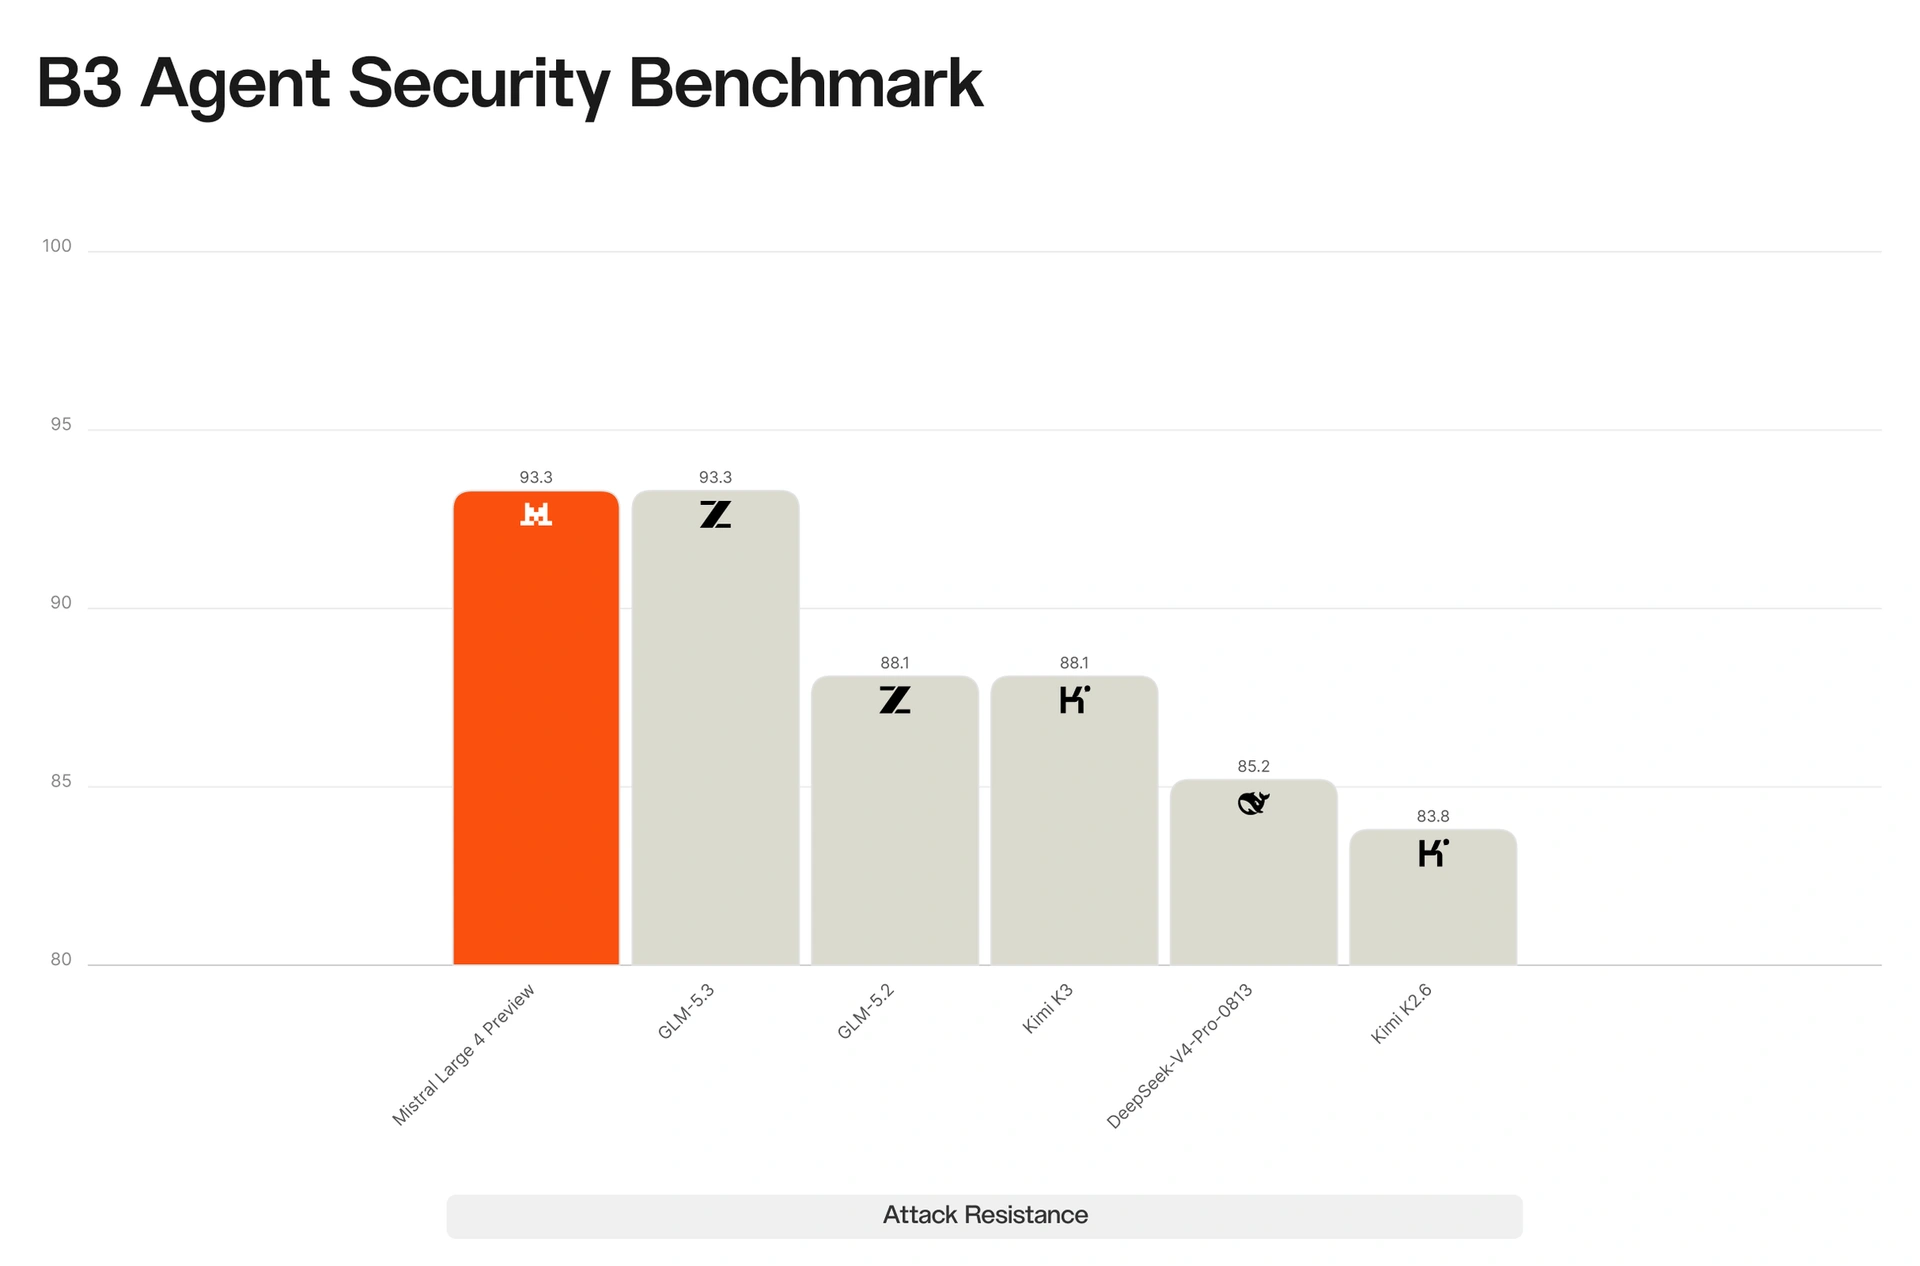
Nel B3 Agent Security Benchmark di Lakera, la percentuale di attacchi respinti è 93,3% per Mistral Large 4 Preview e per GLM-5.3, appaiati in cima. GLM-5.2 e Kimi K3 si fermano a 88,1%. Il produttore sostiene che ML4 resiste al 93,3% degli attacchi e che nessun concorrente ottiene un valore superiore.
B3 Agent Security Benchmark
Attack Resistance
Fonte: Mistral AI, valori letti dal grafico ufficiale
Rifiuto di richieste cyber dannose#
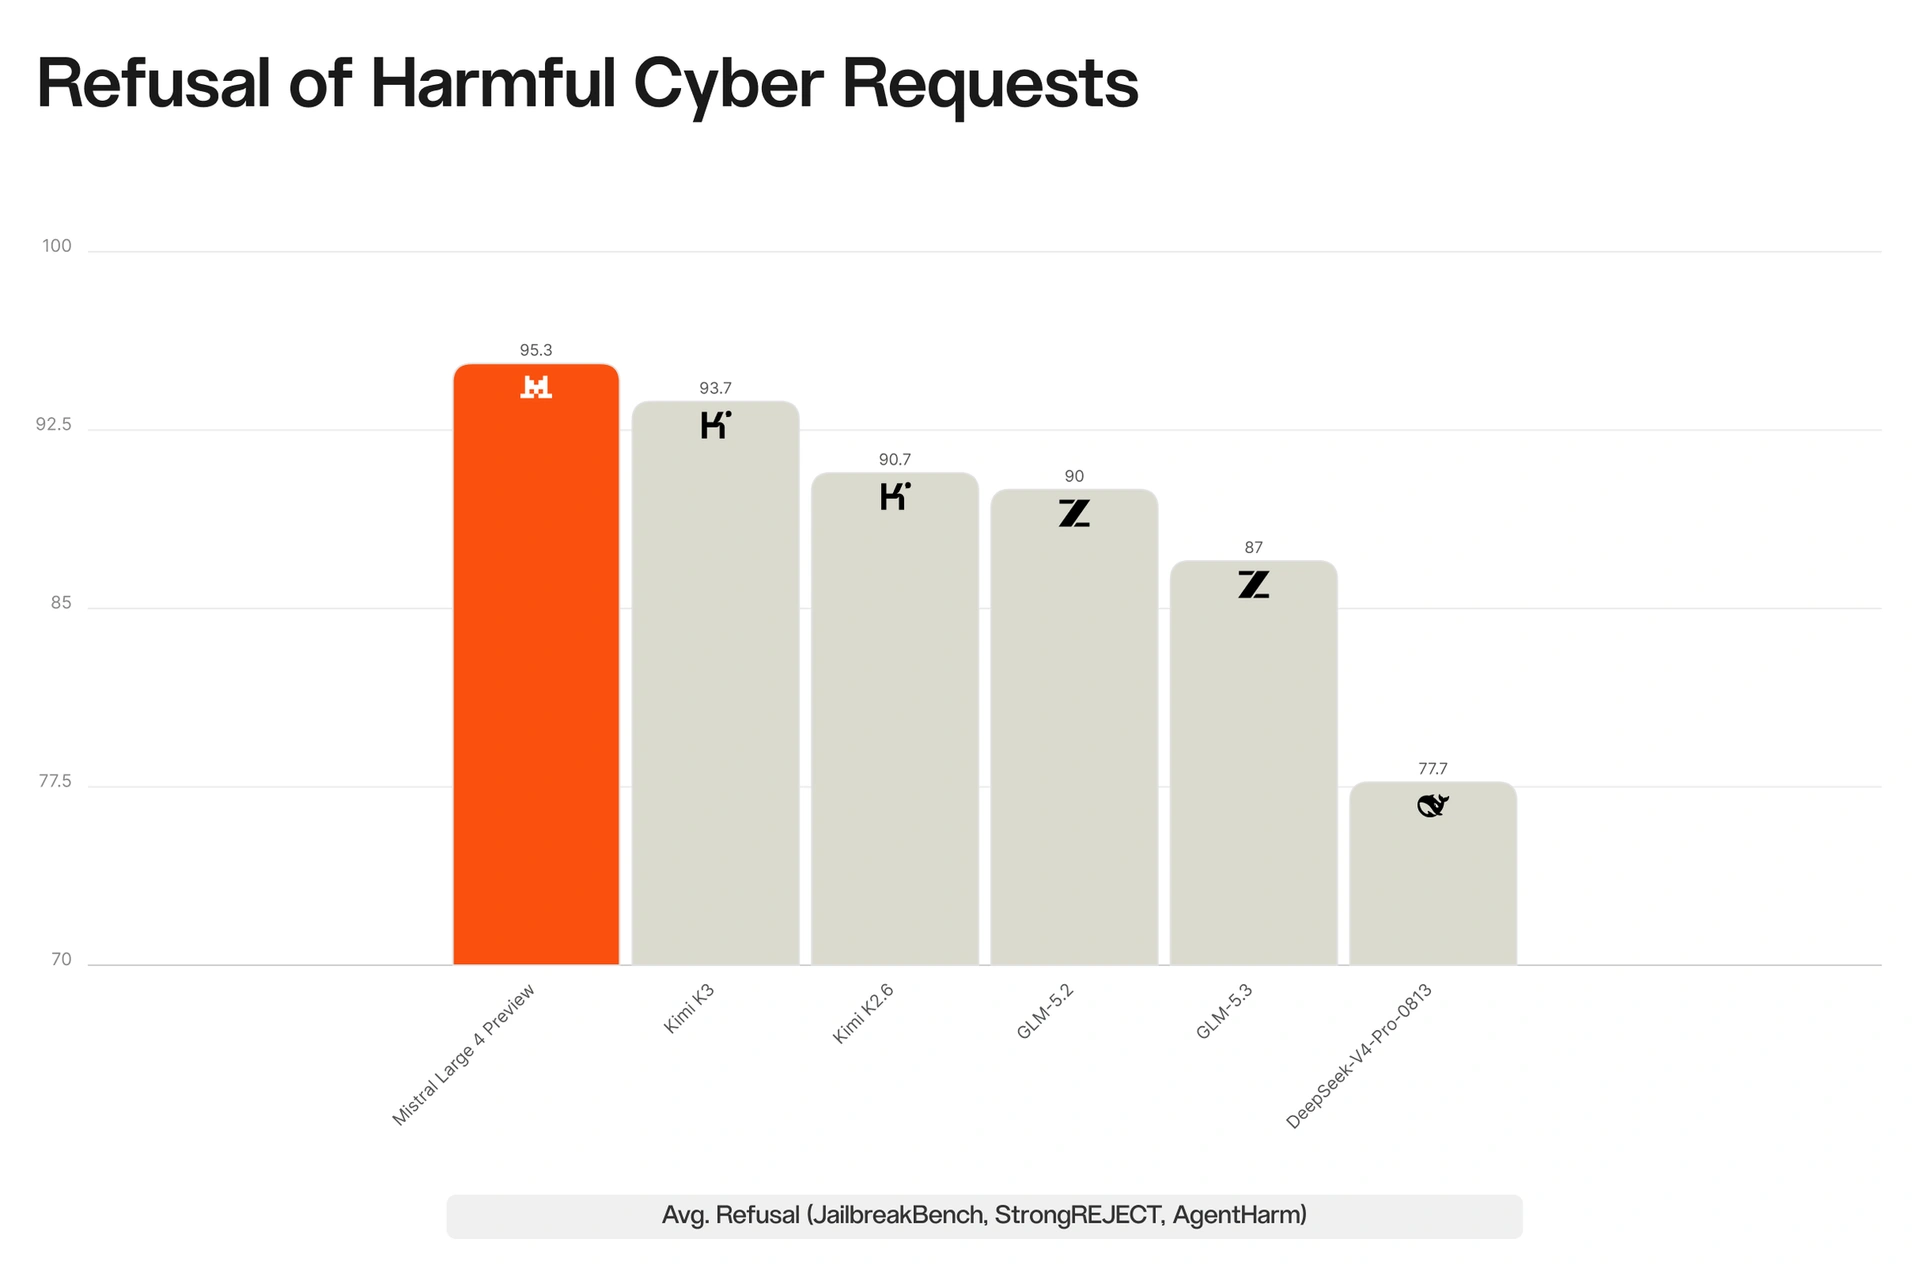
Nella media su JailbreakBench, StrongREJECT e AgentHarm, ML4 rifiuta il 95,3% delle richieste cyber dannose, il valore più alto tra i modelli open-source confrontati dal produttore. Kimi K3 è il più vicino, mentre DeepSeek-V4-Pro-0813, fermo a 77,7%, chiude la graduatoria. La scala dell'asse parte da 70, quindi le distanze visive risultano amplificate.
Refusal of Harmful Cyber Requests
Avg. Refusal (JailbreakBench, StrongREJECT, AgentHarm)
Fonte: Mistral AI, valori letti dal grafico ufficiale
Punteggio KORA#
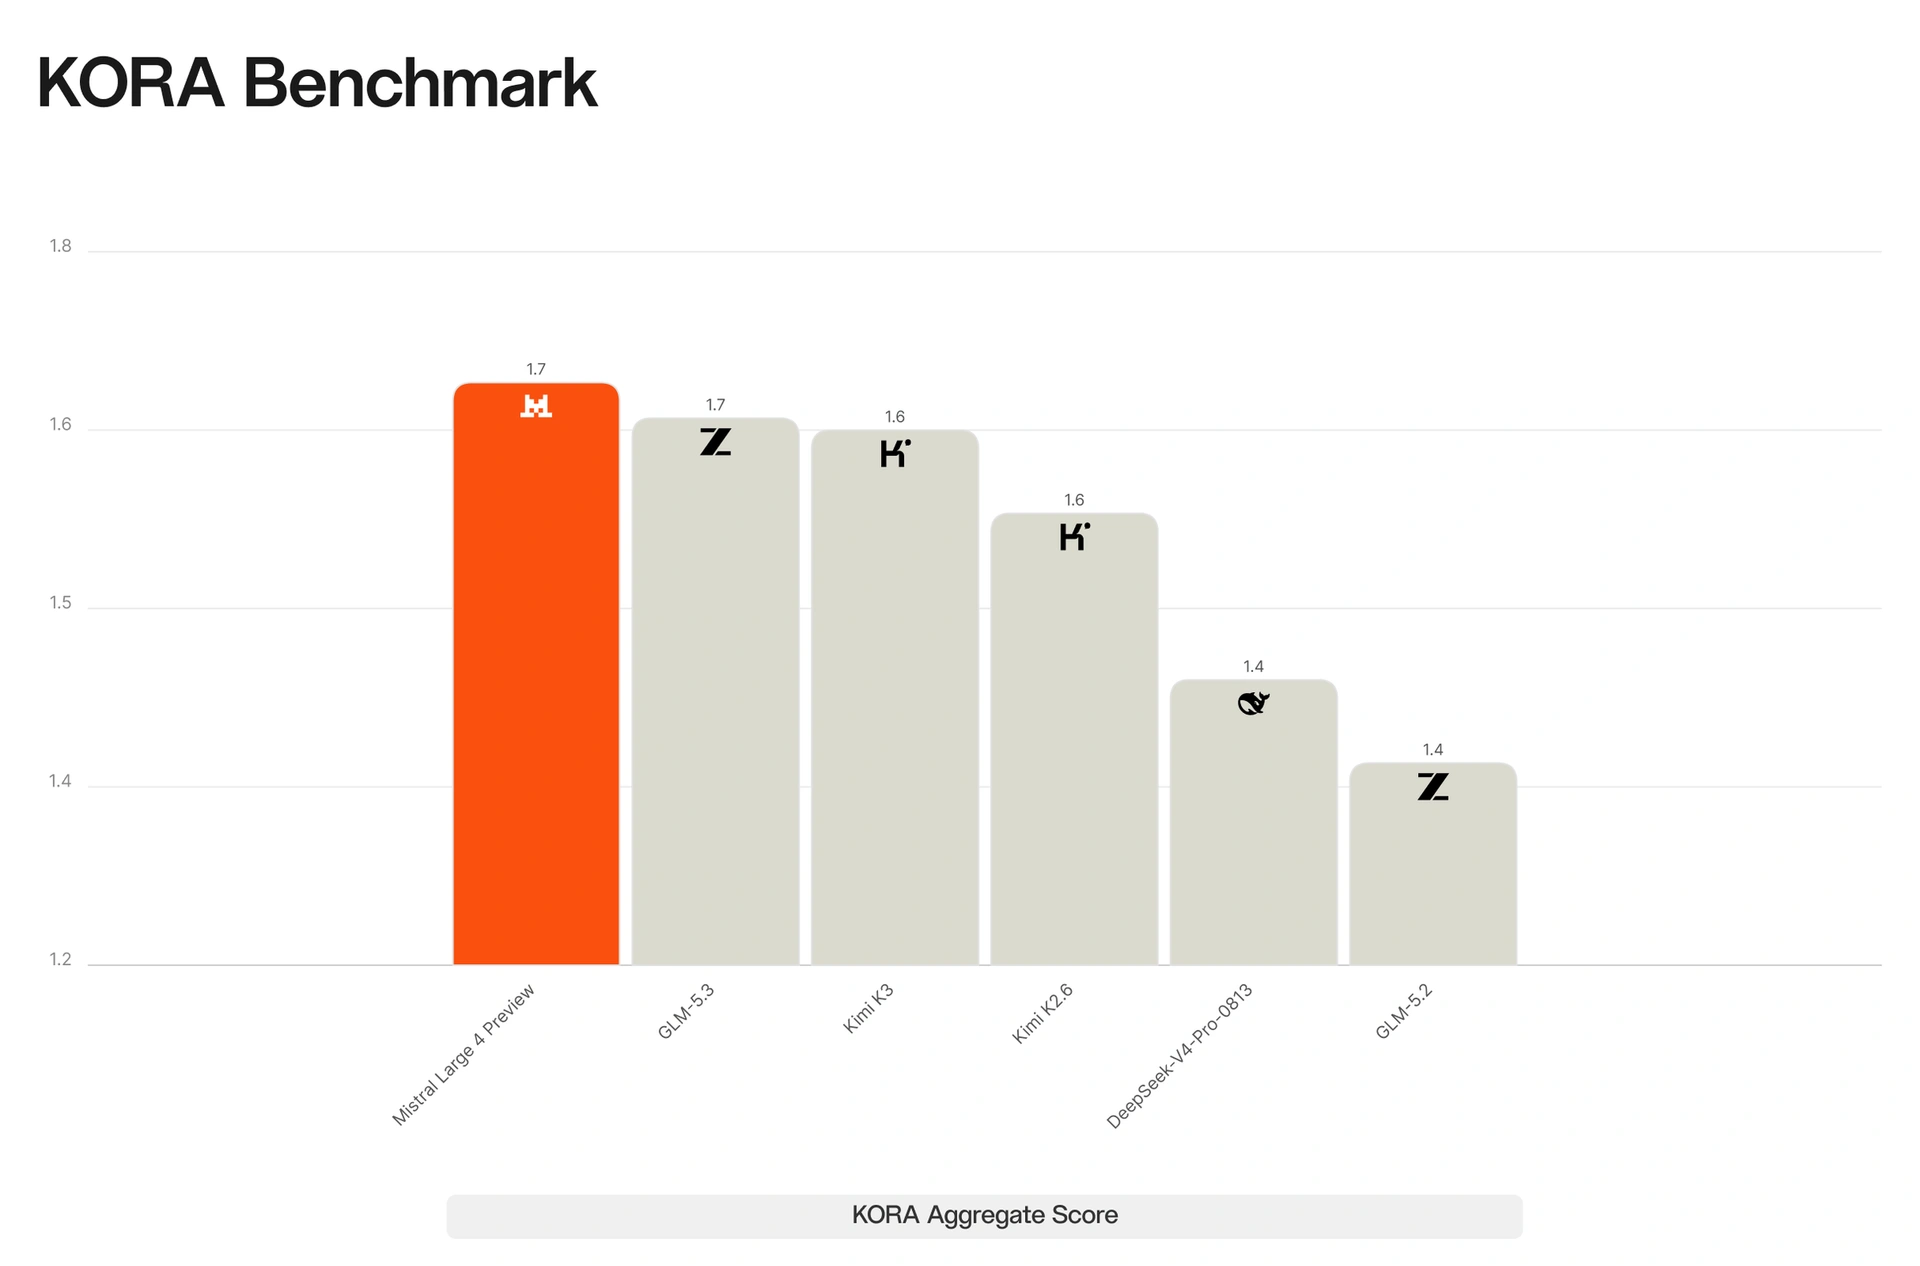
Nel KORA Benchmark il punteggio massimo è 2, denominato «Exemplary». Nel grafico ML4 e GLM-5.3 compaiono entrambi a 1,7», arrotondato a una cifra decimale. Il testo del produttore riporta per ML4 il valore 1,691, indicato come il più alto tra i modelli open-source misurati.
KORA Benchmark
KORA Aggregate Score
Fonte: Mistral AI, valori letti dal grafico ufficiale
Valutazione umana: vittorie e sconfitte#
Valutazione umana: vittorie e sconfitte#
Mistral descrive un confronto interno con annotatori esperti su programmazione, CAD, finanza, matematica e fisica. Mistral Large 4 (ML4) è stato preferito in CAD e STEM e si colloca alla pari o vicino a GLM-5.3 in finanza e programmazione (fonte).
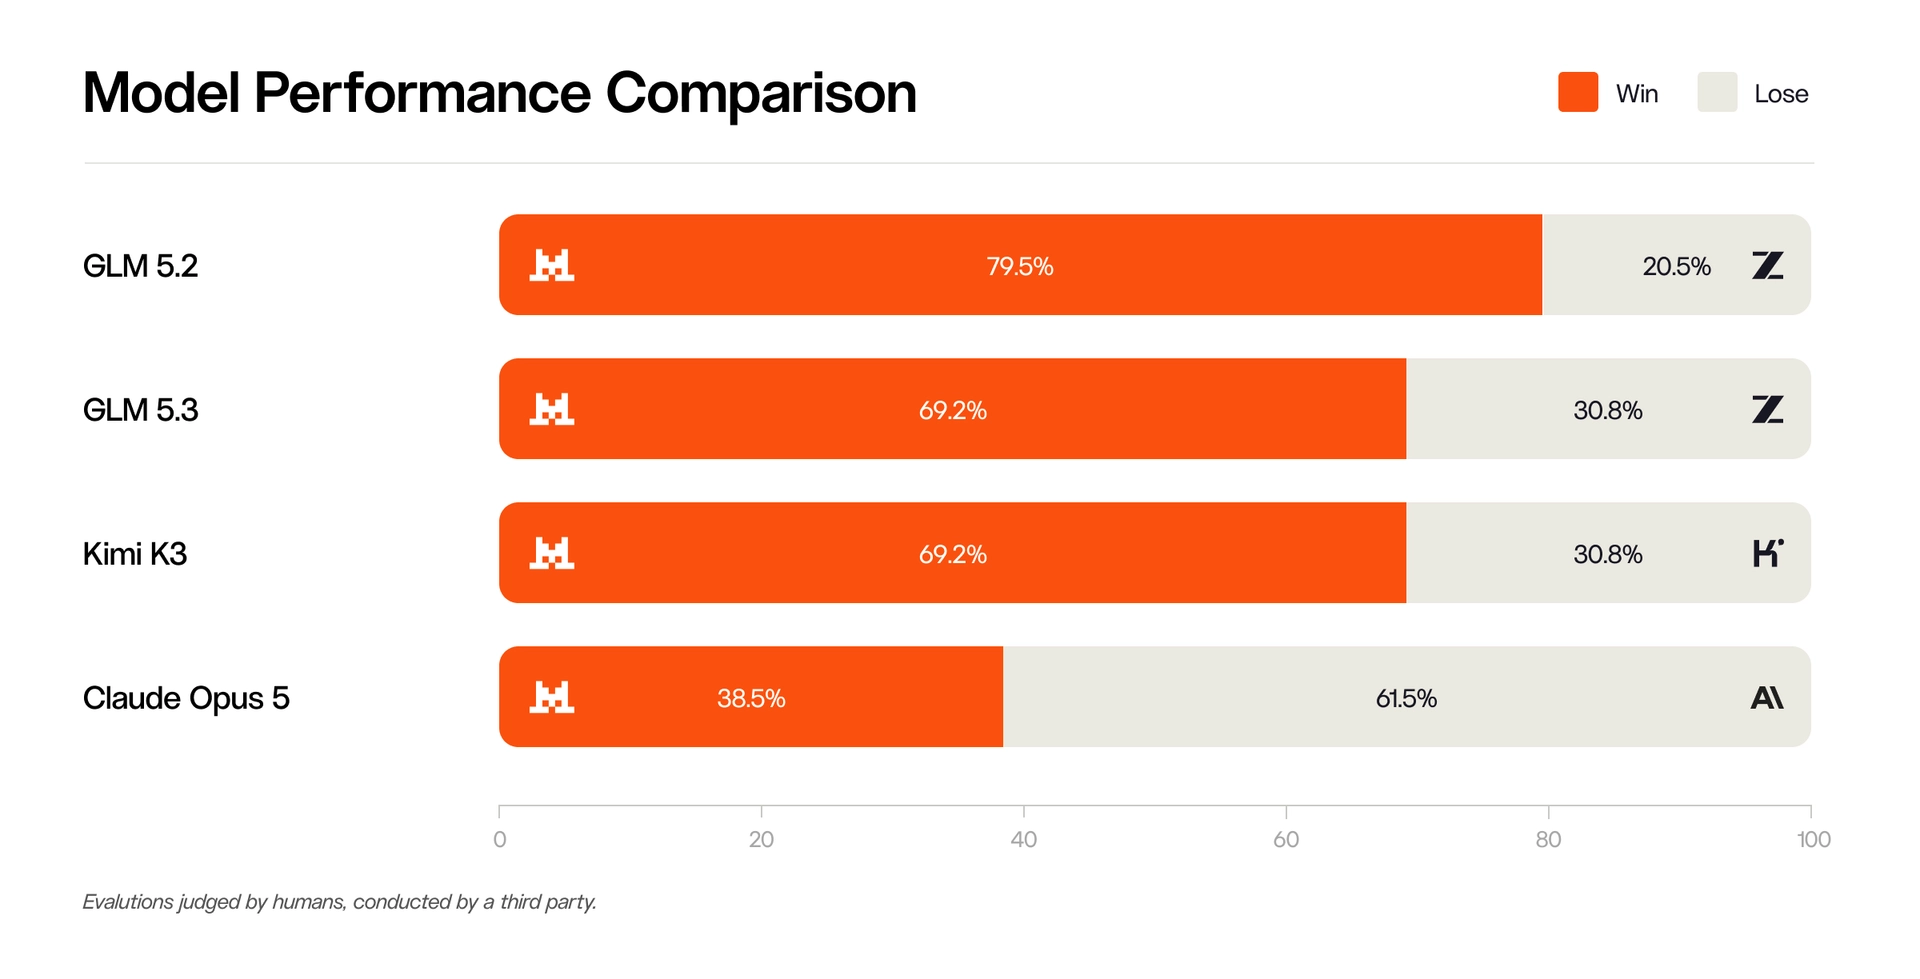
Model Performance Comparison: Win e Lose
Quota di vittorie e sconfitte per modello
- Win (%)
- Lose (%)
Fonte: Mistral AI, valori letti dal grafico ufficiale
Il grafico mostra 79,5% di Win per GLM 5.2, 69,2% per GLM 5.3 e Kimi K3, e 38,5% per Claude Opus 5. Non indica contro quale modello sono calcolate le percentuali. La nota della fonte parla di valutazioni condotte da una terza parte, mentre il testo di Mistral descrive una valutazione interna.
Modello | Win (%) | Lose (%) |
|---|---|---|
GLM 5.2 | 79.5 | 20.5 |
GLM 5.3 | 69.2 | 30.8 |
Kimi K3 | 69.2 | 30.8 |
Claude Opus 5 | 38.5 | 61.5 |
Win e Lose per modello nel grafico Model Performance Comparison. Fonte: Mistral AI.
Apprendimento per rinforzo su scala#
Come funziona il post-training#
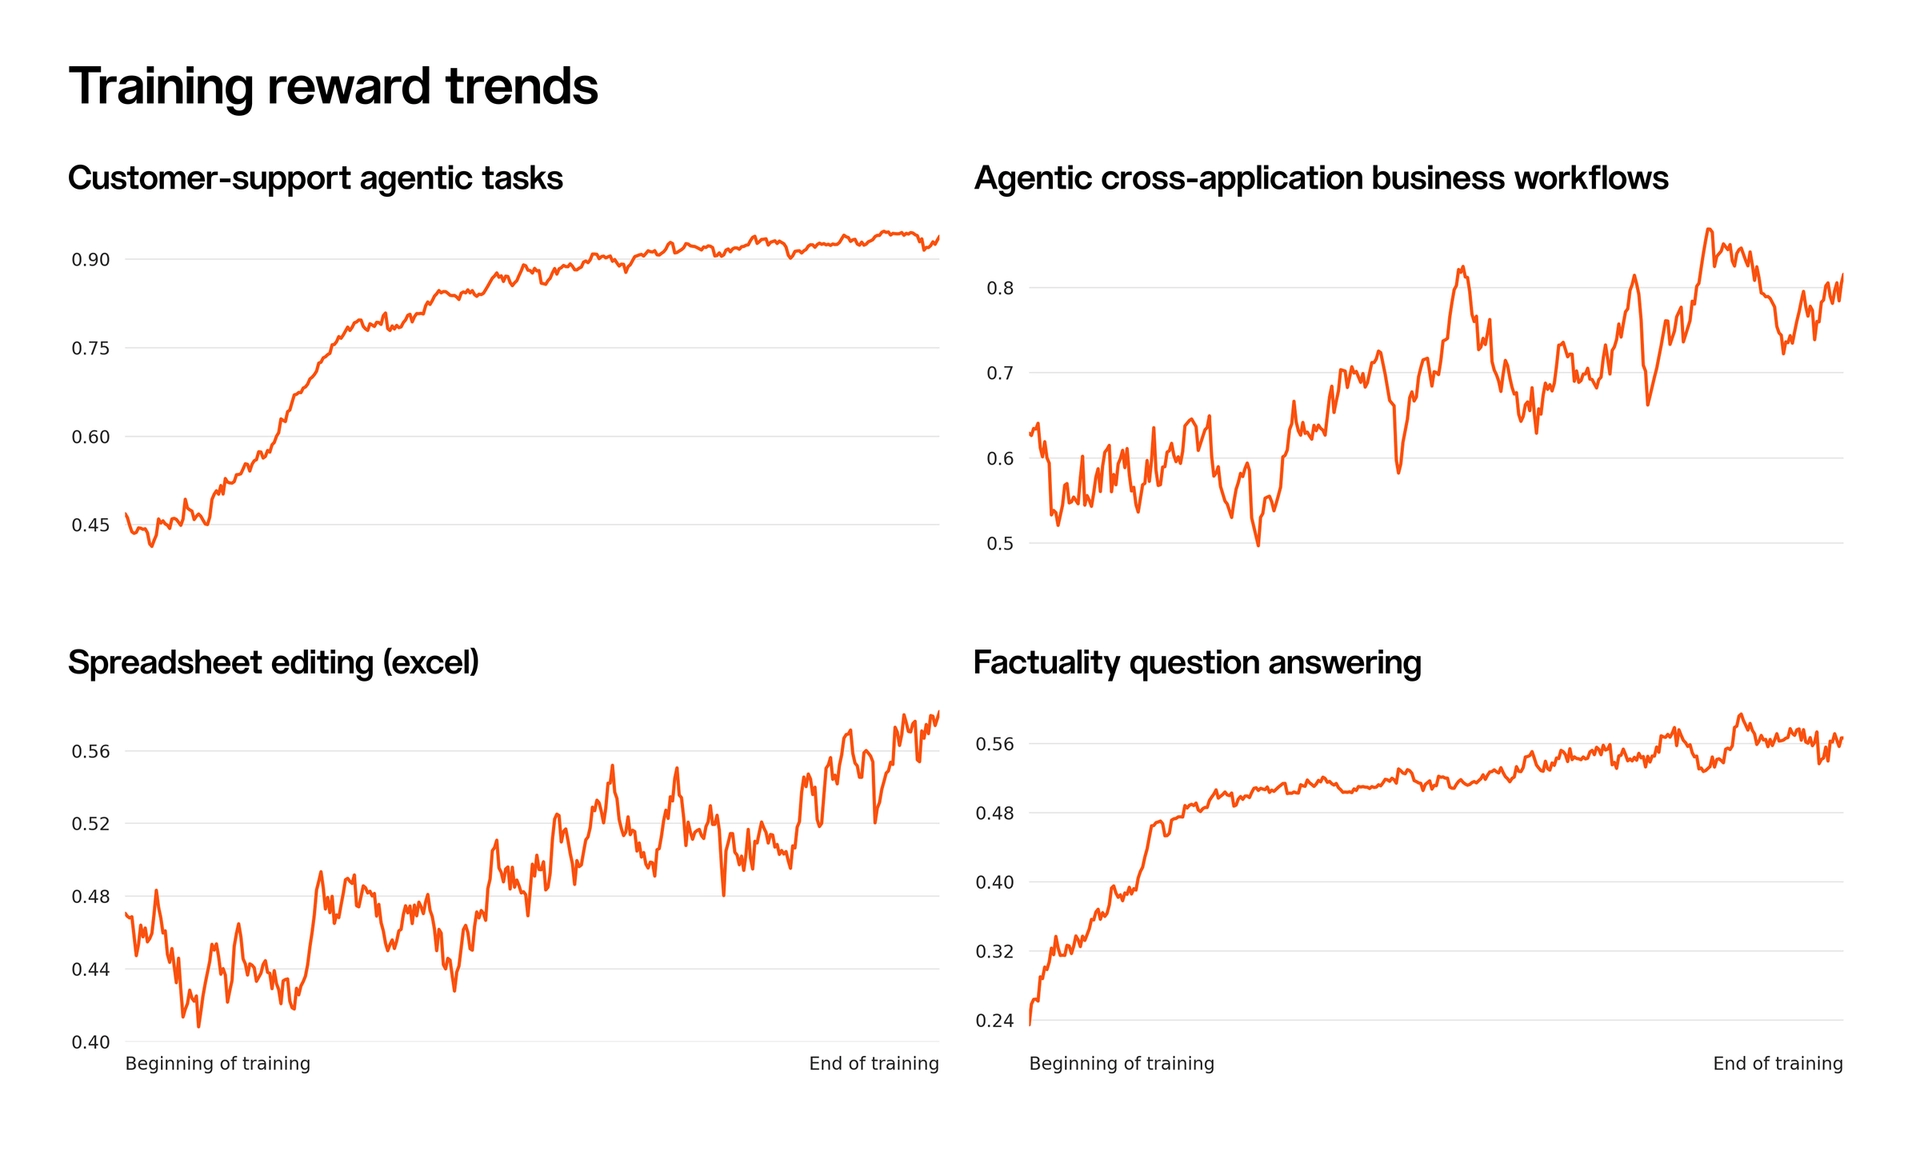
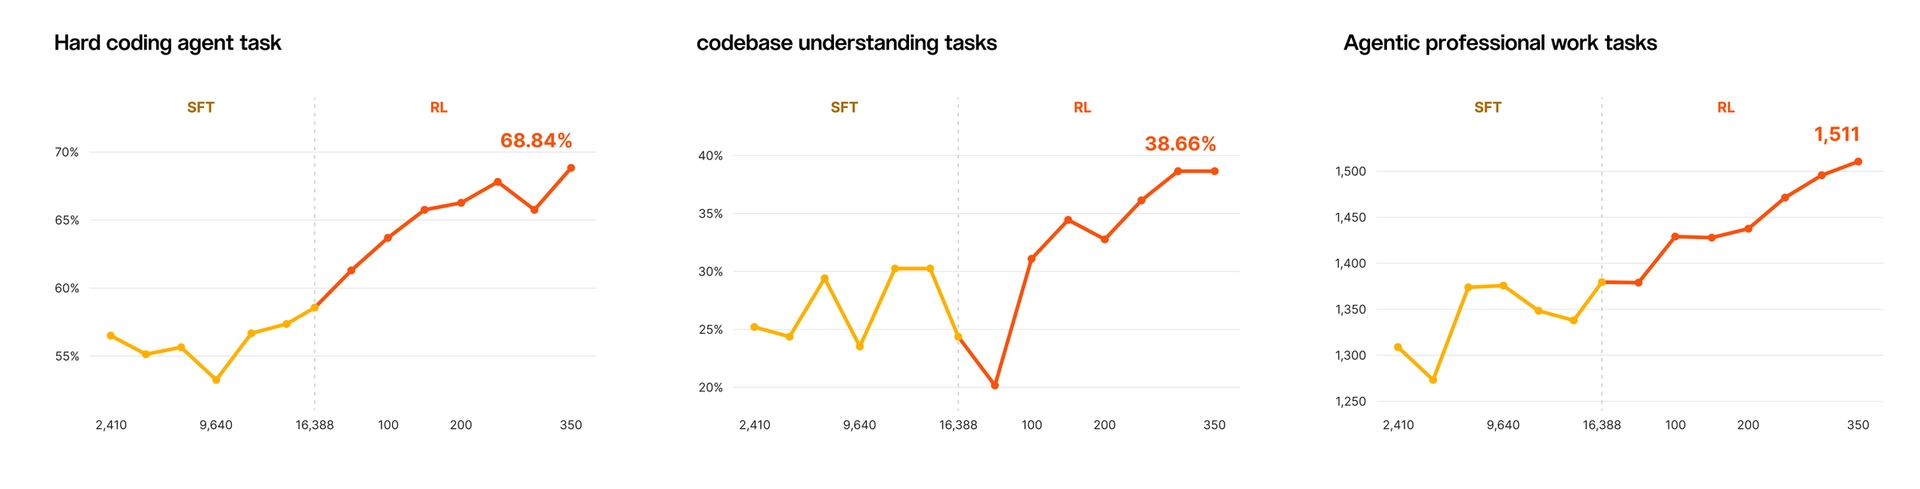
Dopo l'addestramento di base, Mistral affina il modello con due fasi: il supervised fine-tuning (SFT) e l'apprendimento per rinforzo (RL). Nel RL il modello viene valutato sugli esiti dei propri tentativi, e i compiti diventano più difficili man mano che migliora. Gli ambienti di addestramento sono condivisi e possono combinare chat, problemi scientifici, sicurezza, fattualità e uso di strumenti su più passaggi.
Per giudicare le risposte si usano verificatori scelti per ogni compito: reward model, unit test, giudici LLM e controlli statici. Su circa 3.000 GPU una sessione produce circa 33 miliardi di token al giorno, di cui circa 16 miliardi addestrabili dopo filtraggio e mascheramento.
Come leggere le curve#
Le curve mostrano l'andamento della ricompensa durante l'addestramento, quindi il progresso del modello e non un risultato di benchmark. Il grafico in alto raccoglie quattro ambienti, mentre quello successivo confronta le fasi SFT e RL su tre compiti.
Glossario#
Post-training: fasi di affinamento dopo l'addestramento di base.
Rollout: sequenza di tentativi che il modello genera in un ambiente.
Token: piccola unità di testo che il modello legge e produce.
Unit test: controllo automatico che verifica se il codice funziona.
Giudice LLM: un altro modello che valuta la qualità di una risposta.
Come leggere questi numeri#
Il lessico della notizia#
Per leggere le cifre di questa notizia servono alcune definizioni. Le fonti usano questi termini senza spiegarli. Le cifre provengono dalla pagina di annuncio e dalla pagina prodotto di Mistral. Senza pesi e architettura ancora pubblicati, molte misure non si possono ripetere oggi.
Benchmark: test standard con cui si confrontano i modelli su compiti uguali.
Open-weight: modello i cui pesi, cioè i valori numerici che ne determinano il comportamento, sono resi disponibili a tutti.
Parametri: i valori interni del modello. ML4 ne ha 1 trilione in totale e 52 miliardi attivi.
Mixture-of-Experts: architettura che attiva solo una parte dei parametri alla volta.
Multimodale: capace di elaborare testo e immagini.
Token: unità di testo che il modello legge e produce. I prezzi sono indicati per milione di token.
Red-teaming: test avversariale condotto per trovare punti deboli prima del rilascio.
Reinforcement Learning (RL): addestramento in cui il modello migliora dai risultati dei propri tentativi.
Elo: punteggio relativo che ordina i modelli in base ai confronti diretti, come negli scacchi.
Jailbreak: tecnica per aggirare le protezioni di sicurezza di un modello.
Cosa significa per un'azienda#
Provate l'anteprima API su Mistral Studio con un caso reale della vostra attività e misurate il costo per flusso. La scheda indica $1,36 per milione di token in input e $4,18 in output. Per capire come scegliere il fornitore, leggete l'approfondimento dedicato.
Valutate i pesi aperti, annunciati per la fine del mese, se vi servono controllo dei dati o deployment on-premise. Il produttore indica l'esecuzione su private cloud o on-premise per le operazioni di sicurezza.
Per l'uso in sicurezza, verificate la policy del fornitore sulle richieste cyber. Secondo i dati dichiarati da Mistral, il tasso di rifiuto di ML4 sui prompt cyber è più alto di tutti i modelli open-weight testati, mentre alcuni modelli chiusi rifiutano il test di riproduzione delle vulnerabilità.
Confrontate i benchmark dichiarati dal produttore, come 82% nel test di riproduzione e patch e 93% su Cybench, con prove interne sui vostri casi. Per il quadro generale dei modelli disponibili, consultate il panorama dei modelli.
Domande frequenti#
Quando escono i pesi del modello?
Secondo Mistral, i pesi saranno rilasciati entro la fine del mese in cui è stato pubblicato l'annuncio, il 6 ottobre 2026.
Dove posso provare Mistral Large 4?
È disponibile in anteprima pubblica tramite API su Mistral Studio.
Quanto costa?
Per milione di token, il prezzo scontato è $0,68 in input e $2,09 in output, contro un listino di $1,36 e $4,18. Il prezzo degli input in cache è $0,07, contro $0,14 di listino. Dettagli nella pagina del modello.
Il modello è davvero europeo?
Mistral dichiara che il modello è stato addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei propri datacenter europei, e che l'anteprima è servita sulla stessa infrastruttura. È previsto anche un deployment europeo gestito end-to-end da Mistral, sotto legge europea.
Quante lingue supporta?
Mistral indica il supporto a oltre 160 lingue, incluse tutte le lingue ufficiali dell'Unione europea.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni sui benchmark | 7/10 | Il modello ottiene 93% su Cybench e 82 su CyberGym-E2E (AA), ma su SciCode-Verified è 91,8 contro 94,2 di GPT-6 Astra, e i dati provengono in gran parte dal produttore. |
Prezzo e disponibilità | 6/10 | Il prezzo scontato dell'anteprima è 0,68 in input e 2,09 in output per milione di token, contro un listino di 1,36 e 4,18, ma la durata dello sconto non è indicata. |
Apertura e licenza | 4/10 | Il modello è presentato come open-weight, ma i pesi non sono ancora disponibili: Mistral promette il rilascio entro la fine del mese e la licenza non è specificata nelle fonti. |
Trasparenza dei dati | 5/10 | Le fonti combinano valutazioni indipendenti (Artificial Analysis, vals.ai, Surge AI) con dati auto-dichiarati, e i valori delle tabelle sono letti da grafici ufficiali. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Mistral Large 4 è un modello open-weight in anteprima API con risultati forti in cybersicurezza, ma pesi, licenza e prezzi definitivi non sono ancora noti.
Per chi valuta l'adozione, il modello è promettente soprattutto per attività di sicurezza informatica e analisi finanziaria, dove le fonti riportano risultati competitivi. Le cifre più favorevoli sono però in gran parte dichiarate dal produttore e basate su grafici. Prima di decidere conviene attendere il rilascio dei pesi, la licenza e i prezzi definitivi, verificando i benchmark sui propri casi d'uso.
Punti di forza
- Su Cybench ML4 raggiunge 93% (dichiarato da Mistral), il valore più alto della tabella confrontata.
- Su Finance Agent V2 (vals.ai) ML4 ottiene 54,7, sopra GPT-6 Astra a 53,5.
- Il tasso di rifiuto di richieste cyber dannose è 95,3, il più alto della tabella confrontata.
- Il prezzo di anteprima scontato è inferiore al listino pubblicato.
Limiti
- I pesi del modello non sono ancora stati rilasciati e la data è una promessa del produttore.
- Su Finance Agent V2 ML4 (54,7) è sotto GLM-5.3 (55,8) e nella valutazione umana Surge ottiene 3,7 contro 4,2 di Claude Opus 5.
- Le fonti non indicano il prezzo dopo l'anteprima né la durata dello sconto.
- Molti numeri provengono dal produttore o da grafici letti a mano, senza dati grezzi pubblicati.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
2- 1.Mistral AI — Introducing Mistral Large 4 | Mistralmistral.ai
Annuncio ufficiale da cui nasce l’articolo.
- 2.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.