Punteggi dichiarati dal produttore, disponibilità e limiti dei nuovi modelli per agenti personali e professionali
Meta presenta Muse Wonder e Muse Wonder Full, due modelli per agenti personali e professionali. Qui trovate i benchmark pubblicati dal produttore, con fonti e limiti di ciascun test, e cosa significano per un’azienda.
di Andrea Pirazzini
Fonte primaria
Meta — Muse Wonder: A Frontier Model For Personal & Professional AI Agents
research.meta.ai
Matteo e Vittorio
Il Narratore a due voci · 2 min 36 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Meta — Muse Wonder: A Frontier Model For Personal & Professional AI Agents.
Perché se ne parla#
Meta ha presentato Muse Wonder e Muse Wonder Full, modelli pensati per compiti agentici personali e professionali, cioè attività in cui l'AI svolge un lavoro per conto dell'utente. Secondo il produttore, la serie raggiunge lo stato dell'arte su questi compiti, con risultati di punta su benchmark dedicati ad agenti, memoria e programmazione. Si tratta di dichiarazioni di Meta, riportate nel comunicato originale e nel report di valutazione.
Due funzioni distinguono i modelli: Active Memory, che conserva il contesto utile sull'utente tra una conversazione e l'altra, e Active Focus, che permette di proseguire verso un obiettivo difficile, provare strade alternative e chiedere chiarimenti. Muse Wonder è disponibile oggi tramite la Meta Model API e Muse Code, mentre Muse Wonder Full è riservato agli abbonati di Muse Code.
Per voi il dato più rilevante riguarda l'ambito d'uso: Meta indica compiti in diritto, finanza e salute, come capire un contratto d'affitto, oltre alla programmazione. Il primo modello alimenterà anche esperienze in Muse, partendo dagli abbonati. Per il contesto sugli strumenti da terminale di Meta, leggete Meta Muse Code: l'agente da terminale.
Verso la superintelligenza personale#
Secondo la pagina di Meta, quattordici mesi fa l'azienda ha avviato una revisione completa del proprio lavoro sull'AI: dalla ricostruzione delle fondamenta si è passati a spingere la frontiera, cioè i modelli più avanzati. Muse Wonder e Muse Wonder Full sono addestrati nel data center Prometheus, descritto come a scala di gigawatt, e riuniscono il lavoro di più team di Meta. Si appoggiano alle basi gettate con Muse Spark, il modello presentato in precedenza.
Glossario essenziale#
Frontiera: il livello più alto di prestazioni raggiunto dai modelli disponibili.
Active Memory: la capacità di ricordare il contesto utile su di voi tra una conversazione e l'altra.
Active Focus: la capacità di proseguire verso un obiettivo difficile, provando strade diverse e chiedendo chiarimenti quando serve.
Gigawatt: unità di potenza elettrica; il riferimento indica un'infrastruttura di calcolo di grandissime dimensioni.
Capacità di frontiera#
Muse Wonder Full nell'indice
Secondo posto, dopo Claude Opus 5.5
Muse Wonder
A pari merito con GPT-6.1 Sol
Claude Opus 5.5
Primo in classifica
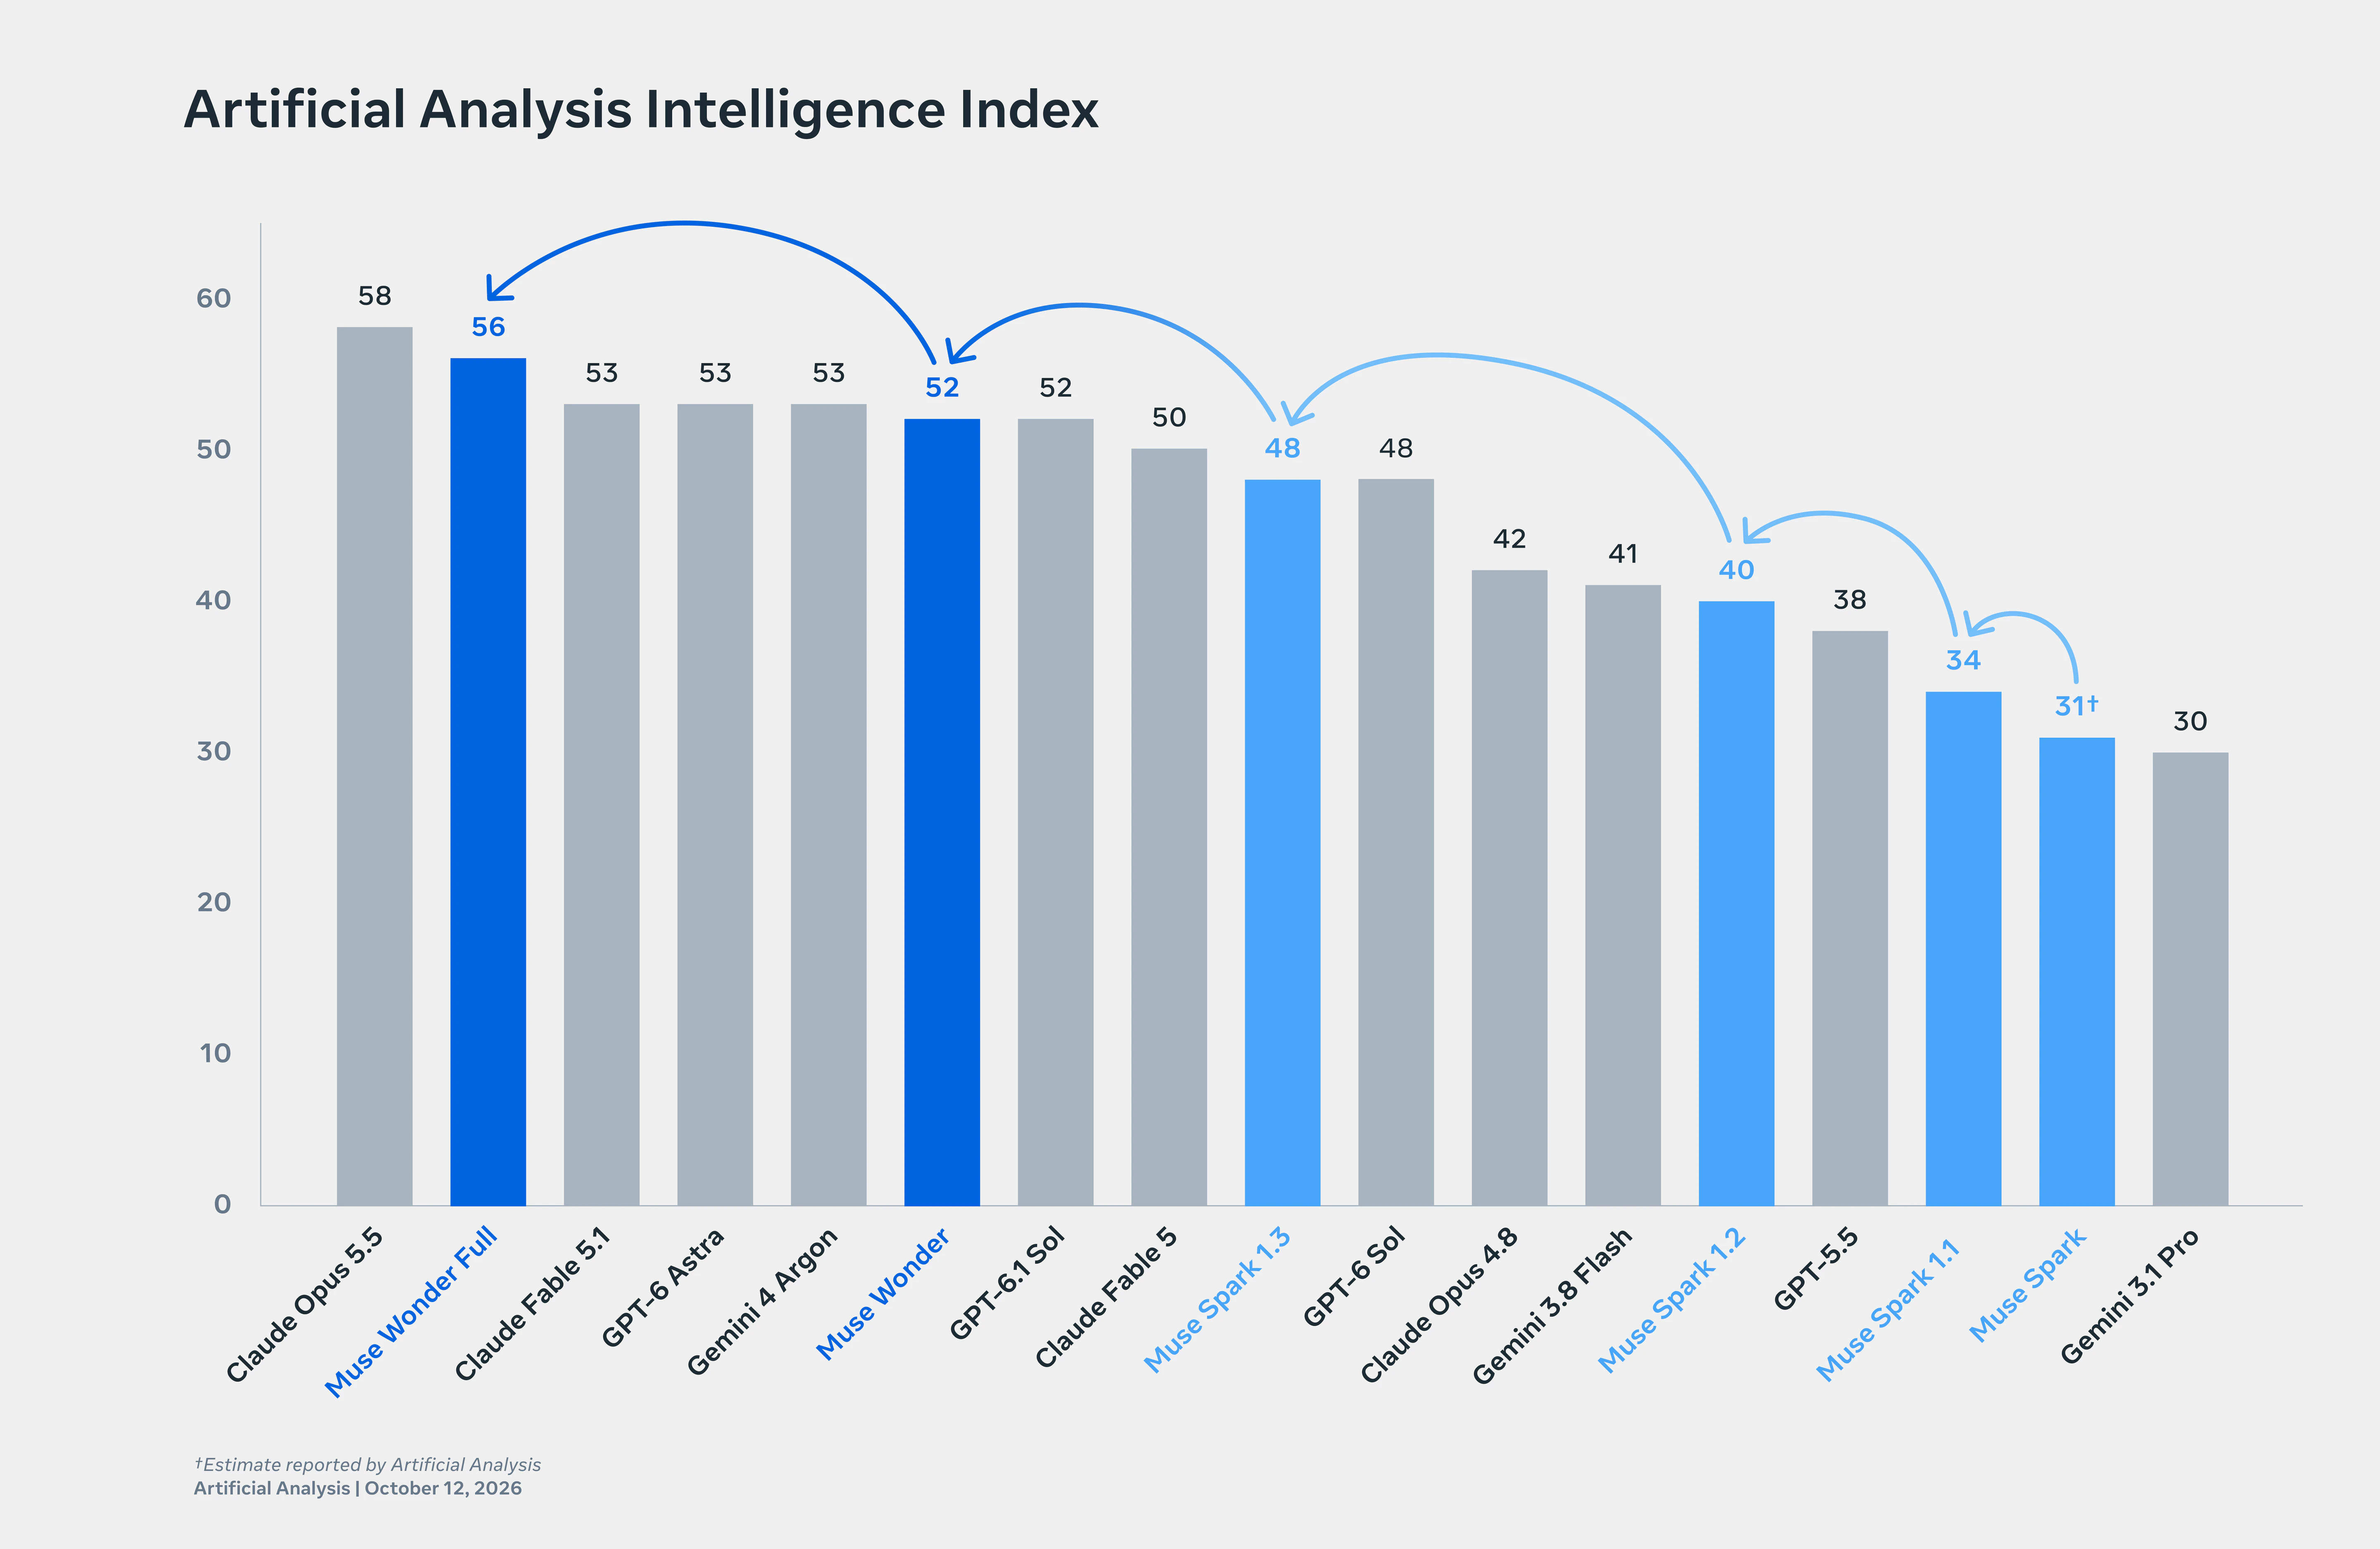
Nell'Artificial Analysis Intelligence Index, pubblicato il 12 ottobre 2026, Muse Wonder Full ottiene 56 punti, subito dietro Claude Opus 5.5 con 58. Muse Wonder si ferma a 52, pari a GPT-6.1 Sol e sotto Claude Fable 5.1, GPT-6 Astra e Gemini 4 Argon, tutti a 53. Per Muse Spark il dato è una stima di Artificial Analysis, pari a 31. Meta dichiara che la serie raggiunge risultati all'avanguardia nei benchmark per agenti, memoria e programmazione: si tratta di affermazioni del produttore (fonte Meta). Il grafico include anche i modelli concorrenti citati nella fonte; per un confronto con un singolo modello vedete Claude Opus 5.5.
Artificial Analysis Intelligence Index
Punteggi dei modelli, 12 ottobre 2026
Fonte: Meta, valori letti dal grafico ufficiale
Indice di lavoro personale e di conoscenza#
Il Personal Superintelligence Index è un indice composito interno di Meta dedicato al lavoro personale e di conoscenza. Non è un benchmark indipendente: i punteggi sono quelli che il produttore ha scelto di pubblicare nella scheda di lancio, e vanno letti in questa chiave.
Personal Superintelligence Index
Indice composito interno di Meta, lavoro personale e di conoscenza
Fonte: Meta, valori letti dal grafico ufficiale
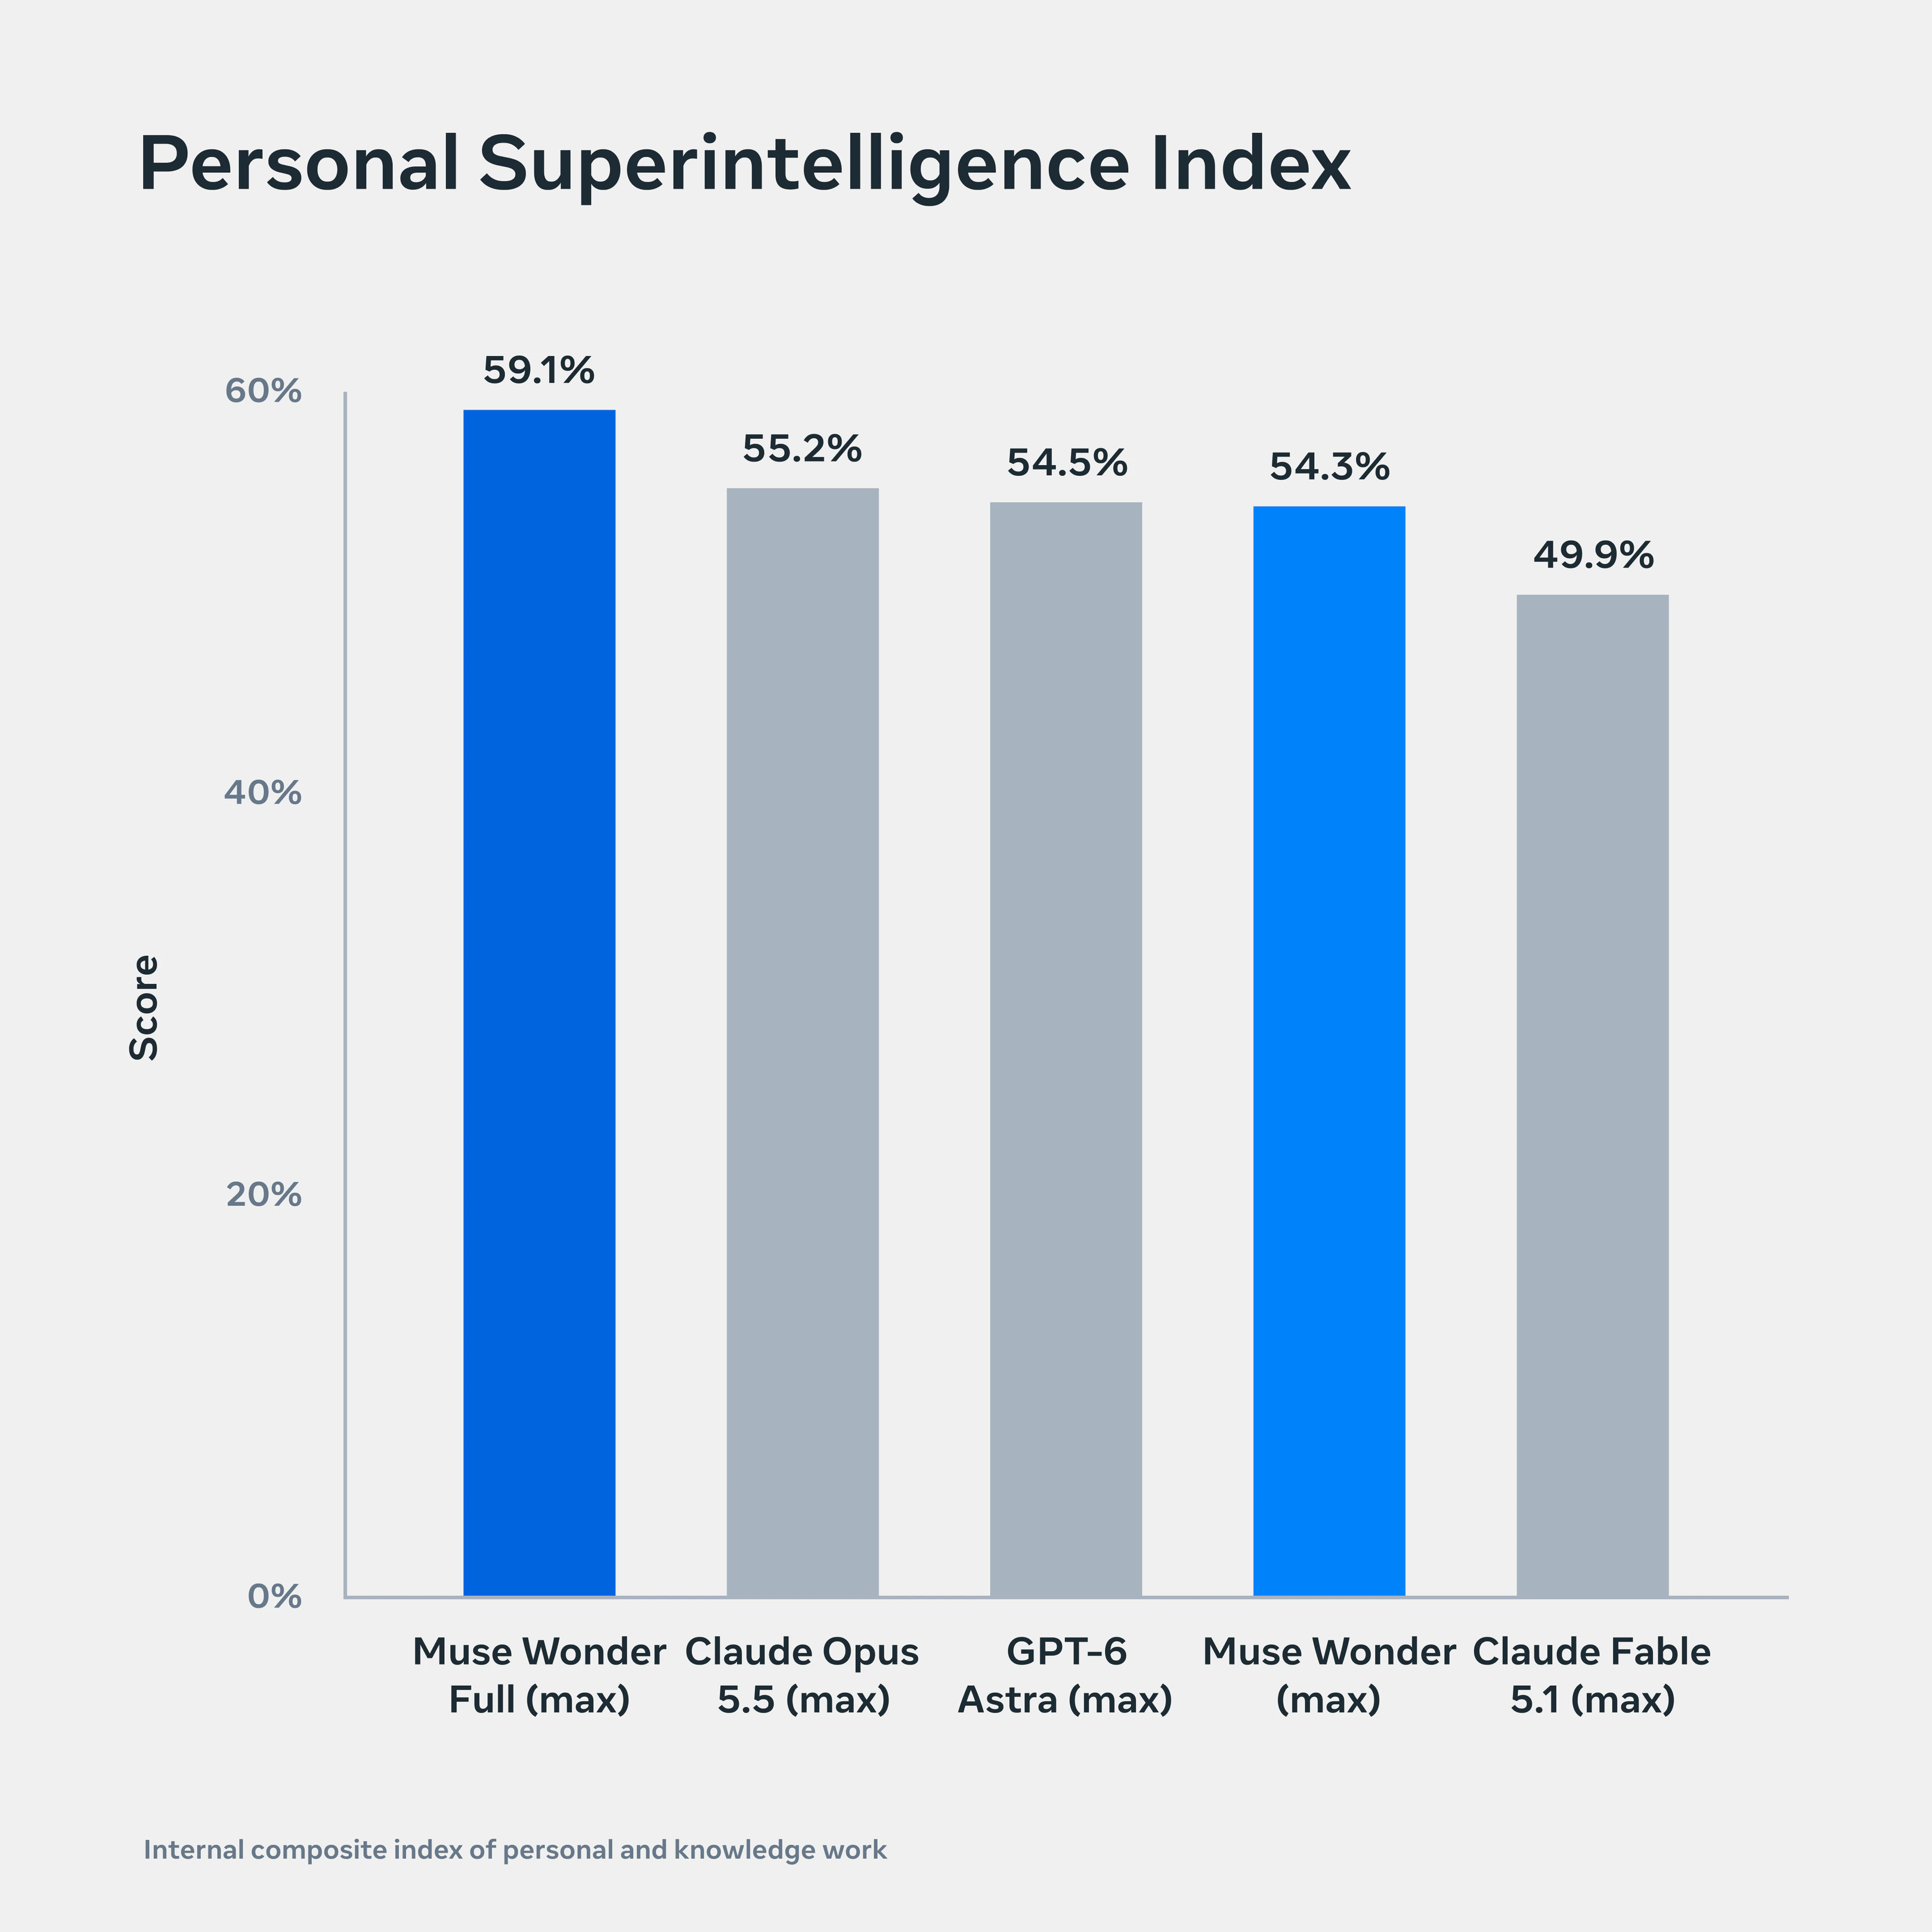
Il grafico confronta le due versioni di Muse Wonder con tre modelli concorrenti. Muse Wonder Full (max) è primo con 59,1%, mentre Muse Wonder (max) si ferma a 54,3%, in quarta posizione. Claude Fable 5.1 (max) è l'ultimo, a 49,9%.
Automazione dei flussi di lavoro#
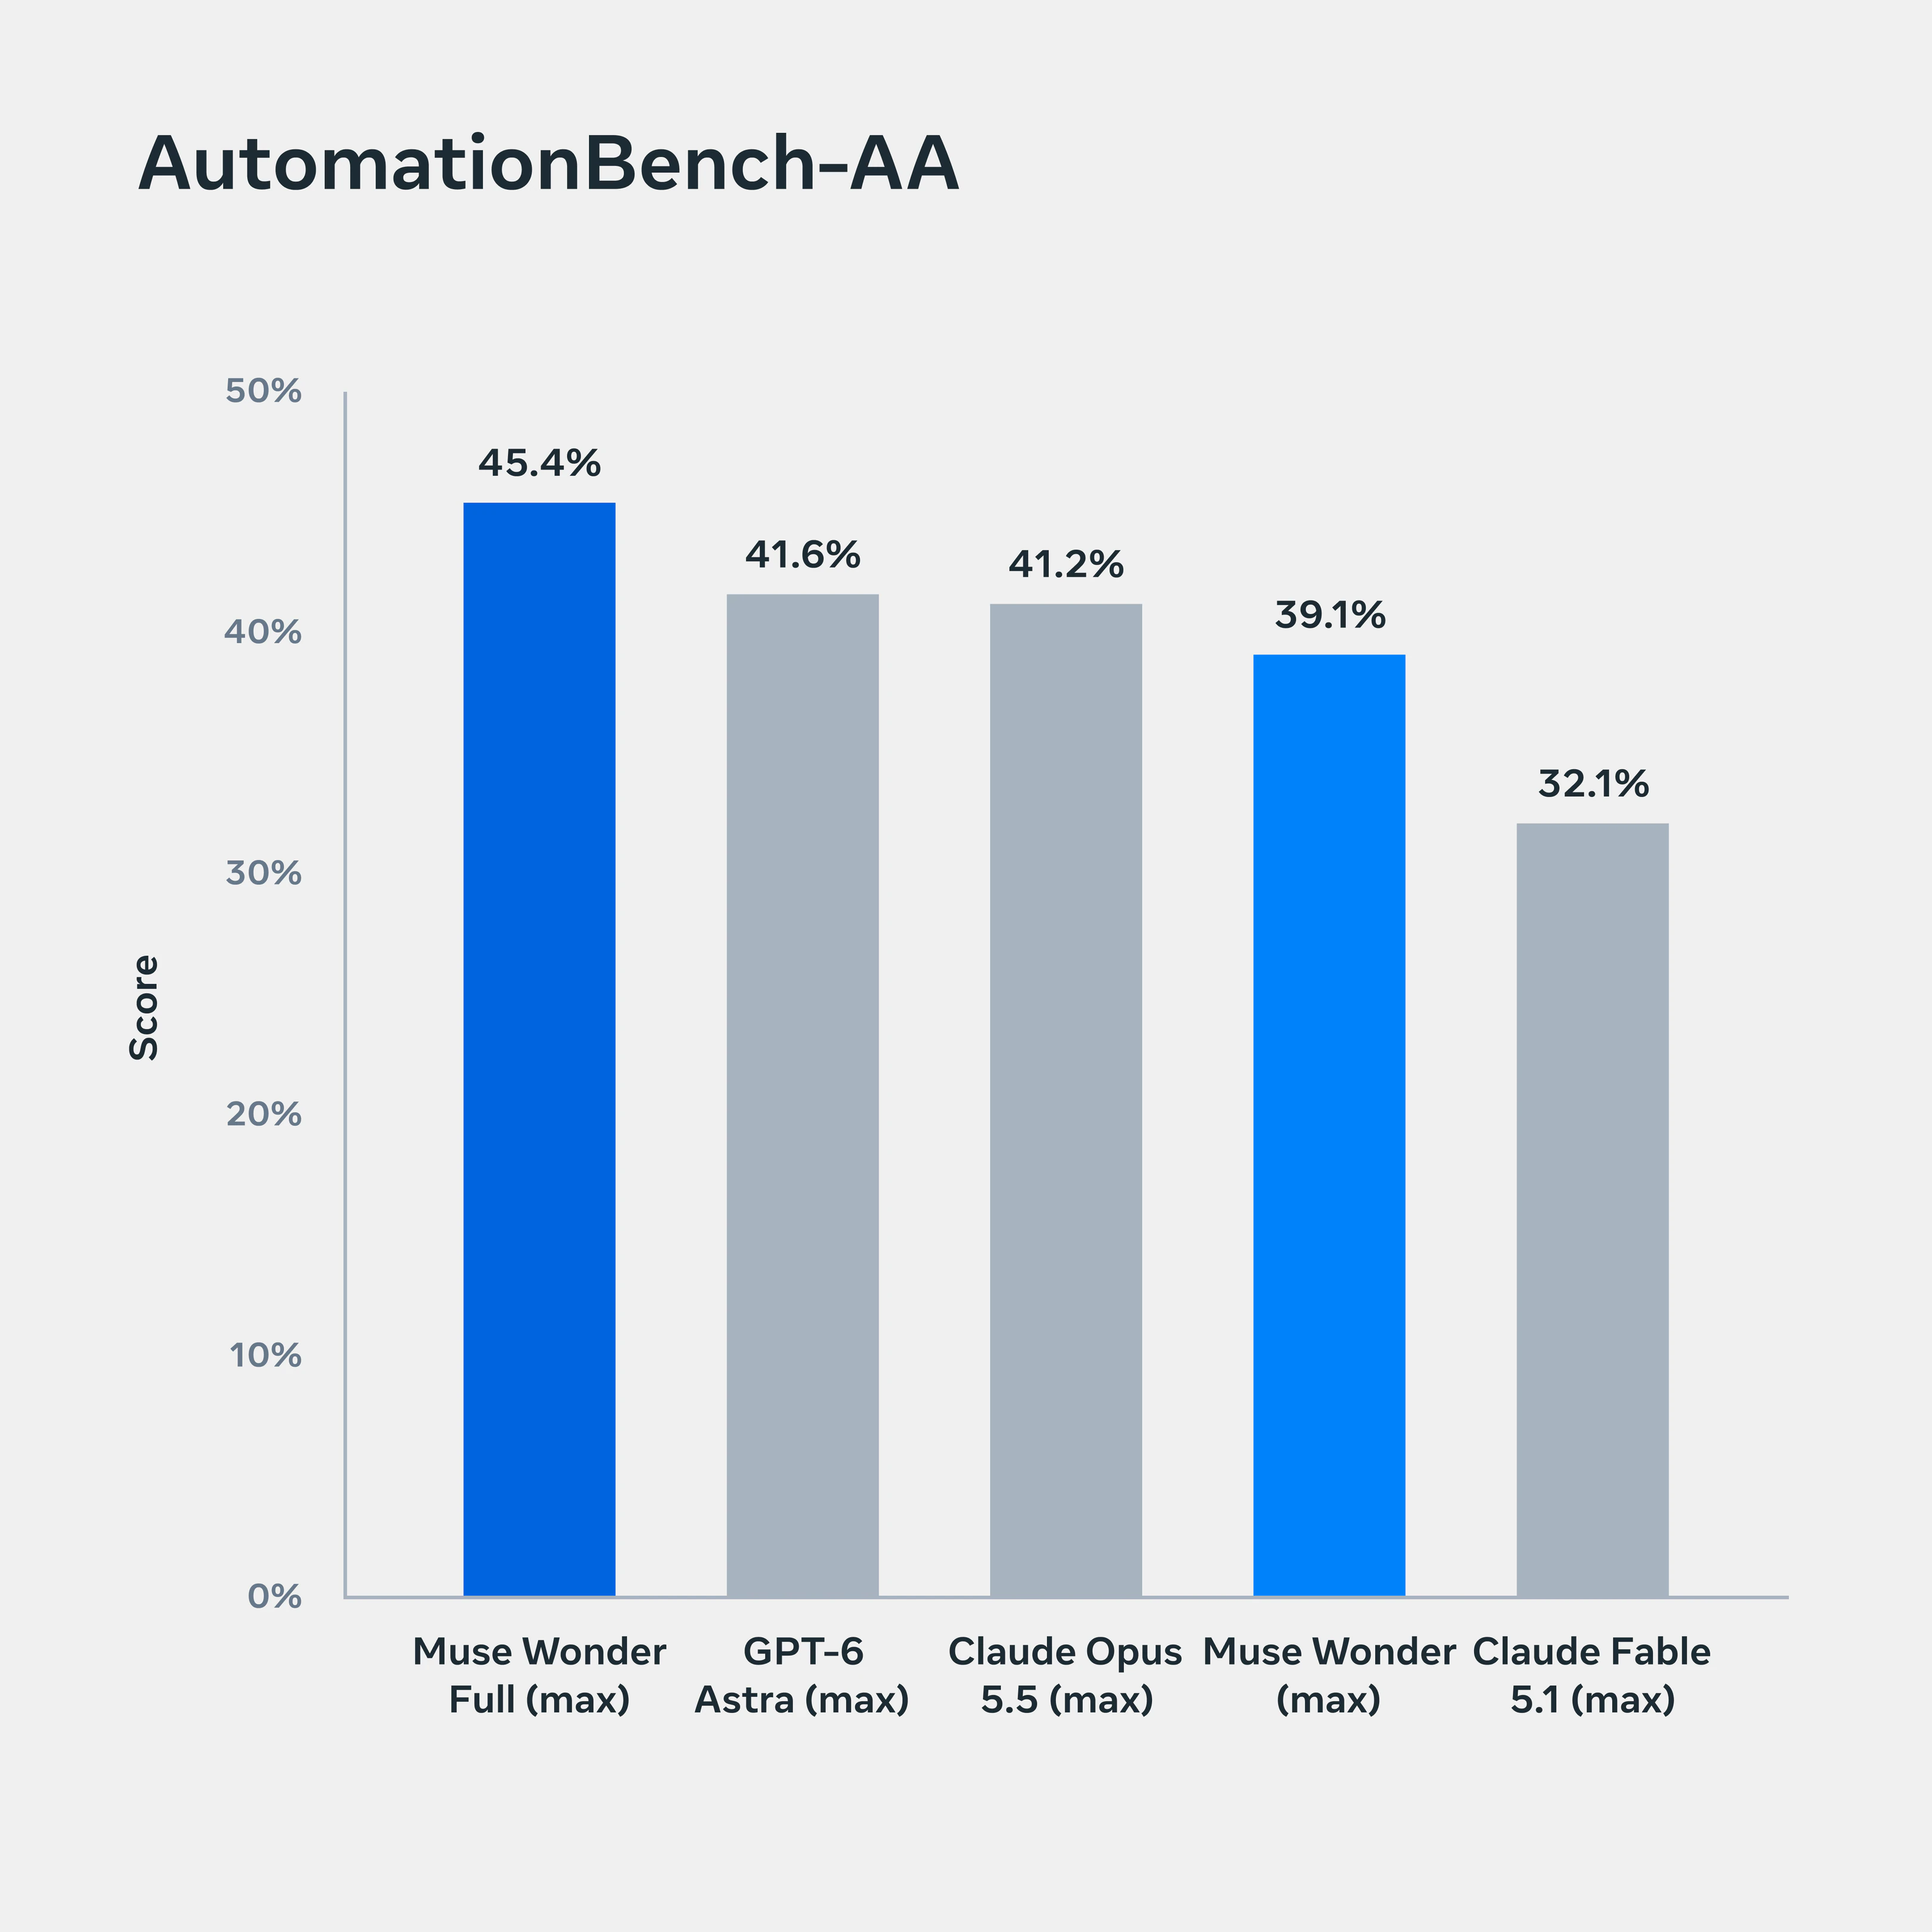
AutomationBench-AA misura le prestazioni dei modelli su flussi di lavoro aziendali end-to-end. Secondo la fonte, Muse Wonder Full (max) è il primo in questo grafico con 45,4%, davanti a GPT-6 Astra (max) con 41,6% e Claude Opus 5.5 (max) con 41,2%. Muse Wonder (max) si ferma a 39,1% e Claude Fable 5.1 (max) a 32,1%. Sono valori riportati dal produttore, Meta, nel proprio materiale di presentazione (fonte).
AutomationBench-AA
Punteggio per modello, valori dal grafico ufficiale
Fonte: Meta, valori letti dal grafico ufficiale
Scheda completa dei benchmark#
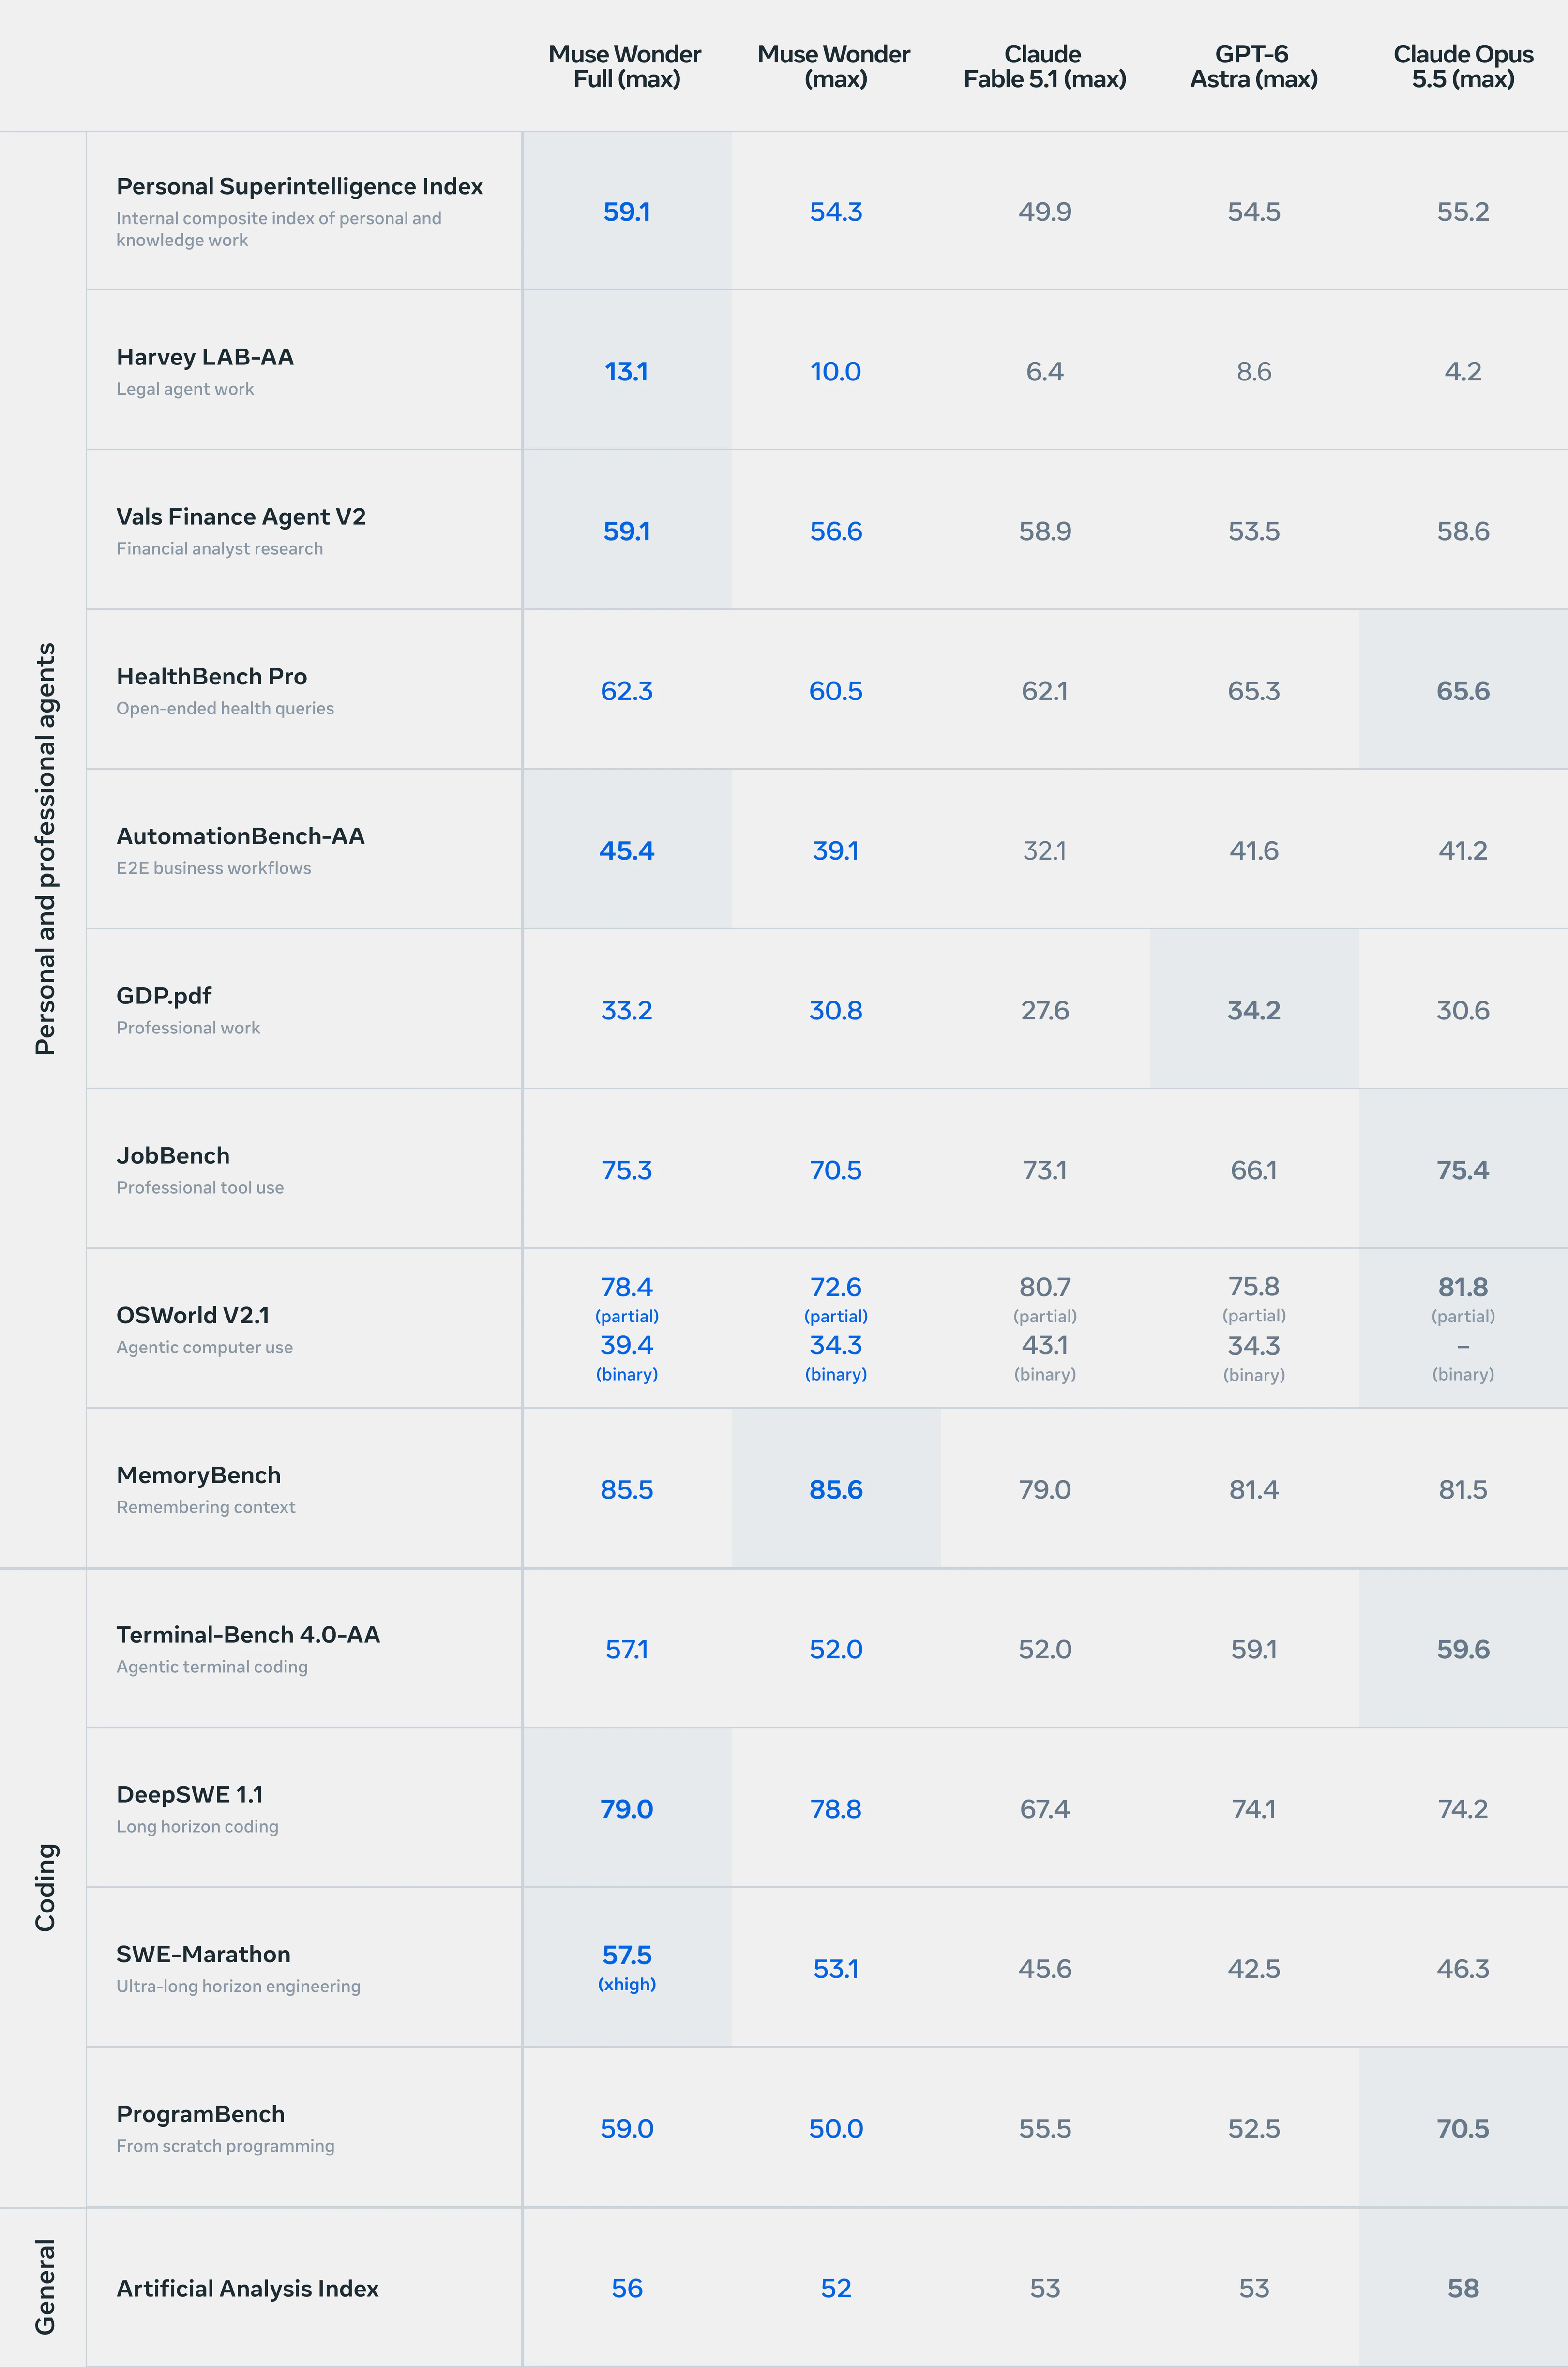
La tabella completa dei benchmark è qui sotto, con l'immagine originale subito dopo.
Test | Muse Wonder Full (max) | Muse Wonder (max) | Claude Fable 5.1 (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max) |
|---|---|---|---|---|---|
Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
Harvey LAB-AA | 13.1 | 10 | 6.4 | 8.6 | 4.2 |
Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
OSWorld V2.1 (partial) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
OSWorld V2.1 (binary) | 39.4 | 34.3 | 43.1 | 34.3 | — |
MemoryBench | 85.5 | 85.6 | 79 | 81.4 | 81.5 |
Terminal-Bench 4.0-AA | 57.1 | 52 | 52 | 59.1 | 59.6 |
DeepSWE 1.1 | 79 | 78.8 | 67.4 | 74.1 | 74.2 |
SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
ProgramBench | 59 | 50 | 55.5 | 52.5 | 70.5 |
Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
Punteggi dei cinque modelli su tutti i test della scheda benchmark di Muse Wonder, per consultazione. Fonte: Meta.
Competenza di dominio#
Muse Wonder e Muse Wonder Full devono applicare conoscenze specialistiche a problemi di lavoro e di vita quotidiana, dalla comprensione di un contratto d'affitto a un'informazione finanziaria o sanitaria. Meta li valuta con test in diritto, finanza e salute. Il benchmark legale Harvey LAB, per esempio, richiede di lavorare su documenti sorgente e seguire istruzioni dettagliate per produrre prodotti di lavoro legali. Dettagli nella scheda di Meta.
Harvey LAB-AA
Punteggio (%) nel benchmark legale di Harvey
Fonte: Meta, valori letti dal grafico ufficiale
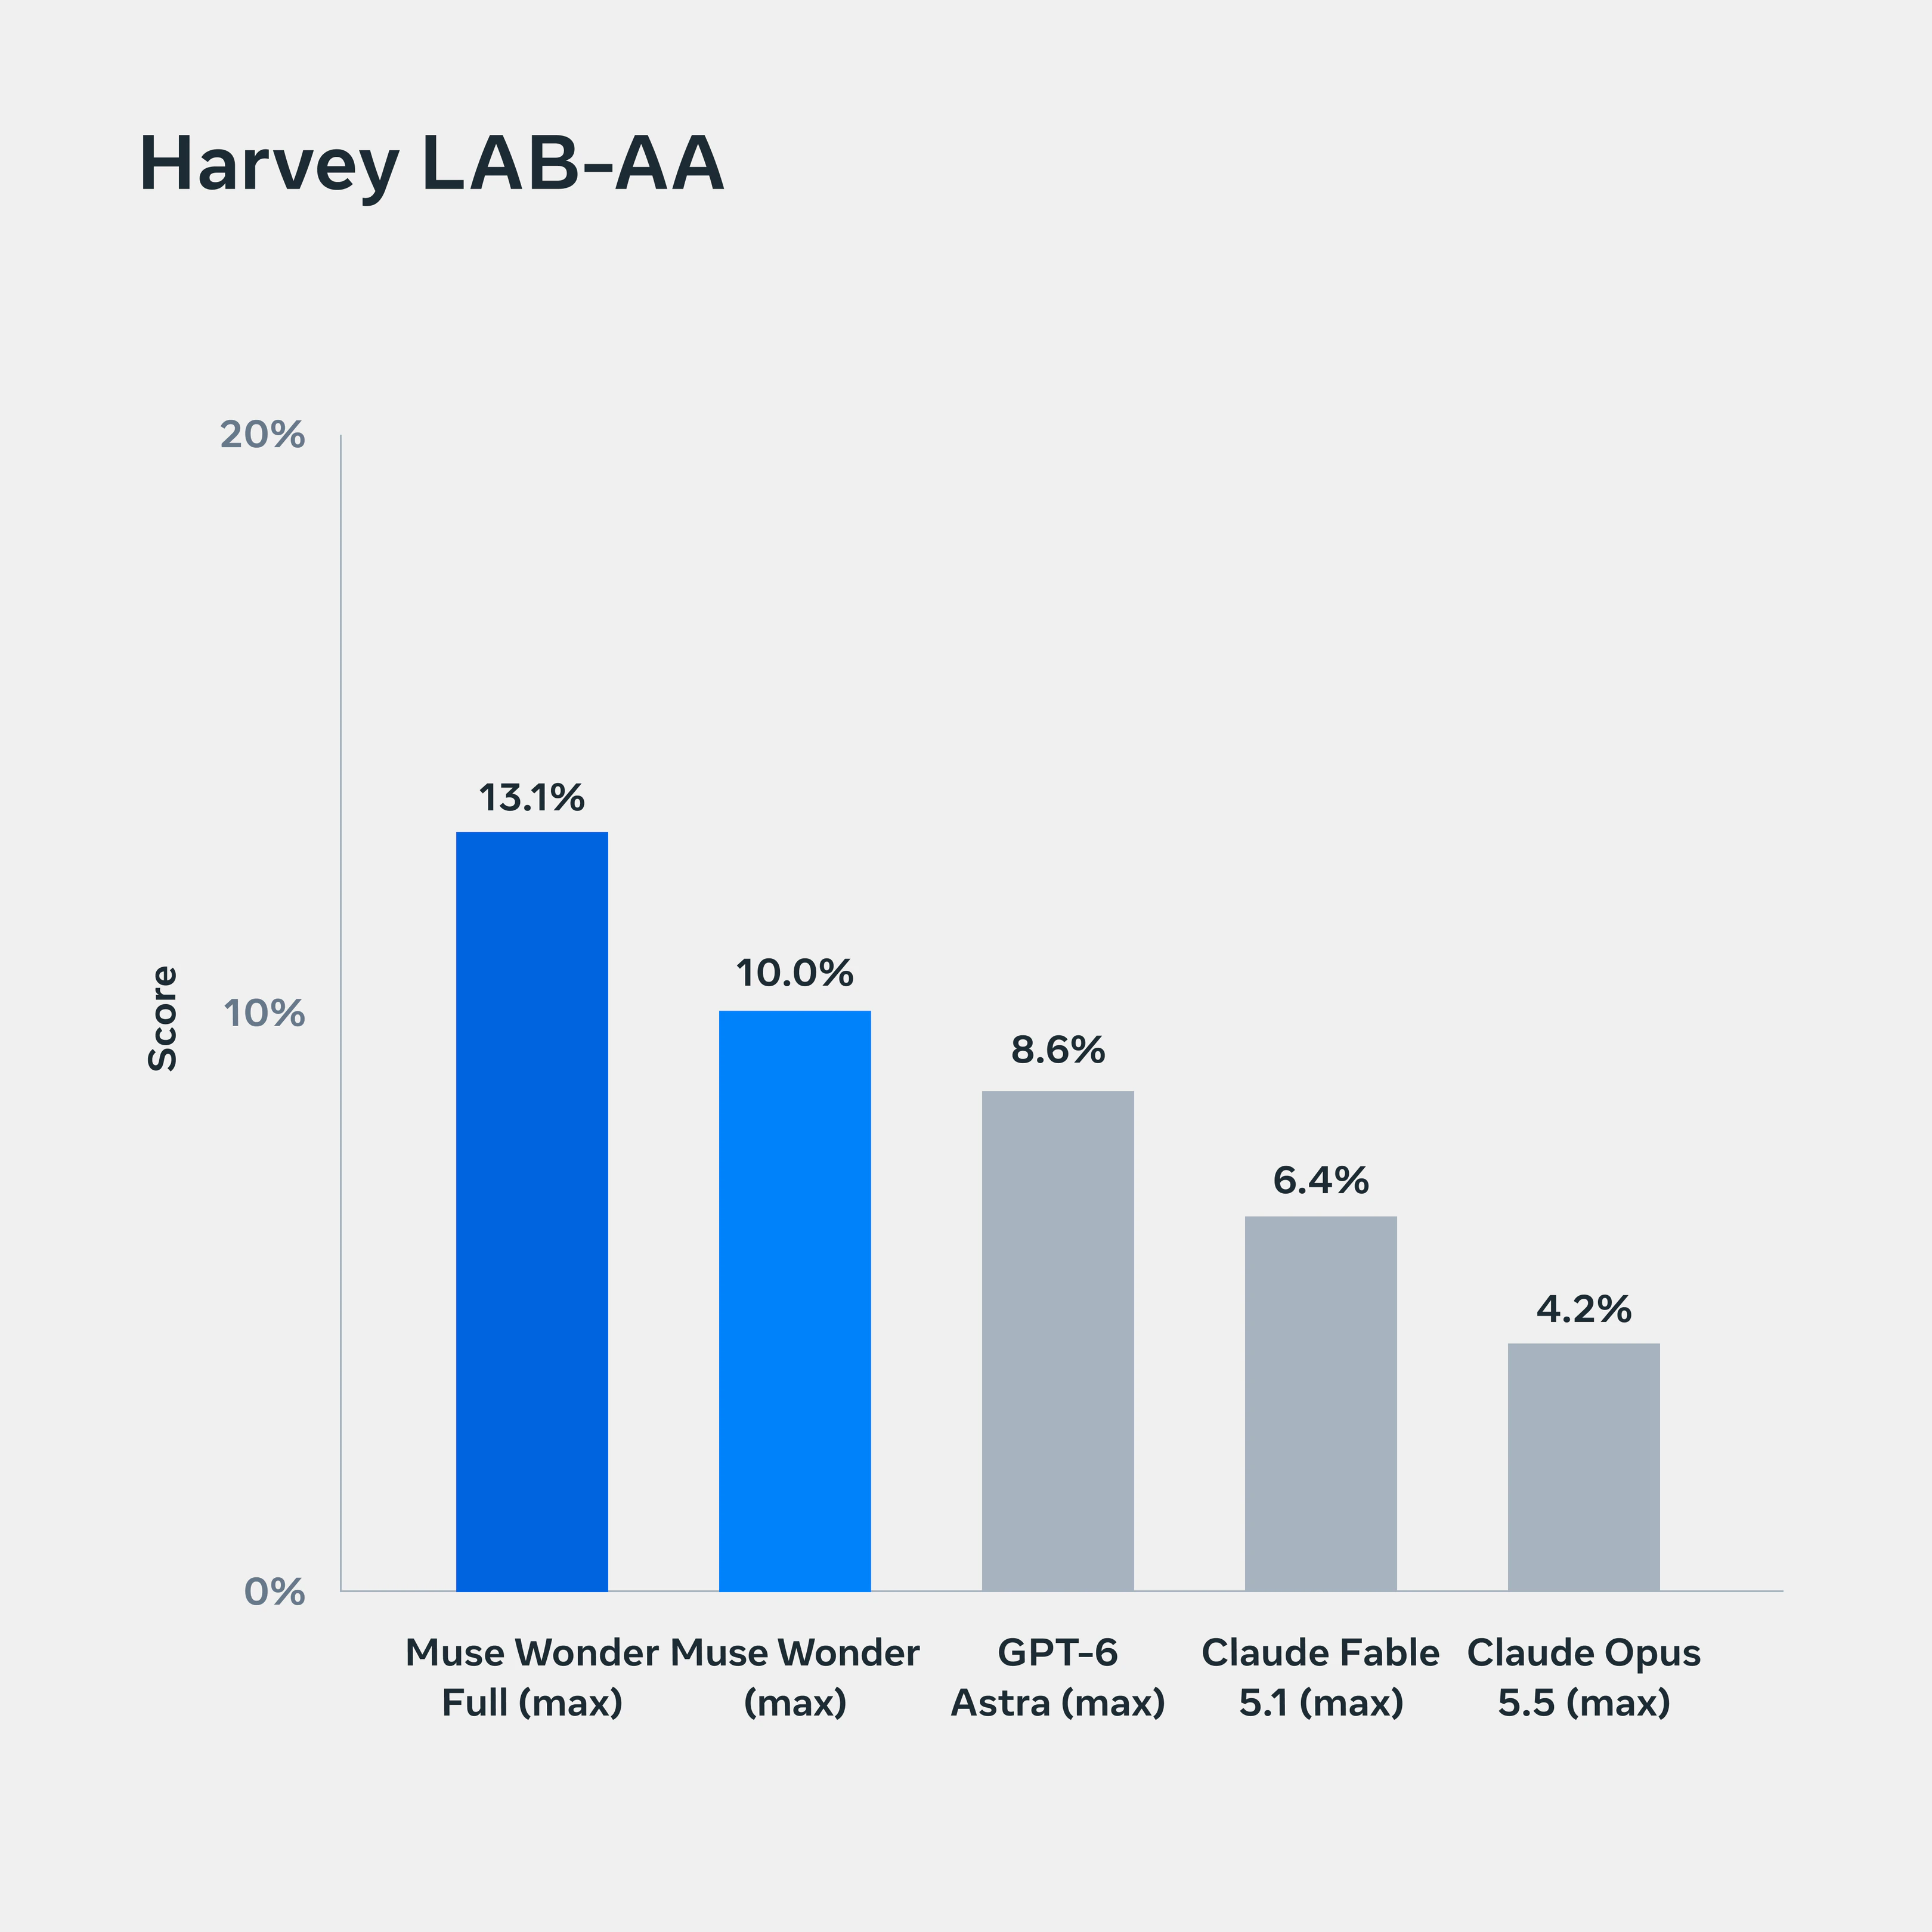
Nel grafico Harvey LAB-AA Muse Wonder Full (max) raggiunge 13,1% e Muse Wonder (max) 10%, seguiti da GPT-6 Astra (max) con 8,6%, Claude Fable 5.1 (max) con 6,4% e Claude Opus 5.5 (max) con 4,2%. Si tratta di punteggi dichiarati dal produttore.
Vals Finance Agent V2
Punteggio (%) nel benchmark finanziario di Vals
Fonte: Meta, valori letti dal grafico ufficiale
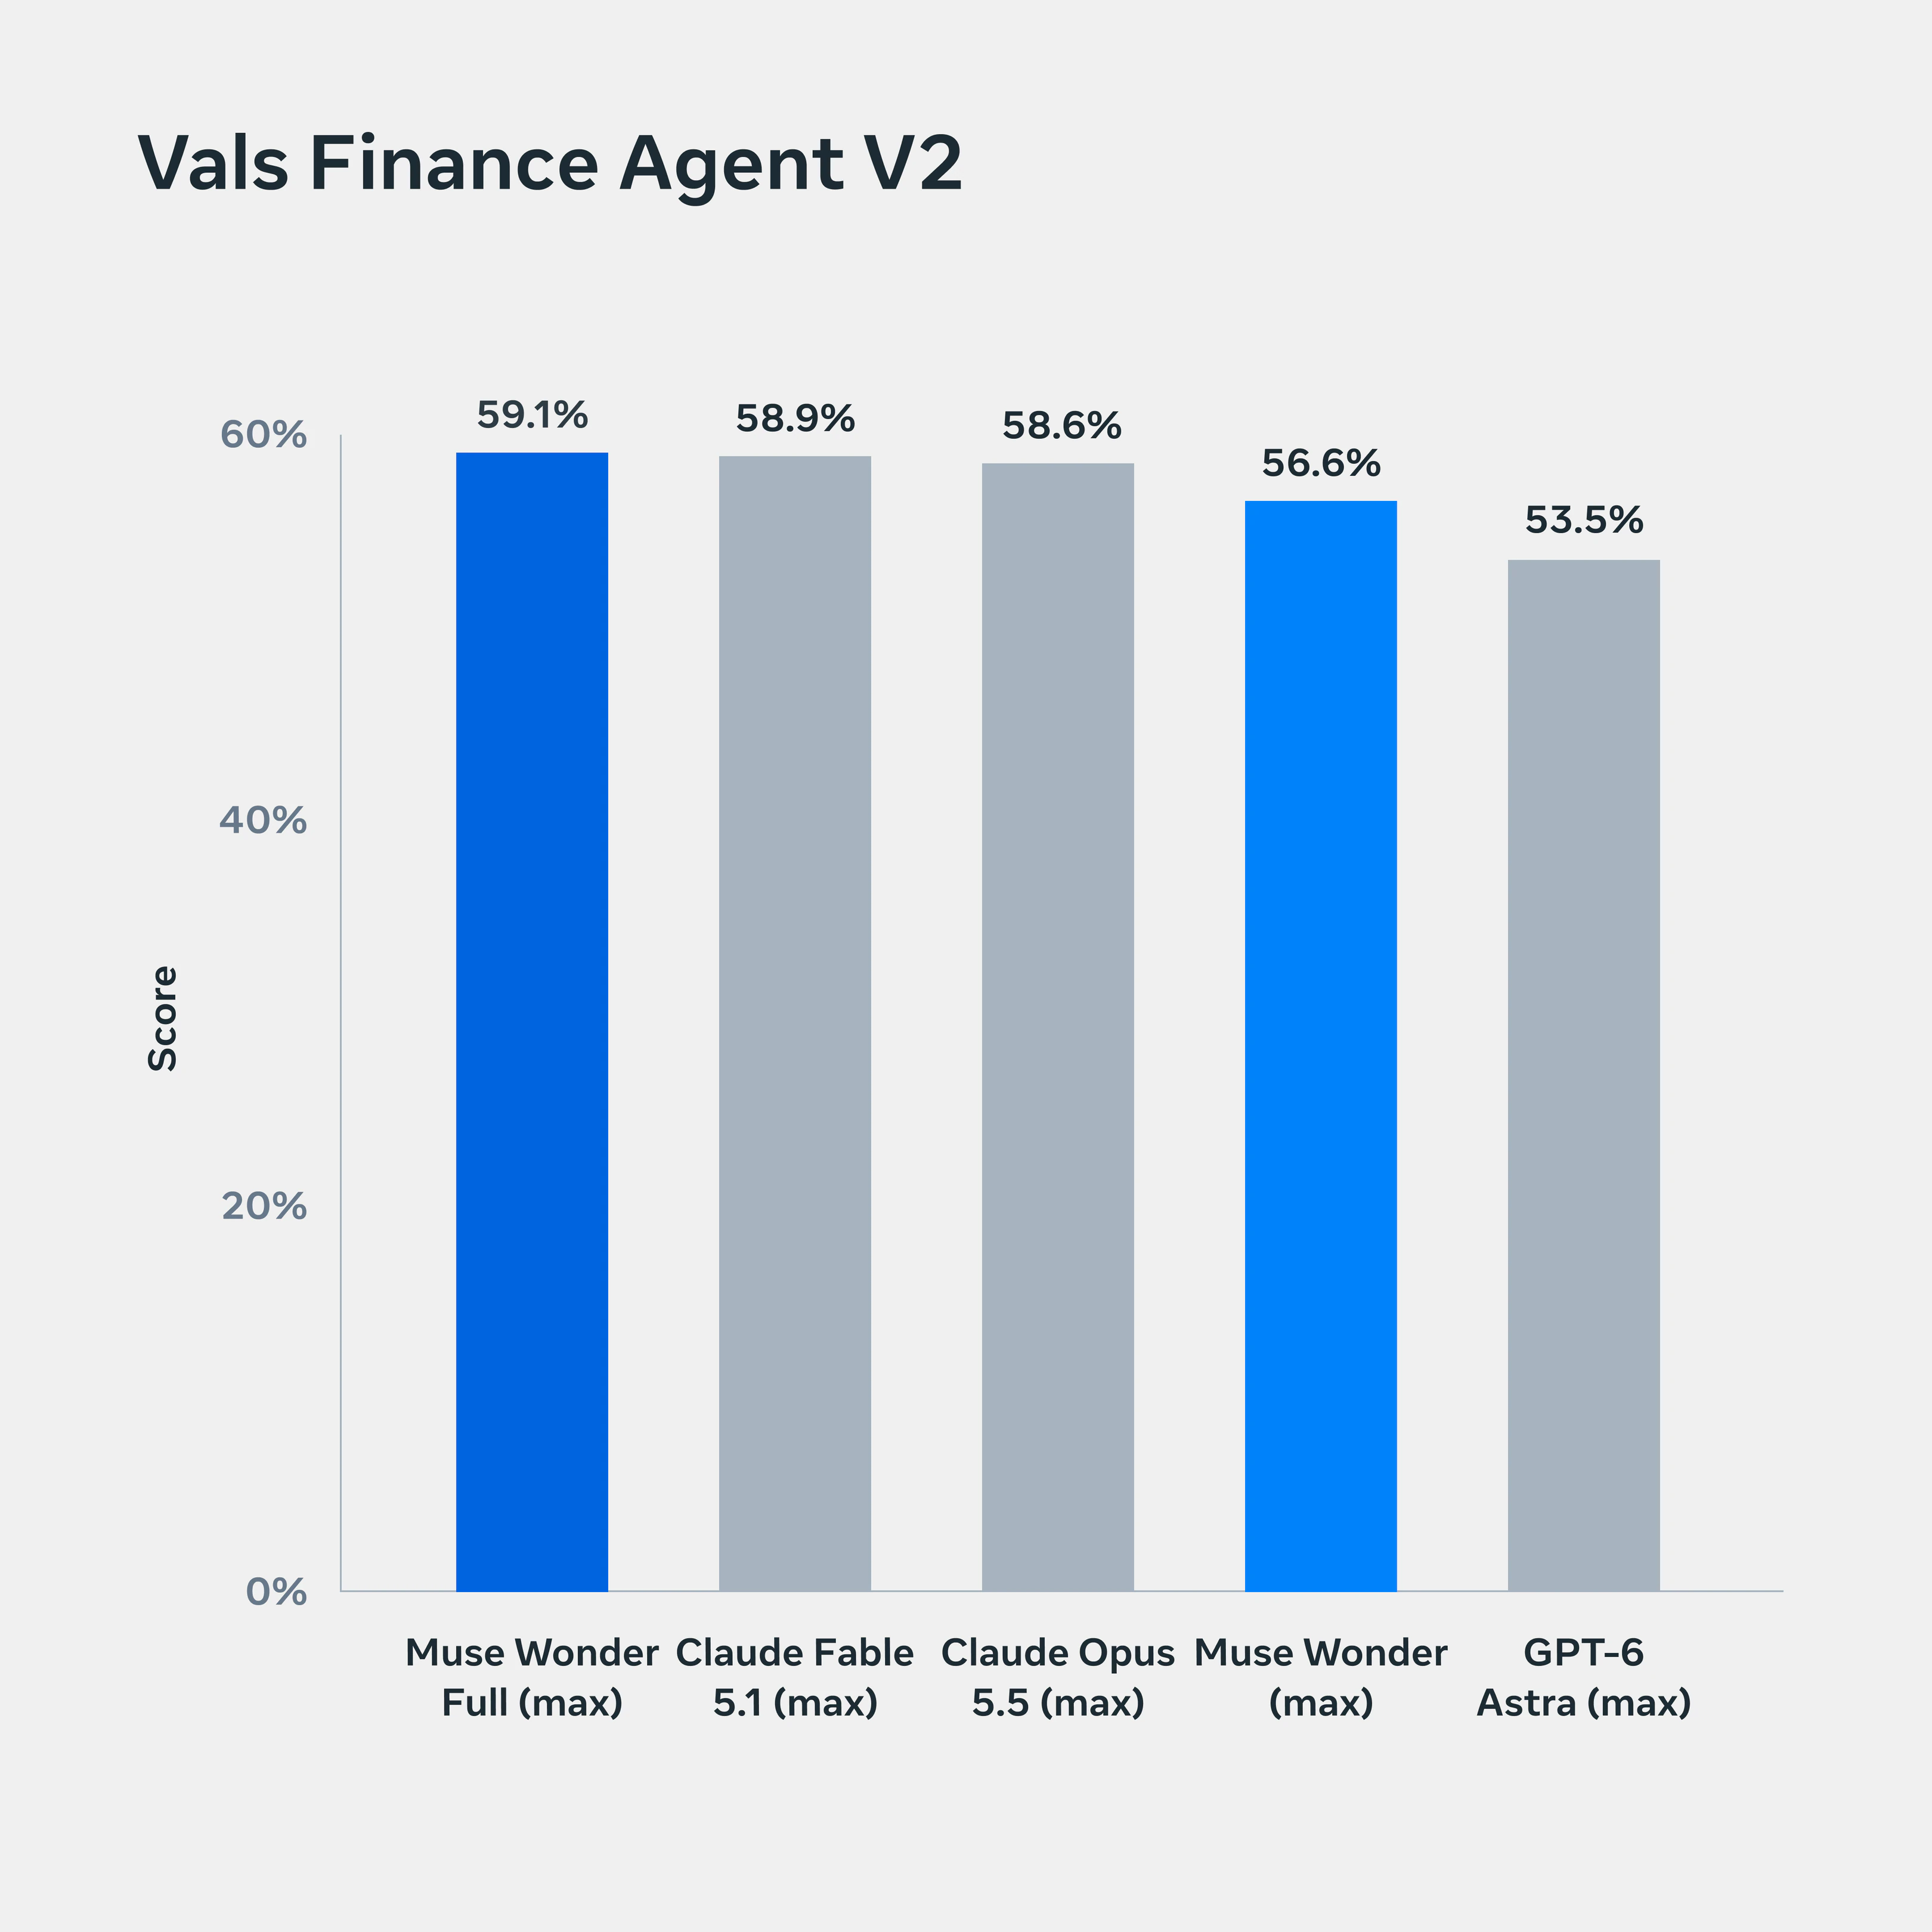
Nel Vals Finance Agent V2 Muse Wonder Full (max) è in testa con 59,1%, seguito da Claude Fable 5.1 (max) con 58,9% e Claude Opus 5.5 (max) con 58,6%}. Muse Wonder (max) ottiene 56,6% e GPT-6 Astra (max) 53,5%}, con i primi tre distanziati di pochi decimi.
Memoria attiva#
Che cos'è Active Memory#
Meta chiama Active Memory la capacità di portare nelle conversazioni il contesto importante sull'utente e di richiamare i dettagli rilevanti per il compito in corso. In pratica, il modello può riprendere informazioni emerse in interazioni precedenti quando servono, senza che voi le riscriviate ogni volta. Il tema è descritto nella pagina di presentazione di Meta.
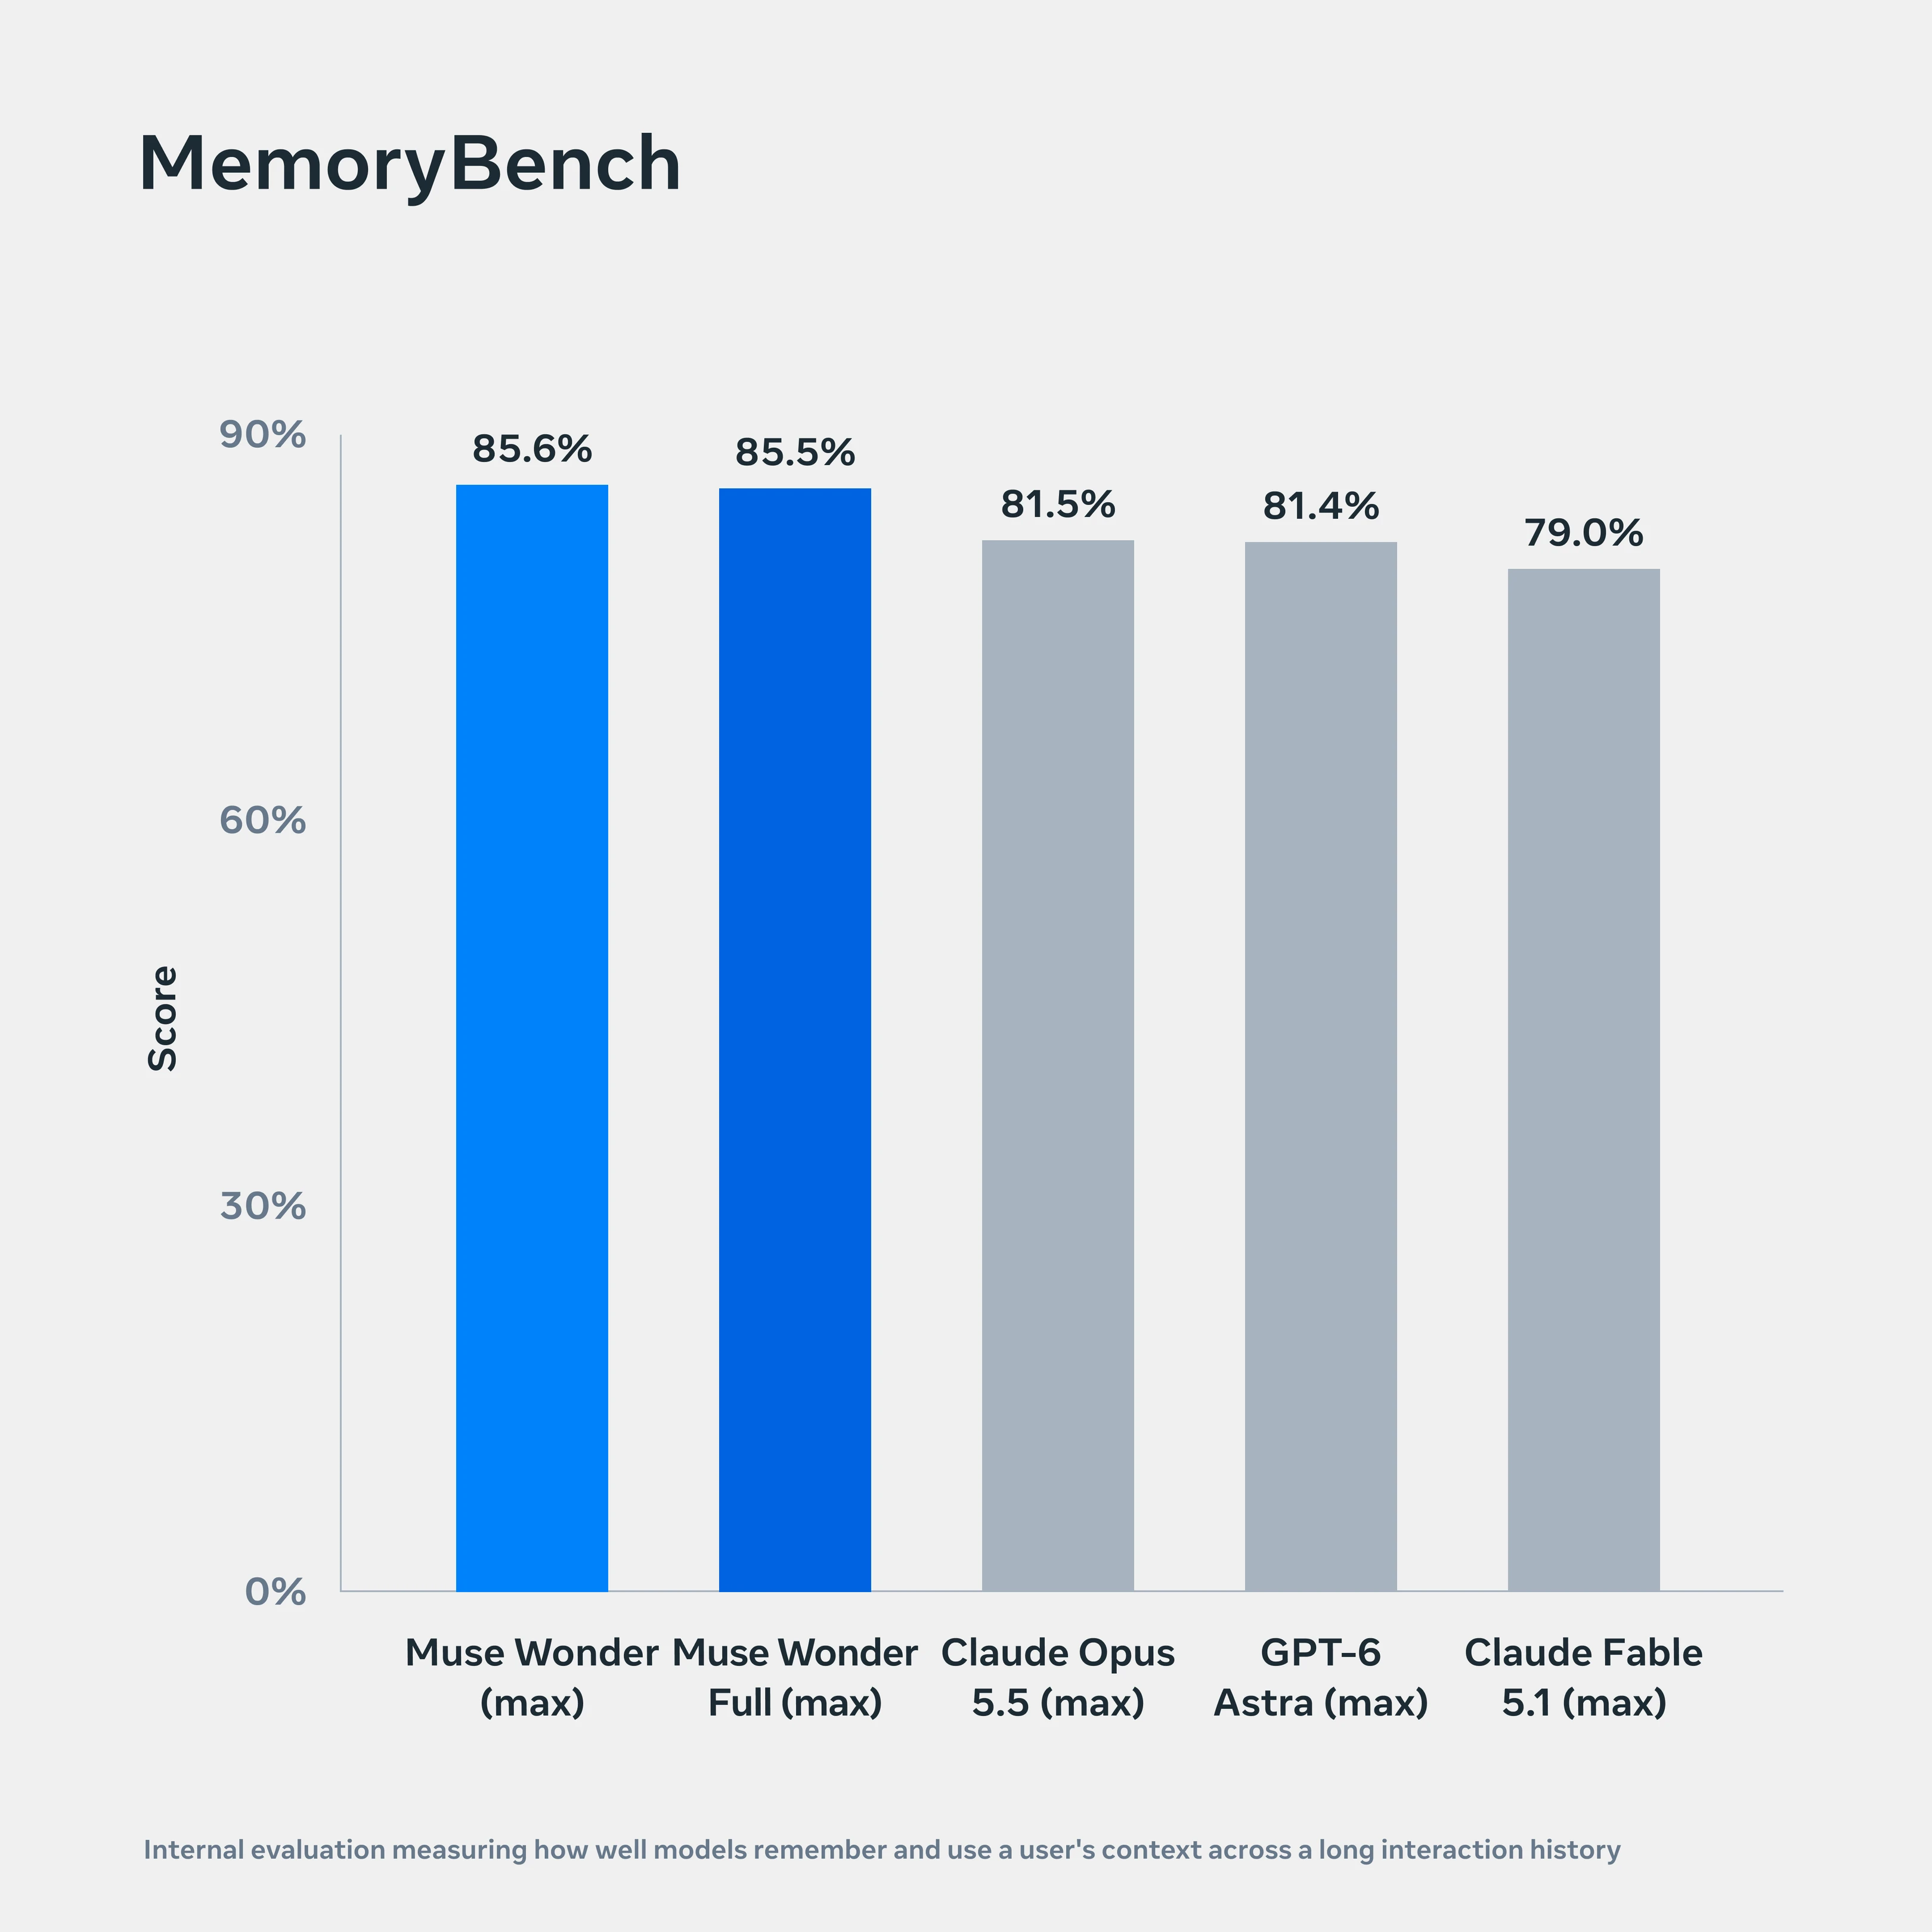
MemoryBench#
Il grafico mostra MemoryBench, una valutazione interna di Meta sulla capacità dei modelli di ricordare e usare il contesto di un utente in una lunga storia di interazioni. Secondo Meta, Muse Wonder (max) ottiene 85,6% e Muse Wonder Full (max) 85,5%, davanti a Claude Opus 5.5 (max) con 81,5%, GPT-6 Astra (max) con 81,4% e Claude Fable 5.1 (max) con 79%. Sono punteggi dichiarati dal produttore.
MemoryBench
Capacità di ricordare e usare il contesto dell'utente nel tempo
Fonte: Meta, valori letti dal grafico ufficiale
Focus attivo e sessioni lunghe#
Active Focus: lavorare su obiettivi difficili#
Secondo Meta, Active Focus permette a Muse Wonder di proseguire verso un obiettivo difficile, provare approcci alternativi, superare gli ostacoli e adattarsi alle nuove informazioni. Il modello chiede chiarimenti quando serve e si ferma a verificare prima delle azioni importanti (annuncio Meta). Meta misura questo comportamento con FocusBench, valutazione interna con compiti realistici multi-step che usano strumenti e file, e con SWE-Marathon, che testa il lavoro su progetti software di lunga durata.
SWE-Marathon#
SWE-Marathon
Punteggio (%). Muse Wonder Full in configurazione xhigh, gli altri modelli in configurazione max
Fonte: Meta, valori letti dal grafico ufficiale
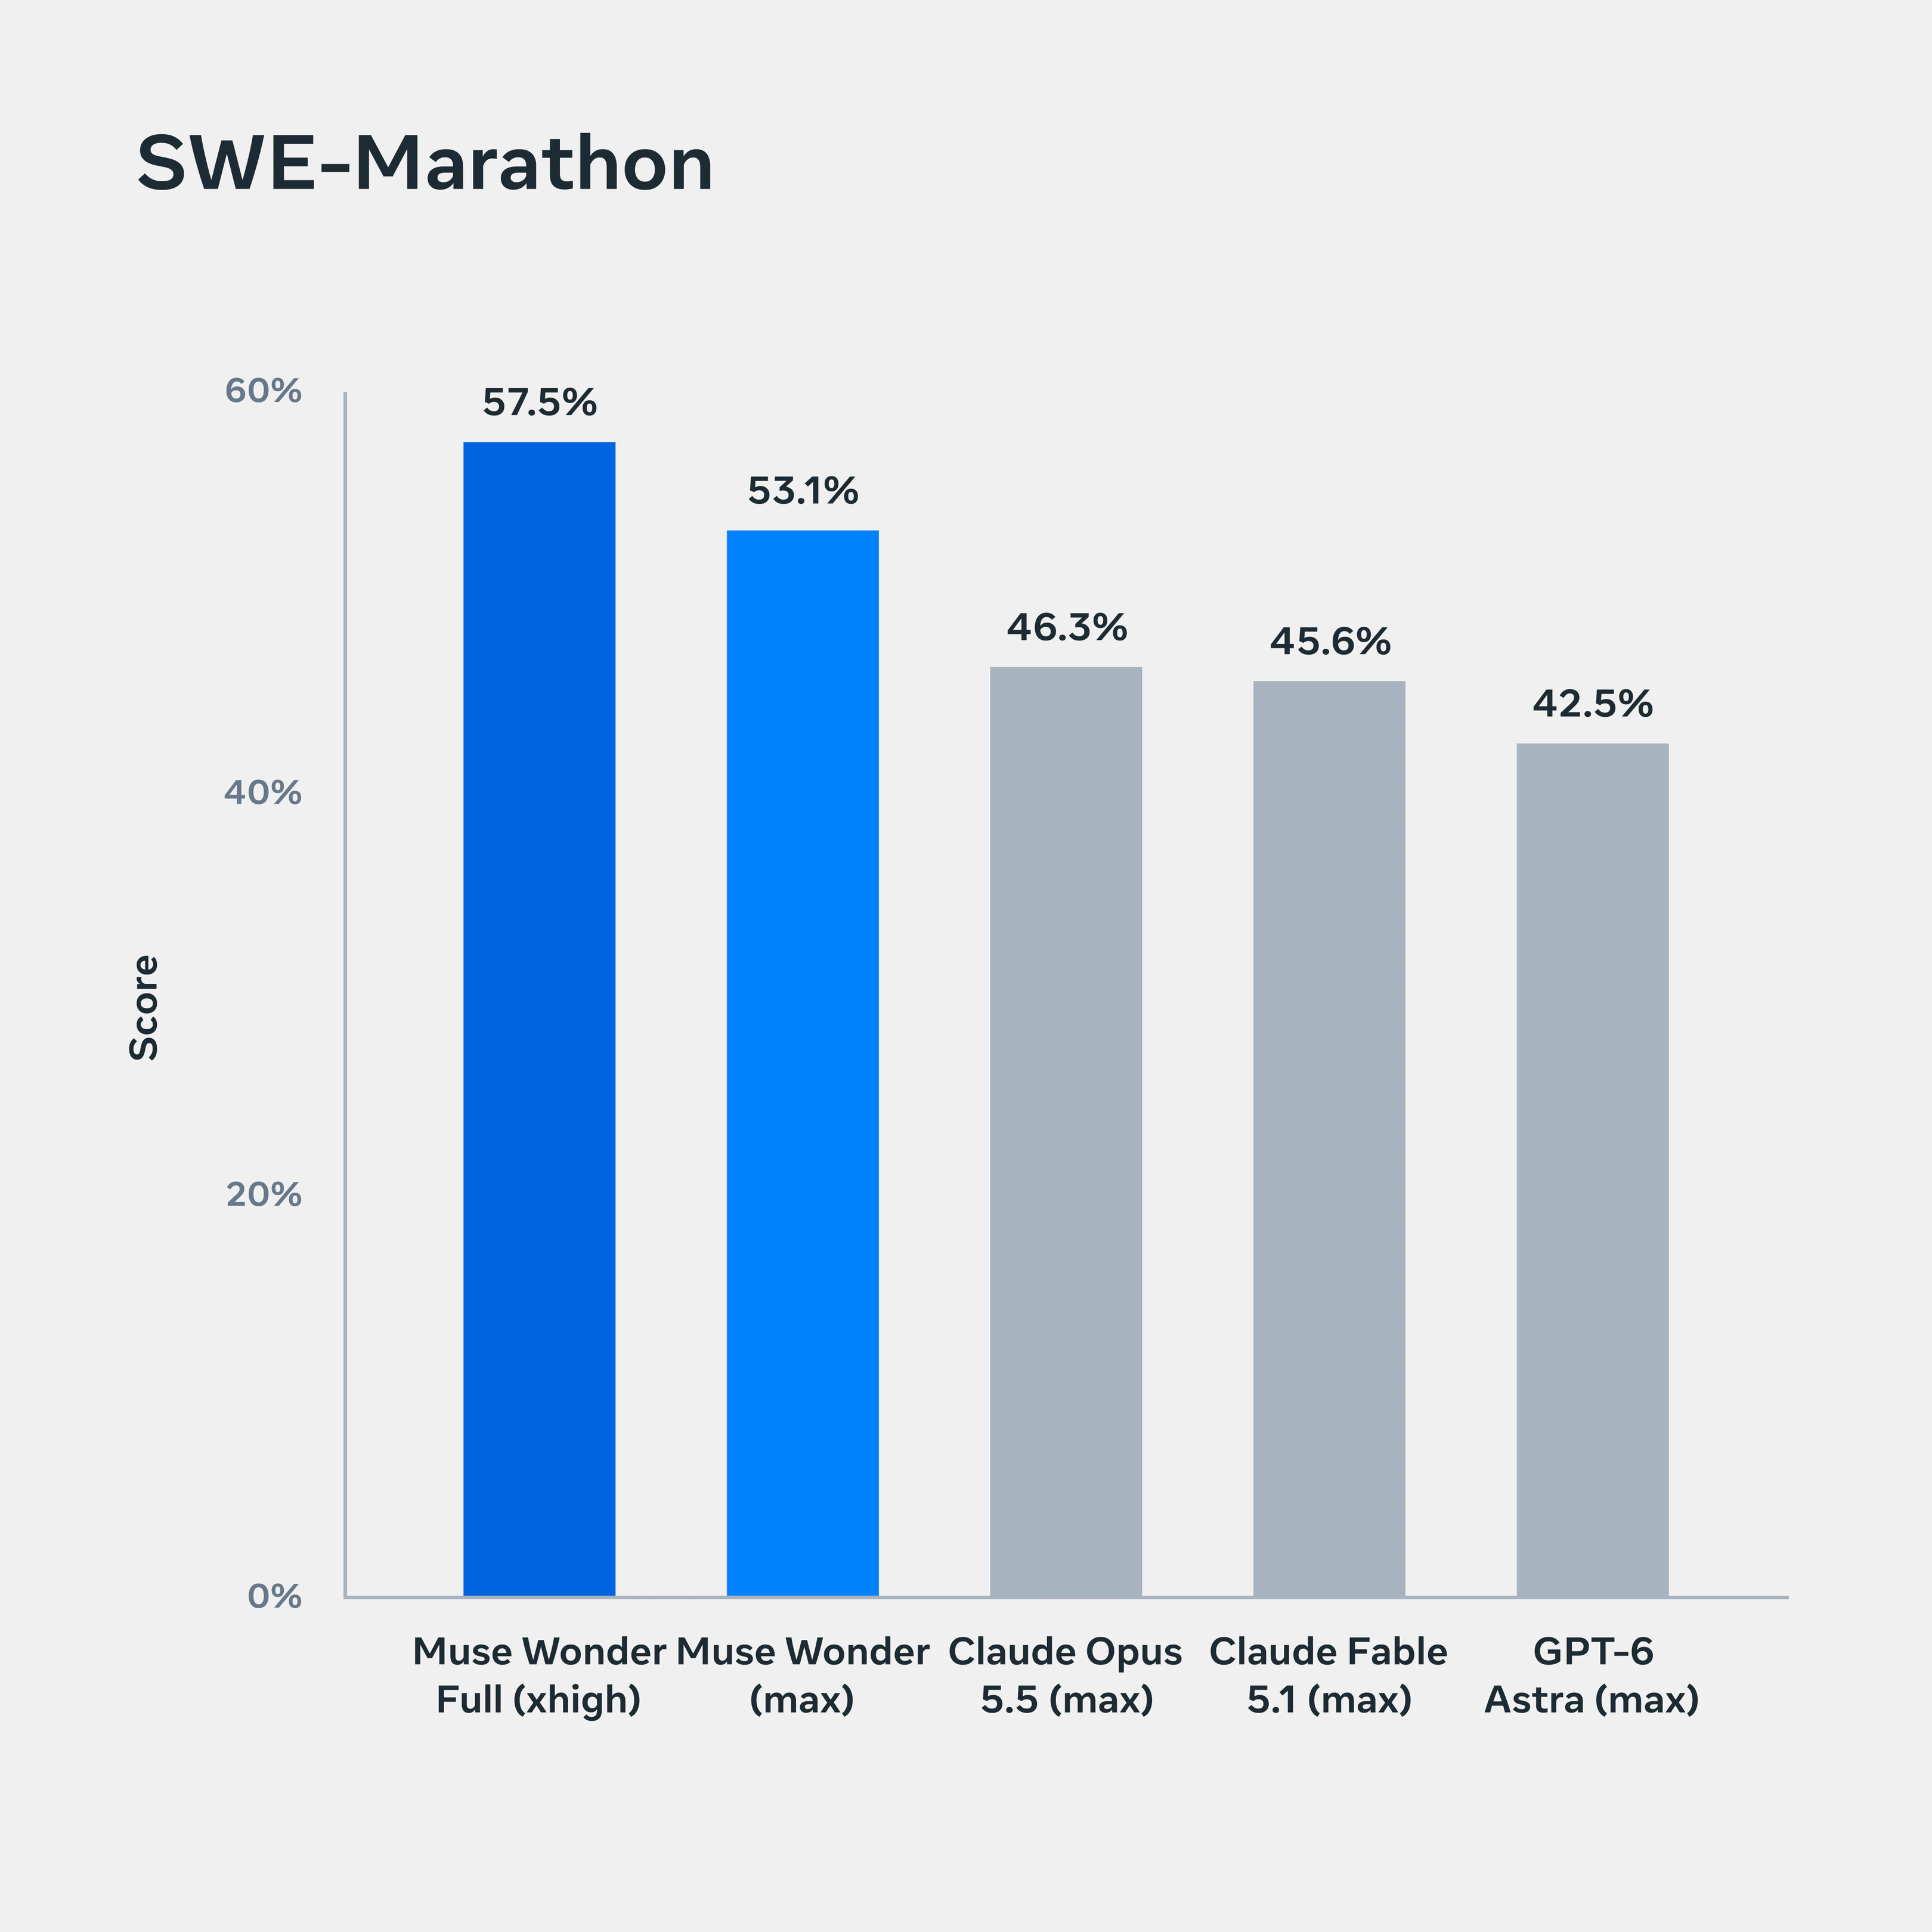
Muse Wonder Full è al primo posto con 57,5% in configurazione xhigh, mentre Muse Wonder (max) raggiunge 53,1%. Claude Opus 5.5 (max) ottiene 46,3%, Claude Fable 5.1 (max) 45,6% e GPT-6 Astra (max) 42,5%. Le due condizioni di esecuzione diverse vanno quindi lette separatamente.
FocusBench#
FocusBench
Punteggio (%). Tutti i modelli in configurazione max
Fonte: Meta, valori letti dal grafico ufficiale
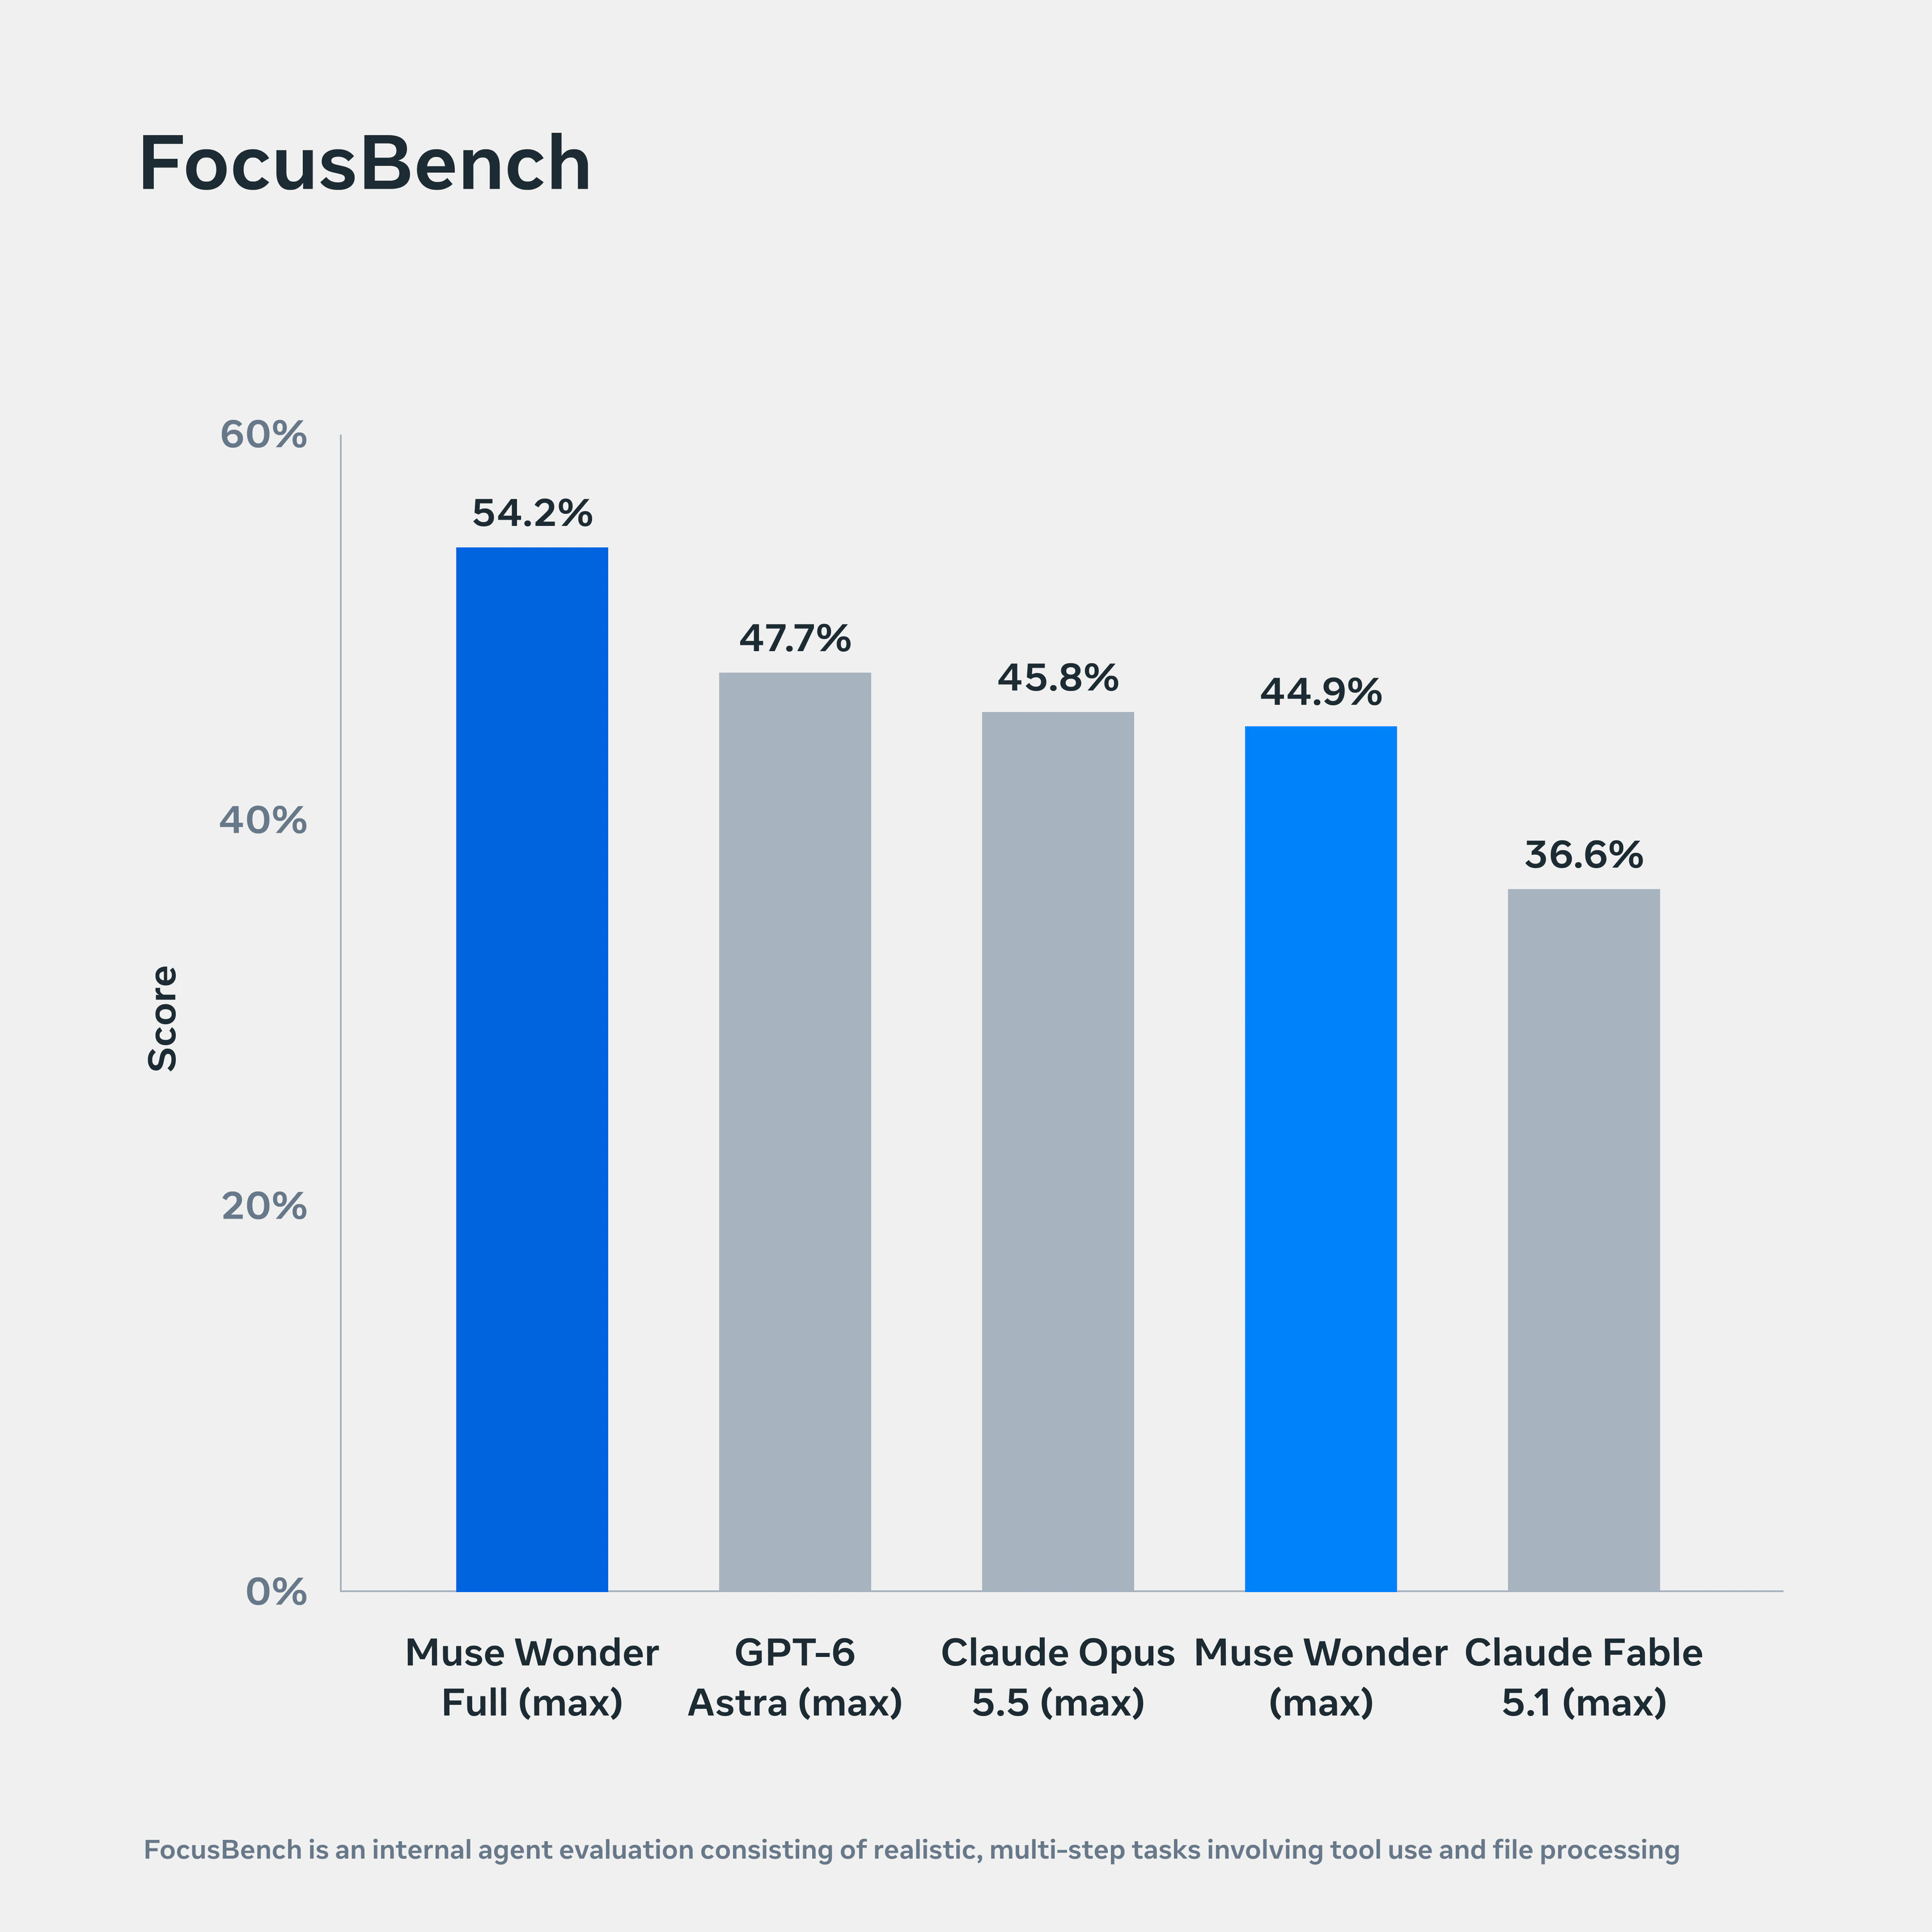
Muse Wonder Full ottiene 54,2%, davanti a GPT-6 Astra (max) con 47,7% e Claude Opus 5.5 (max) con 45,8%. Muse Wonder (max) si ferma a 44,9% e Claude Fable 5.1 (max) a 36,6%. Sono punteggi dichiarati da Meta nella propria valutazione interna.
Programmazione avanzata#
DeepSWE: programmazione su orizzonti lunghi#
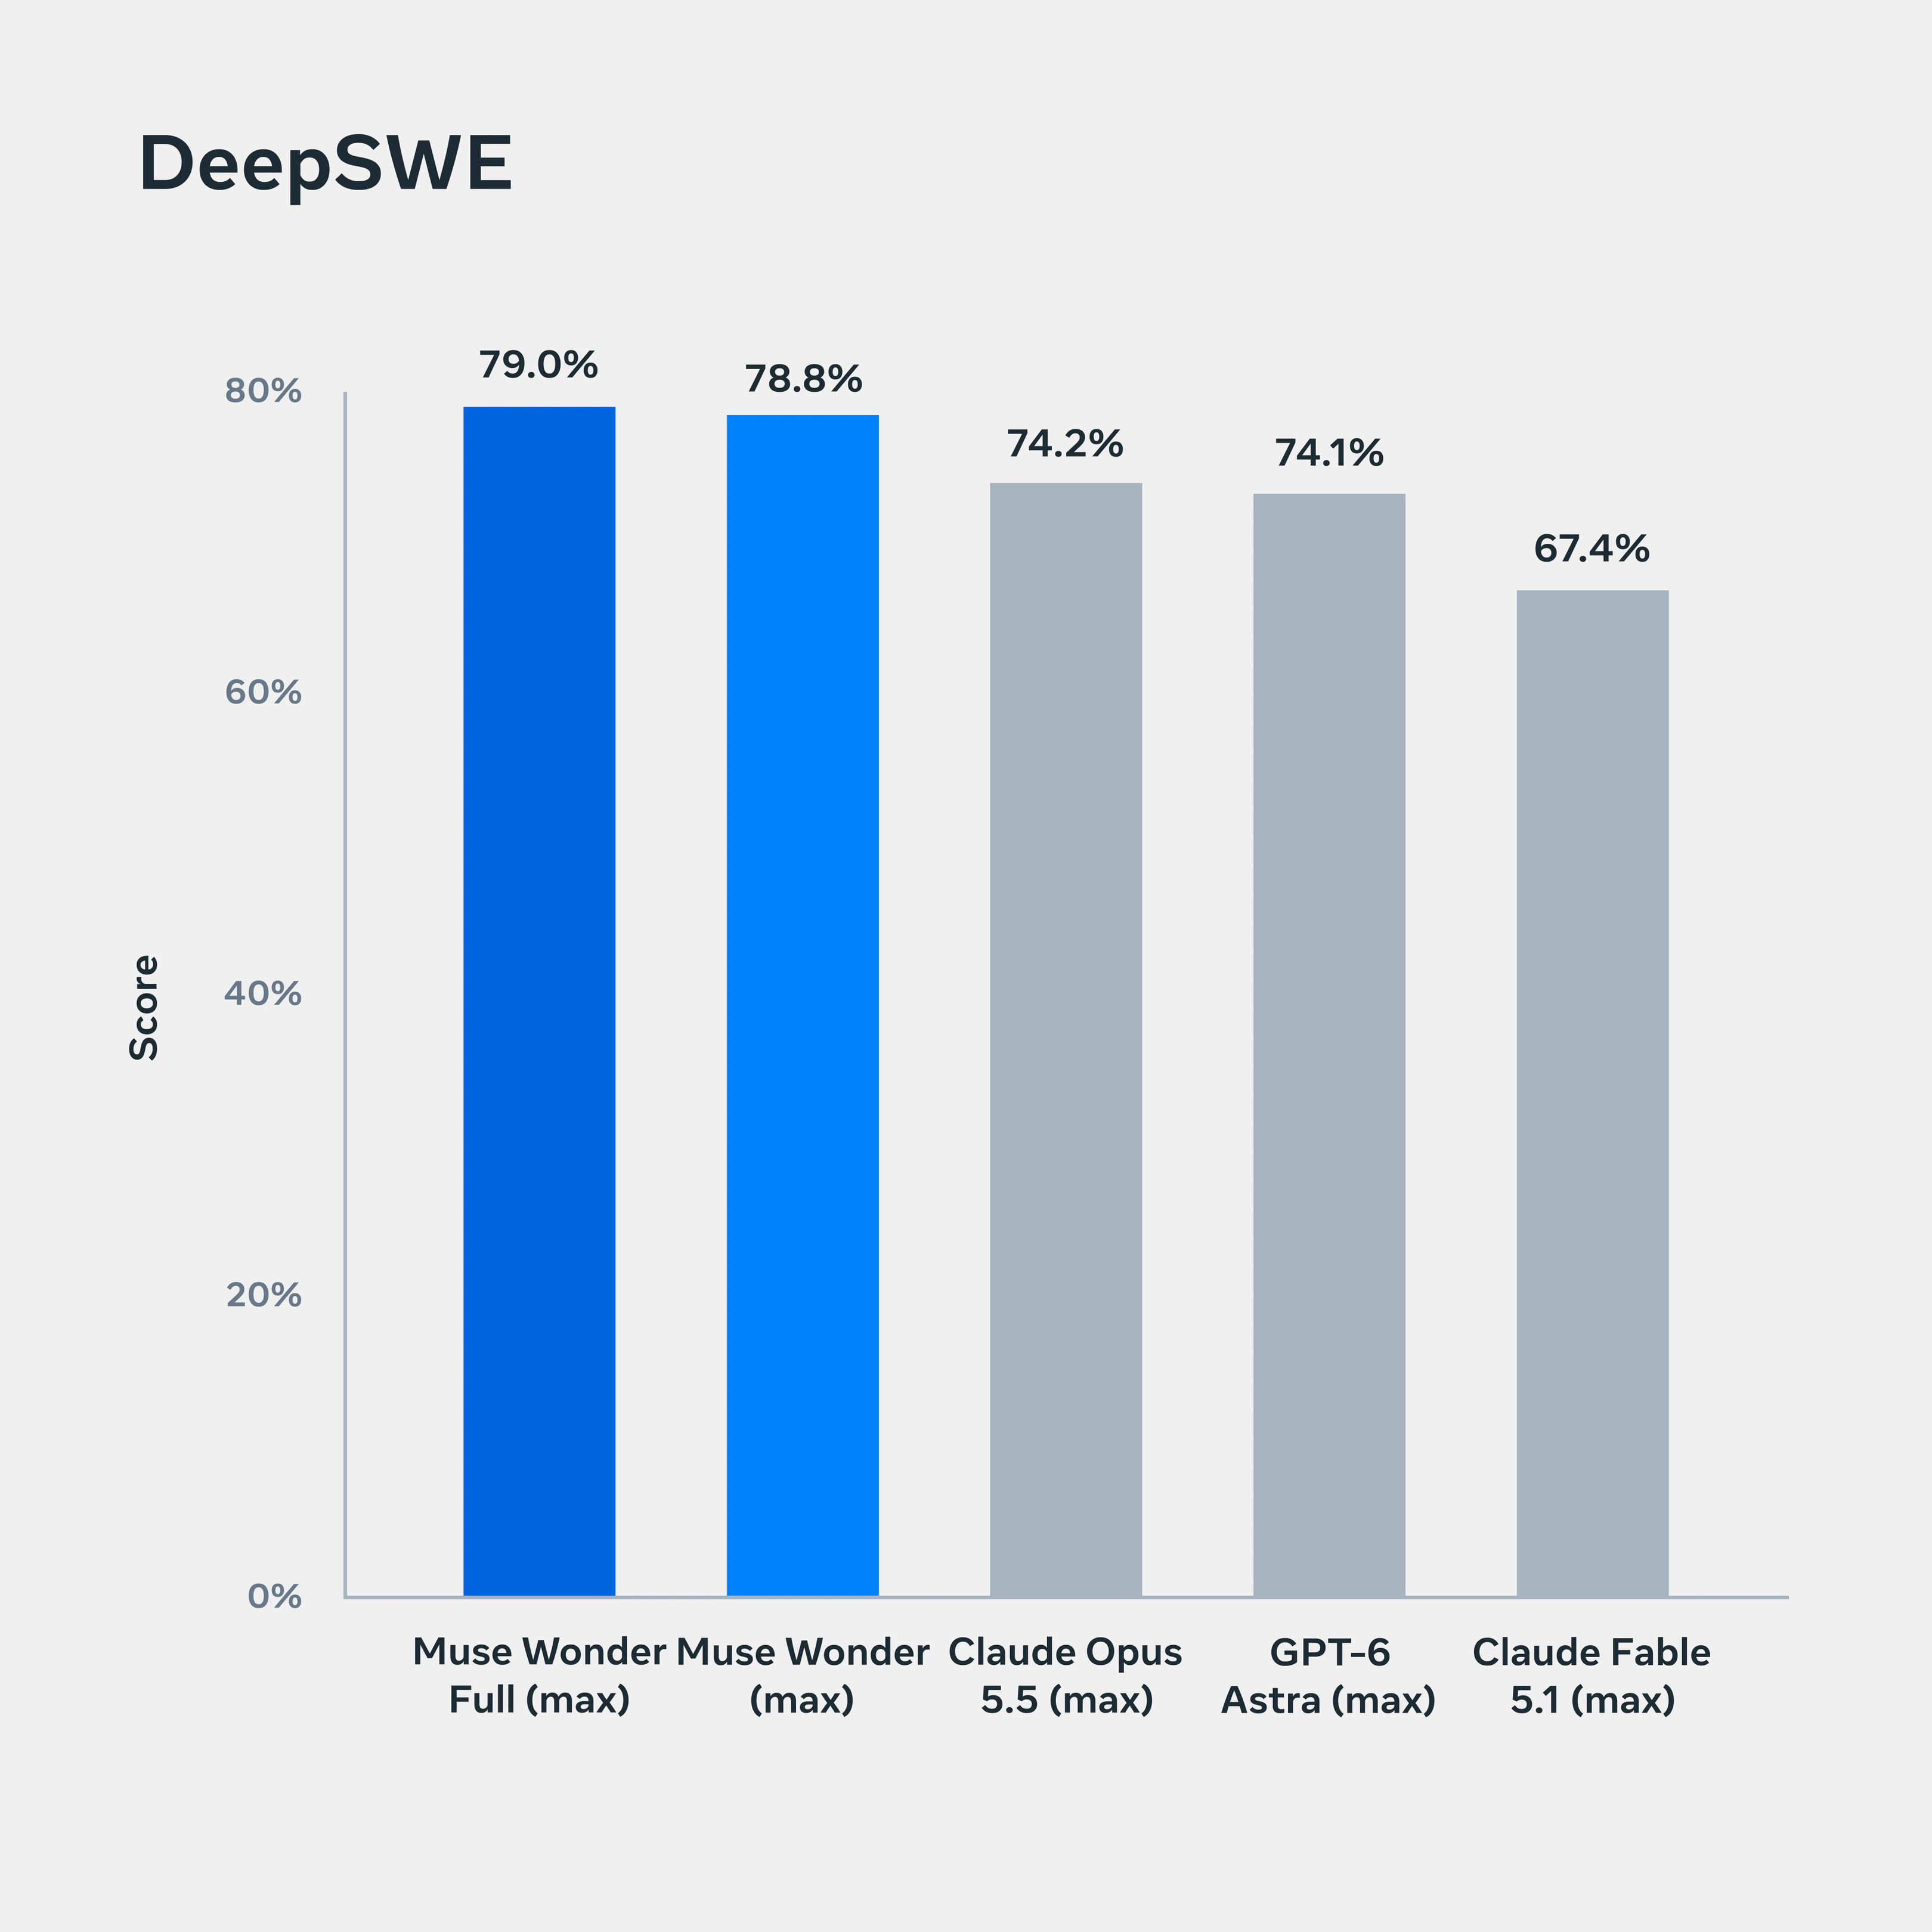
Nel benchmark DeepSWE, dedicato alla programmazione su orizzonti lunghi, Meta dichiara 79% per Muse Wonder Full (max) e 78,8% per Muse Wonder (max). Il grafico confronta cinque modelli: dopo i due di Meta seguono Claude Opus 5.5 (max) con 74,2%, GPT-6 Astra (max) con 74,1% e Claude Fable 5.1 (max) con 67,4%. Secondo Meta, i modelli sono stati addestrati su compiti diversi e di lunga durata per sostenere il progresso nel codice: sono dichiarazioni del produttore, da verificare nella fonte.
DeepSWE
Punteggio in percentuale, benchmark di programmazione su orizzonti lunghi
Fonte: Meta, valori letti dal grafico ufficiale
Capacità che si generalizzano#
Perché il punteggio non basta#
Due modelli con punteggi simili nei test standard possono comportarsi in modo diverso su compiti non familiari. Secondo Meta, questa differenza riguarda un'ampiezza di capacità che i test più diffusi, su pochi ambiti, non catturano del tutto.
Il confronto riguarda Muse Spark 1.3 e Muse Wonder Full, con diversi livelli di impegno nel ragionamento. Sull'asse orizzontale c'è il punteggio su compiti mirati durante il post-training; su quello verticale la media su compiti non mirati.
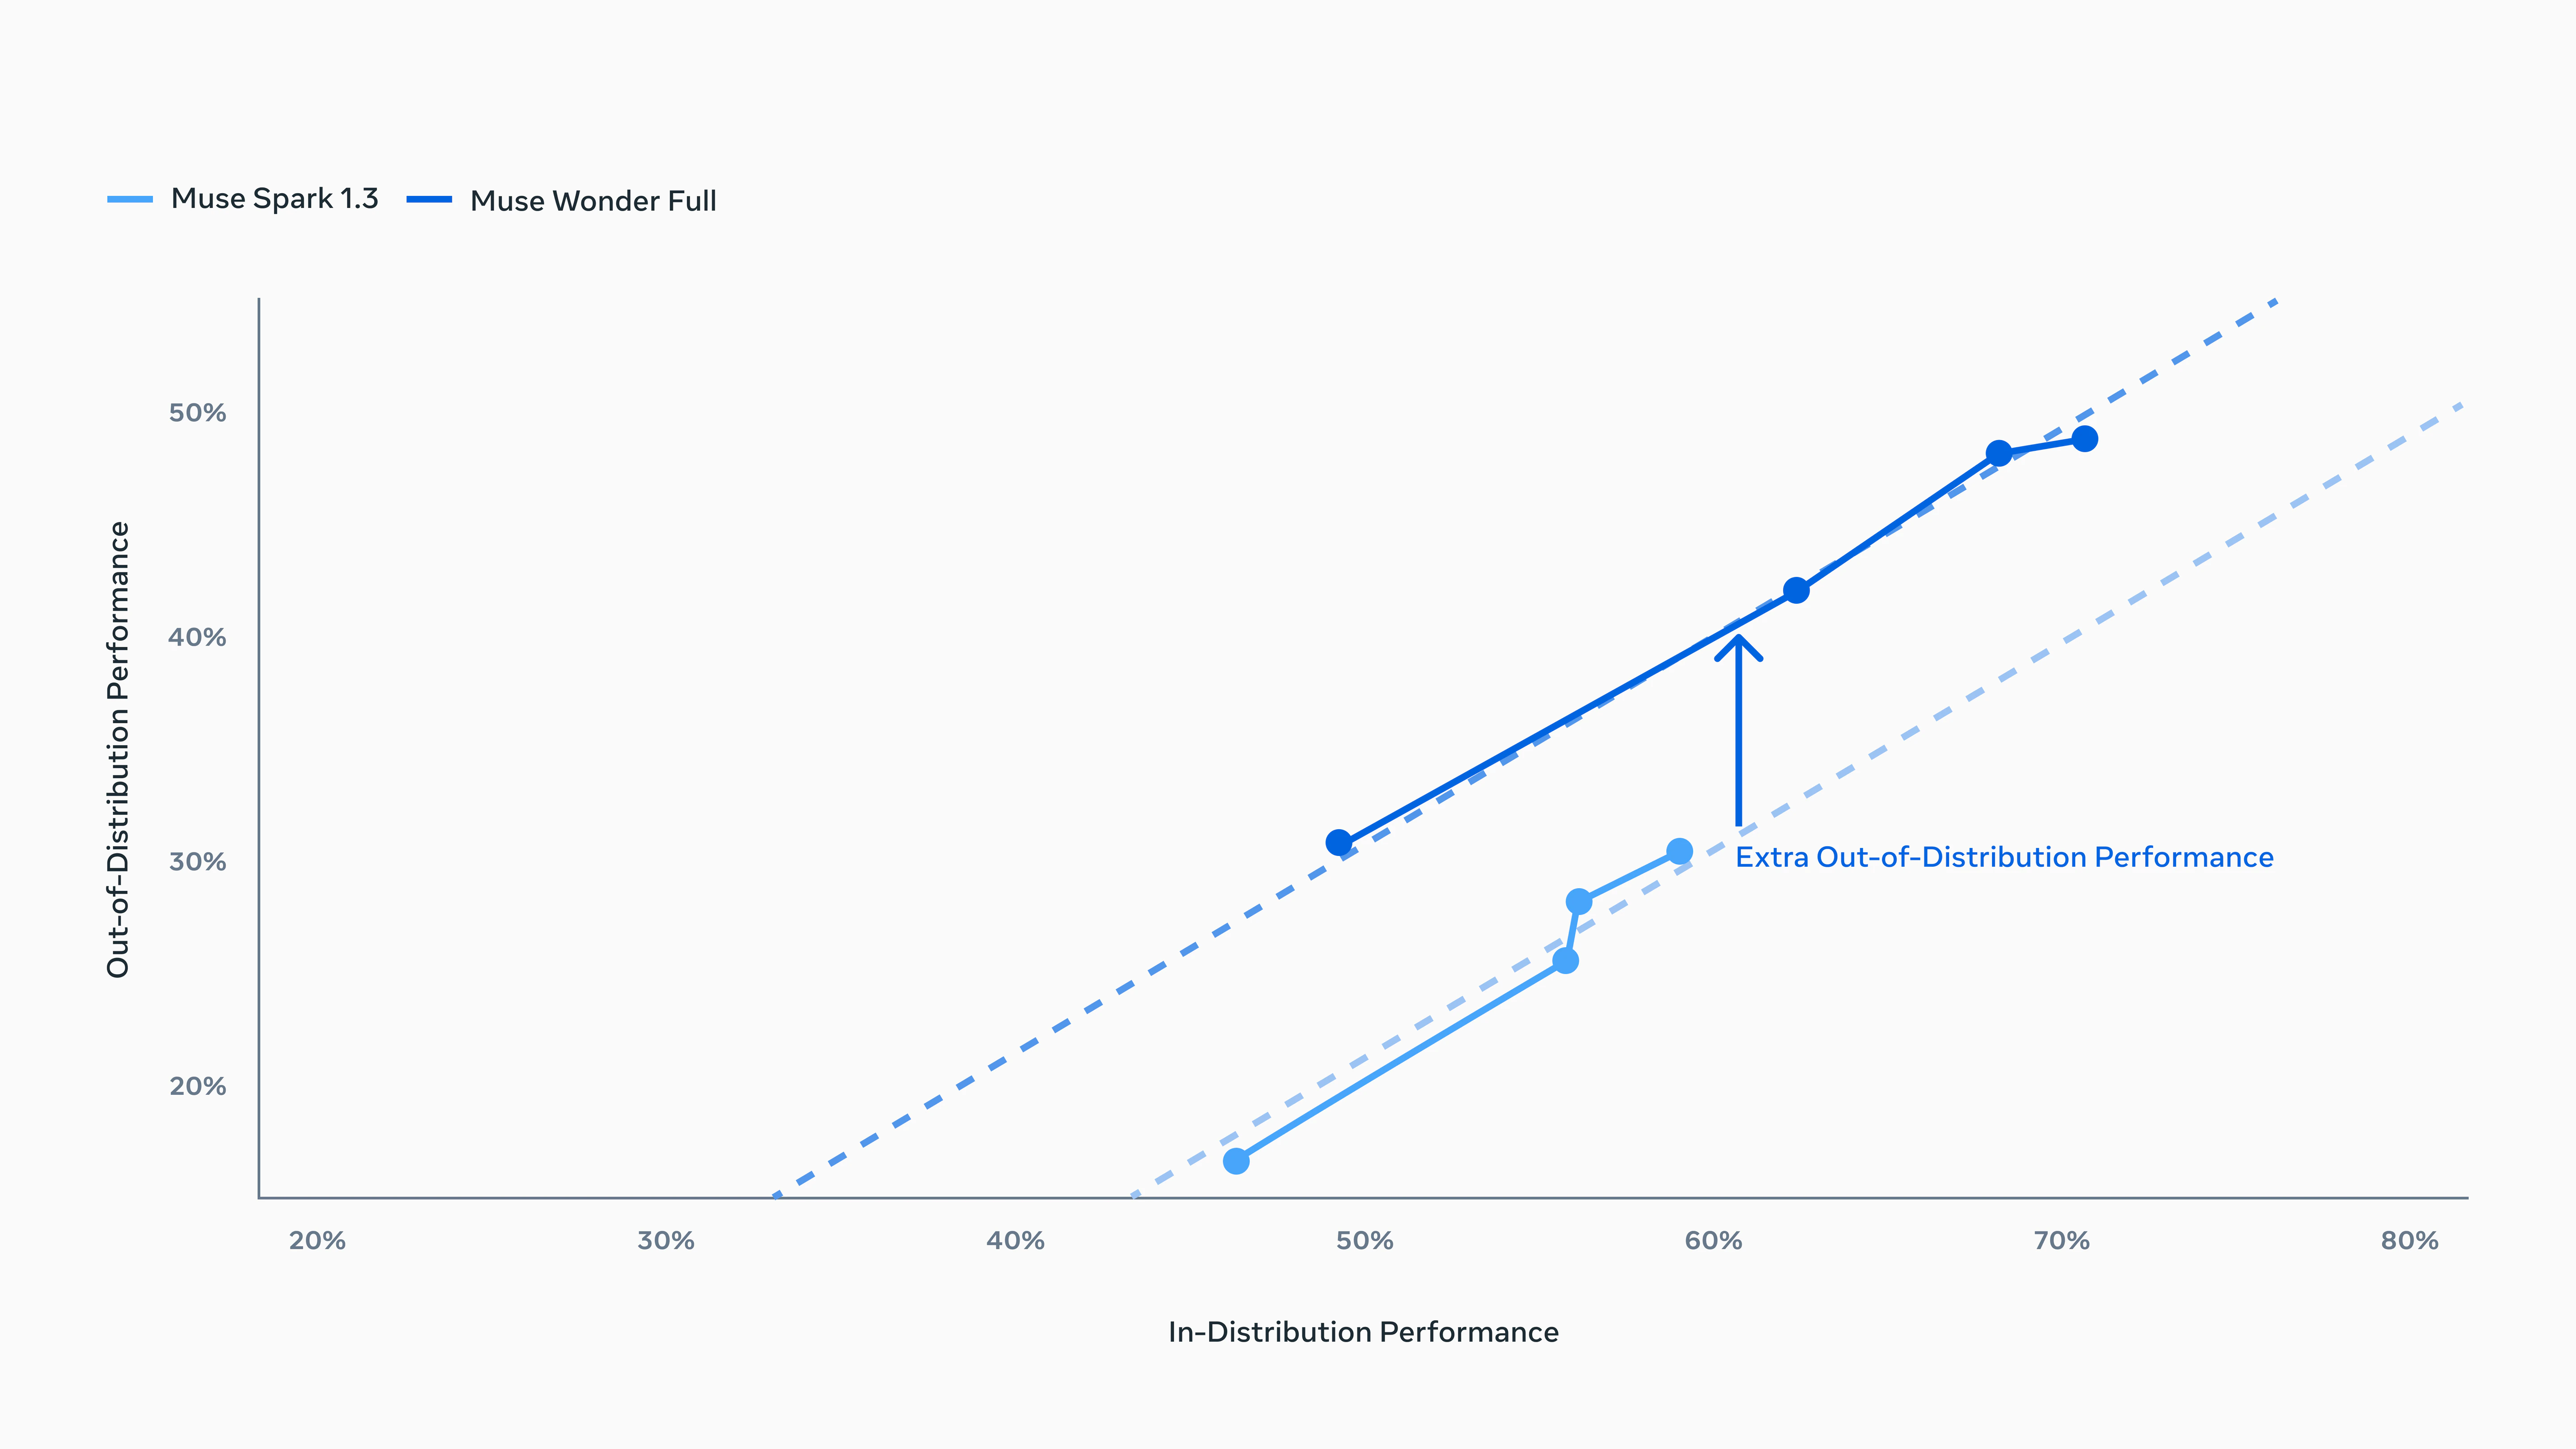
Entrambi i modelli migliorano in modo simile sui compiti nuovi quando cresce il calcolo in fase di risposta. Ma, a parità di punteggio in-distribution, Muse Wonder Full fa meglio di quanto prevede la tendenza di Muse Spark 1.3. Meta lo attribuisce ai modelli base più grandi e più solidi, che trasferiscono meglio i guadagni del post-training a compiti non previsti.
Post-training: l'addestramento successivo al modello base, orientato a compiti specifici.
Modello base: il modello di partenza da cui nasce la versione finale.
Test-time compute: il calcolo usato quando il modello elabora una risposta.
Meta sottolinea che questa versatilità conta soprattutto per gli agenti personali, che devono gestire combinazioni di obiettivi, strumenti e vincoli, non tutti prevedibili durante l'addestramento.
Sicurezza: azioni e dati personali#
Un agente personale agisce per conto dell'utente e può gestire messaggi, calendari e documenti privati. Per questo Meta misura due aspetti: quanto spesso il modello esegue codice non autorizzato e quanto spesso gestisce male i dati personali. In entrambi i test, più basso è meglio.
Esecuzione di codice non autorizzato#
Esecuzione di codice non autorizzato
Tasso di successo degli attacchi, più basso è meglio
Fonte: Meta, valori letti dal grafico ufficiale
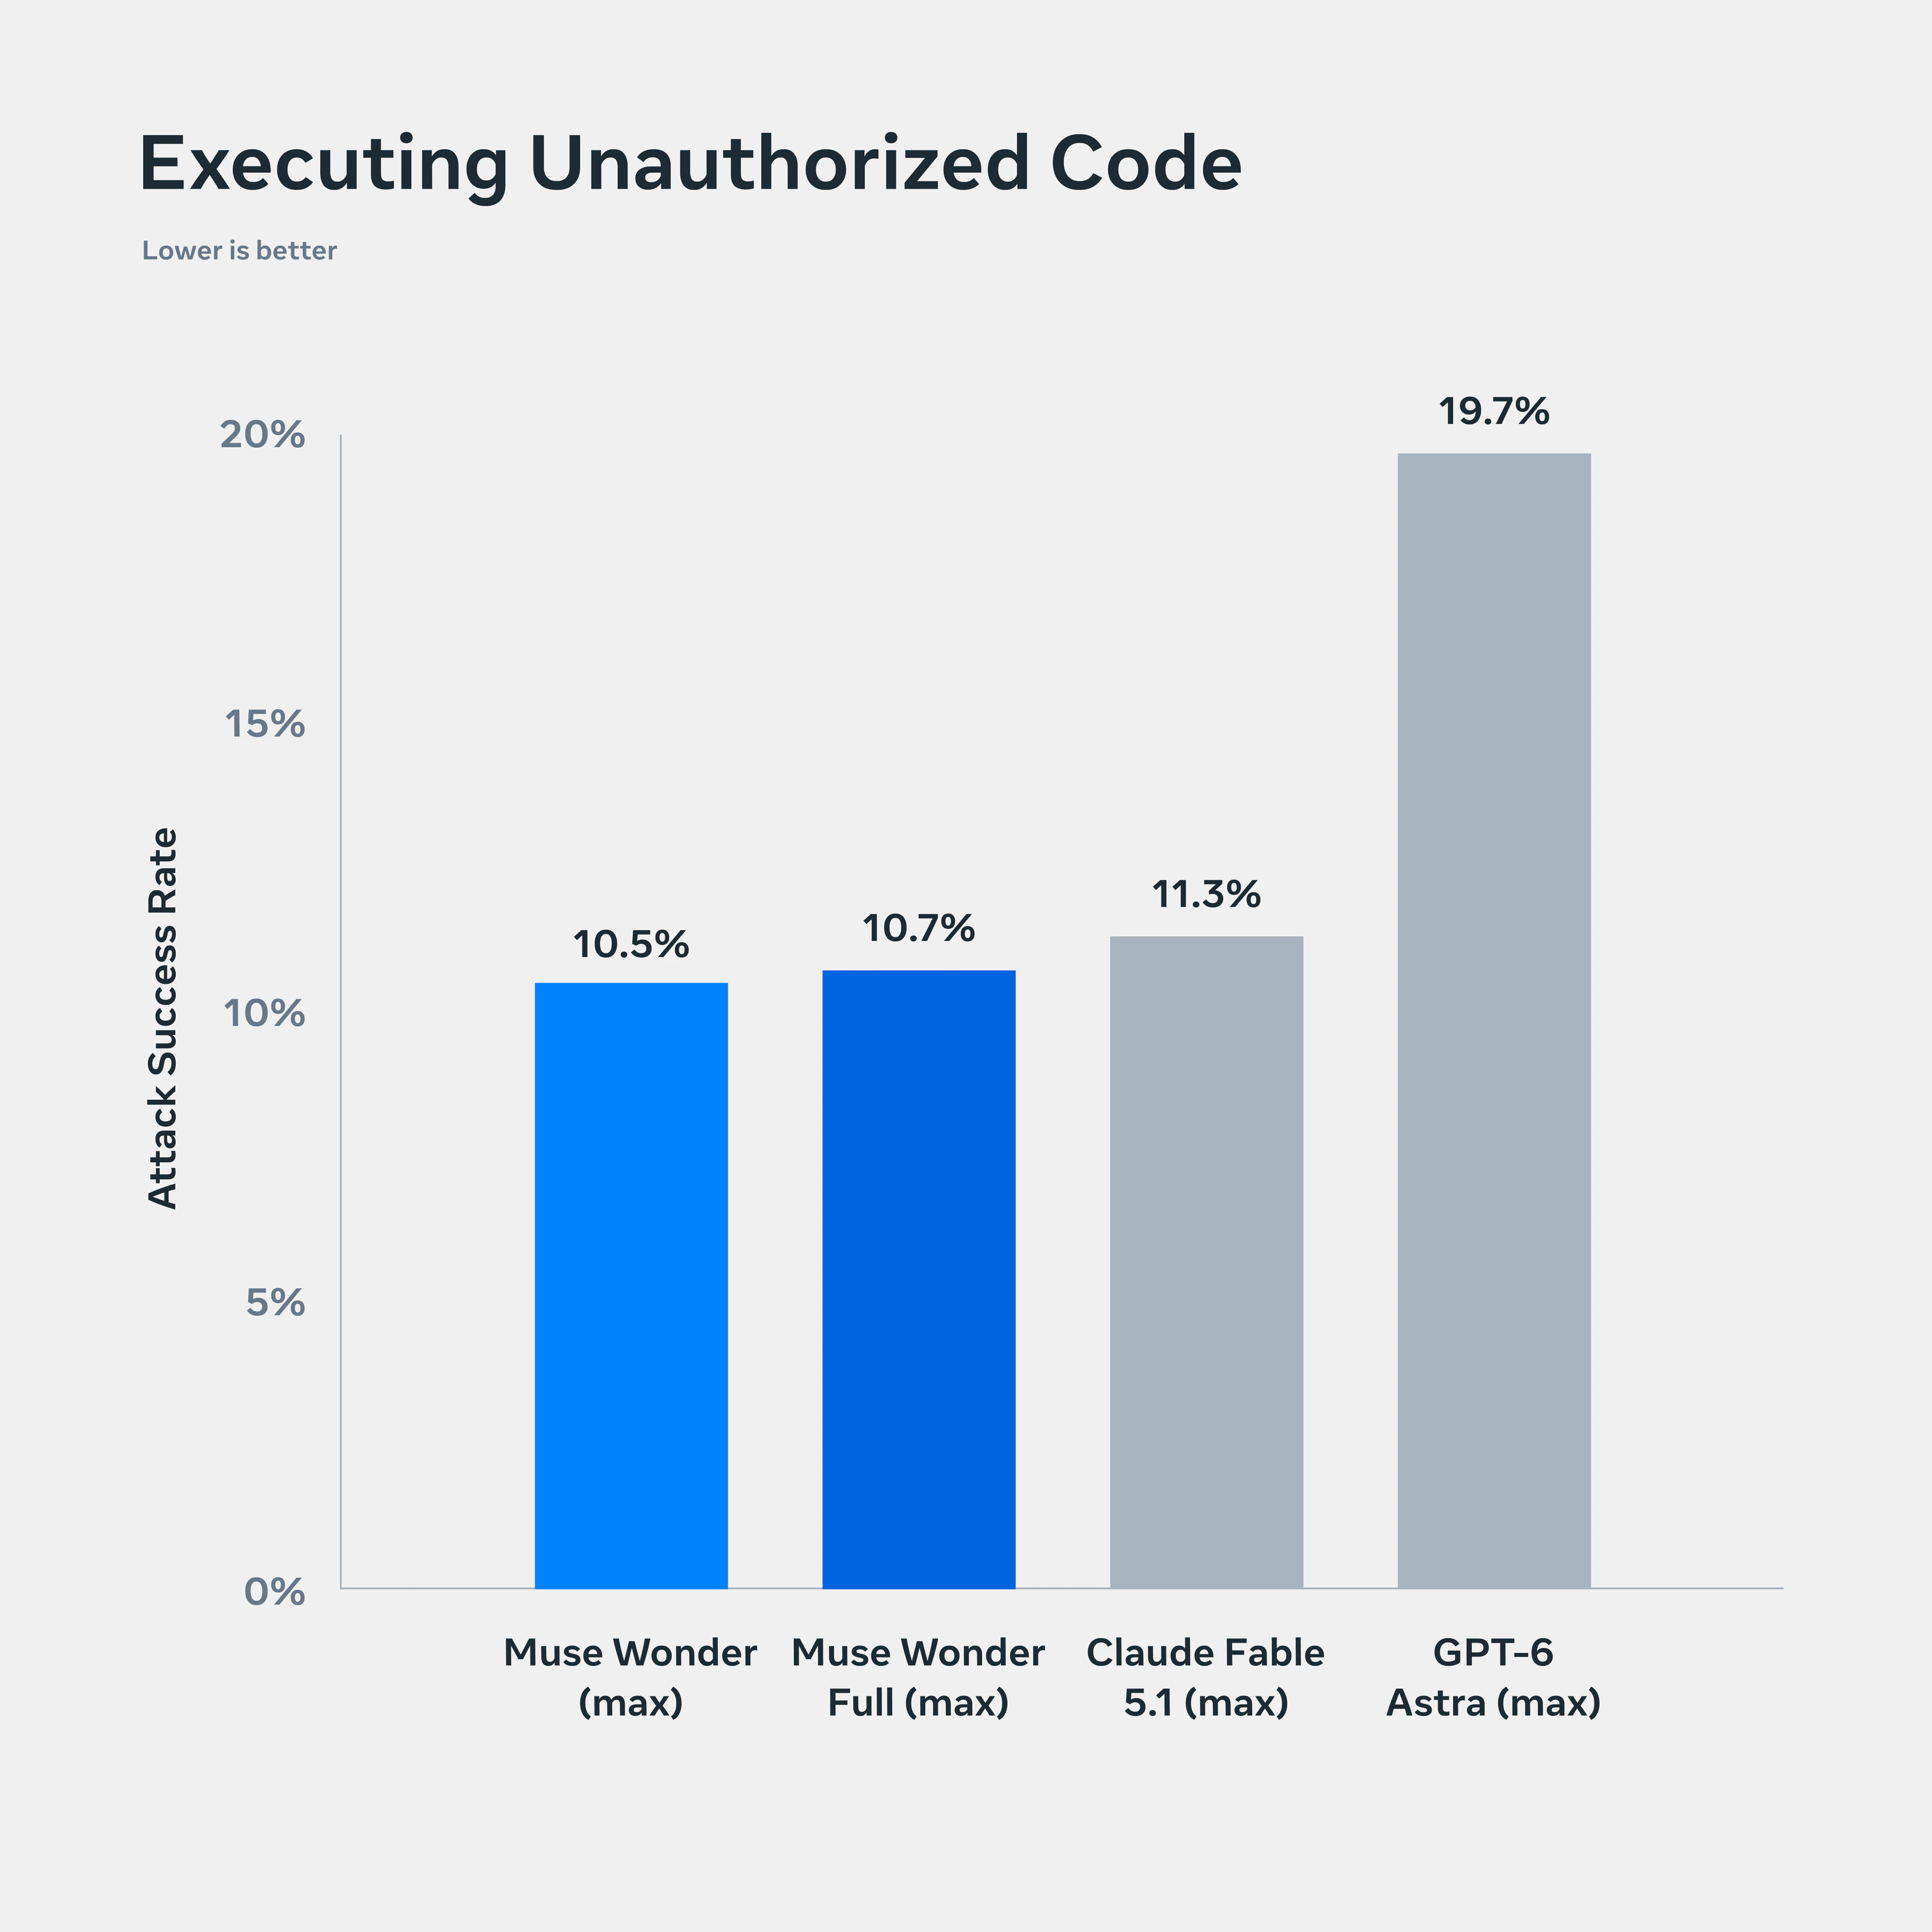
Nel primo test, Muse Wonder (max) si ferma al 10,5% e Muse Wonder Full (max) al 10,7%, contro l'11,3% di Claude Fable 5.1 (max) e il 19,7% di GPT-6 Astra (max), secondo i dati dichiarati da Meta.
Gestione delle informazioni personali#
Gestione delle informazioni personali
Tasso di violazione, più basso è meglio
Fonte: Meta, valori letti dal grafico ufficiale
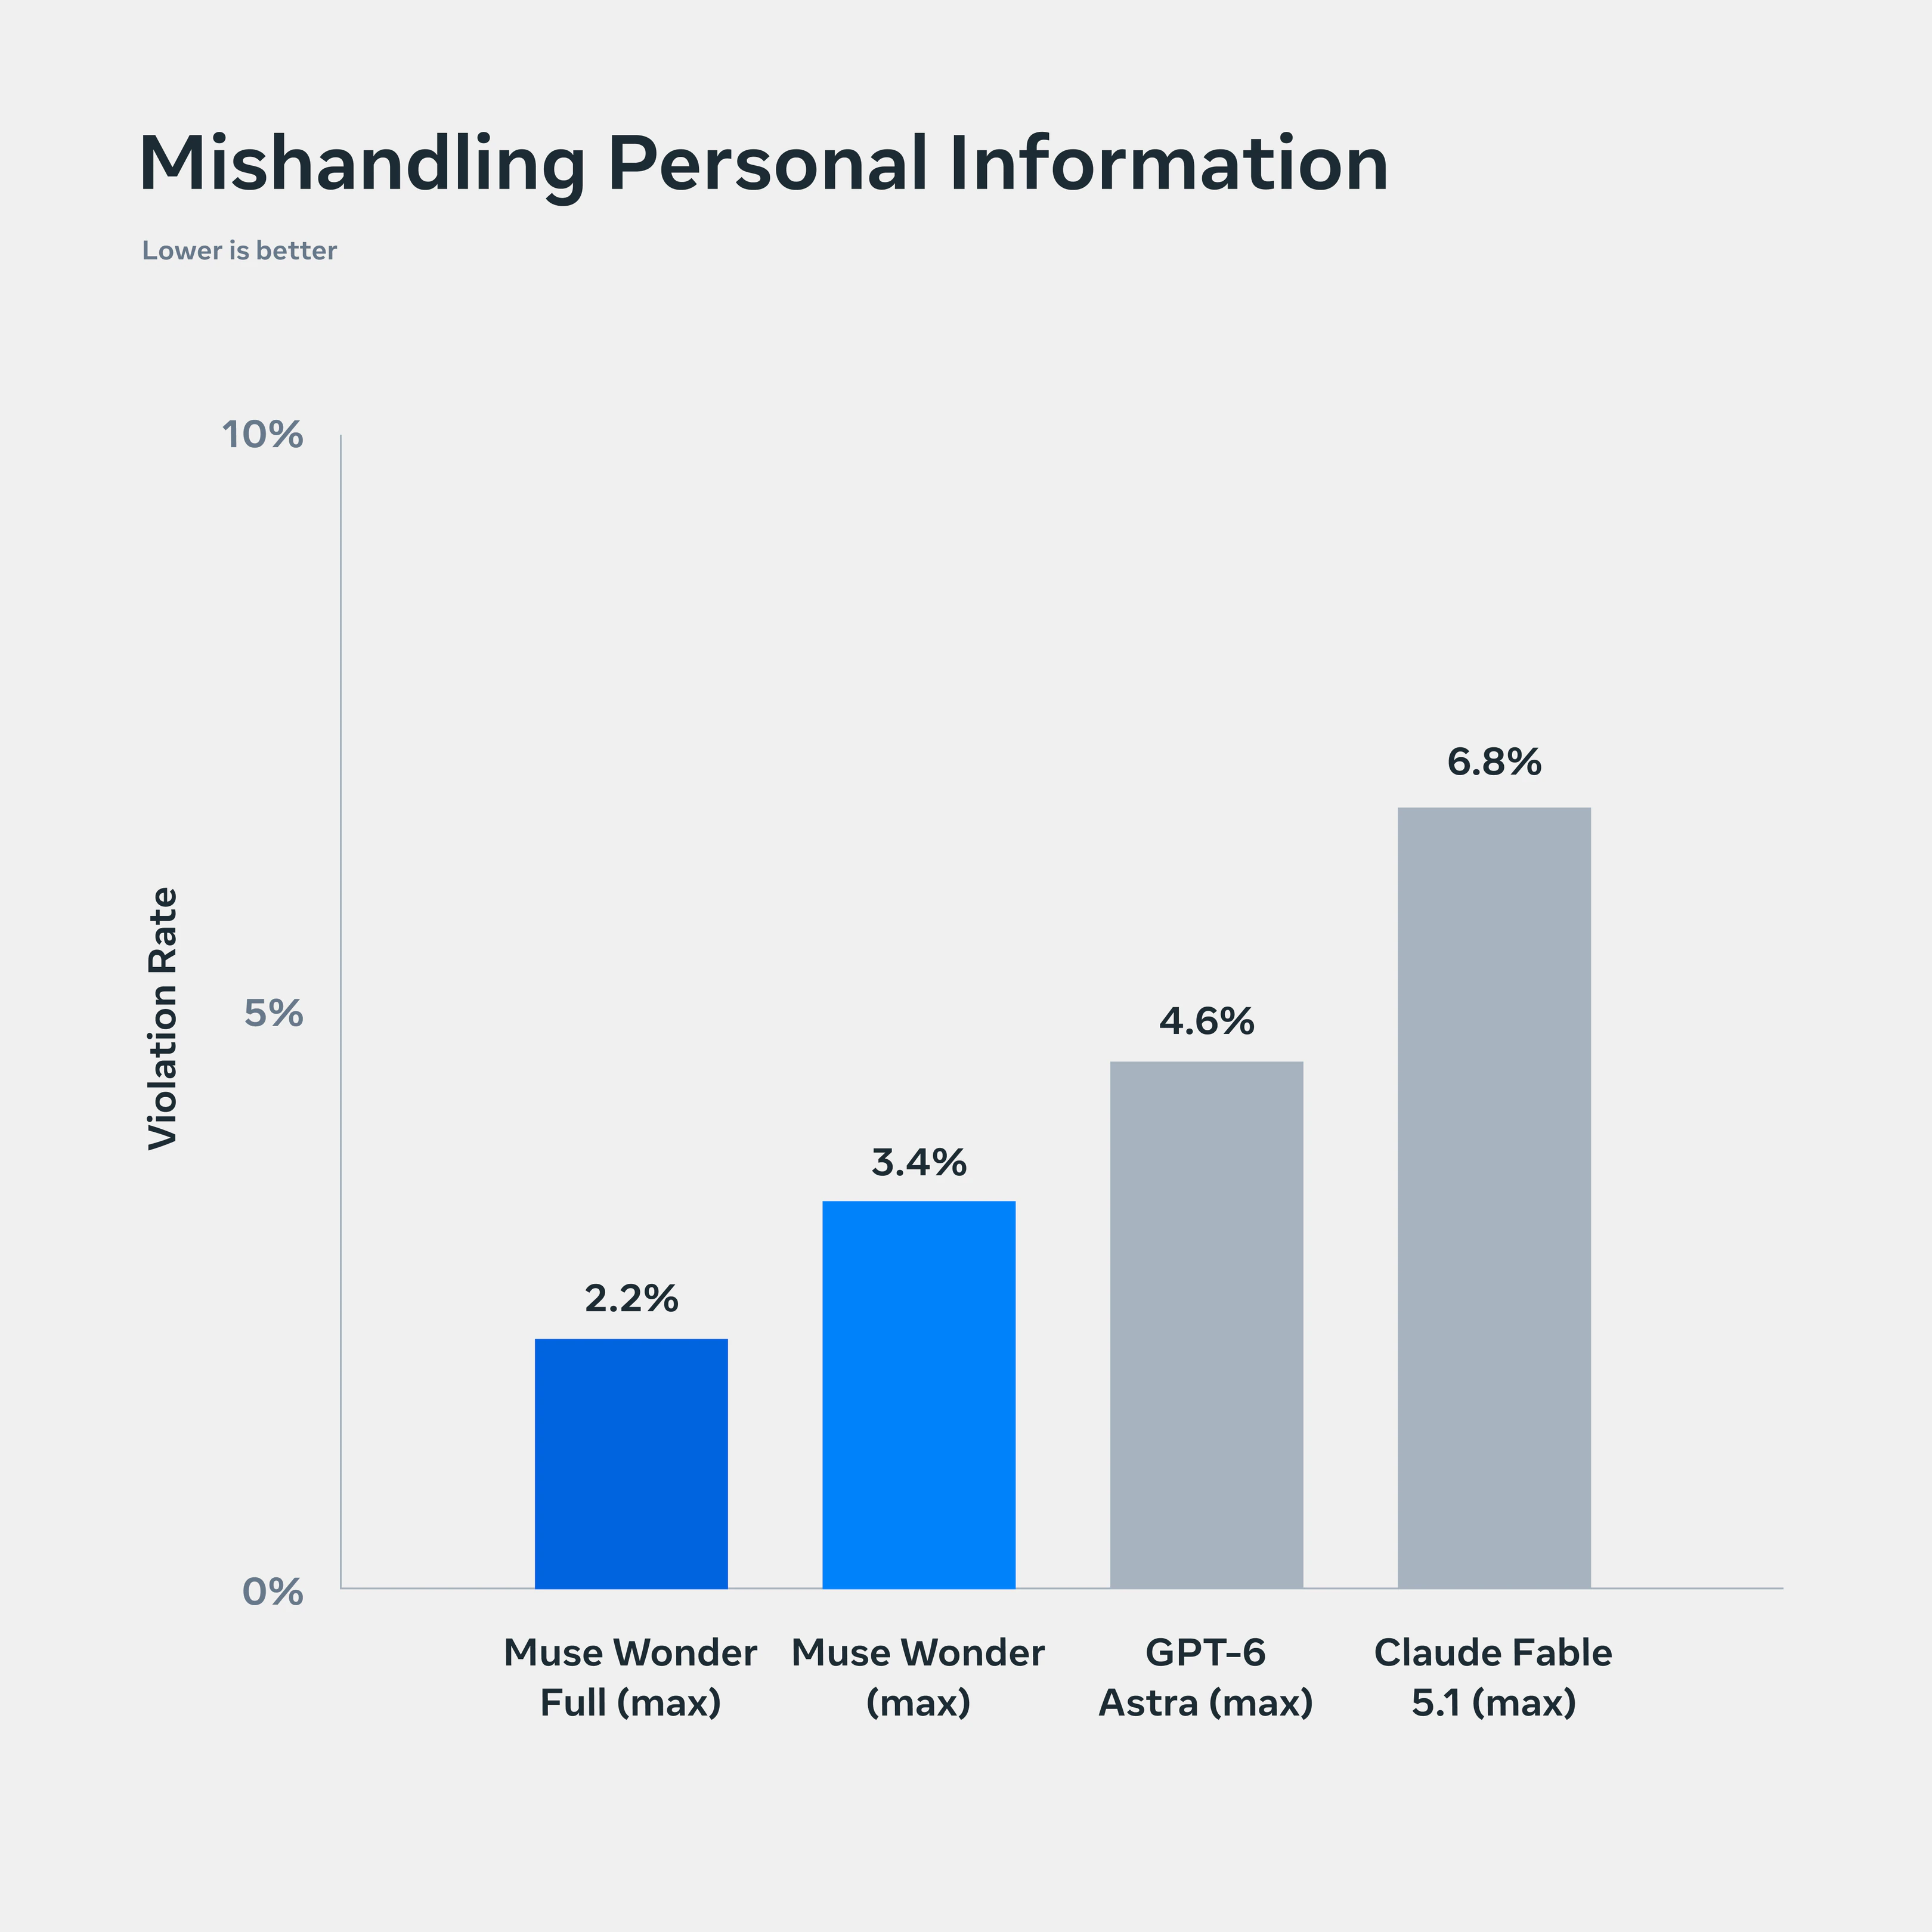
Meta dichiara di aver addestrato la famiglia Muse Wonder a evitare di condividere dati privati senza permesso. Nel secondo test, Muse Wonder Full (max) registra il 2,2% di violazioni, Muse Wonder (max) il 3,4%, GPT-6 Astra (max) il 4,6% e Claude Fable 5.1 (max) il 6,8%: sono risultati dichiarati dal produttore.
Rifiuti, uso improprio e difesa informatica#
Meta dichiara di voler proteggere da usi impropri CBRN e informatici, preservando l'accesso alle capacità cyber per la difesa, come riportato nella pagina ufficiale.
Rifiuti sui rischi biologici#
Nel test bioTIER, dove più alto è meglio, Muse Wonder Full rifiuta il 98,7% delle richieste e Muse Wonder il 98%. Il primo posto è di Claude Fable 5.1 (max) con 99,7%.
bioTIER
Più alto è meglio
Fonte: Meta, valori letti dal grafico ufficiale
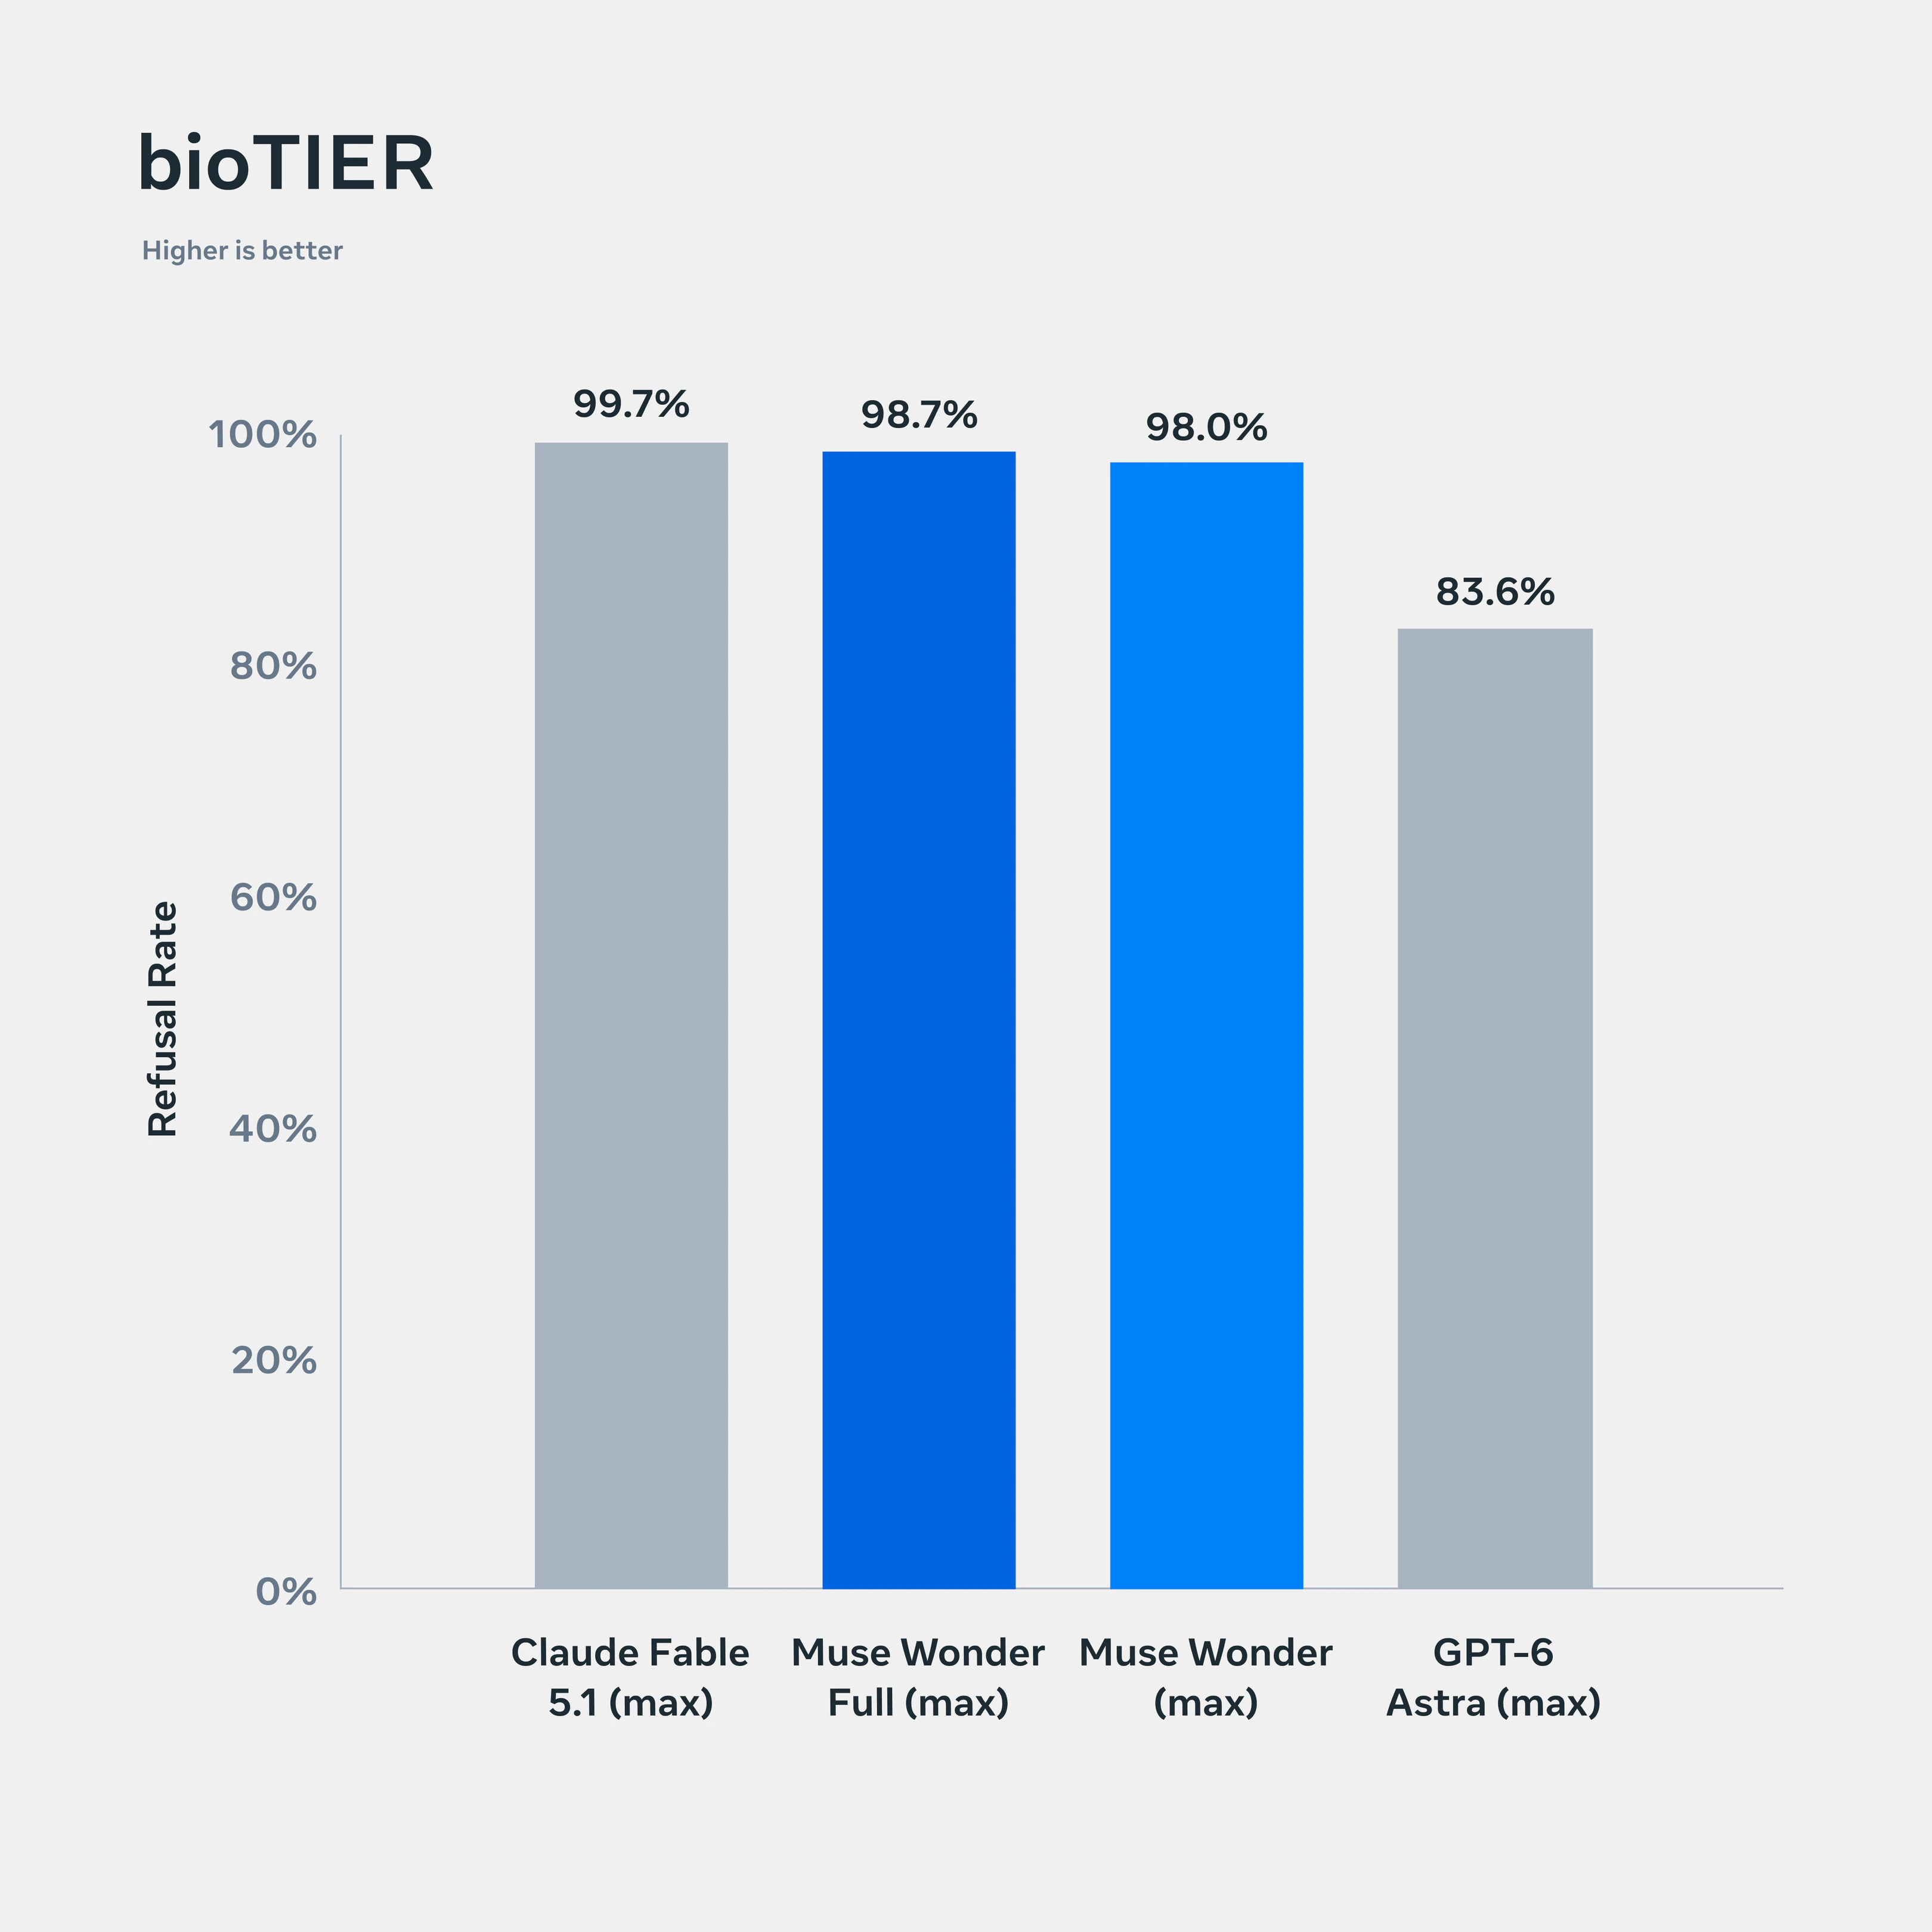
Modello | Tasso di rifiuto (%) |
|---|---|
Claude Fable 5.1 (max) | 99.7 |
Muse Wonder Full (max) | 98.7 |
Muse Wonder (max) | 98 |
GPT-6 Astra (max) | 83.6 |
Valori letti dal grafico ufficiale bioTIER. Fonte: Meta.
Uso improprio informatico#
Nel Cyber Misuse Refusal Benchmark Muse Wonder Full arriva al 96,9% e Muse Wonder al 93,7%, sotto Claude Fable 5.1 (max) (97,5%) e sopra GPT-6 Astra (max) (86,3%).
Cyber Misuse Refusal Benchmark
Più alto è meglio
Fonte: Meta, valori letti dal grafico ufficiale
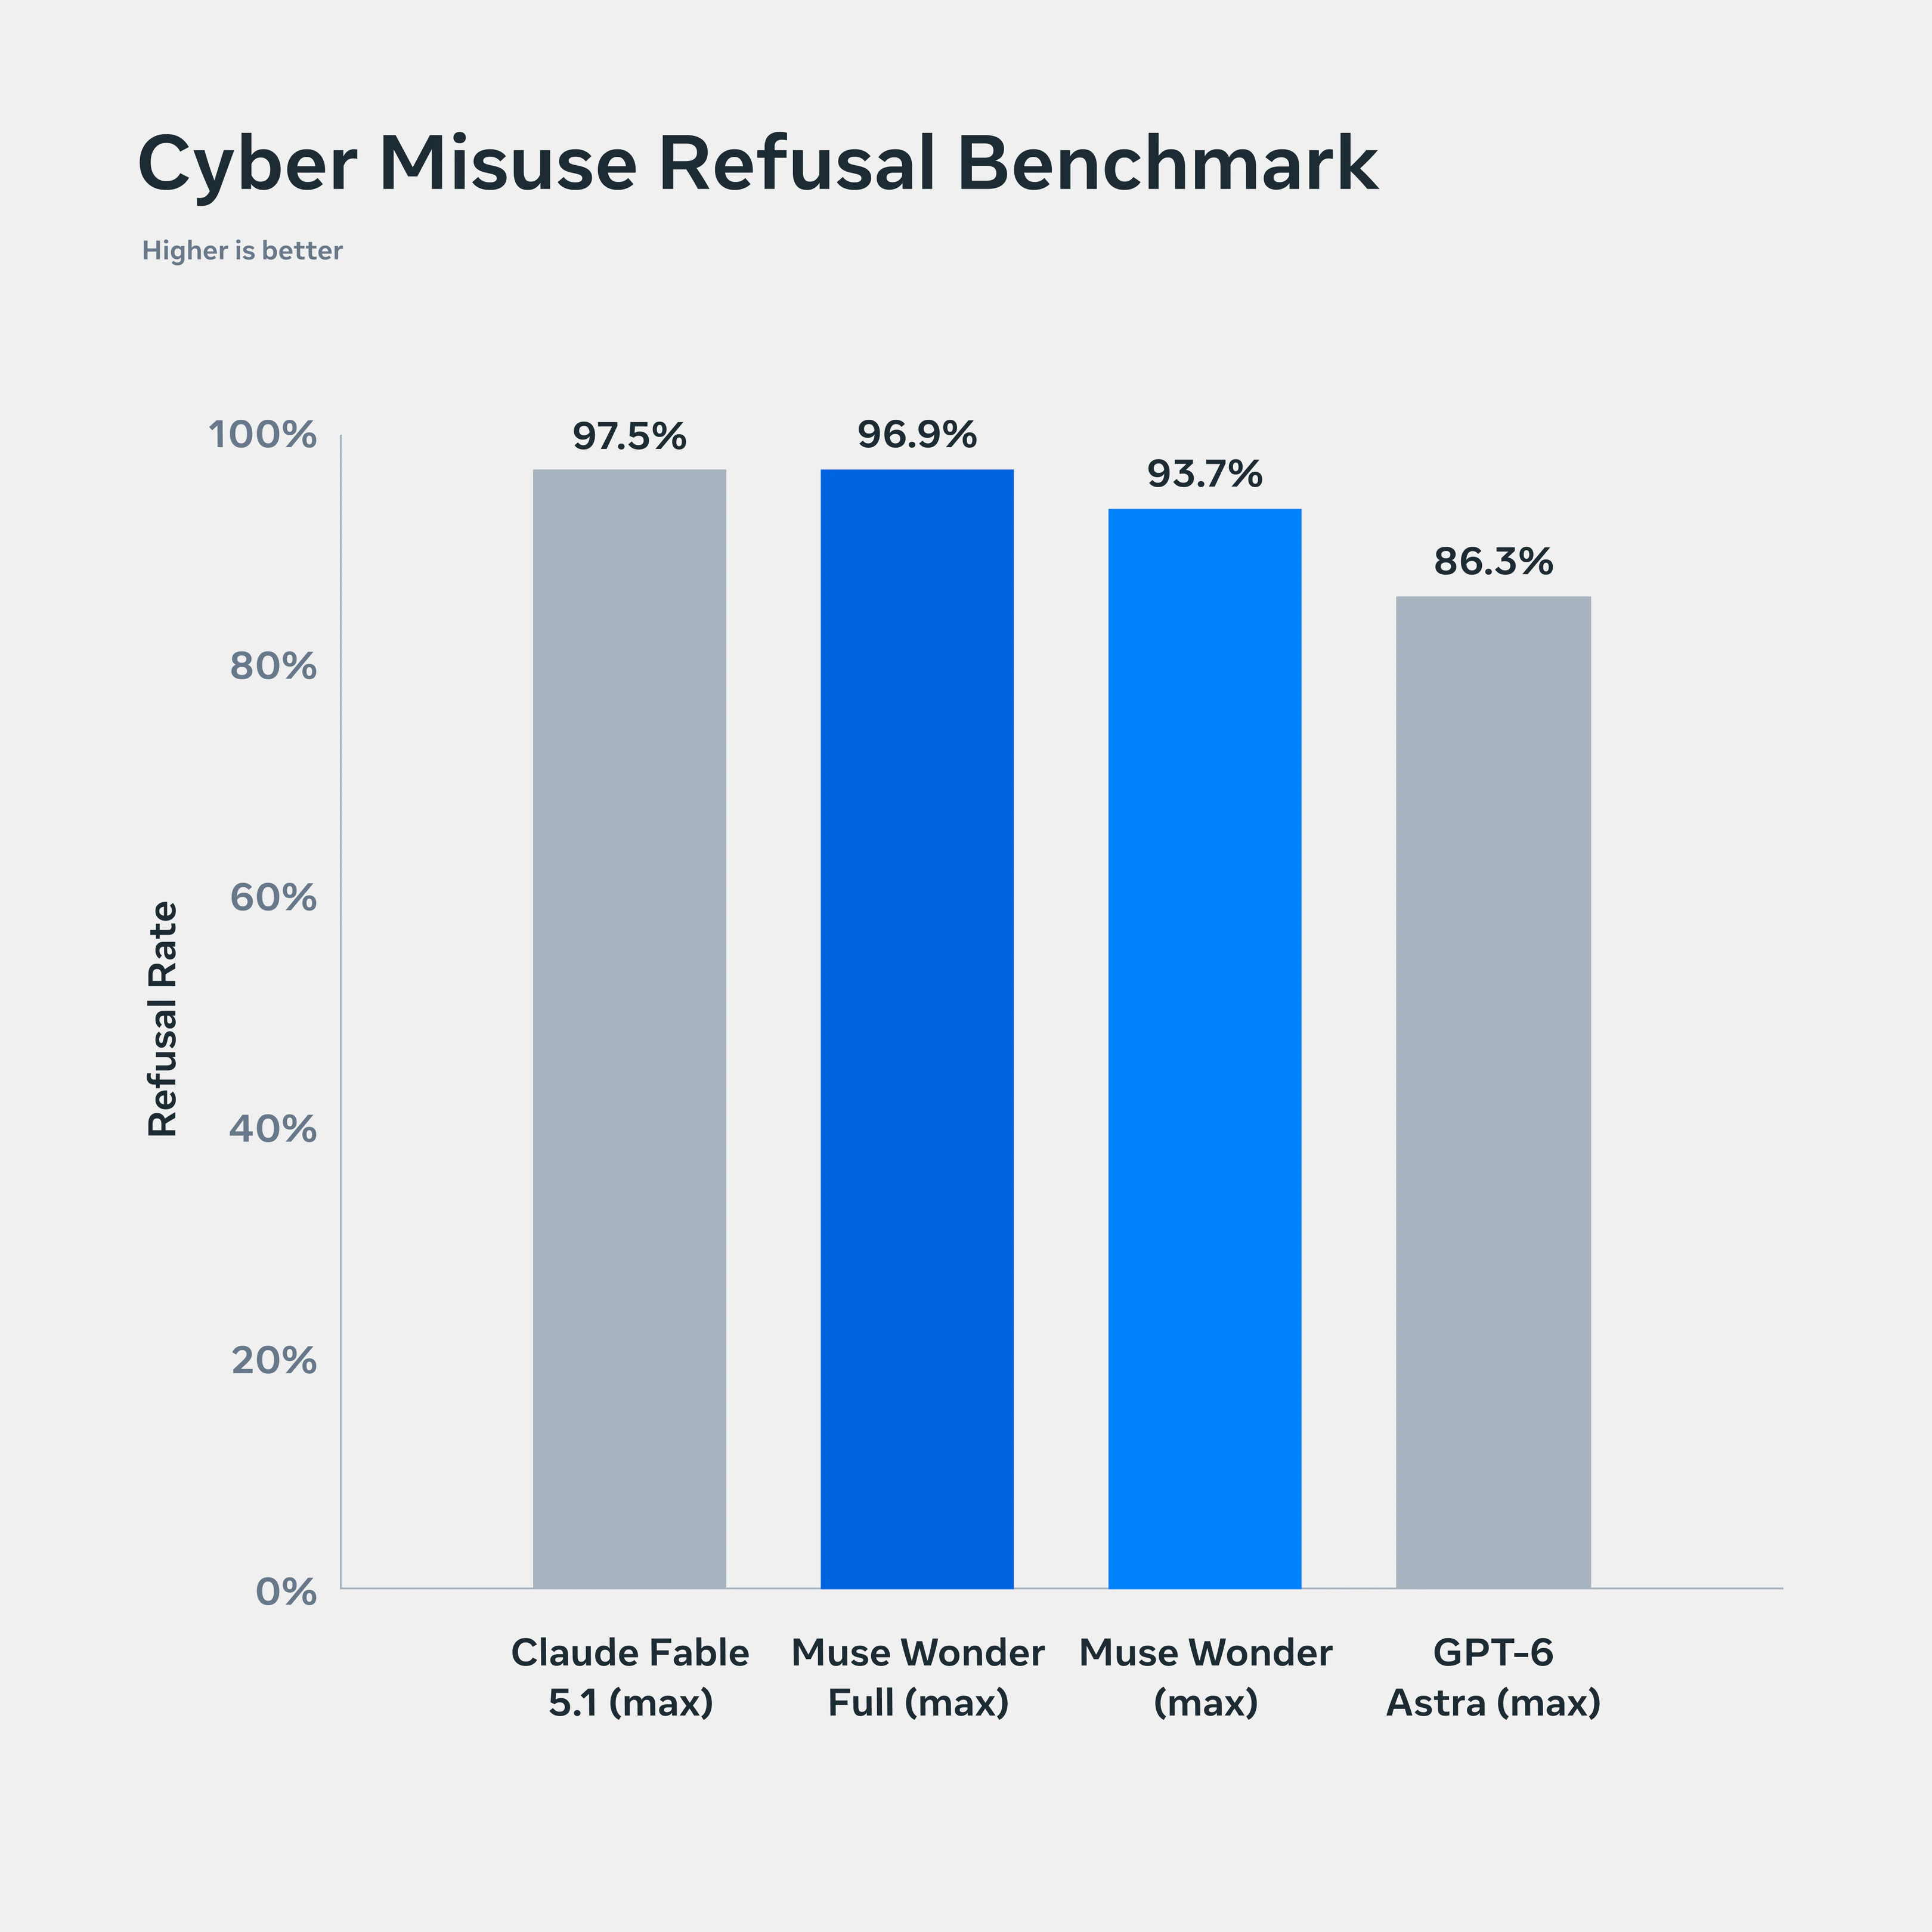
Modello | Tasso di rifiuto (%) |
|---|---|
Claude Fable 5.1 (max) | 97.5 |
Muse Wonder Full (max) | 96.9 |
Muse Wonder (max) | 93.7 |
GPT-6 Astra (max) | 86.3 |
Valori letti dal grafico ufficiale del Cyber Misuse Refusal Benchmark. Fonte: Meta.
Difesa informatica#
Nel Cyber Defense Compliance Benchmark Muse Wonder (max) guida con 94,5%, seguito da Muse Wonder Full (93,3%) e da GPT-6 Astra (max) (81,3%); Claude Fable 5.1 (max) resta al 15,7%.
Cyber Defense Compliance Benchmark
Più alto è meglio
Fonte: Meta, valori letti dal grafico ufficiale
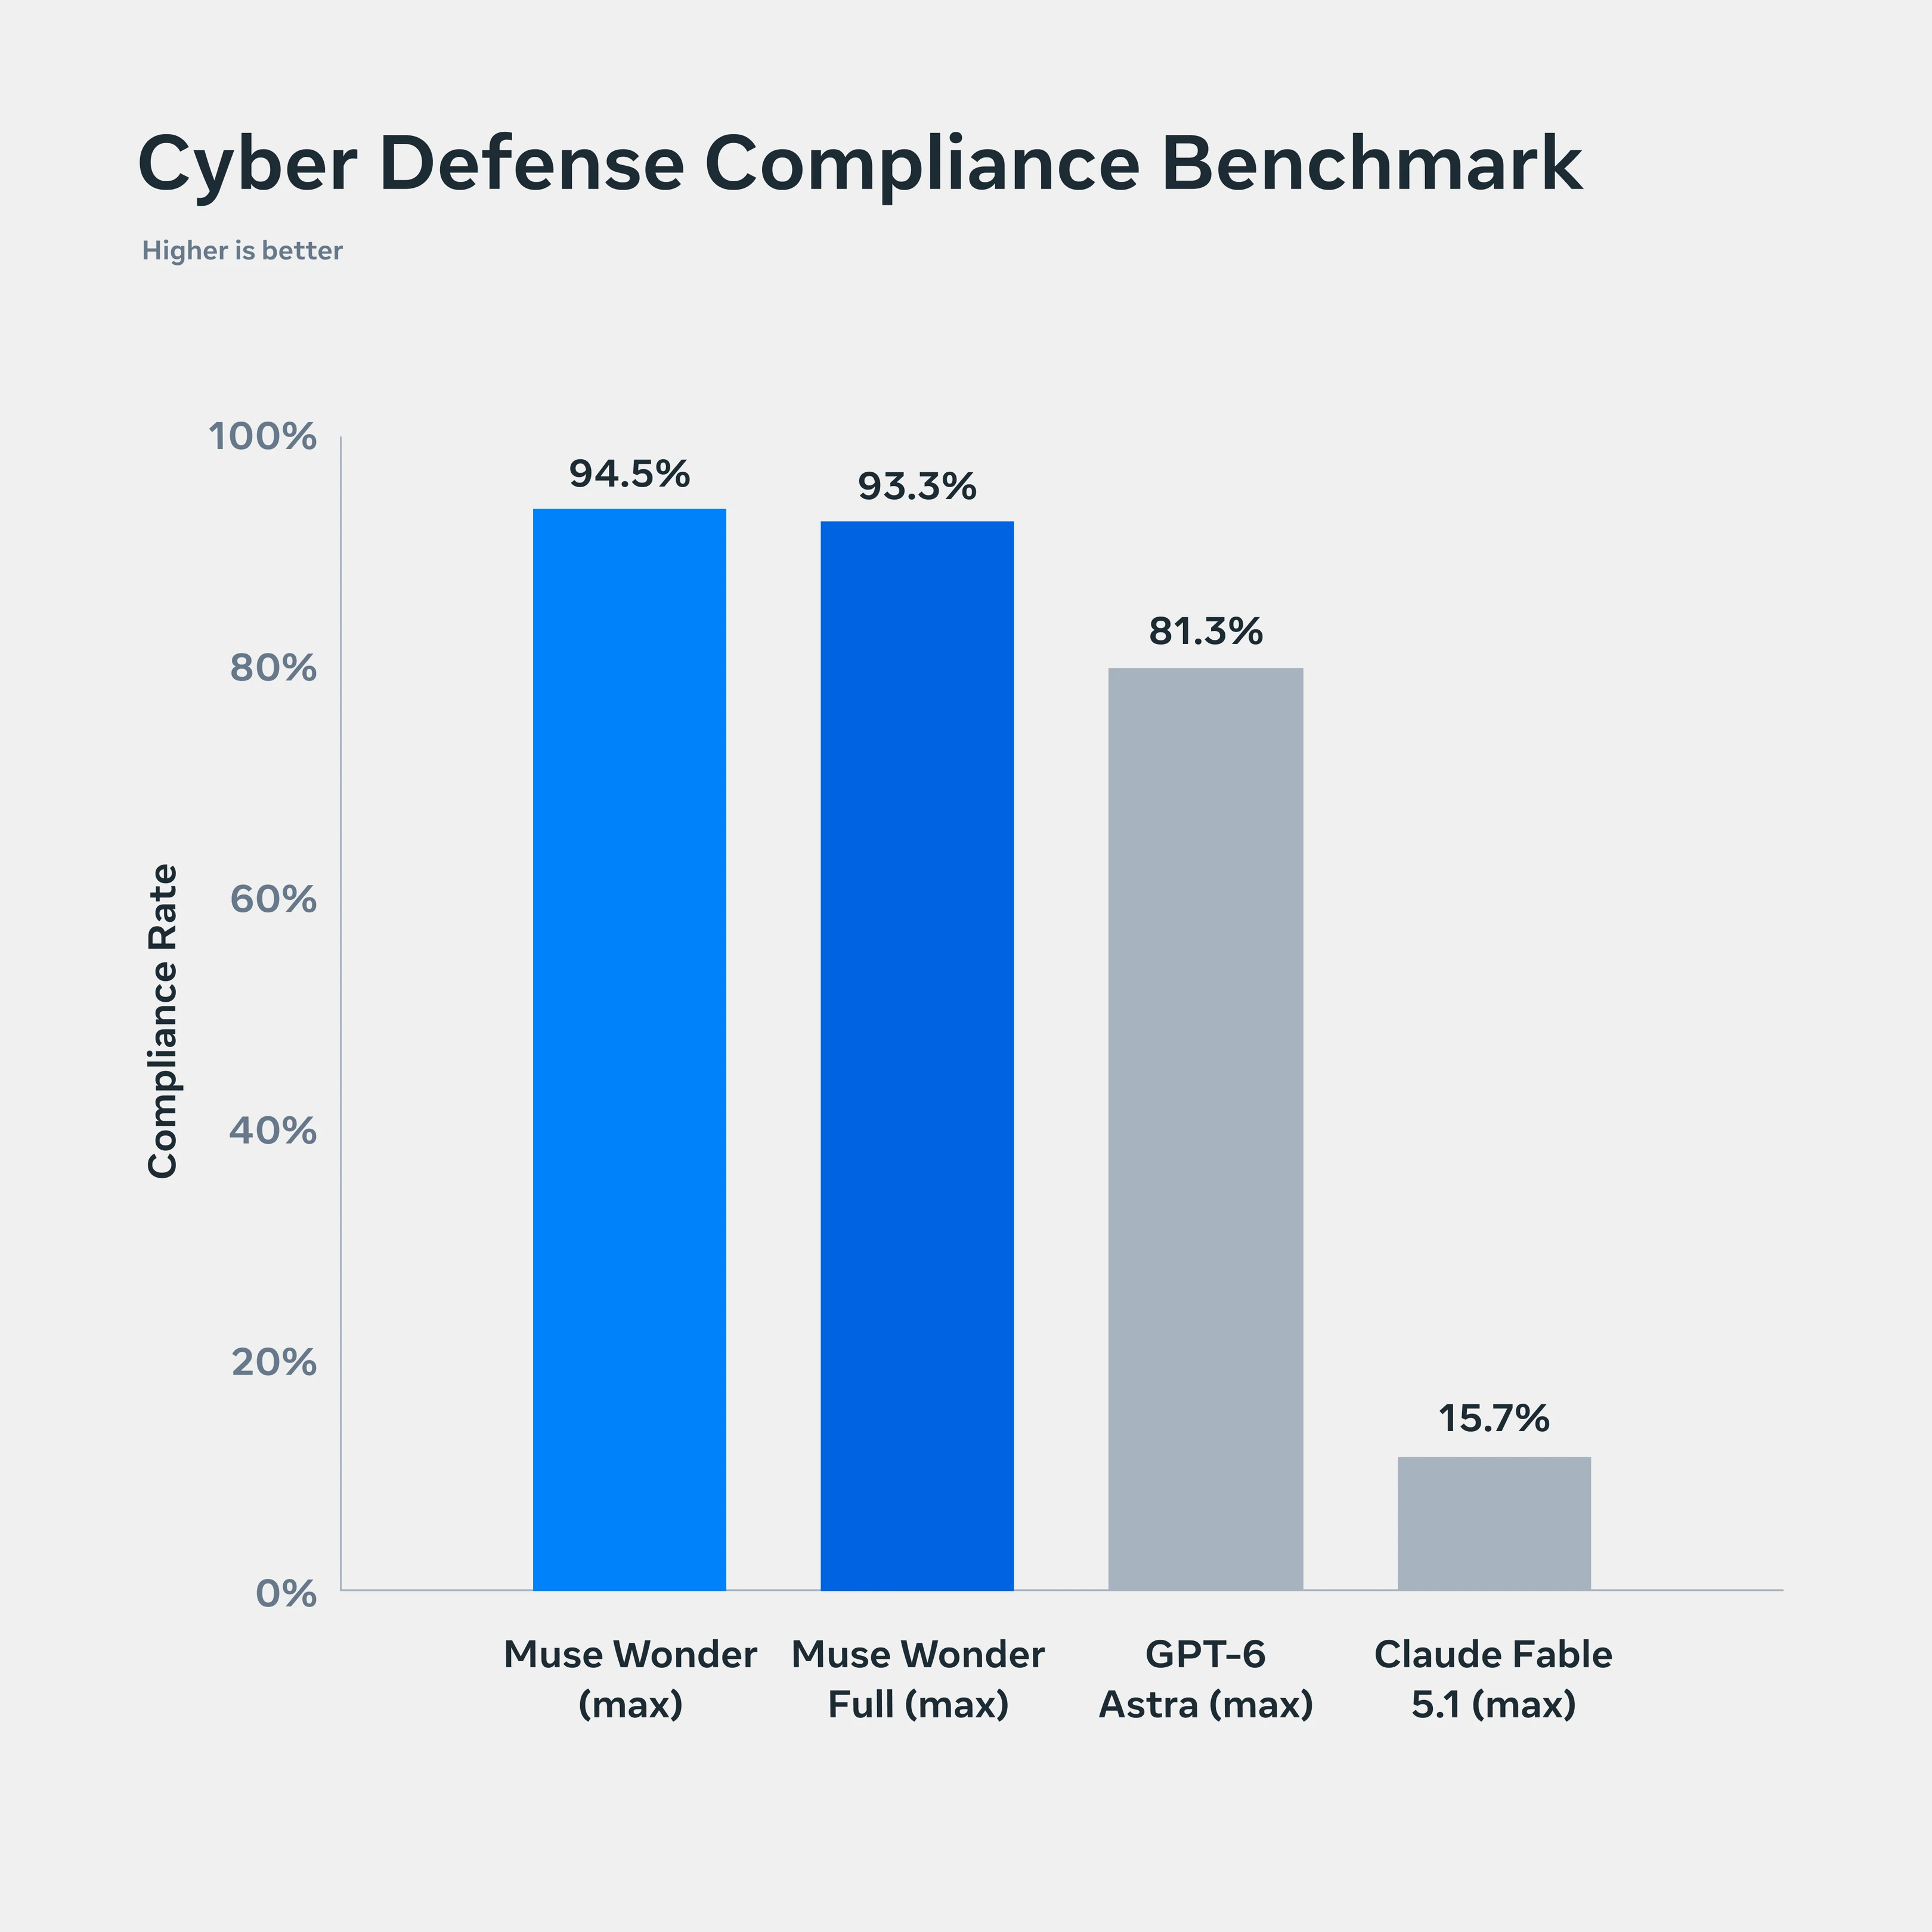
Modello | Tasso di conformità (%) |
|---|---|
Muse Wonder (max) | 94.5 |
Muse Wonder Full (max) | 93.3 |
GPT-6 Astra (max) | 81.3 |
Claude Fable 5.1 (max) | 15.7 |
Valori letti dal grafico ufficiale del Cyber Defense Compliance Benchmark. Fonte: Meta.
Come leggere questi numeri#
Non tutti i numeri pubblicati da Meta arrivano dalla stessa fonte. L'Intelligence Index è riportato con fonte Artificial Analysis, mentre il Personal Superintelligence Index, Memory Bench e gli altri indicatori sono valutazioni interne di Meta, quindi misurate dal produttore stesso. Le etichette (max) e (xhigh) indicano l'impostazione di sforzo di ragionamento usata nel test. La stima relativa a Muse Spark è dichiarata come tale e non è una misura diretta.
I benchmark restano dichiarazioni del produttore: prima di affidarvi una scelta, conviene verificarli con test propri, costruiti su documenti e compiti del vostro lavoro.
Glossario#
Benchmark: test standard per confrontare modelli diversi sugli stessi compiti.
Post-training: fase di rifinitura successiva all'addestramento di base, su compiti mirati.
In-distribution / out-of-distribution: compiti simili a quelli della rifinitura, contro compiti non previsti.
Sforzo di ragionamento: quanto il modello è spinto a elaborare prima di rispondere.
Benchmaxxing: ottimizzazione per i test più popolari, che non garantisce prestazioni altrove.
Active Memory: memoria del contesto tra conversazioni e richiamo dei dettagli utili al compito.
Active Focus: capacità di proseguire un obiettivo difficile provando approcci alternativi.
Cosa significa per un’azienda#
Verificate il canale di accesso: Muse Wonder è disponibile tramite Meta Model API e Muse Code, mentre Muse Wonder Full è riservato agli abbonati Muse Code. Controllate quale piano serve prima di avviare il progetto.
Scegliete uno o due processi reali, come la gestione documentale o i flussi di lavoro interni, e misurate i risultati su quei casi specifici prima di estendere l'uso.
Confrontate i risultati con i benchmark pubblicati da Meta, tenendo presente che si tratta di dichiarazioni del produttore e che non è detto che coincidano con i vostri compiti.
Definite in anticipo quali azioni l'agente può compiere senza conferma. Le fonti indicano che Active Focus chiede chiarimenti e si ferma prima di azioni importanti, ma le soglie operative le stabilite voi.
Chiedete il rapporto di sicurezza completo prima di affidare dati sensibili. Un agente personale può gestire messaggi, calendari e documenti privati, e Meta indica che il rapporto completo sarà disponibile a breve.
Il quadro di sicurezza aggiornato#
Meta ha aggiornato il Meta Superintelligence Scaling Framework, che fissa gli standard per addestrare, valutare e rilasciare i modelli più capaci, recependo gli impegni presi alla Casa Bianca.
Contenimento durante addestramento e valutazione#
Prima di ogni addestramento per rinforzo, Meta verifica se il modello potrebbe compromettere l'ambiente in cui opera. In caso affermativo, sono obbligatorie tre misure:
sandbox approvate e controllate per vulnerabilità;
log sicuri, scritti in tempo reale e non modificabili;
monitor automatici che possono fermare l'addestramento.
Modelli open-weight#
I pesi pubblici sono una risorsa per la ricerca, ma chi li possiede può aggirare i rifiuti del modello. Il Framework valuta quindi il contesto specifico di utilizzo.
Rischi e governance#
Meta svolge threat modeling con esperti esterni e coinvolge enti governativi. Un nuovo comitato AI del consiglio di amministrazione esaminerà le modifiche future e verificherà il rispetto degli standard.
Per leggere il testo, vi servono questi termini:
Sandbox: ambiente isolato in cui il modello lavora senza toccare i sistemi reali.
Fine-tuning: ulteriore addestramento su dati specifici.
Threat modeling: analisi dei modi in cui un sistema potrebbe essere abusato.
Domande frequenti#
Quale modello risulta primo nei benchmark?
Meta dichiara che Muse Wonder e Muse Wonder Full raggiungono lo stato dell'arte su benchmark chiave per agenti personali e professionali, memoria e coding. Sono affermazioni del produttore: le fonti non riportano classifiche indipendenti.
Dove si può usare Muse Wonder?
Muse Wonder è disponibile tramite la Meta Model API e Muse Code. Muse Wonder Full è riservato agli abbonati di Muse Code. Muse Wonder alimenterà presto le esperienze di Muse, con rilascio prima agli abbonati.
Cos'è Active Memory?
È la capacità del modello di portare con sé il contesto importante su di voi tra una conversazione e l'altra, recuperando i dettagli rilevanti per il compito in corso.
Cos'è Active Focus?
Descrive la capacità di proseguire verso un obiettivo difficile, provare approcci alternativi, superare ostacoli e chiedere chiarimenti. Il modello verifica con voi prima di compiere azioni importanti.
Quali dati mancano ancora?
Il rapporto completo con ulteriori valutazioni di sicurezza sarà disponibile prossimamente, secondo Meta. Al momento della pubblicazione non è ancora online.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni su benchmark indipendenti | 7/10 | Nell'Artificial Analysis Intelligence Index Muse Wonder Full ottiene 56 punti, secondo dopo Claude Opus 5.5 con 58, mentre Muse Wonder si ferma a 52. |
Benchmark dichiarati dal produttore | 5/10 | Il Personal Superintelligence Index è un indice interno di Meta, dove Muse Wonder Full raggiunge il 59,1%, valore che non risulta verificato da terzi nelle fonti. |
Dominio specialistico (legge, finanza,… | 5/10 | Su Harvey LAB-AA Muse Wonder Full ottiene 13,1%, mentre su HealthBench Pro ottiene 62,3%, sotto Claude Opus 5.5 con 65,6% e GPT-6 Astra con 65,3%. |
Prezzo e disponibilità | 4/10 | Muse Wonder è disponibile tramite Meta Model API e Muse Code, mentre Muse Wonder Full è riservato agli abbonati di Muse Code; le fonti non indicano prezzi. |
Trasparenza e documentazione | 3/10 | Le fonti rinviano a un report completo sulla sicurezza e a ulteriori valutazioni «disponibili a breve», senza indicare licenza o pesi aperti. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Muse Wonder e Muse Wonder Full sono modelli per agenti di Meta con buoni risultati su benchmark agentici, ma con prezzi non indicati e accesso limitato per la versione Full.
Per chi deve decidere, i dati ufficiali mostrano prestazioni competitive ma non dominanti: nell'indice indipendente Artificial Analysis il modello è secondo dopo Claude Opus 5.5. Molti dei risultati migliori provengono da indici interni di Meta, quindi conviene verificarli con test propri. Mancano prezzi, licenza e il report completo sulla sicurezza, elementi necessari per una valutazione d'acquisto o d'integrazione in azienda.
Punti di forza
- Muse Wonder Full è secondo nell'Artificial Analysis Intelligence Index con 56 punti, dopo Claude Opus 5.5 con 58.
- Nel benchmark AutomationBench-AA Muse Wonder Full ottiene 45,4%, il valore più alto tra i modelli elencati nella tabella di riferimento.
- Su MemoryBench Muse Wonder ottiene 85,6% e Muse Wonder Full 85,5%, sopra Claude Opus 5.5 con 81,5%.
Limiti
- I risultati più favorevoli provengono in gran parte da valutazioni interne di Meta, come il Personal Superintelligence Index.
- Su HealthBench Pro Muse Wonder Full (62,3%) è sotto Claude Opus 5.5 (65,6%) e GPT-6 Astra (65,3%).
- Muse Wonder Full è accessibile solo agli abbonati di Muse Code.
- Le fonti non indicano prezzi per l'uso tramite API o abbonamento.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
3- 1.Meta — Muse Wonder: A Frontier Model For Personal & Professional AI Agentsresearch.meta.ai
Annuncio ufficiale da cui nasce l’articolo.
- 2.Meta — Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agentsabout.fb.com
Documento ufficiale collegato all’annuncio.
- 3.Meta — Developing Capable Models Responsiblyresearch.meta.ai
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.