Come l'infrastruttura NVIDIA Blackwell Ultra sostiene la modalità Ultrafast di OpenAI nell'API
NVIDIA dichiara fino a 50x di throughput per megawatt e 35x di costo per token in meno rispetto a Hopper, con dati SemiAnalysis InferenceX. OpenAI usa Blackwell per Ultrafast, fino a 8x più veloce dello Standard.
di Andrea Pirazzini
Fonte primaria
NVIDIA — New SemiAnalysis InferenceX Data Shows NVIDIA Blackwell Ultra Delivers up to 50x Better Performance and 35x Lower Costs for Agentic AI
blogs.nvidia.com
Carlo
Il Narratore · 2 min 15 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: NVIDIA — New SemiAnalysis InferenceX Data Shows NVIDIA Blackwell Ultra Delivers up to 50x Better Performance and 35x Lower Costs for Agentic AI.
Perché se ne parla#
NVIDIA annuncia che il sistema GB300 NVL72, basato sulla GPU Blackwell Ultra, offre fino a 50x di throughput per megawatt rispetto alla piattaforma Hopper, con un costo per token fino a 35x inferiore. Il dato deriva da analisi di SemiAnalysis InferenceX citate dall'azienda. Nello stesso periodo OpenAI presenta GPT-6 Astra Ultrafast, eseguito su GPU Blackwell: entrambi gli annunci riguardano la velocità e il costo dell'inferenza, cioè l'esecuzione dei modelli.
Il tema conta per chi usa l'AI al lavoro perché agenti e assistenti di coding richiedono bassa latenza, per restare reattivi tra un passaggio e l'altro, e contesti lunghi, per ragionare su interi progetti software. Secondo il report State of Inference di OpenRouter, citato da NVIDIA, le richieste legate alla programmazione sono passate dall'11% a circa il 50% nell'ultimo anno. Con questi volumi, il costo per token incide direttamente sul budget.
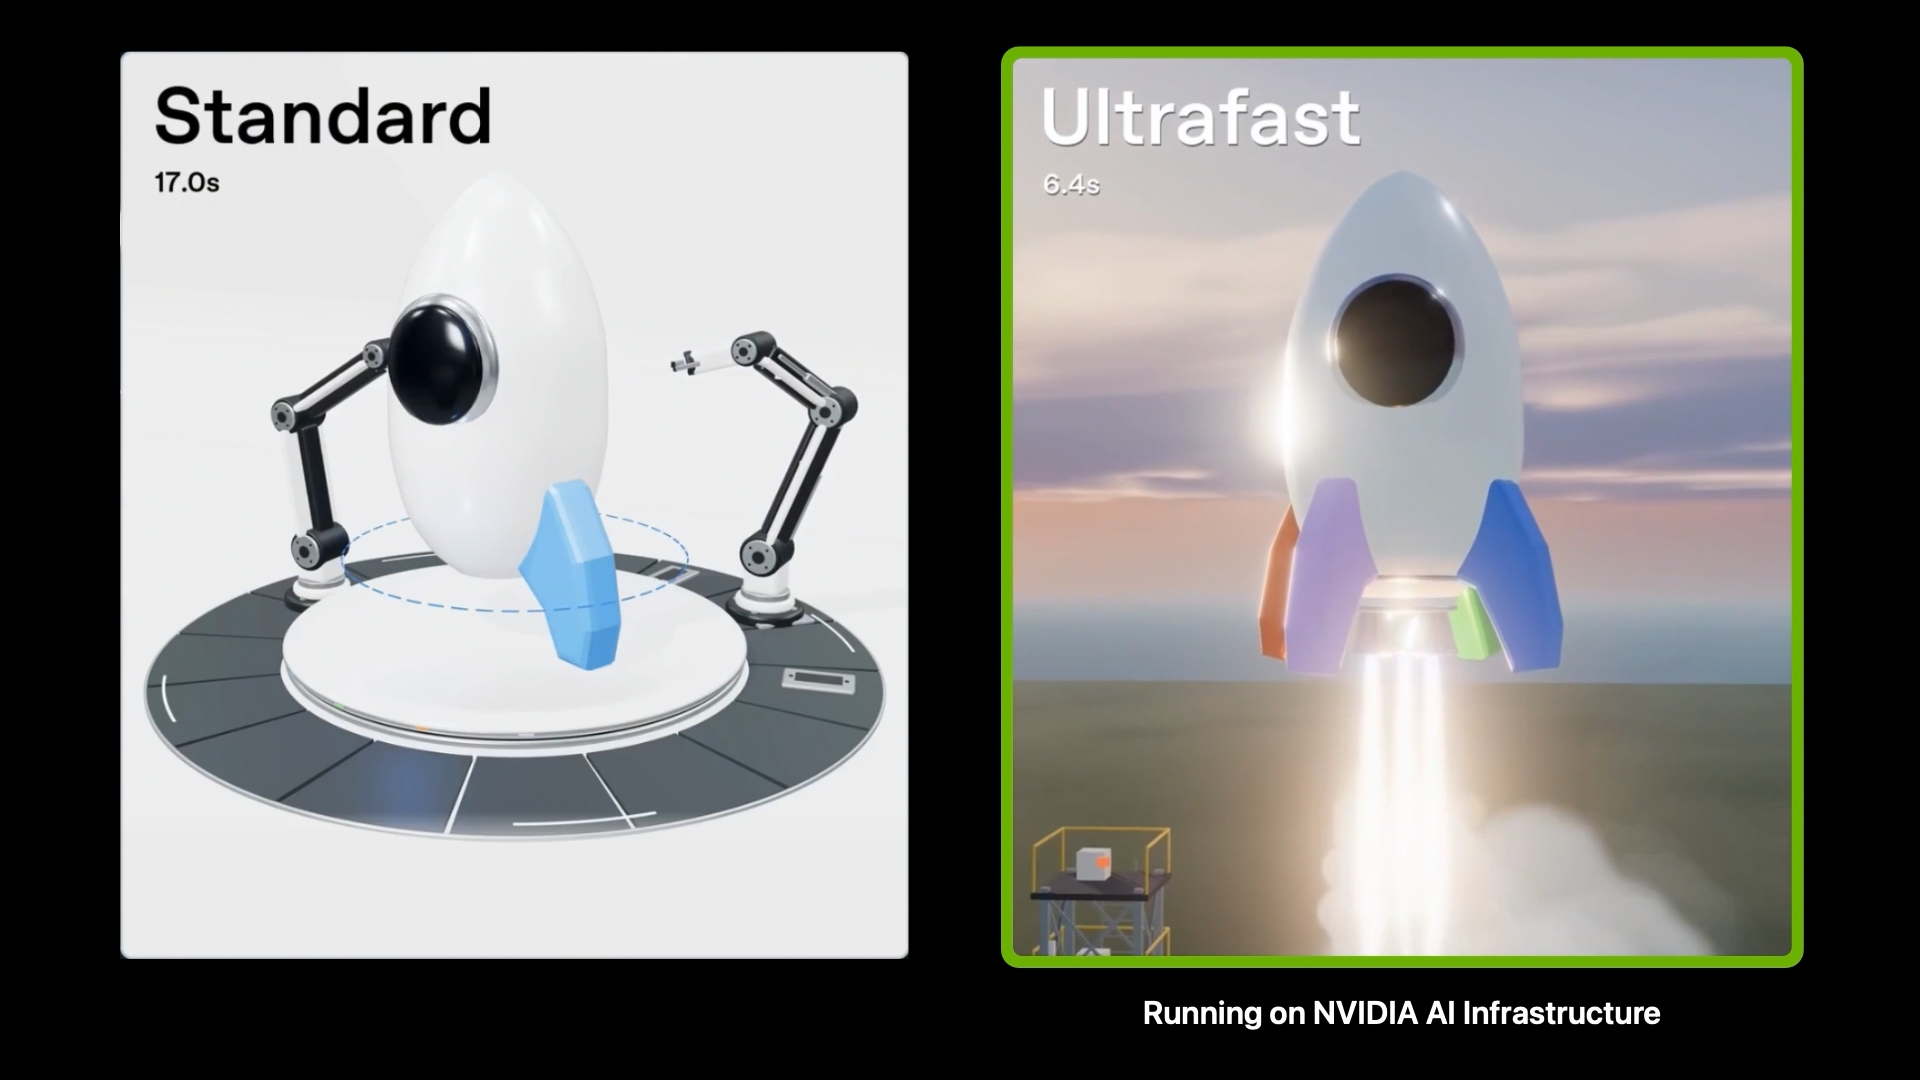
OpenAI dichiara che Astra Ultrafast genera token fino a 8x più velocemente rispetto alla modalità Astra Standard. Il modello è disponibile nell'API OpenAI e per gli utenti idonei di ChatGPT Work e Codex. Si tratta di dichiarazioni dei produttori, presentate come tali. Per i dettagli sul modello, leggete l'approfondimento su GPT-6 Astra.
GB300 NVL72: fino a 50x con carichi a bassa latenza#
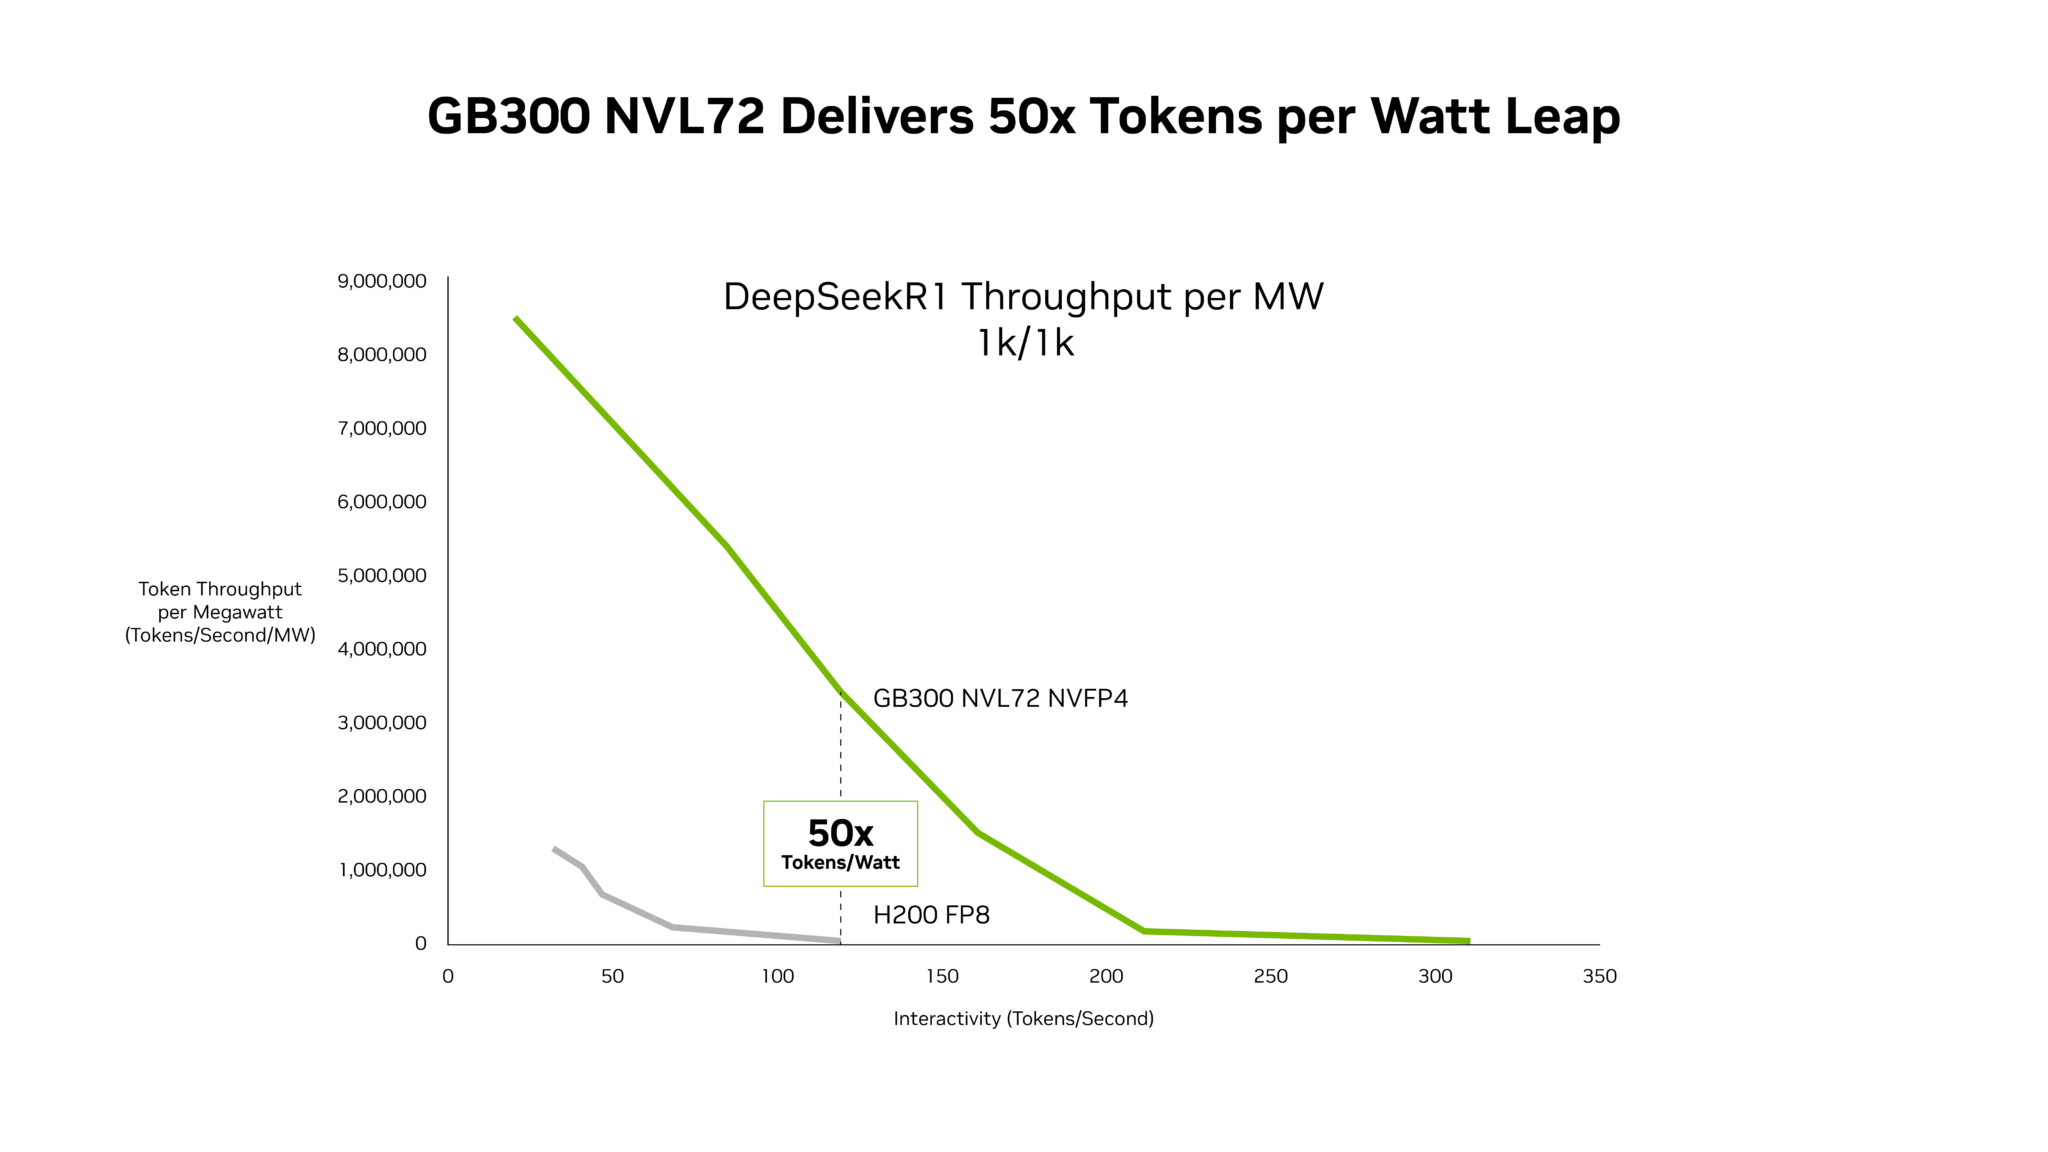
Secondo NVIDIA, GB300 NVL72 raggiunge fino a 50x di throughput per megawatt e 35x di costo per token in meno rispetto alla piattaforma Hopper, con i dati di dati InferenceX come riferimento. I valori più alti riguardano i carichi a bassa latenza tipici degli agenti, dove ogni millisecondo pesa nei flussi multi-step.
throughput per MW rispetto a Hopper, dichiarato da NVIDIA
costo per token in meno rispetto a Hopper, dichiarato da NVIDIA
token per watt di GB200 NVL72 secondo Signal65
NVIDIA cita anche Signal65, che per GB200 NVL72 indica oltre 10x di token per watt. Nella scheda tecnica di GB300 NVL72, l'azienda dichiara 10x di TPS per utente e 5x di TPS per MW rispetto a Hopper, in un test su DeepSeek-R1. Sono prestazioni previste e soggette a modifica.
Costo per token: fino a 35x in meno#
Il confronto nel grafico NVIDIA#
Il grafico mostra il costo per milione di token di DeepSeekR1 (1k/1k) in funzione dell'interattività, misurata in token al secondo per utente. Confronta la curva H200 FP8 con quella di GB300 NVL72 in formato NVFP4.
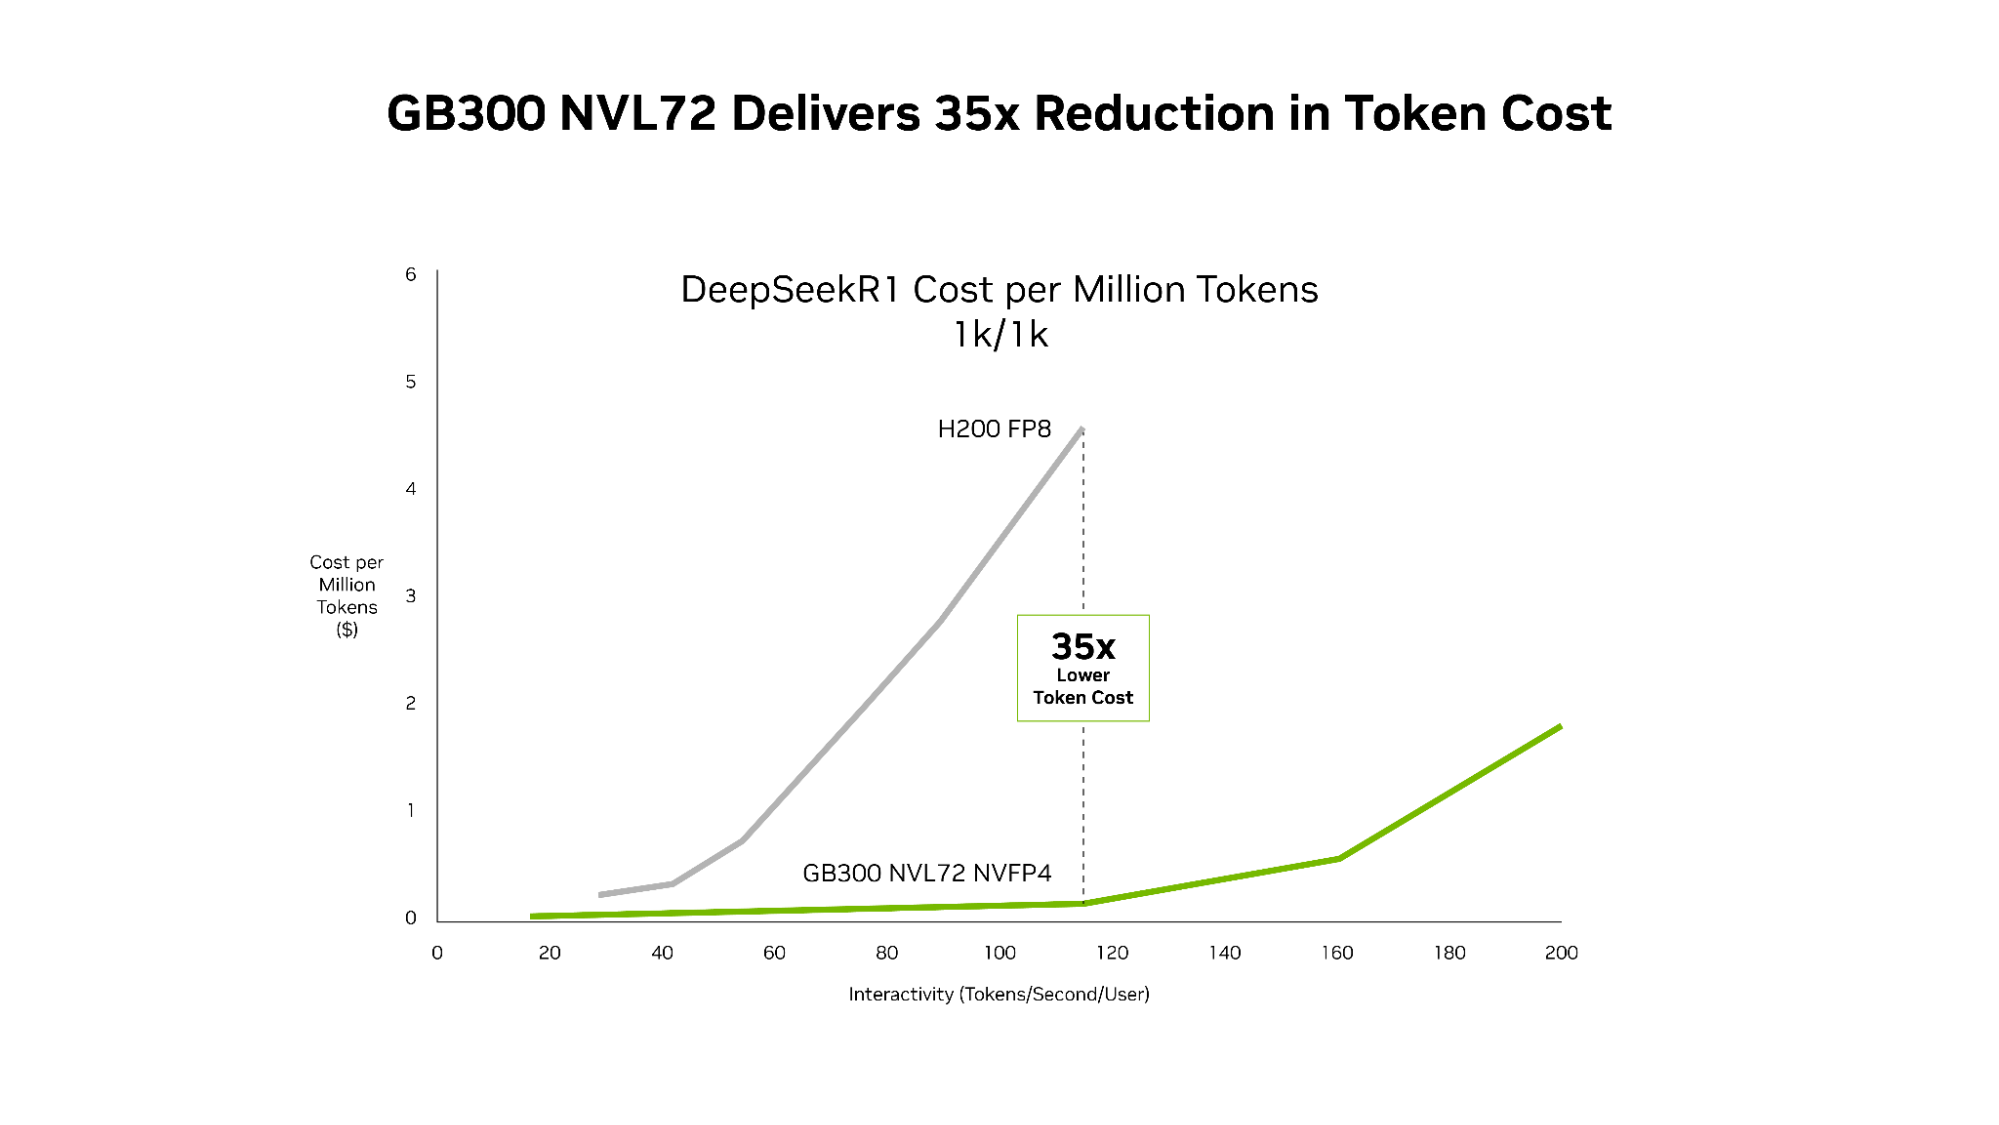
Secondo NVIDIA, GB300 NVL72 con lo stack software Dynamo e TensorRT-LLM offre 35x di costo per token in meno rispetto a Hopper. Si tratta di una dichiarazione del produttore, basata sul grafico ufficiale, che non riporta i valori intermedi delle curve.
Contesto lungo e infrastruttura per agenti#
Contesto lungo: il vantaggio di GB300 NVL72#
Con DeepSeek-R1, 128.000 token di input e 8.000 di output, NVIDIA dichiara che GB300 NVL72 offre fino a 1,5x di costo per token inferiore rispetto a GB200 NVL72. Il divario emerge soprattutto nei carichi a contesto lungo, come gli assistenti di coding che ragionano su interi repository (fonte).
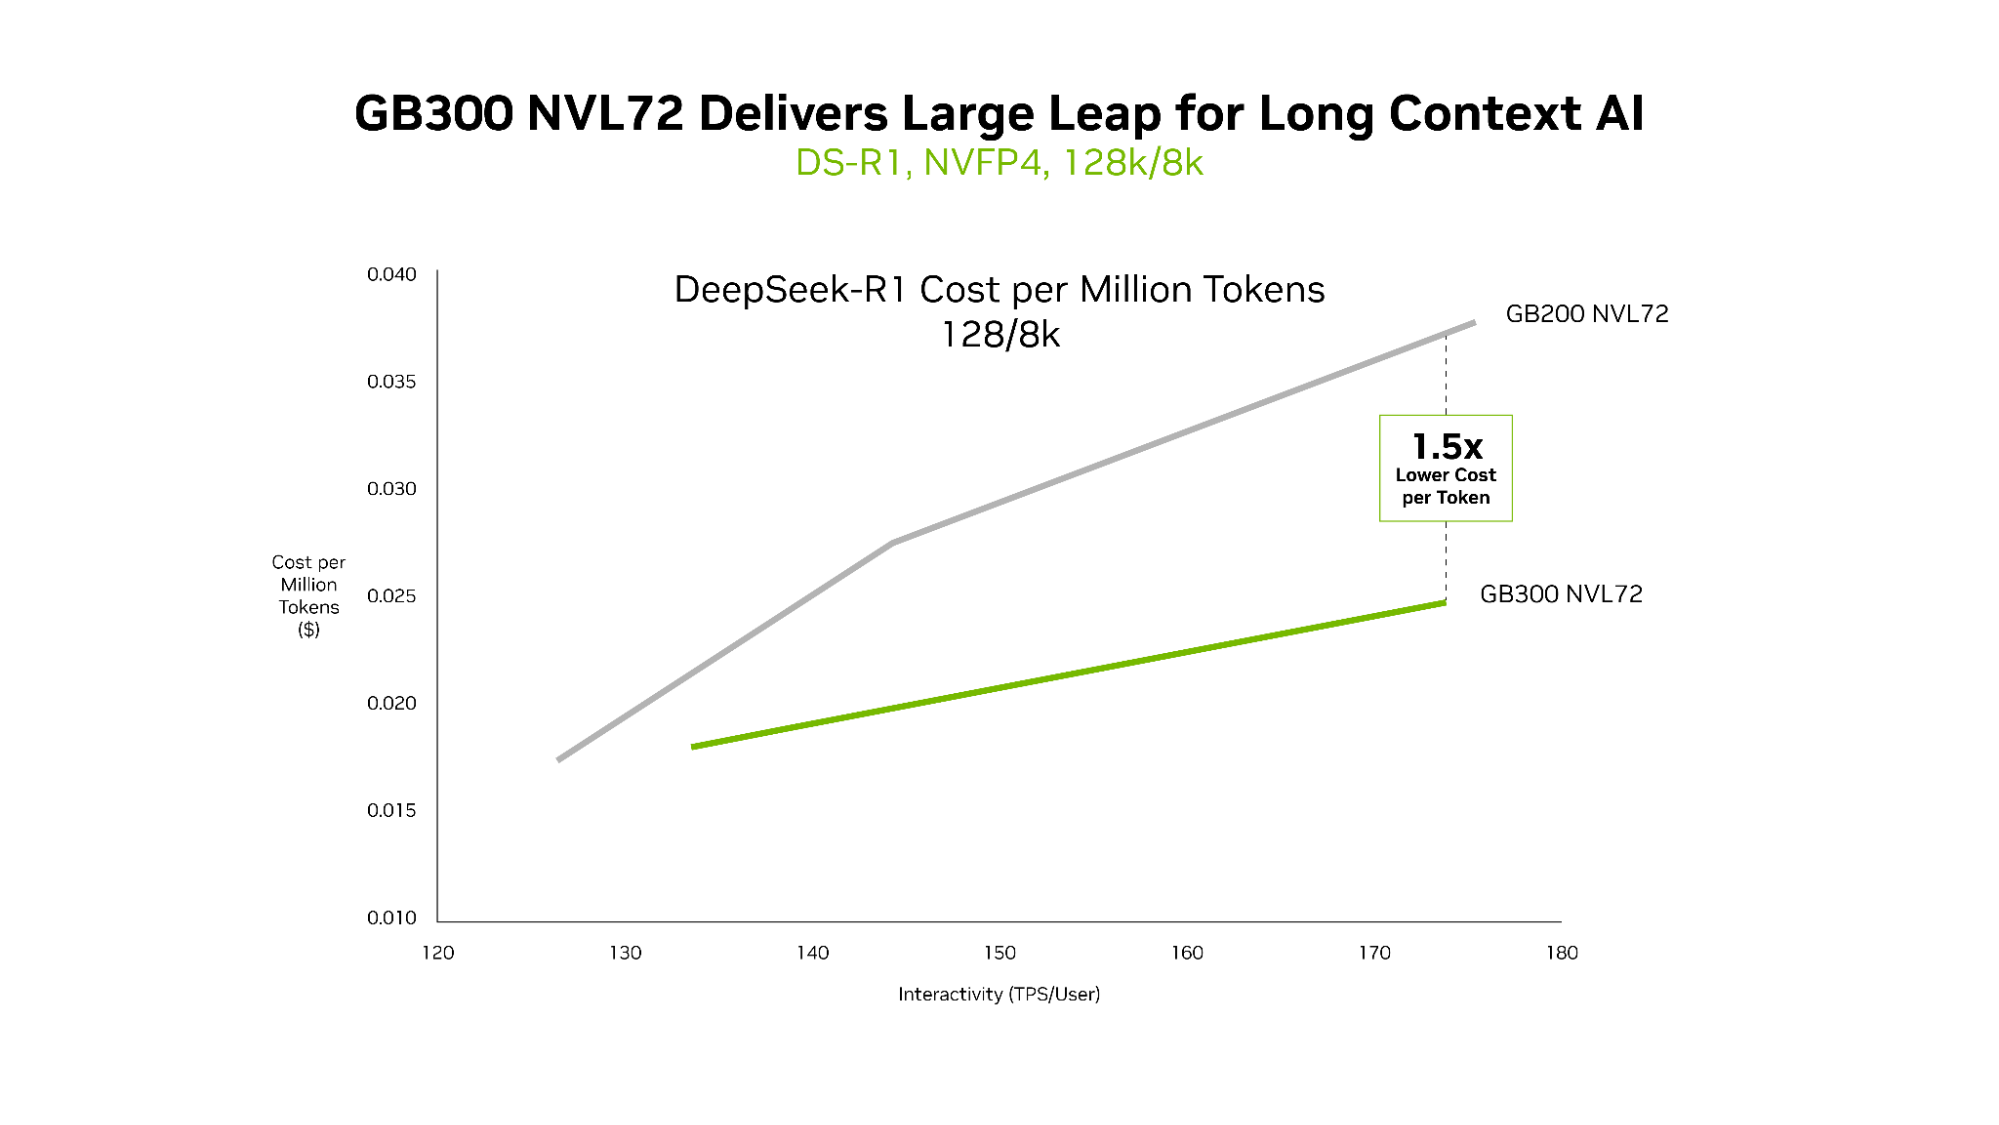
Secondo la spiegazione di NVIDIA, il motivo sta in 1,5x di prestazioni di calcolo NVFP4 e in 2x di velocità nell'elaborazione dell'attenzione. Man mano che l'agente legge più codice, il contesto cresce e richiede molto più calcolo: questi due fattori servono proprio a gestirlo.
Chi lo usa per l'agentic coding#
Microsoft, CoreWeave e OCI stanno distribuendo GB300 NVL72 per casi a bassa latenza e contesto lungo, come l'agentic coding e gli assistenti di programmazione. Chen Goldberg, senior vice president of engineering di CoreWeave, sostiene che, con l'inferenza al centro della produzione AI, contano sempre di più le prestazioni su contesto lungo e l'efficienza dei token, e che il cloud di CoreWeave punta a trasformare i guadagni di GB300 in prestazioni e costi prevedibili.
Uno sguardo a Vera Rubin NVL72#
NVIDIA dichiara che la piattaforma Vera Rubin NVL72 offre fino a 10x di throughput per megawatt rispetto a Blackwell nell'inferenza MoE, con un costo per milione di token pari a un decimo. Si tratta di un dato del produttore, non verificato in modo indipendente in questa sezione.
I numeri di testa#
Throughput per MW rispetto a Hopper
Dichiarato da NVIDIA, dati SemiAnalysis InferenceX
Costo per token in meno rispetto a Hopper
Dichiarato da NVIDIA, dati SemiAnalysis InferenceX
Generazione Ultrafast rispetto a Standard
Dichiarato da OpenAI
GPU per dominio NVLink (NVL72)
Specifica tecnica della scheda GB300 NVL72
I primi due valori sono confronti che NVIDIA attribuisce ai dati SemiAnalysis InferenceX e riguardano la piattaforma Hopper: sono risultati dichiarati dal produttore, non misure indipendenti sui vostri carichi di lavoro. L'8x sulla velocità di generazione è invece una dichiarazione di OpenAI e misura Ultrafast rispetto alla modalità Standard. Il dato sulle 72 GPU per dominio NVLink è una specifica tecnica della scheda della GB300 NVL72, verificabile nel datasheet, e non un risultato di prestazione. Tenere separate queste fonti aiuta a capire cosa misura ciascun numero.
GPT-6 Astra Ultrafast su Blackwell#
Cosa cambia con Ultrafast#
Secondo OpenAI, GPT-6 Astra Ultrafast gira su GPU NVIDIA Blackwell ed è disponibile nell'API e per gli utenti idonei di ChatGPT Work e Codex. Rispetto alla modalità Astra Standard, la generazione dei token è fino a 8x più veloce.
Per chi sviluppa, la velocità conta soprattutto nei cicli ripetuti: l'agente scrive codice, usa uno strumento, verifica il risultato e sceglie il passo successivo. Risposte più rapide riducono l'attesa a ogni passaggio.
Le dichiarazioni di OpenAI#
Philippe Tillet, inference lead di OpenAI, afferma che la documentazione e gli strumenti NVIDIA hanno aiutato i modelli a programmare bene le GPU Blackwell e Rubin, e che Astra trasforma questa competenza in kernel ad alte prestazioni. Uday Ruddarraju, chief technology officer of compute di OpenAI, dichiara che l'azienda ha usato modelli interni per ottimizzare l'inferenza sulle GPU NVIDIA.
Piccolo glossario#
Token: piccole unità di testo che il modello produce una alla volta.
Inferenza: l'uso di un modello già addestrato per generare risposte.
Kernel: programma che esegue un calcolo direttamente sulla GPU.
Blackwell: architettura di GPU NVIDIA su cui funziona Ultrafast.
Per dettagli sulla piattaforma, consultate la pagina NVIDIA.
Ultrafast nell'API: cosa cambia per chi sviluppa#
Come si attiva Ultrafast#
Ultrafast è la fascia più veloce dell'API di OpenAI, disponibile per gpt-6-astra e gpt-6.1-sol. Il parametro service_tier va impostato su ultrafast in ogni richiesta, quindi non si attiva una volta per tutte. Per agenti che concatenano molte chiamate di strumenti, la documentazione raccomanda i WebSocket, una connessione persistente che riduce il sovraccarico di rete tra una richiesta e l'altra. Chi preferisce l'HTTP può usarlo comunque, come illustra la guida.
Limiti di utilizzo e residenza dei dati#
Ultrafast ha limiti separati da quelli delle modalità Standard e Fast. Per GPT-6.1 Sol i limiti di default vanno da 1.000.000 TPM nel livello Build a 40.000.000 nel livello Grow; per GPT-6 Astra vanno da 500.000 a 5.000.000. Sol supporta la residenza dei dati negli Stati Uniti e nell'UE, Astra solo negli Stati Uniti.
Livello di utilizzo API | Token al minuto (TPM) |
|---|---|
Build | 1,000,000 |
Launch | 4,000,000 |
Grow | 40,000,000 |
Limiti di default Ultrafast per GPT-6.1 Sol Fonte: NVIDIA.
Livello di utilizzo API | Token al minuto (TPM) |
|---|---|
Build | 500,000 |
Launch | 1,000,000 |
Grow | 5,000,000 |
Limiti di default Ultrafast per GPT-6 Astra Fonte: NVIDIA.
TPM: token al minuto, il numero di token che il limite consente di elaborare in un minuto.
Tier di utilizzo: il livello dell'organizzazione da cui dipendono i limiti applicati.
WebSocket: connessione che resta aperta tra il vostro programma e il server, per più richieste di seguito.
service_tier: il parametro della richiesta che indica la fascia di servizio scelta.
Architettura Blackwell: i numeri di base#
Blackwell è l'architettura con cui NVIDIA costruisce i chip per i data center dell'AI. Le GPU Blackwell contengono 208 miliardi di transistor, i minuscoli interruttori che eseguono i calcoli, e sono prodotte con un processo costruito su misura da TSMC, chiamato 4NP. Ogni GPU unisce due die, cioè due blocchi di silicio, collegati a 10 TB/s, e funziona come un'unica GPU. Approfondite l'architettura nella scheda di NVIDIA.
Die: il blocco di silicio su cui sono incisi i circuiti del chip.
NVLink Switch: il componente che collega le GPU; in un dominio NVL72 da 72 GPU offre 130 TB/s di banda.
Microscaling: una tecnica che regola in modo fine la scala dei numeri, così da mantenere precisione usando formati più compatti.
FP4: un formato numerico a 4 bit che, secondo NVIDIA, raddoppia le dimensioni dei modelli che la memoria può ospitare.
Attenzione: il meccanismo centrale dei modelli linguistici, che Blackwell Ultra accelera 2x rispetto a Blackwell.
Calcolo confidenziale: protegge dati e modelli con sicurezza hardware; secondo NVIDIA, le prestazioni sono quasi identiche a quelle in modalità non cifrata.
Tutti questi valori sono dichiarazioni di NVIDIA, riportate così come pubblicate dal produttore.
Prezzi Ultrafast e confronto con le altre modalità#
Prezzi Ultrafast per 1M di token#
La pagina prezzi di OpenAI elenca Ultrafast accanto a Standard e Fast, con tariffe per milione di token (i prezzi). Per GPT-6 Astra l'input costa 60 $ e l'output 300 $; per GPT-6.1 Sol 12 $ di input e 60 $ di output. Con contesto lungo l'input sale a 120 $ per Astra e a 24 $ per Sol.
Modello | Standard input / output | Fast input / output | Ultrafast input / output |
|---|---|---|---|
GPT-6 Astra | 10 $ / 50 $ | 20 $ / 100 $ | 60 $ / 300 $ |
GPT-6.1 Sol | 2 $ / 10 $ | 4 $ / 20 $ | 12 $ / 60 $ |
Prezzi API OpenAI per 1M di token: Standard, Fast e Ultrafast
Confronto delle tariffe (contesto breve, in $/1M token) tra GPT-6 Astra e GPT-6.1 Sol
- Standard
- Fast
- Ultrafast
Fonte: OpenAI API Pricing, tabella ufficiale Ultrafast
Il sovrapprezzo regionale del 10% vale per gli endpoint di residenza dei dati. Esempio: 300 $ × 2 = 600 $ di output per 2 milioni di token Astra Ultrafast; con il sovrapprezzo, 600 $ × 1,10 = 660 $.
Tariffe complete nelle tabelle#
Modello | Input | Input cache | Scrittura cache | Output | Input (contesto lungo) | Input cache (contesto lungo) | Scrittura cache (contesto lungo) | Output (contesto lungo) |
|---|---|---|---|---|---|---|---|---|
gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 | $20.00 | $2.00 | $25.00 | $75.00 |
gpt-6.1-sol | $2.00 | $0.10 | $2.50 | $10.00 | $4.00 | $0.20 | $5.00 | $15.00 |
gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 | $0.20 | $0.02 | $0.25 | $0.75 |
Tariffe Standard per 1M di token, contesto breve e lungo: da qui si leggono i valori Standard di GPT-6 Astra e GPT-6.1 Sol. Fonte: NVIDIA.
Modello | Input | Input cache | Scrittura cache | Output | Input (contesto lungo) | Input cache (contesto lungo) | Scrittura cache (contesto lungo) | Output (contesto lungo) |
|---|---|---|---|---|---|---|---|---|
gpt-6-astra | $5.00 | $0.50 | $6.25 | $25.00 | $10.00 | $1.00 | $12.50 | $37.50 |
gpt-6.1-sol | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 | $0.10 | $2.50 | $7.50 |
gpt-6-luna | $0.05 | $0.005 | $0.0625 | $0.25 | $0.10 | $0.01 | $0.125 | $0.375 |
Tariffe Batch per 1M di token, breve e lungo contesto: per Astra e Sol i valori coincidono con la tabella Flex. Fonte: NVIDIA.
Modello | Input | Input cache | Scrittura cache | Output | Input (contesto lungo) | Input cache (contesto lungo) | Scrittura cache (contesto lungo) | Output (contesto lungo) |
|---|---|---|---|---|---|---|---|---|
gpt-6-astra | $5.00 | $0.50 | $6.25 | $25.00 | $10.00 | $1.00 | $12.50 | $37.50 |
gpt-6.1-sol | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 | $0.10 | $2.50 | $7.50 |
gpt-6-luna | $0.05 | $0.005 | $0.0625 | $0.25 | $0.10 | $0.01 | $0.125 | $0.375 |
Tariffe Flex per 1M di token, breve e lungo contesto, con gli stessi valori della tabella Batch. Fonte: NVIDIA.
WebSocket: meno attesa tra uno strumento e l'altro#
L'API Responses di OpenAI offre una modalità WebSocket, pensata per flussi lunghi con molte chiamate a strumenti esterni. Invece di inviare una nuova richiesta a ogni passaggio, la connessione resta aperta e ogni turno trasmette solo i nuovi input, indicando la risposta precedente con previous_response_id. Il dettaglio è nella documentazione WebSocket Mode.
Secondo OpenAI, per flussi con 20+ chiamate a strumenti l'esecuzione end-to-end può risultare fino a circa il 40% più veloce. Si tratta di una dichiarazione del produttore, non di un benchmark indipendente.
Con stream_id, una sola connessione gestisce più conversazioni in parallelo e può far ripartire una conversazione esistente su un nuovo flusso. La modalità è compatibile con Zero Data Retention (ZDR) e con store=false.
Glossario essenziale#
WebSocket: canale di comunicazione che resta aperto e permette lo scambio continuo di messaggi tra il vostro software e il server.
previous_response_id: identificativo della risposta precedente, da cui la conversazione prosegue.
stream_id: etichetta che distingue più conversazioni parallele sulla stessa connessione.
Zero Data Retention (ZDR): modalità in cui il fornitore non conserva i dati delle richieste.
store=false: parametro che chiede di non salvare la risposta sul server.
GB300 NVL72: scheda tecnica#
Cosa racchiude il sistema#
Il GB300 NVL72 è un sistema rack-scale a raffreddamento liquido che integra 72 GPU NVIDIA Blackwell Ultra e 36 CPU NVIDIA Grace in un'unica piattaforma. Secondo il produttore, rispetto alle GPU Blackwell offre 1,5x di FLOPS FP4 Tensor Core densi e 2x di accelerazione del livello attention. Le specifiche complete sono nella pagina NVIDIA.
Voce | Valore |
|---|---|
NVLink Bandwidth | 130 TB/s |
Fast Memory | 37 TB |
GPU Memory | Bandwidth | 20 TB | Up to 576 TB/s |
CPU Memory | Bandwidth | 17 TB LPDDR5X | 14 TB/s |
CPU Core Count | 2,592 Arm Neoverse V2 cores |
FP4 Tensor Core | 1440 | 1080 2 PFLOPS |
FP8/FP6 Tensor Core | 720 PFLOPS |
INT8 Tensor Core | 24 POPS |
FP16/BF16 Tensor Core | 360 PFLOPS |
TF32 Tensor Core | 180 PFLOPS |
FP32 | 6 PFLOPS |
FP64 / FP64 Tensor Core | 100 TFLOPS |
Specifiche tecniche del GB300 NVL72 riportate dalla pagina NVIDIA Fonte: NVIDIA.
Dichiarazioni del produttore#
NVIDIA dichiara fino a 50x di aumento della produttività complessiva di un'AI factory rispetto a piattaforme Hopper. Il dato si basa su un test con DeepSeek-R1, con 32K token in ingresso e 8K in uscita, e le performance sono indicate come proiettate e soggette a modifiche. Le specifiche Tensor Core includono la sparsità, salvo diversa indicazione: la voce FP4 riporta 1440 PFLOPS con sparsità e 1080 PFLOPS senza.
Disponibilità e prezzi#
La pagina indica il sistema come disponibile ora. La fonte non riporta prezzi: per l'acquisto il riferimento è il contatto con le vendite NVIDIA.
Come leggere questi numeri#
Chi ha misurato cosa#
I valori 50x e 35x derivano dai dati SemiAnalysis InferenceX, che NVIDIA cita nel proprio comunicato. L'analisi di Signal65 riguarda invece GB200 NVL72 e parla di oltre 10x di token per watt. La scheda prodotto di NVIDIA attribuisce il 50x a DeepSeek-R1 con 32K di input e 8K di output, confrontando GB300 NVL72 con H100 in FP8, e avverte che le prestazioni sono proiettate e soggette a modifiche.
Cosa non dicono#
Ogni cifra vale solo per il proprio scenario. Le fonti citano carichi diversi, da 1k/1k a 32k/8k fino a 128k/8k, e un confronto su input lunghi non vale automaticamente per i vostri casi. Il costo per token dipende da ipotesi su prezzi e utilizzo che le fonti non descrivono, quindi il rapporto di costo non si trasferisce al vostro caso senza una verifica.
Questo articolo è stato scritto con l'aiuto dell'intelligenza artificiale.
Riquadro di cautela: cosa non sappiamo ancora#
Cosa significa per un'azienda#
Stabilite se la latenza conta. Secondo NVIDIA, Ultrafast genera token fino a 8 volte più velocemente di Standard: conviene dove la velocità giustifica il costo.
Verificate i limiti TPM prima di aumentare il traffico. Ultrafast ha limiti separati: per GPT-6 Astra il livello Build prevede 500.000 TPM, Launch 1.000.000, Grow 5.000.000.
Confrontate i costi su un caso reale. Per GPT-6 Astra l'input costa $60 per milione di token in Ultrafast contro $10 in Standard; l'output $300 contro $50.
Con agenti che fanno molte chiamate a strumenti, usate WebSocket. OpenAI segnala circa il 40% di esecuzione più rapida oltre 20 chiamate, compatibile con ZDR e store=false.
Controllate la residenza dei dati: GPT-6.1 Sol supporta US ed EU, GPT-6 Astra solo US.
Misurate la latenza sui vostri carichi prima di scalare, perché i dati citati sono dichiarazioni dei produttori.
Domande frequenti#
Che cos'è Ultrafast?
È la modalità di servizio più veloce dell'API OpenAI, disponibile per GPT-6 Astra e GPT-6.1 Sol. Secondo quanto dichiarato dal produttore, offre fino a 8x di generazione di token rispetto alla modalità Standard di Astra.
Quanto costa per GPT-6 Astra?
Per il contesto breve, Ultrafast costa $60.00 per 1M di token in input e $300.00 in output. Per la modalità Standard la tabella riporta $10.00 in input e $50.00 in output. Per il contesto lungo i prezzi sono più alti: consultate la tabella dei prezzi.
Serve il WebSocket?
Non è obbligatorio. La documentazione lo raccomanda soprattutto per flussi agentici con molte chiamate di strumenti, e segnala fino a circa 40% di esecuzione più rapida con 20+ chiamate. Ultrafast funziona anche via HTTP, ma senza connessione persistente l'overhead di rete può ridurre i vantaggi di latenza.
Chi può usarla in ChatGPT?
In ChatGPT la modalità è offerta agli utenti idonei di ChatGPT Work e Codex. Nell'API è disponibile a tutti gli utenti API. Controllate i rate limit della vostra organizzazione, che sono separati da quelli di Standard e Fast.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 5/10 | NVIDIA dichiara fino a 50x di throughput per megawatt e fino a 35x di costo per token in meno rispetto a Hopper, mentre OpenAI dichiara Ultrafast fino a 8x più veloce della modalità Standard; sono dati dei produttori e le fonti non… |
Prezzo e disponibilità | 6/10 | Il prezzo Ultrafast di GPT-6 Astra è pubblicato (60 dollari per milione di token di input contro 10 in Standard, 300 in output contro 50) e il servizio è disponibile ora nell'API OpenAI. |
Trasparenza dei dati | 5/10 | La pagina GB300 NVL72 indica le condizioni di un test (DeepSeek-R1, ISL 32K, OSL 8K, confronto con H100 FP8) ma definisce le proiezioni «soggette a modifiche»; le fonti non chiariscono la baseline completa dei 35x di costo. |
Apertura e licenza | 2/10 | GPT-6 Astra Ultrafast è accessibile solo tramite API OpenAI e le fonti non riportano alcuna licenza, né pesi del modello disponibili per uso locale. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Annuncio con dati di prestazione dichiarati dai produttori (NVIDIA e OpenAI), prezzi Ultrafast pubblicati e disponibilità API immediata; verifiche indipendenti assenti.
Per chi deve decidere, l'Ultrafast di GPT-6 Astra è disponibile subito via API, ma costa molto più della modalità Standard e le cifre di velocità e costo sono dichiarazioni dei produttori. Le fonti non permettono di verificare i 50x e i 35x in condizioni diverse dal test NVIDIA indicato. Conviene confrontare il costo reale per le proprie chiamate agli strumenti e verificare i limiti di frequenza prima di adottarlo in produzione.
Punti di forza
- Prezzi Ultrafast pubblicati in tabella per input, input in cache, scrittura cache e output, con limiti di frequenza separati per livello d'uso.
- Disponibilità immediata dell'Ultrafast di GPT-6 Astra per tutti gli utenti API, con esempi di codice in più linguaggi e modalità HTTP e WebSocket.
- Il test NVIDIA su GB300 NVL72 dichiara i parametri di carico (32K di input e 8K di output) e la configurazione di confronto.
Limiti
- I dati di 50x e 35x sono dichiarazioni del produttore; le fonti non riportano verifiche indipendenti complete.
- Ultrafast di GPT-6 Astra costa 60 dollari per milione di token di input contro 10 in Standard, con un costo di output di 300 dollari contro 50.
- Limiti di frequenza Ultrafast distinti e più bassi per GPT-6 Astra (da 500.000 a 5.000.000 TPM), con residenza dei dati solo negli Stati Uniti.
- Le fonti non indicano prezzi o costi reali di un carico di lavoro specifico né la licenza del modello.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.NVIDIA — New SemiAnalysis InferenceX Data Shows NVIDIA Blackwell Ultra Delivers up to 50x Better Performance and 35x Lower Costs for Agentic AIblogs.nvidia.com
Annuncio ufficiale da cui nasce l’articolo.
- 2.NVIDIA — How NVIDIA GPUs Help Accelerate OpenAI’s GPT-6 Astra Ultrafastblogs.nvidia.com
Documento ufficiale collegato all’annuncio.
- 3.NVIDIA — Ultrafast mode | OpenAI APIdevelopers.openai.com
Documento ufficiale collegato all’annuncio.
- 4.
- 5.
- 6.NVIDIA — WebSocket Mode | OpenAI APIdevelopers.openai.com
Documento ufficiale collegato all’annuncio.
- 7.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.