2,4 trilioni di parametri, 95 miliardi attivi, un milione di token di contesto e API a 2 e 6 dollari. Cosa mostrano le demo, dove vince nei benchmark, dove no, e cosa manca ancora.
Qwen3.8-Max di Alibaba: 2,4 trilioni di parametri, contesto da 1 milione di token, API a 2/6 $, benchmark contro GPT e Claude e pesi ancora da pubblicare.
di Andrea Pirazzini
Fonte primaria
Qwen Team — Qwen3.8: A New Bar for Coding and Cowork, annuncio e blog tecnico
qwen.ai
Versione audio
2 min 17 s
Perché se ne parla#
Alibaba ha reso disponibile Qwen3.8-Max, il nuovo modello di punta della famiglia Qwen. I numeri in copertina sono quelli di un modello di frontiera: 2,4 trilioni di parametri, un milione di token di contesto, testo e immagini in ingresso. Le due notizie vere, però, sono altre.
La prima è il prezzo. Su QwenCloud si pagano 2 dollari per milione di token in ingresso e 6 in uscita: poco, per un modello che si mette a confronto diretto con i migliori sistemi americani. La seconda è una promessa: Qwen dice che ne pubblicherà i pesi la settimana dopo il lancio. Per la serie Max, finora sempre chiusa, sarebbe la prima volta.
A luglio avevo scritto della preview di Qwen 3.8, quando mancavano ancora benchmark e dettagli tecnici. Adesso il quadro è molto più ricco: cinque video, una tabella di test lunghissima e una serie di casi in cui il modello lavora da solo per ore, a volte per giorni. Il messaggio di Alibaba è netto: questo non è Qwen3.5 in formato più grande, è un modello pensato per prendere in carico un lavoro aperto, usare gli strumenti, guardare cosa ha prodotto, correggersi e consegnare qualcosa che si può controllare.
parametri totali, di cui 95 miliardi attivi per token
token di contesto dichiarati su QwenCloud
per milione di token in ingresso, 6 $ in uscita
su PaperBench, il punteggio più alto del confronto
La scheda, in una tabella#
Voce | Cosa dichiara Alibaba al lancio |
|---|---|
Nome nelle API | qwen3.8-max |
Parametri | 2,4 trilioni in totale, 95 miliardi attivi per token |
Architettura | Mixture of Experts, costruita sulle basi di Qwen3.5 |
Contesto | 1 milione di token su QwenCloud |
Cosa legge | Testo e immagini; lavora su codice, documenti, video lunghi e uso del computer |
Livelli di ragionamento | xhigh, medium, low |
Compatibilità | Protocolli API di OpenAI e di Anthropic |
Prezzo | 2 $ input e 6 $ output per milione di token |
Pesi | Promessi su Hugging Face e ModelScope, non ancora online al 3 agosto 2026 |
Come è fatto e come è stato allenato#
95 miliardi al lavoro, su 2,4 trilioni#
Qwen3.8-Max è un Mixture of Experts, come molti modelli di questa fascia. L'immagine più semplice è quella di un grande studio professionale: dentro ci sono 2,4 trilioni di parametri, ma per ogni parola da elaborare se ne attivano circa 95 miliardi, una frazione. Così si ha la capacità di un modello enorme senza pagare ogni volta il costo di usarlo per intero.
Allenato su lavori lunghi, non su domande secche#
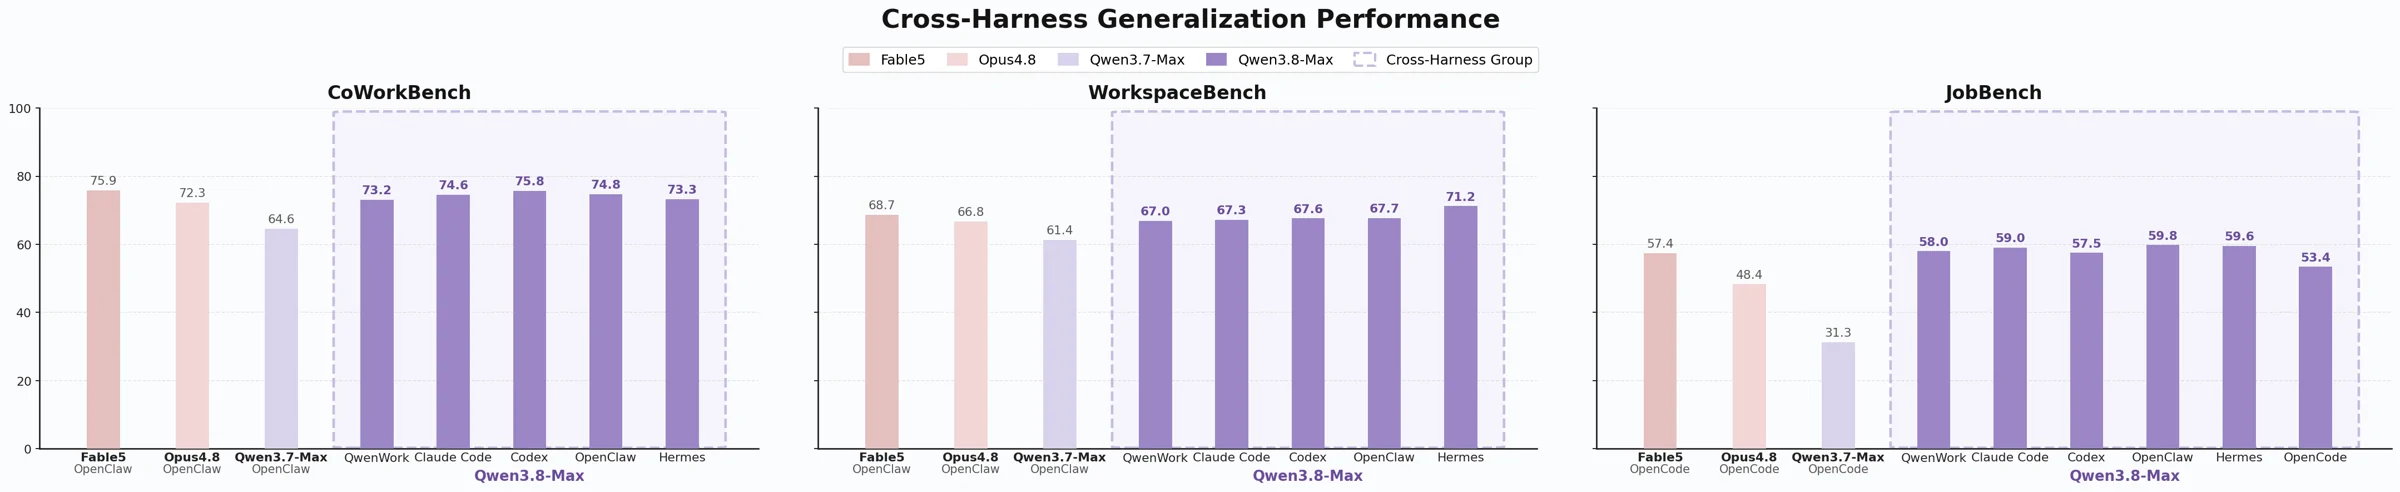
La parte più interessante del lancio riguarda l'addestramento. Qwen racconta di aver fatto crescere insieme la potenza di calcolo e il numero di ambienti di reinforcement learning: le palestre dove il modello si esercita su compiti concreti e riceve un voto per come li svolge.
Questi ambienti cambiano lungo tre assi:
la durata del compito, da pochi passaggi a lavori di giorni;
la complessità dello spazio di lavoro, cioè quanti file, dati e strumenti entrano in gioco;
l'harness, il programma che collega il modello a terminale, browser e strumenti esterni.
Il voto arriva da un sistema unico che combina tre tipi di controllo: prove che si possono eseguire (il codice gira oppure no), giudizi su testi e su risultati grafici renderizzati, e ispezioni svolte da un altro agente. Un bilanciatore, in tempo reale, distribuisce gli esercizi tra tipi di compito, livelli di difficoltà e strumenti, per evitare che il modello si specializzi su una cosa sola.
Lo stesso modello dentro strumenti diversi#
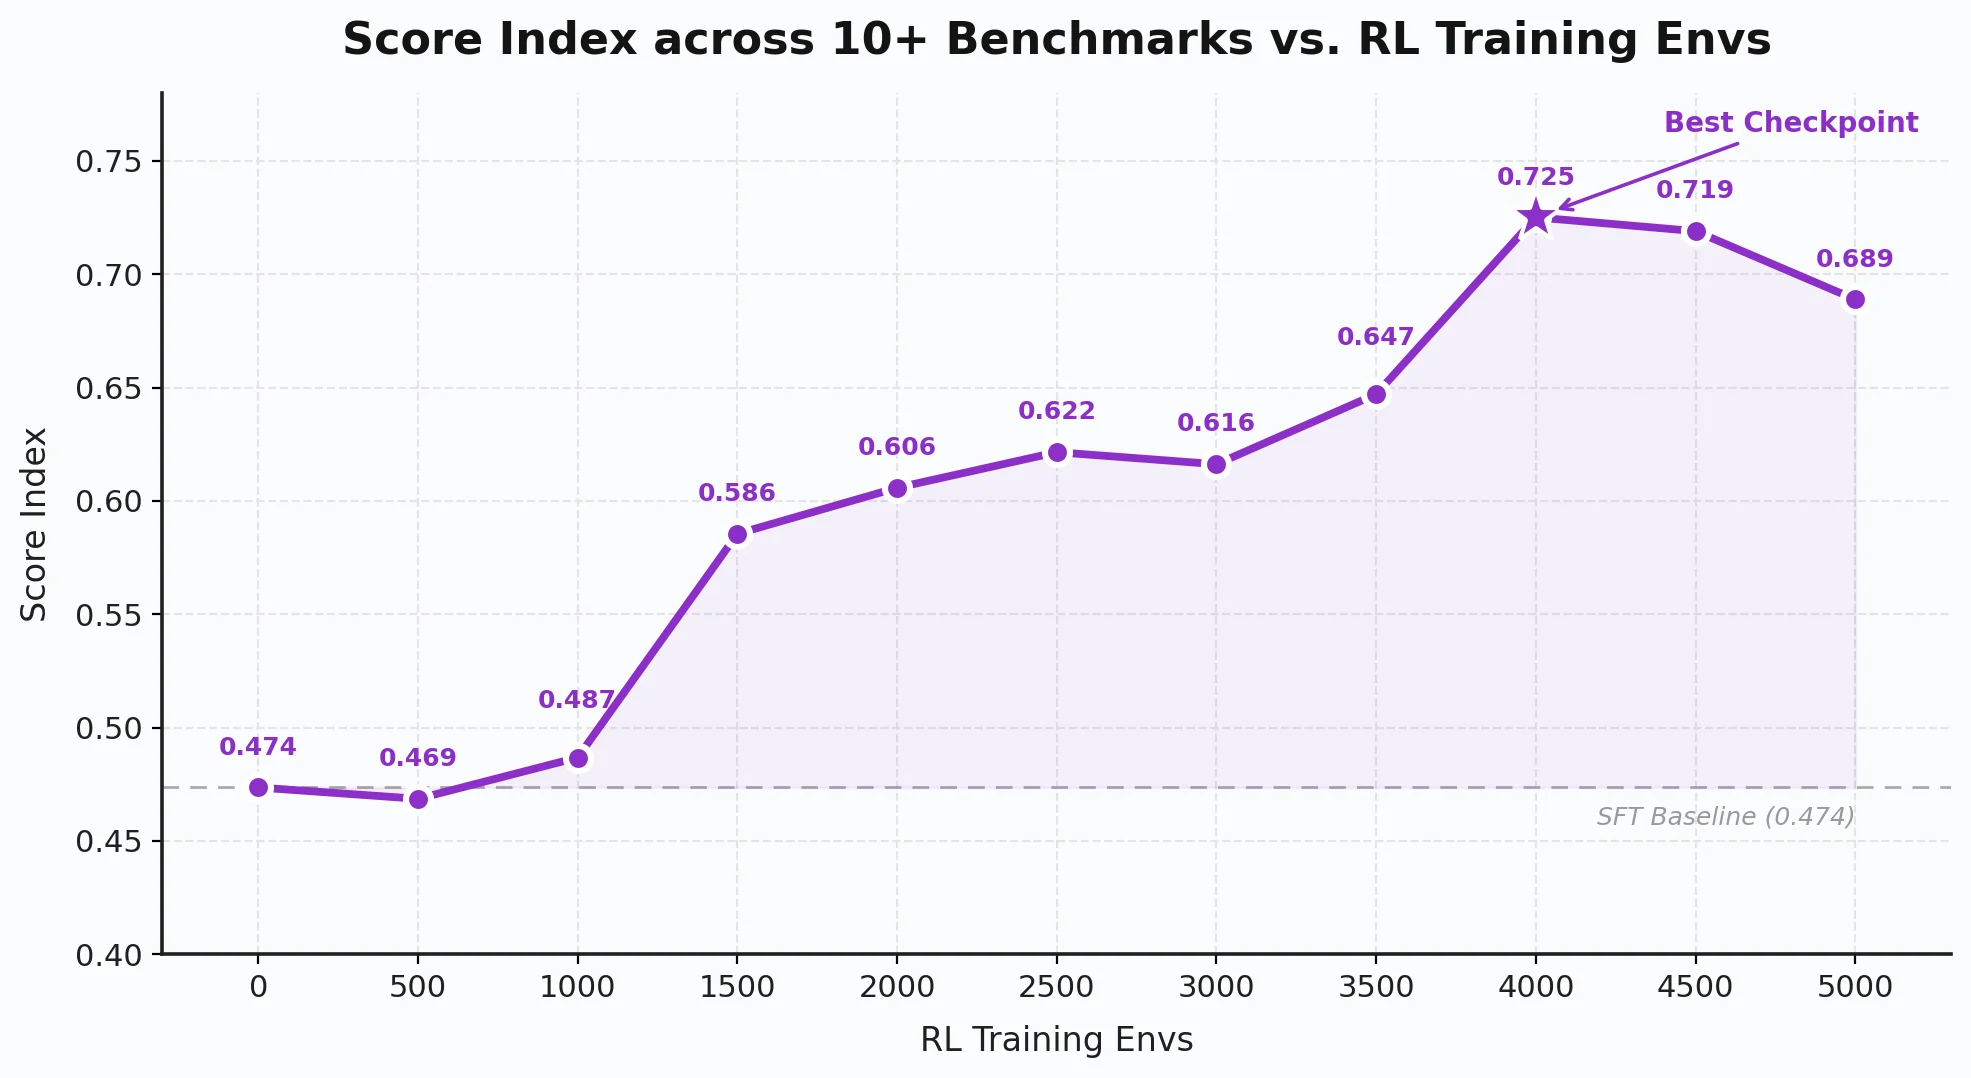
Secondo Qwen, il modello rende in modo simile in cinque ambienti di lavoro: QwenWork, Claude Code, Codex, OpenClaw e Hermes. Per chi costruisce agenti in azienda sarebbe un dettaglio prezioso, perché vorrebbe dire poter cambiare strumento senza perdere qualità. Per ora però sono misure del produttore: prima di contarci servono prove su installazioni e carichi di lavoro esterni.
Cinque prove di lavoro autonomo#
Il lancio si appoggia su cinque video e su diversi casi raccontati nel dettaglio. Li riassumo con i numeri dichiarati.
Un agente da terminale costruito in più di dieci giorni#
Il primo caso si chiama oh-my-cli: un agente da riga di comando con un harness che migliora grazie ai feedback. Qwen3.8-Max lo ha costruito da zero lavorando in autonomia per oltre dieci giorni. Il resoconto ufficiale, aggiornato al 30 luglio, parla di circa 16 giorni di attività, con 265 commit, 151 issue e 127 pull request. Il repository è pubblico, quindi almeno l'esistenza del progetto e la sua attività si possono verificare.
oh-my-cli in circa 16 giorni
Attività sul repository, resoconto ufficiale al 30 luglio
Fonte: dichiarato dal team Qwen, agosto 2026
Il funzionamento ricorda quello di un piccolo team di sviluppo:
richieste e segnalazioni diventano issue;
il lavoro passa agli agenti e attraversa tre stati,
ready, poileased, poiactive;dopo ogni modifica si compila tutto, girano i test unitari e quelli end-to-end, e si verifica il ciclo di vita dell'app desktop;
se qualcosa si rompe, l'errore torna all'issue o alla pull request che l'ha causato e il ciclo di riparazione riparte.
È una prova più seria delle solite demo da cinque minuti, perché tocca le cose che contano nel software vero: tenere traccia dello stato, ripartire dopo un fallimento, fare manutenzione, tenere conto di segnali che arrivano da fuori. Resta organizzata da Qwen e non è un audit indipendente, ma un repository aperto dà molta più trasparenza di un video promozionale.
Rifare un articolo scientifico, poi migliorarlo#
Nel secondo caso il modello riceve un paper, Unified Data Selection for LLM Reasoning, e un gruppo di GPU. Nessuna riga di codice di partenza. In circa 125 ore:
scrive circa 7.600 righe di codice;
compie più di 1.100 azioni;
completa 33 cicli di addestramento.
Le prime 37 ore se ne vanno per ricostruire la pipeline e riprodurre sei risultati principali del paper. Nelle 88 successive il modello propone e prova 18 idee, in quattro round. Il metodo originale, una volta riprodotto, arrivava al 49,58% sul test AIME24; la variante migliore trovata dal modello sale al 52,29%, cioè 2,71 punti in più.
Il dato vale per questo esperimento: non dice che il modello sappia migliorare qualunque ricerca. Mostra però un ciclo di lettura, codice, addestramento e analisi tenuto in piedi per giorni senza perdersi.
Una gara contro 526 squadre umane#
Terzo caso: una competizione pubblica sulla piattaforma Tianchi, la WWW2025 Multimodal Dialogue Intent Recognition Challenge, dove bisogna capire l'intenzione di un utente mettendo insieme testo e immagini. In 24 ore il modello ha assemblato una soluzione a più pezzi: per le frasi ha scelto BERT, MacBERT e RoBERTa; per le immagini Qwen2.5-VL-7B; per decidere i casi incerti Chinese-CLIP.
Dopo 45 invii, sempre secondo Qwen, l'accuratezza passa da 0,60 a 0,853. Con quel punteggio il modello si sarebbe piazzato davanti a 458 squadre su 526: meglio dell'87% dei partecipanti.
Oltre il software: il lavoro delle professioni#
Qwen ha messo alla prova il modello anche su flussi di lavoro presi da centinaia di professioni di alto valore economico. Si va dalla revisione dei contratti alla progettazione di interfacce, dai menu per la ristorazione all'analisi strutturale, fino alla riabilitazione e all'analisi sportiva.
Caso dichiarato | Risultato |
|---|---|
Revisione contrattuale | Da centinaia di documenti, 1.284 clausole rilevanti trovate in meno di un'ora |
Progettazione di interfacce | Prototipo interattivo di un'app bancaria, otto schermate, in un solo passaggio |
Ristorazione | Menu di 26 piatti, food cost al 33,8% |
Ingegneria strutturale | Modello interattivo della risposta al sisma di un palazzo di 30 piani |
Analisi sportiva | Profili tattici costruiti da circa 8.400 possessi palla per giocatore |
Una strategia d'investimento in una sessione#
Il caso finanziario parte da una richiesta di poche righe: costruire una strategia di rotazione tra ETF. Il modello organizza il lavoro con circa 330 sotto-agenti e quasi 6.000 backtest, divisi tra sei famiglie di fattori (sentiment, momentum, value, qualità, basso rischio e investimento).
La parola "profittevole", qui, conta poco: un backtest non garantisce nulla sul futuro. Conta di più come il modello si muove durante la ricerca:
quando sospetta un overfitting tra il periodo usato per progettare e quello usato per validare, toglie i fattori che si ripetono;
quando strade diverse portano agli stessi segnali, aggiunge una validazione con più semi casuali (multi-seed);
quando un insieme di modelli si rivela fragile su campioni piccoli, cambia architettura.
Qwen riporta un excess Sharpe tra 0,64 e 1,48 e un information coefficient tra 0,010 e 0,014, e non presenta il risultato come un consiglio finanziario da usare senza ulteriori verifiche.
Progettare un chip, gestire un negozio#
Un acceleratore crittografico con verifiche automatiche#
Qwen3.8-Max ha lavorato anche sull'hardware: un acceleratore per calcoli GCD/RSA, in un ambiente attrezzato con Icarus Verilog, Yosys e OpenROAD e con test scritti in cocotb. Servono circa 500 turni e 71 valutazioni per portare le porte logiche del primo progetto funzionante da 8.298 a 678. Il guadagno più grosso arriva da una scelta di architettura: al posto di un divisore hardware per il modulo, un procedimento iterativo che sposta e sottrae (shift-subtract).
Misura | Primo progetto | Progetto finale |
|---|---|---|
Porte logiche | 8.298 | 678 |
Area del die | 106×106 µm² | 46×46 µm² |
Lunghezza dei collegamenti | 33.369 µm | 4.187 µm |
Il progetto finale rispetta i tempi a 500 MHz con un margine positivo (slack) di 0,66 ns. Il valore della prova non è il chip in sé. È il metodo: ogni revisione passa per simulazione, sintesi e piazzamento sul layout, quindi il modello riceve un riscontro oggettivo invece di dare i voti da solo al proprio codice.
Un anno di e-commerce, in simulazione#
E-Commerce Bench è un test interno che simula 365 giorni di gestione di un negozio online. In gioco ci sono 7.000 prodotti divisi in 60 categorie, 12 tipologie di negozio e quasi 600 fornitori. Il capitale iniziale è di 100.000 yuan: con quello il modello sceglie assortimento, prezzi e scorte, tratta con i fornitori e gestisce i resi. Nel frattempo arrivano la stagionalità, le crisi di fornitura e 152 operatori truffaldini nascosti nel mercato.
Un anno di negozio simulato
E-Commerce Bench, migliaia di yuan (arrotondato)
Fonte: dichiarato dal team Qwen, agosto 2026
Secondo Qwen, il modello chiude l'anno con 416.252 yuan: 4,16 volte il capitale di partenza, il 38% in più di GLM 5.2 (secondo in classifica) e il 152% in più di Qwen3.7-Max. Il test si basa su dati anonimizzati di Taobao e Tmall ed è utile per misurare la coerenza lungo più di 2.000 interazioni. Gestire un'impresa vera, però, resta un'altra faccenda.
Vede quello che fa: l'agente multimodale#
Qwen3.8-Max unisce la comprensione visiva all'esecuzione. Secondo il produttore legge documenti di oltre 200 pagine e video di oltre 100 ore, e se ne costruisce una memoria fatta di persone, eventi, scene e momenti precisi. Sa anche produrre interfacce, animazioni, montaggi video, scene in Blender e applicazioni a partire da un'immagine o da una descrizione.
La differenza sta nell'usare la vista durante il lavoro, non solo all'inizio. Il modello osserva come è impaginata una pagina, da che parte sono girati gli oggetti, se un'animazione riesce bene: se in una scena 3D un televisore guarda dalla parte sbagliata, o una pagina non rispetta il design, se ne accorge, rivede il piano e corregge. Qwen chiama questa combinazione Hybrid Agent: il codice per le operazioni precise e ripetibili, il controllo dell'interfaccia grafica per tutto ciò che una persona vede e può toccare sullo schermo.
Per misurarla il team ha creato RecreationBench, che copre cinque ambienti (web, Android, Windows, macOS e Ubuntu). Qui il modello riceve un'applicazione come una scatola chiusa, senza sorgente e senza accesso a Internet, e deve ricostruirla usandola e osservandone le reazioni. Con il modello arriva anche Qwen-MM-Plugins, un'estensione che aggiunge agli harness per agenti elaborazione di immagini e video, memoria multimodale, risoluzione dinamica e strumenti visivi.
I benchmark: forte, ma non primo dappertutto#
La tabella ufficiale descrive un modello che sta alla pari con i migliori sistemi americani, non un vincitore assoluto. Ecco otto test in cui Qwen riporta i valori di tutti e quattro i modelli messi a confronto.
Qwen3.8-Max contro i modelli americani
Otto test con i valori di tutti e quattro i modelli, punteggi dichiarati
- Qwen3.8-Max
- Opus 4.8
- Fable 5
- GPT-5.6 Sol
Fonte: tabella pubblicata dal team Qwen, agosto 2026
Letta con calma, la tabella dice questo:
PaperBench (riprodurre ricerche scientifiche): Qwen3.8-Max è primo con 93,0, davanti a GPT-5.6 Sol (90,5), Fable 5 (88,8) e Opus 4.8 (80,3).
TerminalBench 2.1 (lavoro da terminale): 86,6, dietro GPT-5.6 Sol (88,8) ma davanti ai due modelli Anthropic, entrambi a 84,6.
SWE-bench Pro (correggere software reale): 67,7, sotto Fable 5 (80,0) e Opus 4.8 (69,2), sopra GPT-5.6 Sol (64,6).
DeepSWE 1.1: 56,6, il valore più basso dei quattro.
CoWorkBench: 74,8, secondo per un soffio dietro Fable 5 (75,9).
HLE senza strumenti (domande di livello esperto): 43,6, ultimo; Fable 5 arriva a 53,3.
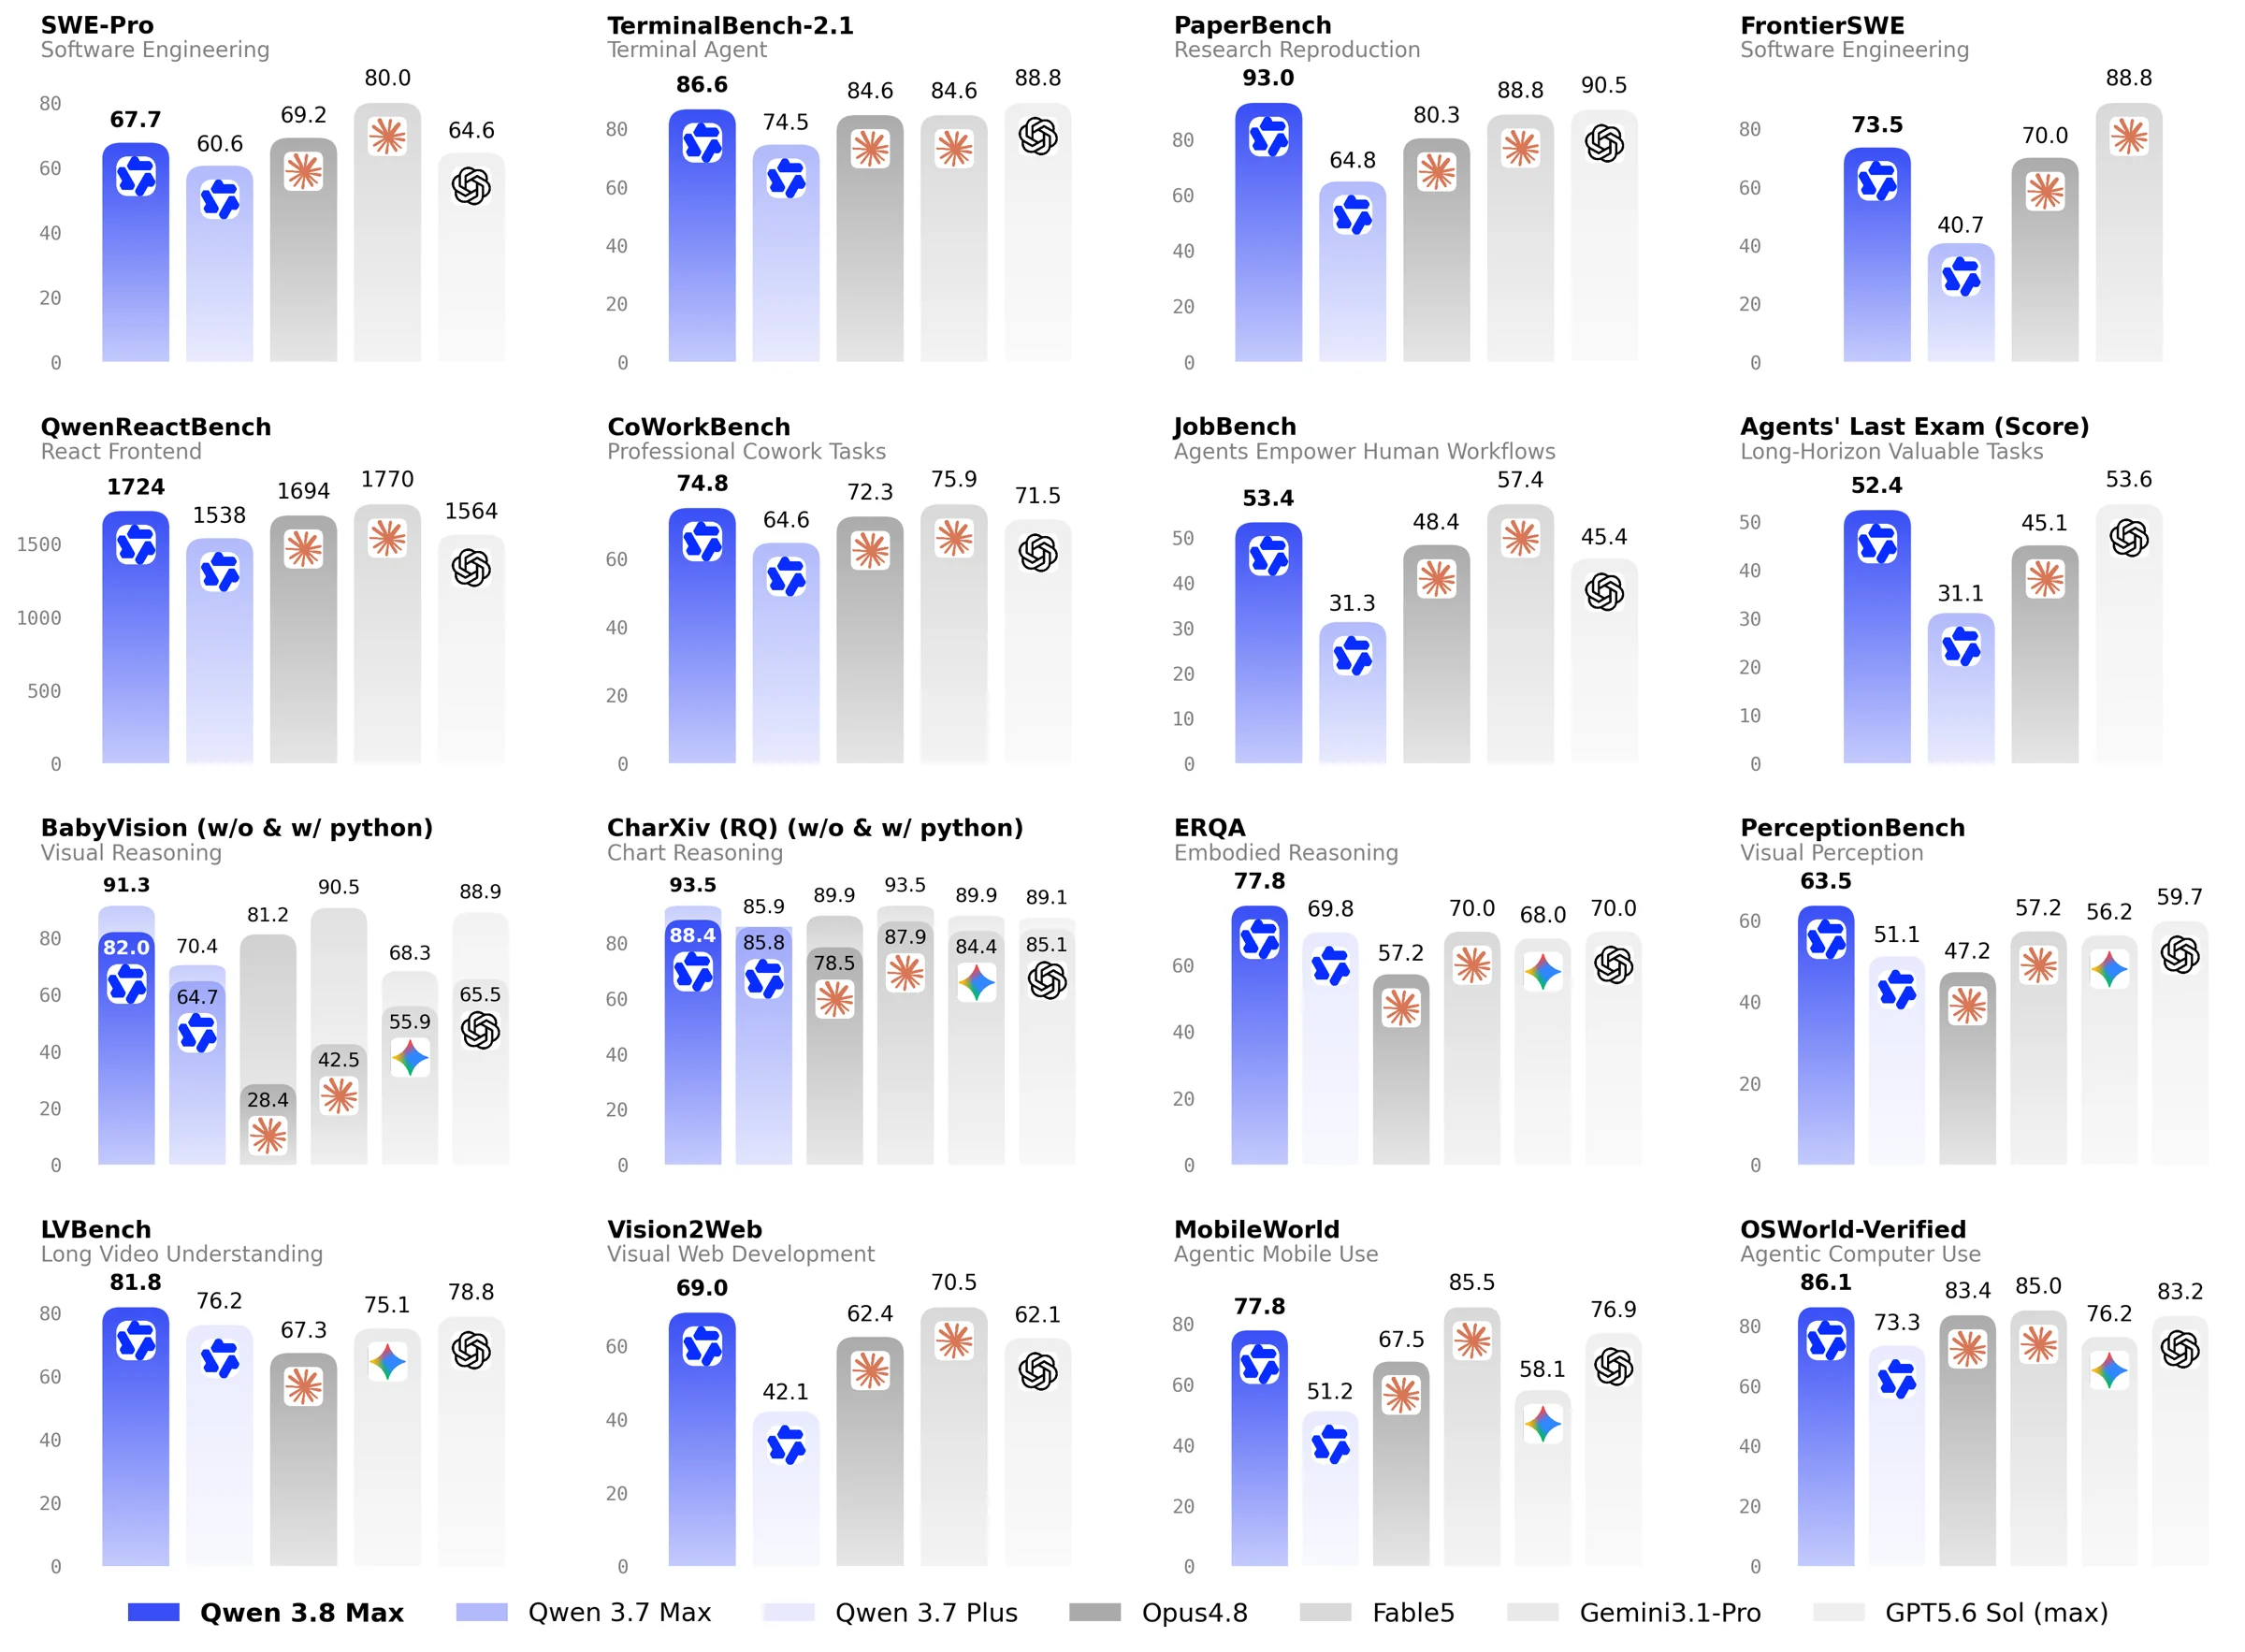
Su tre test Qwen dichiara il punteggio più alto della sua tabella: IFBench (seguire istruzioni precise) con 82,8, WideSearch (ricerche ampie sul web) con 81,9 e OSWorld-Verified (usare un computer come farebbe una persona) con 86,1. Sul fronte visivo, dove il confronto coinvolge anche Gemini 3.1 Pro, i punteggi dichiarati sono questi:
Qwen3.8-Max nei test visivi
Punteggi dichiarati, più alto è meglio
Fonte: tabella pubblicata dal team Qwen, agosto 2026
Il confronto diretto con GPT-5.6 Sol e Gemini 3.1 Pro, su sei test tra visione e uso del computer, disegna invece questa forma:
Prezzi, API e integrazioni#
Il modello si usa già su QwenCloud. L'API offre le interfacce Chat Completions e Responses compatibili con OpenAI e un'interfaccia compatibile con Anthropic. In pratica lo si può collegare a Qwen Code, Qoder CLI, OpenClaw, Codex e Claude Code cambiando tre cose: indirizzo, chiave e nome del modello.
Il parametro reasoning_effort decide quanto il modello ragiona prima di rispondere:
Livello | Quando usarlo |
|---|---|
xhigh | Il valore predefinito, per i problemi complessi |
medium | Un compromesso tra qualità e velocità |
low | Meno costo e meno attesa, per compiti semplici |
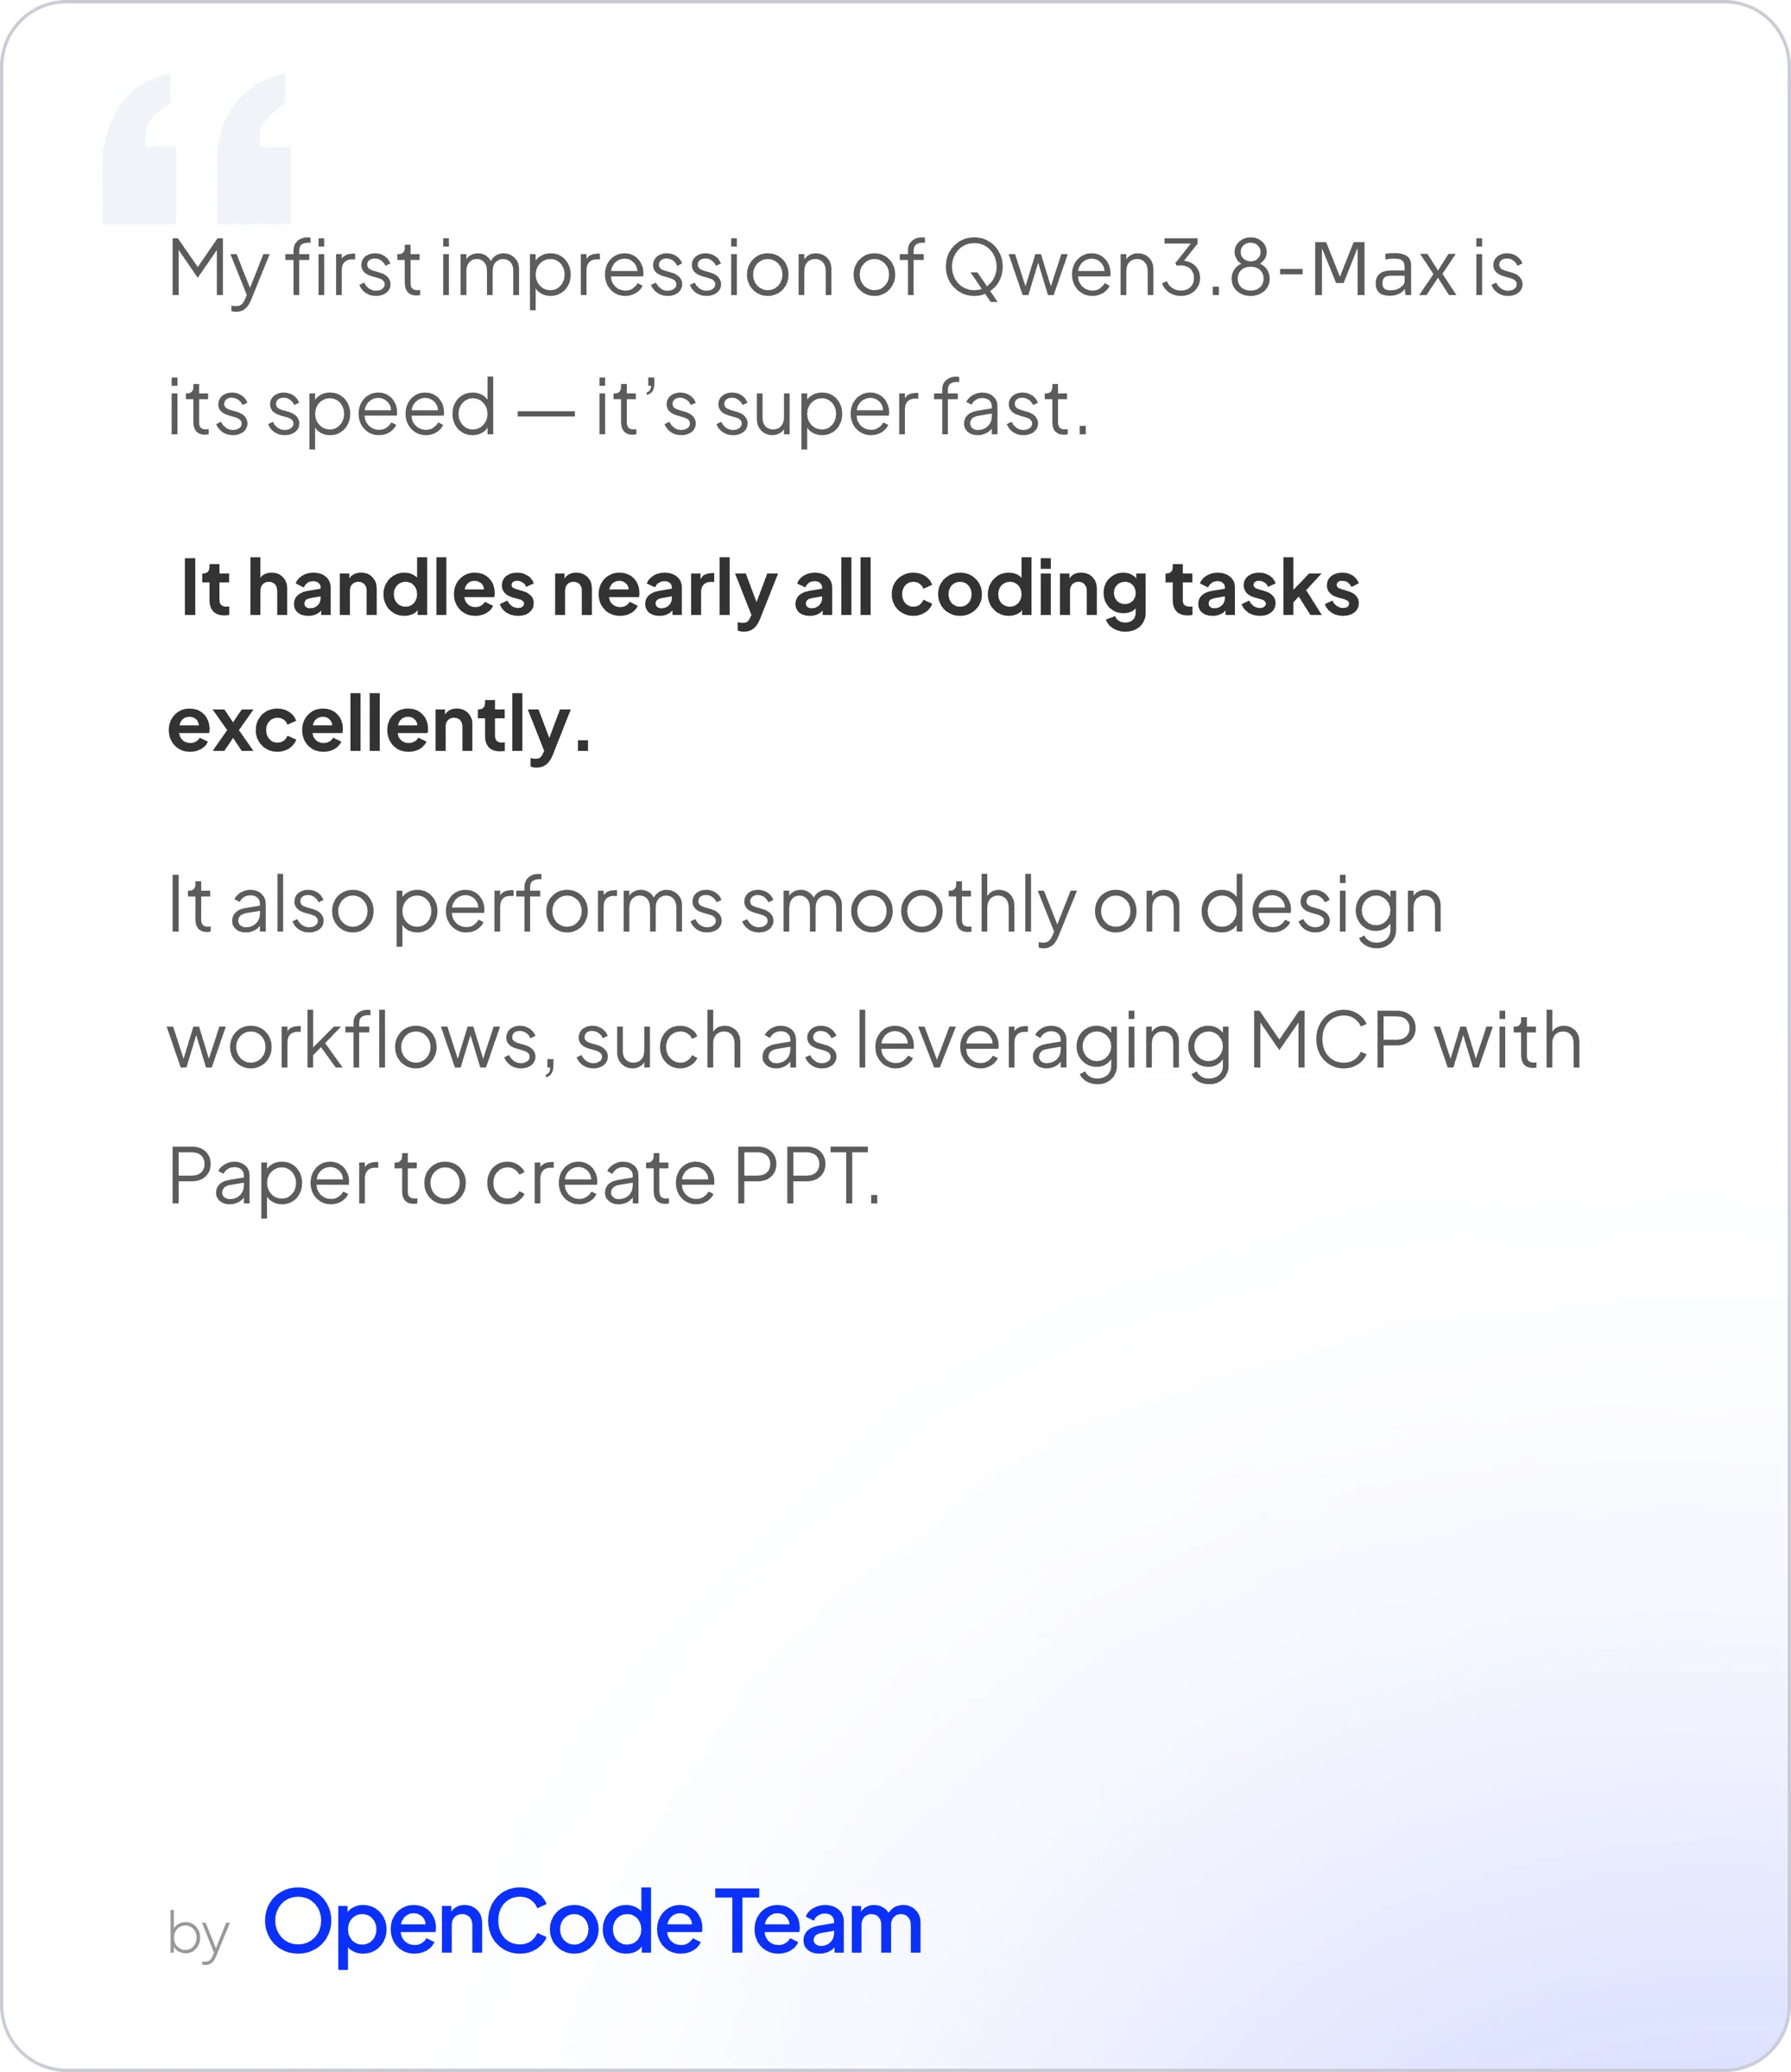
Secondo la documentazione del lancio, l'opzione preserve_thinking è attiva di default. Nel materiale ufficiale c'è anche una testimonianza del team di OpenCode, che parla di velocità e buoni risultati nel coding e nel design: una citazione scelta da Qwen, non un test.
Per una prima prova basta l'SDK di OpenAI puntato all'endpoint internazionale di DashScope, con la chiave tenuta in una variabile d'ambiente:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["QWEN_API_KEY"],     # la chiave non va mai scritta nel codice
    base_url="ENDPOINT_INTERNAZIONALE_DASHSCOPE",
)
risposta = client.chat.completions.create(
    model="qwen3.8-max",
    reasoning_effort="medium",              # xhigh, medium oppure low
    messages=[{"role": "user", "content": "Elenca le clausole di recesso di questo contratto."}],
)
print(risposta.choices[0].message.content)
La stessa prova, passo per passo e con l'indirizzo reale dell'endpoint:
Un esempio di calcolo#
Prendiamo un contratto lungo 50.000 token da cui far uscire un riassunto di 2.000 token. L'ingresso costa 50.000 × 2 $ / 1.000.000 = 0,10 $, l'uscita 2.000 × 6 $ / 1.000.000 = 0,012 $: circa 11 centesimi a documento, poco più di 11 dollari per cento contratti.
È un conto indicativo. Con i livelli di ragionamento più alti il modello può produrre molto più testo in uscita, e quindi costare di più; promozioni, regioni e servizi accessori possono spostare il prezzo effettivo. Anche il milione di token di contesto va letto come un tetto: quanto se ne usa davvero dipende dall'endpoint, dal client, dalla lunghezza della risposta richiesta e dai limiti del proprio account.
I pesi aperti: la promessa c'è, la prova ancora no#
Qwen vuole fare di questo il primo modello Max con i pesi pubblici. Al momento dell'annuncio, però, sui repository indicati i file non c'erano. Mancano quindi le informazioni che servono per giudicare quanto sarà davvero aperto:
la licenza e le condizioni per l'uso commerciale;
i formati e le dimensioni dei file;
i requisiti hardware e le precisioni numeriche supportate.
Ricordo anche che "pesi aperti" e "open source" non sono sinonimi: sarà la licenza a dire cosa si può fare.
E anche quando i file arriveranno, 2,4 trilioni di parametri non girano su una workstation normale. Attivarne 95 miliardi per token costa meno rispetto a un modello denso della stessa taglia, ma distribuirlo e farlo rispondere richiederà infrastrutture specializzate o una quantizzazione molto spinta. Chi deve tenere i dati in casa oggi fa meglio a guardare modelli più piccoli, come spiego nella guida all'AI locale in azienda. Fino al rilascio, Qwen3.8-Max è un servizio via API con dei pesi promessi, non un modello scaricabile.
La reazione della Borsa#
Secondo Investing.com, alle 04:58 italiane del 3 agosto il titolo Alibaba alla Borsa di Hong Kong (HK:9988) guadagnava circa il 6%, a 124 dollari di Hong Kong. Il lancio si inserisce nella corsa che vede Alibaba contro DeepSeek, Baidu e Tencent in Cina, e contro i grandi laboratori americani.
Va letto per quello che è: una fotografia del mercato in un momento preciso. Non dimostra che il rialzo dipenda solo da Qwen3.8-Max, non dice nulla sull'andamento futuro del titolo e non è un'indicazione d'investimento.
Cosa significa per un'azienda#
Per una PMI italiana il numero dei parametri conta poco. Contano tre cose: quanto costa, quanto regge un lavoro lungo e quanto è facile provarlo senza rifare tutto. Su questi punti Qwen3.8-Max ha argomenti seri:
il prezzo permette di sperimentare su volumi veri, per esempio la lettura di molti contratti o documenti tecnici;
la compatibilità con OpenAI e Anthropic vuol dire che chi usa già Claude Code, Codex o un proprio agente può metterlo alla prova cambiando poche righe di configurazione;
i casi lunghi (dieci giorni di sviluppo, cinque giorni su un paper) sono il terreno degli agenti AI, dove i modelli di solito si perdono.
Le domande da farsi prima di adottarlo restano quelle di sempre: dove vengono trattati i dati, cosa prevede il contratto di QwenCloud, quale licenza avranno i pesi, chi controlla il lavoro dell'agente prima che arrivi a un cliente.
Il mio parere#
Qwen3.8-Max è un lancio da prendere sul serio. Mette insieme scala, un prezzo molto competitivo, un contesto lungo e una quantità di prove agentiche che non si vede spesso. I casi da cinque o sedici giorni mi interessano più delle demo da pochi minuti, e il fatto che ci siano un repository, dei video e una descrizione dei metodi permette almeno una verifica parziale.
Il limite è altrettanto evidente: quasi tutto quello che sappiamo l'ha scritto Qwen. Diverse suite di test sono interne, gli harness non sono gli stessi per tutti i modelli e dei pesi, per ora, c'è solo l'annuncio. Cambierò idea in meglio quando ci saranno una licenza, i file e qualche valutazione indipendente: solo allora si potranno misurare i costi veri, la riproducibilità dei risultati e il comportamento del modello fuori dalla piattaforma di Alibaba.
Nel frattempo, se usate già un modello per un compito preciso, il modo giusto di valutarlo è un confronto sul campo: poche attività vere, eseguite dal modello attuale e da Qwen3.8-Max, misurando qualità, costo, tempi e quante volte una persona deve correggere. Se volete impostare questa prova sui vostri documenti, possiamo farlo insieme.
Domande frequenti#
Qwen3.8-Max è già open source?
No. Al 3 agosto 2026 i pesi erano solo annunciati per la settimana successiva e non c'erano file sui repository pubblici. Inoltre pesi aperti e open source non sono la stessa cosa: bisognerà leggere la licenza.
Quanto costa usarlo?
Sul listino di QwenCloud: 2 dollari ogni milione di token in ingresso, 6 dollari ogni milione in uscita. Promozioni, regioni e funzioni accessorie possono cambiare il costo finale.
Quanto è grande la finestra di contesto?
QwenCloud dichiara fino a un milione di token. Quanti se ne possono usare davvero dipende dall'endpoint, dal client, dalla risposta richiesta e dai limiti dell'account.
È migliore di GPT-5.6 Sol e dei modelli Claude?
Dipende dal test. Nei dati di Qwen vince su PaperBench, IFBench, WideSearch, OSWorld-Verified e su diversi test visivi, ma perde su HLE, su SWE-bench Pro rispetto a Fable 5 e su TerminalBench rispetto a GPT-5.6 Sol. Nessun punteggio lo rende il migliore in ogni situazione.
Si può usare dentro Claude Code o Codex?
Sì. QwenCloud parla sia il protocollo di OpenAI sia quello di Anthropic, e mette a disposizione configurazioni pronte per Claude Code e Codex. Servono una chiave QwenCloud, l'indirizzo base corretto e il nome del modello, qwen3.8-max.
Il mio verdetto
Un lancio ambizioso, tutto puntato sul lavoro degli agenti, con prezzo e contesto dichiarati davvero competitivi. Il giudizio però resta prudente: pesi e licenza non sono ancora pubblici e buona parte delle valutazioni arriva dal produttore stesso.
Cosa mi convince
- Mixture of Experts da 2,4 trilioni di parametri, con 95 miliardi attivi per token
- Contesto dichiarato di un milione di token
- Prezzo competitivo su QwenCloud: 2 $ in ingresso e 6 $ in uscita per milione di token
- Cinque demo su lavori lunghi, in parte verificabili
- API compatibili sia con il protocollo di OpenAI sia con quello di Anthropic
- Primo nei test di Qwen su PaperBench, IFBench, WideSearch e OSWorld-Verified
Cosa non mi convince
- Pesi non ancora pubblicati al momento del lancio
- Licenza dei pesi ancora sconosciuta
- Molti benchmark e casi sono prodotti internamente da Qwen
- Harness e condizioni di prova non uguali per tutti i concorrenti
- Con 2,4 trilioni di parametri serve una grande infrastruttura per eseguirlo in proprio
- Nessuna valutazione indipendente completa il giorno del lancio
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
7- 1.
- 2.
- 3.QwenCloud Docs — la prima chiamata APIdocs.qwencloud.com
- 4.
- 5.
- 6.Tianchi — WWW2025 Multimodal Dialogue Intent Recognition Challengetianchi.aliyun.com
- 7.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.