Cosa dichiara Google sul modello, con i benchmark letti dai grafici ufficiali
Google presenta Gemini 4 Argon, con un limite di 1 milione di token in output e un prezzo introduttivo di 2 dollari per milione di token in input. Per ora il modello è riservato a difensori informatici fidati; i benchmark sono dichiarazioni del produttore.
di Andrea Pirazzini
Fonte primaria
Google DeepMind — Gemini 4 Argon: our next era of frontier intelligence
blog.google
Giulio
Il Narratore · 2 min 10 s
Articolo redatto da un sistema di AI a partire da fonti ufficiali: Google DeepMind — Gemini 4 Argon: our next era of frontier intelligence.
Perché se ne parla#
Il 30 settembre 2026 Google ha annunciato Gemini 4 Argon, il suo nuovo modello di frontiera. A presentarlo è stato Koray Kavukcuoglu, SVP di Google DeepMind e Chief AI Architect di Google. Per ora il modello è in distribuzione a un gruppo selezionato di difensori informatici fidati, attraverso il Fairwind Program.
Google lo presenta per lavori complessi e di lungo periodo: sviluppo software, lavoro di conoscenza in ambiti come legale e finanza, e difesa informatica. Le prestazioni citate nell'annuncio sono dichiarazioni del produttore, che le riporta come tali.
Il rilascio avviene per fasi. Google partecipa al processo volontario del governo degli Stati Uniti per l'accesso ai modelli prima della pubblicazione e intende raccogliere il riscontro dei primi tester prima di ampliare l'accesso.
Cosa cambia nel lavoro interno di Google#
Google descrive tre ambiti in cui i propri team interni usano già Gemini 4 Argon. Le cifre seguenti sono risultati interni riportati da Google, non verificati da fonti indipendenti.
Ottimizzazione quantistica: per le subroutine che rallentano le applicazioni dei ricercatori di calcolo quantistico, Argon ha ridotto del 40% le risorse spaziotemporali (qubit × porte) rispetto alla baseline pubblicata, in pochi minuti in un esempio.
Efficienza di memoria: agenti Argon hanno analizzato la telemetria di profiling dei data center di Google e applicato ottimizzazioni che, una volta distribuite, liberano oltre 300 TiB, con una stima di 500 TiB–1 PiB di risparmio complessivo.
Migrazione da C/C++ a Rust: per libgav1, il decoder video open source di Google, gli agenti hanno sostituito 32K righe di codice SIMD. Il decoder risultante, con memoria sicura, è 2,7 volte più veloce del port Rust e produce lo stesso output video.
Ragionare su compiti lunghi: il limite di output#
Il limite di output di Gemini 4 Argon passa da 64K a 1 milione di token. Google collega questo aumento alla possibilità del modello di generare centinaia di migliaia di token in una sola traiettoria di ragionamento, cioè in un unico percorso continuo di elaborazione.
Per voi professionisti il vantaggio è pratico: un problema complesso può essere affrontato in un'unica esecuzione, invece di essere spezzato in più richieste successive che poi dovete ricomporre a mano. Il modello ha più spazio per ragionare in profondità e per produrre un risultato completo in una volta sola.
Token: unità di testo elaborata dal modello, spesso un frammento di parola.
Limite di output: quantità massima di token che il modello può generare in risposta.
Traiettoria di ragionamento: sequenza continua di passaggi con cui il modello arriva alla risposta.
Long-horizon: compiti lunghi, formati da più passaggi collegati tra loro.
Coding, finanza e legale: i benchmark dichiarati#
Coding e lavoro su codice#
Google dichiara che Gemini 4 Argon raggiunge lo stato dell'arte su DeepSWE v1.1 con il 77,9%, un test che misura le prestazioni su attività di ingegneria del software svolte su orizzonti lunghi. Per AutomationBench, il benchmark di Zapier sull'esecuzione end-to-end di funzioni aziendali, il produttore indica il primo posto con il 51,3%.
Finanza e diritto#
Secondo Google, Argon è il modello in testa al Vals Index, che misura l'impatto economico su finanza, coding, legale e fiscale, pesando ogni settore in base al contributo al PIL statunitense. Il produttore dichiara prestazioni di vertice anche su Vals Finance Agent v2, dedicato alla ricerca finanziaria in più passaggi, e su Harvey's Legal Agent Benchmark, dedicato a ricerca e redazione giuridica. Per questi tre test il testo non riporta punteggi.
DeepSWE v1.1
Stato dell'arte secondo Google
AutomationBench (Zapier)
Primo posto secondo Google
LVBench
Stato dell'arte secondo Google
Difesa informatica: CWE-bench v1#
Nel leaderboard di CWE-bench v1, che misura la capacità di un modello di correggere vulnerabilità di sicurezza, Gemini 4 Argon ottiene il 68% di Pass@1, a pari merito con Grok 4.7 e GPT-6 Astra. Seguono Claude Opus 5.5 al 67% e Claude Fable 5.1 al 58%. Il valore più basso è quello di Inkling, al 37%. Quando due modelli hanno lo stesso Pass@1, la posizione dipende dal Pass@4.
CWE-bench v1: Pass@1 per modello
Pass@1, a parità risolta da Pass@4. Più alto è meglio
Fonte: Google DeepMind, valori letti dal grafico ufficiale
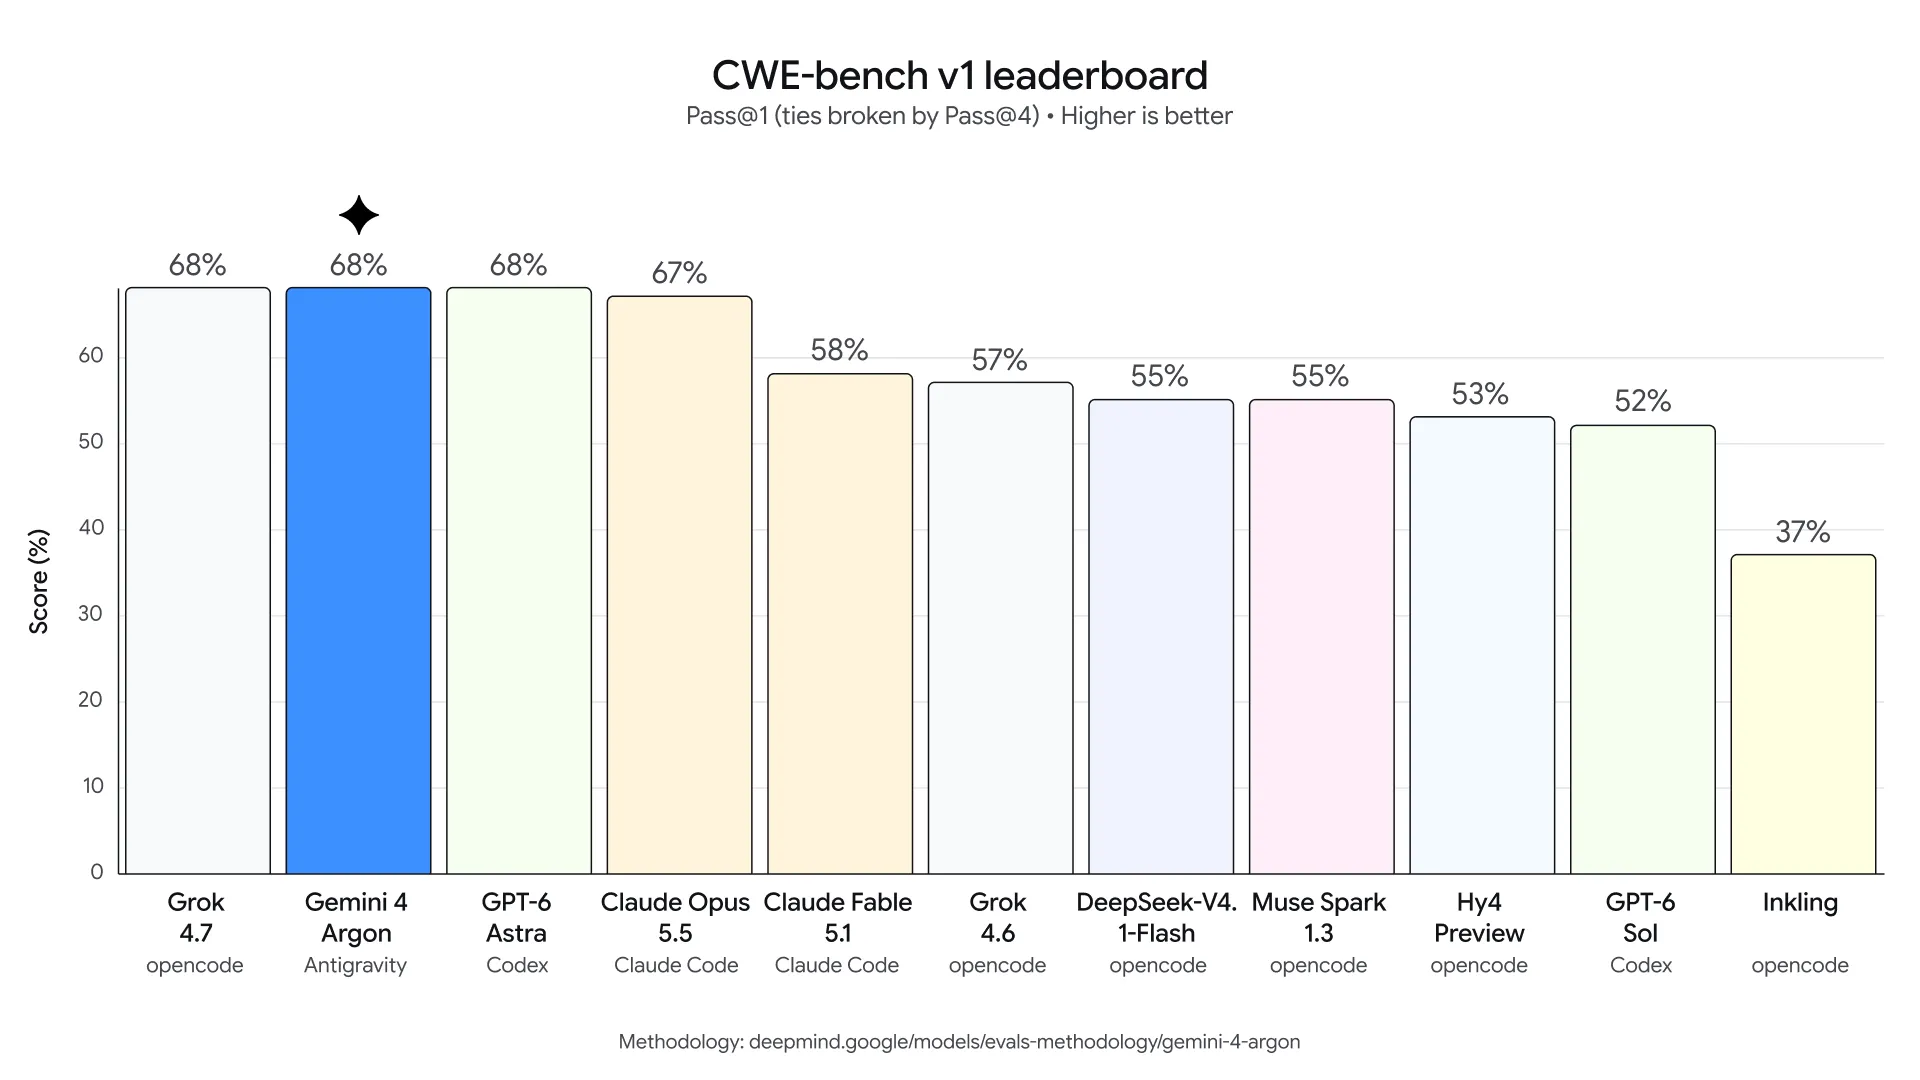
La metodologia del test è pubblicata da Google, che dichiara il punteggio come proprio dato, come indicato nel post di lancio. Questi risultati sono quindi dichiarazioni del produttore, da leggere come tali.
Google scrive che Argon si basa sulle prestazioni di 3.8 Flash Cyber su CWE-bench v0. Per CWE-bench v1 la fonte non riporta il punteggio di 3.8 Flash Cyber, quindi in questa sezione non è possibile un confronto diretto con quel modello.
Scoprire vulnerabilità e test di penetrazione#
Nei due benchmark interni di Google e Wiz, Gemini 4 Argon ottiene 85,8% contro 71% di Gemini 3.8 Flash Cyber nella scoperta di vulnerabilità su codice sorgente in 20 linguaggi, e 70,9% contro 58,2% nel test di penetrazione Wiz su sistemi web senza codice sorgente. Non si tratta di benchmark pubblici: la metrica è Pass@1, e il punteggio più alto indica la prestazione migliore.
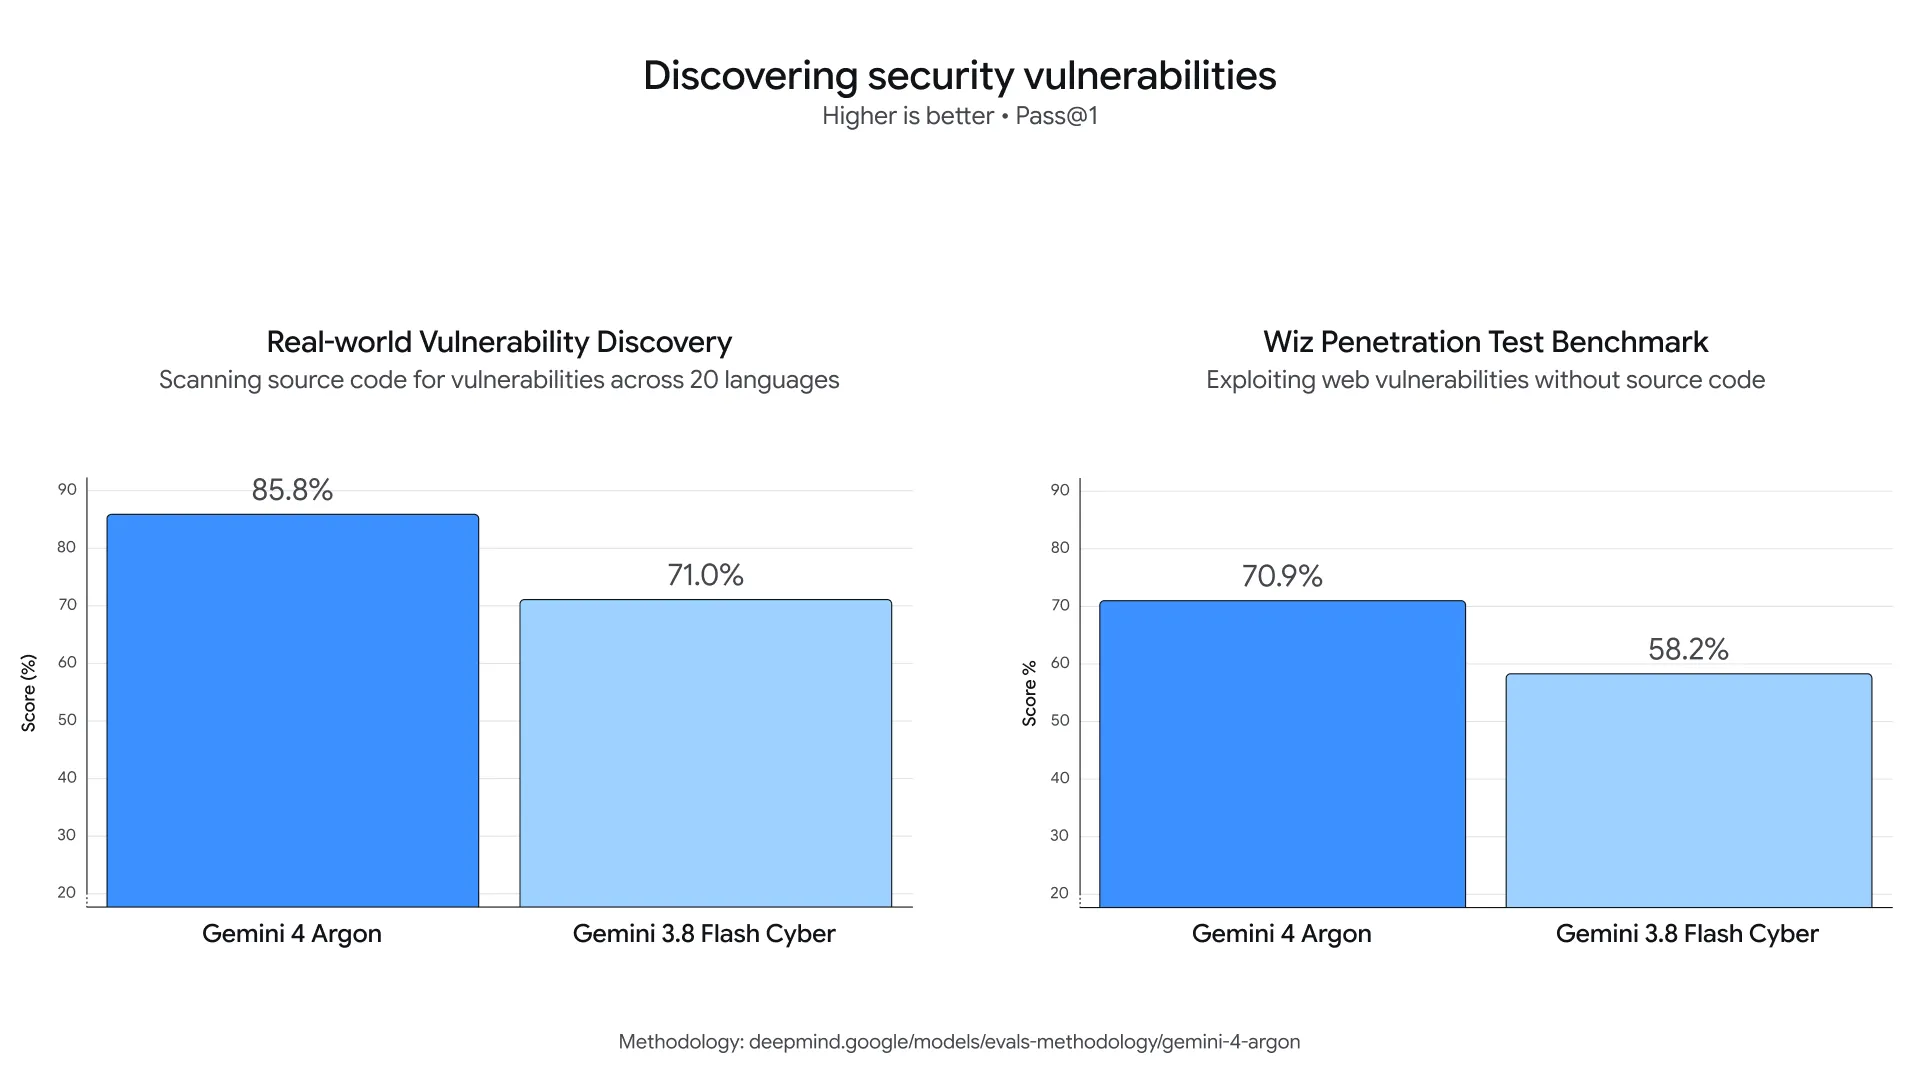
Scoperta di vulnerabilità e test di penetrazione
Pass@1, punteggio più alto migliore. Benchmark interni di Google e Wiz, non pubblici
- Gemini 4 Argon
- Gemini 3.8 Flash Cyber
Fonte: Google DeepMind, valori letti dal grafico ufficiale
Il grafico affianca i due modelli per ciascun test, e in entrambi Argon ha il punteggio più alto. Secondo la fonte, nel test Wiz Argon individua la superficie d'attacco, identifica le vulnerabilità e produce prove di concetto per validarle. Per un confronto con altri modelli orientati alla cybersicurezza, vedi OpenAI Daybreak e GPT-5.6-Cyber; la fonte ufficiale è Gemini 4 Argon: our next era of frontier intelligence.
Prompt injection: il benchmark Gray Swan IPI#
Google dichiara che Gemini 4 Argon è il suo modello più resistente finora agli attacchi di prompt injection indiretta, cioè istruzioni malevole nascoste in documenti o pagine web che dirottano il comportamento dell'AI. Il benchmark Gray Swan IPI misura la percentuale di attacchi riusciti. Nelle barre impilate, i tre livelli mostrano i tassi per k=1, k=10 e k=15 tentativi, mentre il numero sopra ogni barra indica il valore a k=15 (documento Google).
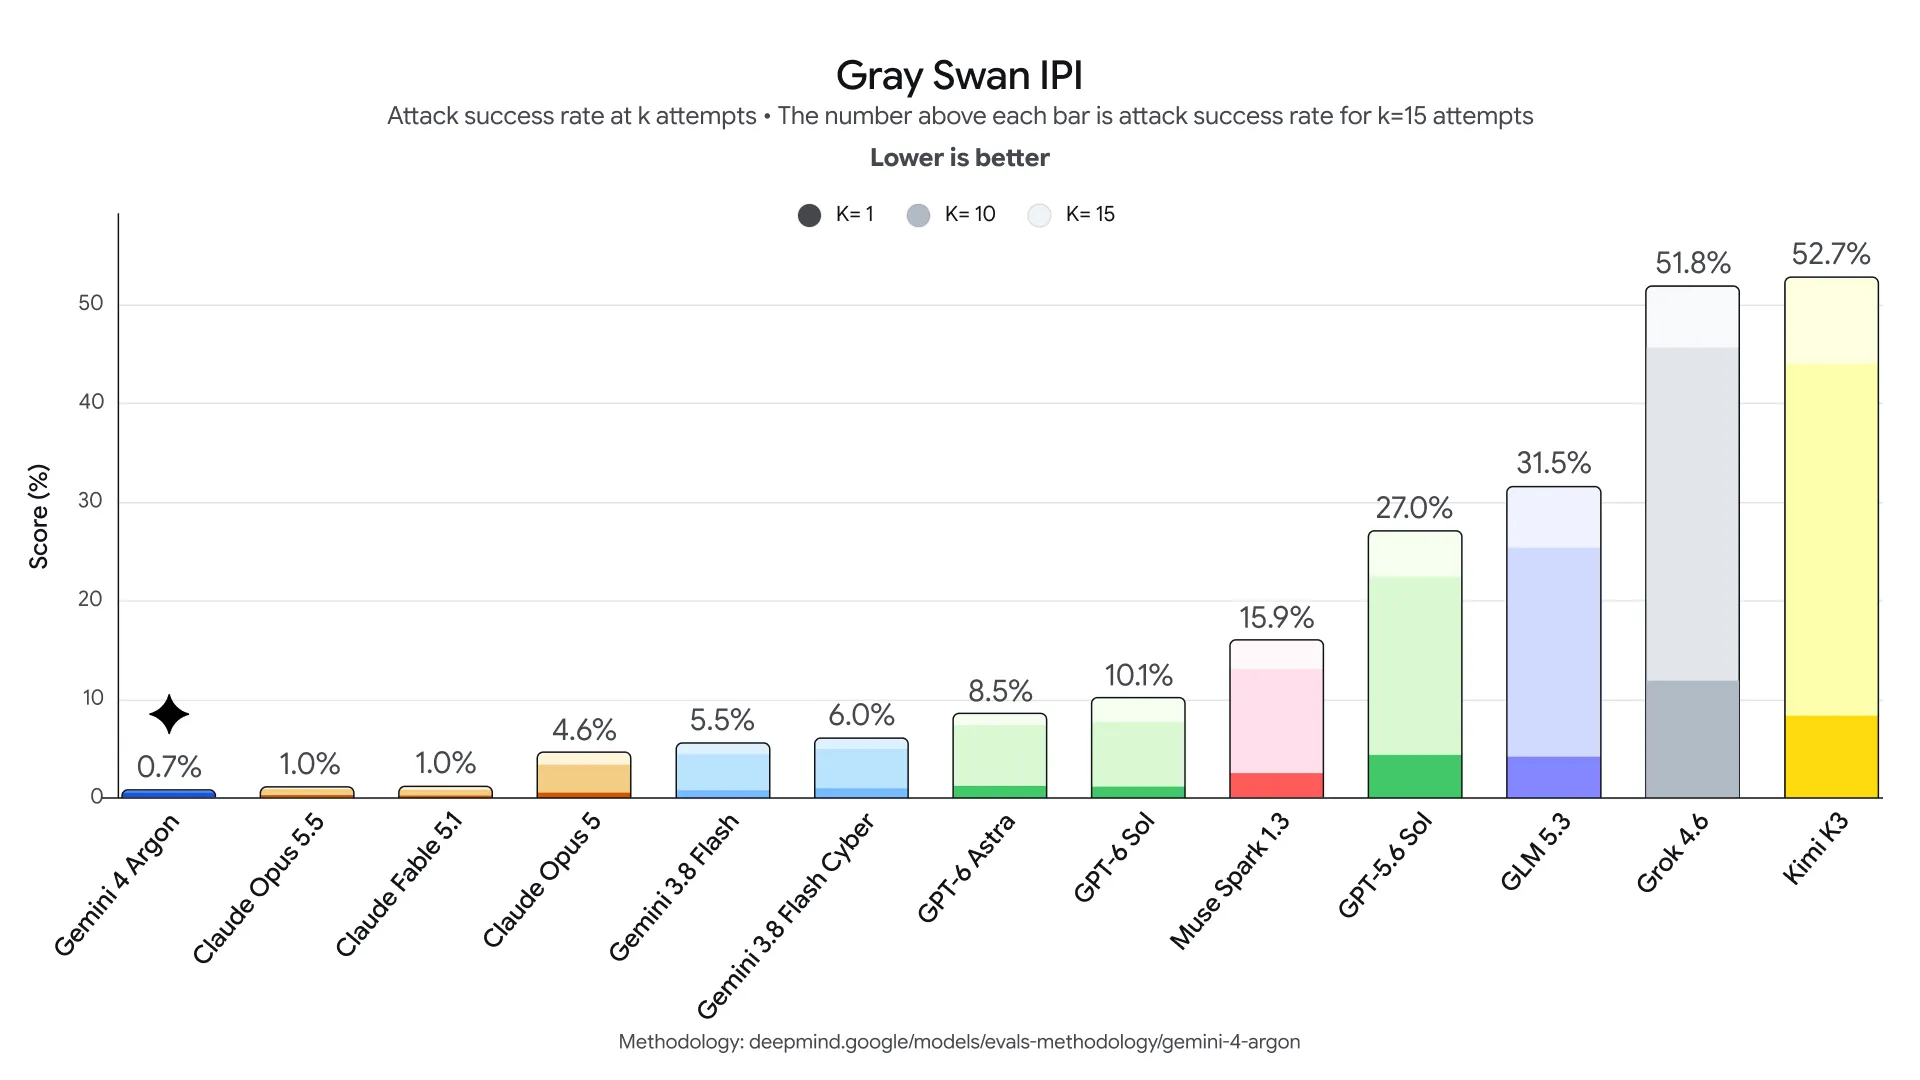
Gray Swan IPI: tasso di successo degli attacchi a k=15
Più basso è meglio
Fonte: Google DeepMind, valori letti dal grafico ufficiale
Nel grafico Gemini 4 Argon si ferma a 0,7%, seguito da Claude Opus 5.5 e Claude Fable 5.1 a 1,0%. All'estremo opposto, Grok 4.6 arriva a 51,8% e Kimi K3 a 52,7%. Sono dati dichiarati dai produttori sui propri modelli e su quelli concorrenti, da leggere come tali, come nelle schede dei modelli Claude Opus 5.5 e GPT-6 Astra.
Le salvaguardie prima del rilascio#
Le quattro aree di intervento#
Google dichiara di rafforzare le salvaguardie su quattro fronti. Uso improprio: il modello deve rifiutare richieste legate a attacchi informatici o ad armi CBRN, pur sostenendo la ricerca a duplice uso. Le protezioni sono state testate da team interni ed esterni di red teaming.
Prompt injection: secondo Google, Argon è il suo modello più resistente finora a istruzioni malevole nascoste in documenti o dati. Il primato sul benchmark Gray Swan IPI è un dato dichiarato dal produttore.
Disallineamento: sistemi di mitigazione controllano catena di pensiero e azioni e bloccano l'esecuzione quando serve. Gli stessi controlli monitorano i training run e avvisano un team di risposta agli incidenti. I risultati non tornano nell'addestramento, per non insegnare al modello a eludere il monitoraggio.
Sandbox: prima di addestramenti o valutazioni ad alto rischio, gli ambienti vengono isolati e sigillati.
Il quadro di riferimento#
Il Frontier Safety Framework di Google DeepMind, alla terza versione, introduce una Critical Capability Level sulla manipolazione dannosa. Dal 17 aprile 2026 aggiunge le Tracked Capability Levels, soglie di allerta precoce per rischi meno estremi.
Piccolo glossario#
Red teaming: test che cercano di aggirare le protezioni.
Catena di pensiero: i passaggi di ragionamento prima della risposta.
CBRN: armi chimiche, biologiche, radiologiche e nucleari.
CCL: livello di capacità che segnala un rischio severo.
Prezzi e disponibilità#
Google indica un prezzo introduttivo per Gemini 4 Argon: 2 dollari per milione di token in input e 10 dollari per milione di token in output. I token in input memorizzati in cache sono scontati del 95% rispetto al prezzo di input.
Fasi di disponibilità#
Difensori di cybersicurezza fidati, attraverso il Fairwind Program, dove Argon è in fase di rilascio.
Clienti API a pagamento e abbonati Google AI Ultra, che Google indica come i destinatari successivi.
La fonte non fissa una data per la seconda fase. Il prezzo è introduttivo e può cambiare al lancio generale.
Come leggere questi numeri#
Chi dichiara i punteggi#
I punteggi citati nel annuncio Google sono dichiarati dall'azienda stessa. Sono misurati in test scelti da Google, e la metodologia è riportata su deepmind.google. Il comunicato non riporta verifiche di terze parti. Alcuni test, come quelli interni a Google o a Wiz, non sono descritti in dettaglio e non possono essere riprodotti da terzi.
Termini ricorrenti#
Pass@1 e Pass@4: misurano la percentuale di problemi risolti al primo tentativo, oppure in almeno uno di quattro tentativi. Il comunicato non specifica quale variante sia usata per i punteggi citati.
Pari merito: quando Argon «ties for first place» nel CWE-bench, condivide il primo posto con un altro modello, con lo stesso punteggio.
Più basso è meglio: per il benchmark Gray Swan IPI, sulla resistenza agli attacchi di prompt injection, il risultato migliore è il punteggio più basso. Per gli altri test vale il contrario.
Token: unità di testo che il modello legge e scrive. Il limite di 1 milione indica quanto testo può gestire in una sola elaborazione.
Chain-of-thought: il ragionamento intermedio del modello prima della risposta finale.
Prompt injection: istruzioni malevole nascoste in testi o dati, che tentano di dirottare il comportamento del modello.
Red teaming: test in cui team interni o esterni cercano di far fallire il modello.
SIMD: istruzioni del processore che elaborano più dati in parallelo.
Cosa significa per un'azienda#
Verificate se il vostro caso d'uso rientra in coding, documenti legali o finanza prima di valutare Argon. Sono gli ambiti in cui Google dichiara prestazioni al vertice nei propri test, come il 77,9% su DeepSWE v1.1 e il primo posto nel Vals Index: si tratta di dati del produttore, non di verifiche indipendenti. Per confrontare i fornitori potete partire da come scegliere a chi affidare un progetto di intelligenza artificiale.
Chiedete l'accesso anticipato solo se siete tra i difensori fidati del Fairwind Program, che è il gruppo a cui Argon è in distribuzione in questa fase. Per le altre aziende, Google indica come primi destinatari del rilascio i clienti API a pagamento e gli abbonati Google AI Ultra, senza una data precisa.
Confrontate il prezzo introduttivo con altri modelli. Argon costa 2 dollari per milione di token di input e 10 dollari per milione di token di output, con i token in cache scontati del 95%. Il prezzo è dichiarato come introduttivo: prima di decidere, mettetelo a confronto con le schede di GPT-6 Astra e Claude Opus 5.5, anche sui costi reali del vostro flusso di lavoro.
Affrontate la sicurezza informatica solo con un fornitore e un processo chiari. Google dichiara che Argon può trovare, validare e correggere vulnerabilità in modo autonomo, ma verrà rilasciato senza protezioni cyber per i difensori fidati. Definite prima chi risponde dei risultati, quali controlli applicare e come verificare le correzioni proposte.
Domande frequenti#
Quando sarà disponibile per tutti?
La fonte non indica una data. Google parla di un rilascio per fasi: dopo i test con i difensori informatici selezionati, l'accesso partirà dai clienti API a pagamento e dagli abbonati Google AI Ultra. Il prezzo introduttivo è di 2 dollari per milione di token di input e 10 dollari per milione di token di output.
Posso già usare Gemini 4 Argon?
Non per il pubblico. Oggi Argon è distribuito a un gruppo ristretto di difensori informatici di fiducia attraverso il Fairwind Program.
Che cosa significa un punteggio di benchmark dichiarato dal produttore?
Un benchmark è un test standard che misura una capacità specifica. Il punteggio, come il 77,9% su DeepSWE v1.1 per l'ingegneria del software, è riportato da Google: si tratta di una sua dichiarazione. Per confrontarlo con altri modelli servono test identici, e ogni test misura un compito preciso, non il valore complessivo del modello per la vostra azienda.
Qual è la differenza tra l'output di 1 milione di token e il contesto?
Il limite di 1 milione di token citato nella fonte riguarda l'output: il limite precedente era di 64mila token. Con più margine, il modello può generare centinaia di migliaia di token in un'unica traiettoria di lavoro. La fonte non indica una cifra separata per il contesto in ingresso, quindi non è possibile confrontare i due valori.
Come è stato calcolato il voto#
Il voto della valutazione è la media di questi criteri, ciascuno motivato con un fatto delle fonti ufficiali.
Criterio | Voto | Motivo |
|---|---|---|
Prestazioni dichiarate | 7/10 | Google dichiara il 77,9% su DeepSWE v1.1 e un primo posto su AutomationBench con 51,3%, ma le fonti non riportano verifiche indipendenti di questi valori. |
Sicurezza informatica | 7,5/10 | Su CWE-bench v1 il modello ottiene 68%, ex aequo con Grok 4.7 e GPT-6 Astra, e sui test di scoperta vulnerabilità supera 3.8 Flash Cyber (85,8% contro 71% e 70,9% contro 58,2%), con valori letti da grafici ufficiali. |
Prezzo e disponibilità | 5/10 | Il prezzo introduttivo è di 2 dollari per milione di token in input e 10 dollari in output, ma il modello è oggi accessibile solo a un gruppo ristretto tramite il Fairwind Program e la data di apertura generale non è fissata. |
Robustezza ai attacchi di prompt… | 7/10 | Nel benchmark Gray Swan IPI con k=15 Argon registra 0,7%, contro l'1% di Claude Opus 5.5 e Claude Fable 5.1, dato riportato da un grafico ufficiale. |
Apertura e trasparenza | 3/10 | Le fonti non indicano licenza, condizioni d'uso né prezzi dei modelli concorrenti per un confronto diretto. |
Valutazione
Redatta da un sistema di AI sui dati ufficiali delle fonti.
Gemini 4 Argon: i dati ufficiali di Google indicano risultati forti in codice e cybersicurezza, ma l'accesso è oggi limitato e il prezzo è introduttivo.
Per chi deve decidere, i dati ufficiali mostrano prestazioni competitive soprattutto in codice e sicurezza informatica, con alcuni risultati confermati su grafici pubblici. I numeri su DeepSWE e sugli altri benchmark sono però dichiarati dal produttore e non verificati da terzi nelle fonti. Il modello non è oggi disponibile per un uso generalizzato, e il prezzo è introduttivo e privo di confronti; una valutazione operativa richiede di attendere la disponibilità generale e test indipendenti.
Punti di forza
- Limite di output dichiarato di 1 milione di token, contro i 64K del modello precedente.
- Primo posto ex aequo su CWE-bench v1 con il 68%, secondo il grafico ufficiale.
- Risultati superiori a 3.8 Flash Cyber nei test di scoperta di vulnerabilità riportati da Google e Wiz.
- Tasso di successo molto basso negli attacchi di prompt injection indiretta nel benchmark Gray Swan.
Limiti
- Molti risultati, incluso il 77,9% su DeepSWE v1.1, sono dichiarati dal produttore e non verificati da terzi nelle fonti.
- Le fonti non indicano prezzi di confronto con modelli concorrenti, quindi il rapporto costo-prestazioni non è valutabile.
- Accesso limitato a un gruppo ristretto di difensori tramite il Fairwind Program, senza data di disponibilità generale.
- La versione per i difensori è rilasciata senza cyber guardrail, una scelta che richiede controllo sull'uso.
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
2- 1.Google DeepMind — Gemini 4 Argon: our next era of frontier intelligenceblog.google
Annuncio ufficiale da cui nasce l’articolo.
- 2.Google DeepMind — Google DeepMind strengthens the Frontier Safety Frameworkdeepmind.google
Documento ufficiale collegato all’annuncio.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.