Stesso modello di base di GLM-5.2, molto più allenamento dopo. Cosa dicono i benchmark, come si usa con Claude Code e Cline, quanto costa il Coding Plan e cosa mancava ancora al lancio.
GLM-5.3 di Z.ai: benchmark di coding e sicurezza, contesto da 1 milione di token, ragionamento sempre attivo, Coding Plan da 18 $ e cosa mancava al lancio.
di Andrea Pirazzini
Fonte primaria
Z.ai — annuncio di GLM-5.3, con grafici e note metodologiche
z.ai
Versione audio
2 min 44 s
Perché se ne parla#
Il 14 agosto 2026 Z.ai ha presentato GLM-5.3, e la notizia più interessante è quello che non è cambiato. Il modello di base è lo stesso di GLM-5.2. Tutto il salto in avanti, secondo il produttore, arriva dalla fase successiva: il post-training.
Per capirci: il modello di base è come uno studente che ha letto un'intera biblioteca. Il post-training è il tirocinio in cui impara a fare un mestiere preciso, provando e riprovando su compiti veri e ricevendo un voto ogni volta. Z.ai dice di aver allargato proprio questo tirocinio: più ambienti di lavoro, compiti più vari e più potenza di calcolo per il reinforcement learning (l'apprendimento per prove ed errori) su attività lunghe e il cui risultato si può verificare.
Ne esce un modello pensato per tre cose: programmazione affidata a un agente, compiti in molti passaggi e sicurezza informatica. Può tenere in memoria fino a un milione di token in una volta, scrivere risposte fino a 128.000 token e ragionare su tre livelli di intensità.
Al lancio, però, la disponibilità è a metà. Si può usare subito dentro il GLM Coding Plan, l'abbonamento per programmatori. L'API a consumo e il suo listino non ci sono ancora. I pesi del modello sono promessi due settimane dopo il lancio, una volta finiti i controlli di sicurezza e il lavoro di irrobustimento.
token di contesto, con il suffisso [1m] nel Coding Plan
token massimi per una singola risposta
vulnerabilità dichiarate in 269 progetti, 1.097 di gravità medio-alta
al mese: il prezzo di partenza del GLM Coding Plan
La scheda, in una tabella#
Voce | Cosa dice Z.ai | Cosa vuol dire in pratica |
|---|---|---|
Nome del modello |
| È l'identificativo da usare in API e Coding Plan |
Modello di base | Lo stesso di GLM-5.2 | I progressi vengono dal post-training |
Contesto | Fino a 1.000.000 di token | Nel Coding Plan si attiva con il suffisso |
Risposta massima | 128K token | Utile per lavori lunghi; costi e tempi vanno misurati |
Ragionamento | Sempre attivo | Tre livelli: |
Dove si usa al lancio | GLM Coding Plan e ZCode | API generale annunciata come "coming soon" |
Pesi | Non ancora pubblicati | Promessi due settimane dopo il lancio |
Cosa legge | Solo testo | Le immagini passano da un MCP separato del Coding Plan |
Cosa cambia rispetto a GLM-5.2#
La scelta di Z.ai è netta: base invariata, post-training potenziato. Il lavoro poggia su tre strumenti già costruiti per la versione precedente:
IndexShare, per gestire i contesti molto lunghi;
SAO, per il reinforcement learning su compiti che durano a lungo;
slime, il framework che fa girare il post-training in modo asincrono.
Gli ambienti di allenamento non sono semplici esercizi di programmazione. Z.ai li descrive come giornate di lavoro di un ingegnere: accesso a repository, documentazione, archivi, cluster e risultati di esperimenti; capire qual è il problema; modificare il codice; lanciare i test; consegnare un risultato che si può misurare.
La catena che li produce è a sua volta automatizzata. Degli agenti di ricerca costruiscono gli ambienti, un "giudice" prova a risolverli, e i sistemi che assegnano il voto vengono controllati per evitare scorciatoie e compiti dati per risolti quando non lo sono. Z.ai ammette comunque che tutto questo richiede ancora parecchio lavoro umano.
I benchmark: un salto netto, ma non primo ovunque#
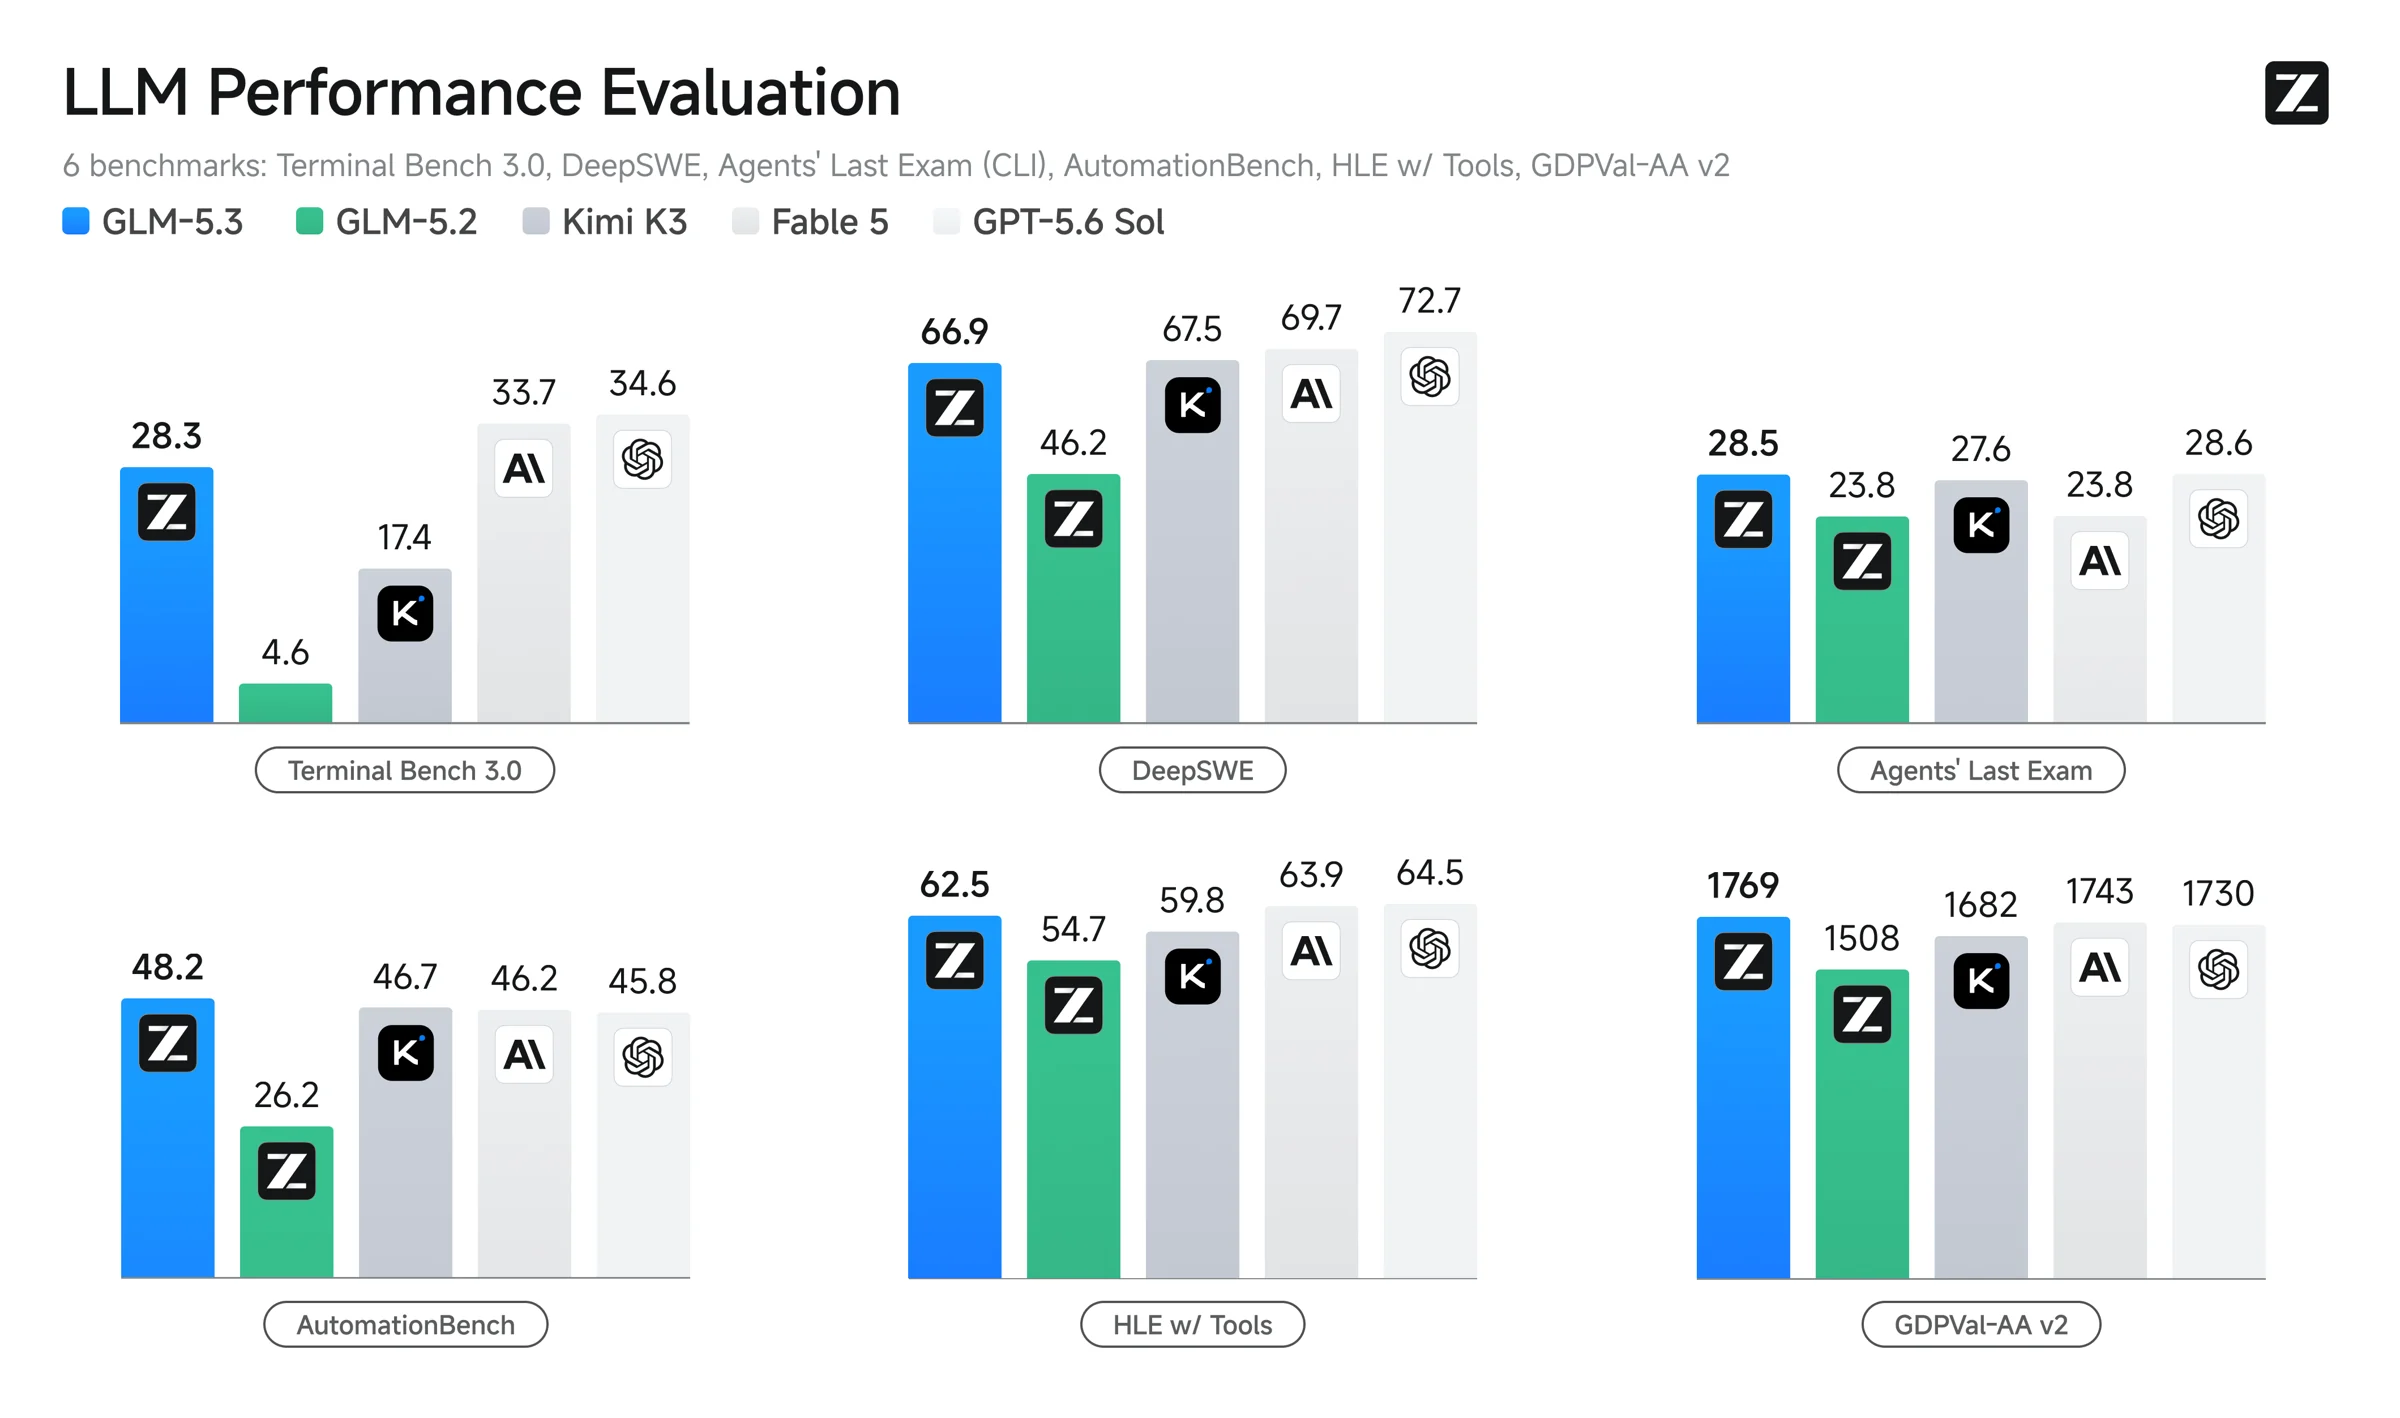
Rispetto a GLM-5.2 i miglioramenti sono evidenti. Il confronto con gli altri modelli, però, è meno trionfale di quanto farebbe pensare uno slogan da "stato dell'arte".
GLM-5.3 contro GLM-5.2
Punteggi nei benchmark di coding e agenti
- GLM-5.3
- GLM-5.2
Fonte: dichiarato da Z.ai, agosto 2026
Il caso più istruttivo è Terminal-Bench 3.0, che misura quanto un agente se la cava lavorando nel terminale: GLM-5.3 moltiplica per sei il punteggio del predecessore, ma resta dietro a Fable 5 e a GPT-5.6 Sol. Su DeepSWE v1.1 il punteggio sale da 46,2 a 66,9, e anche qui si piazza alle spalle di Kimi K3, Fable 5 e GPT-5.6 Sol.
Terminal-Bench 3.0
Punteggio, più alto è meglio
Fonte: grafico ufficiale di Z.ai, agosto 2026
Ecco tutti i numeri del grafico ufficiale:
Benchmark | GLM-5.3 | GLM-5.2 | Kimi K3 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
Terminal-Bench 3.0 | 28,3 | 4,6 | 17,4 | 33,7 | 34,6 |
DeepSWE v1.1 | 66,9 | 46,2 | 67,5 | 69,7 | 72,7 |
Agents' Last Exam CLI | 28,5 | 23,8 | 27,6 | 23,8 | 28,6 |
AutomationBench | 48,2 | 26,2 | 46,7 | 46,2 | 45,8 |
HLE con strumenti | 62,5 | 54,7 | 59,8 | 63,9 | 64,5 |
GDPval-AA v2 | 1769 | 1508 | 1682 | 1743 | 1730 |
GLM-5.3 contro i rivali
Punteggi nei benchmark di coding e agenti, più alto è meglio
- GLM-5.3
- Kimi K3
- Fable 5
- GPT-5.6 Sol
Fonte: grafico ufficiale di Z.ai, agosto 2026
Letta con calma, la tabella dice che GLM-5.3 è primo su AutomationBench e su GDPval-AA v2, praticamente alla pari con GPT-5.6 Sol su Agents' Last Exam CLI, e dietro ai modelli chiusi più forti su Terminal-Bench, DeepSWE e HLE. Kimi K3, di cui ho scritto al momento del suo lancio, gli sta davanti solo su DeepSWE.
Z.ai Code Bench: più precisione scrivendo meno#
Z.ai ha anche un benchmark tutto suo, costruito su scenari realistici e ambienti locali complicati, eseguito dentro Claude Code 2.1.207. La particolarità è che mette insieme due misure: quante attività il modello risolve e quanti token scrive per farlo.
Z.ai Code Bench v1.0
Accuratezza e token medi di output per attività
Fonte: benchmark interno di Z.ai, agosto 2026
Il dato che fa notizia è questo: al livello massimo GLM-5.3 risolve il 34,5% delle attività scrivendo circa 75.000 token ciascuna, mentre GLM-5.2 si fermava al 23,4% con circa 96.000. Più risultati con meno testo prodotto, quindi meno costo e meno attesa.
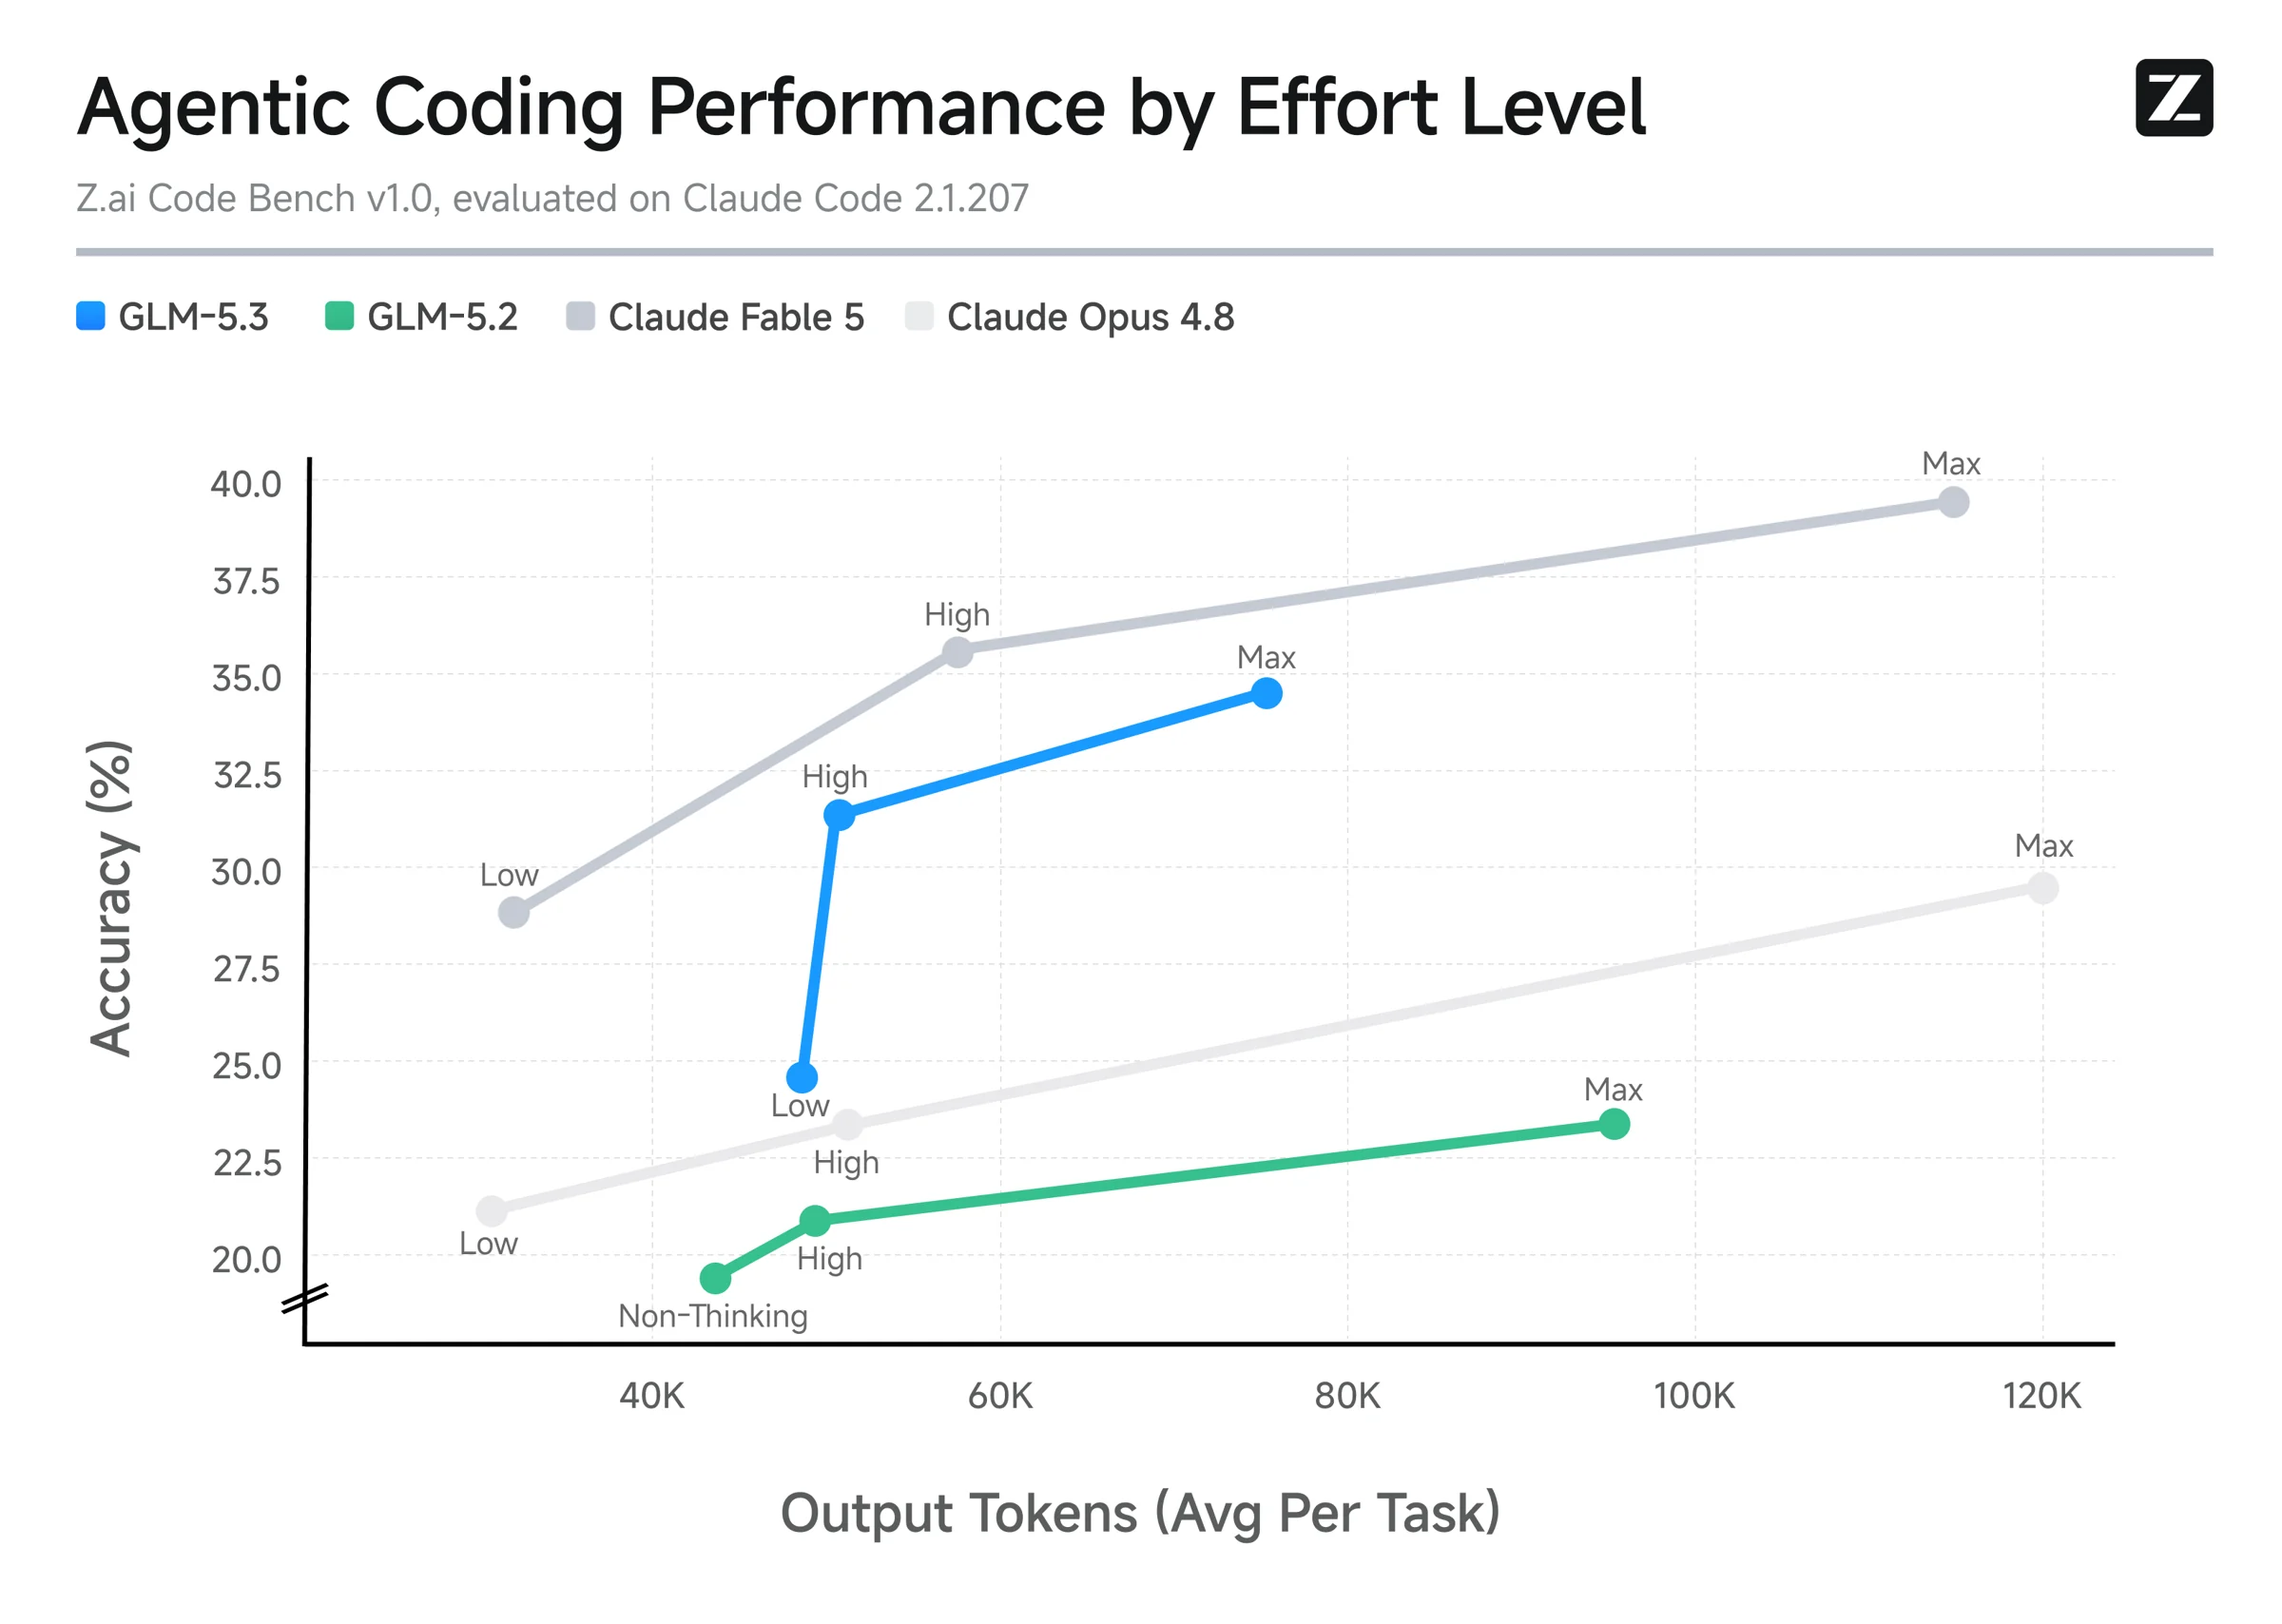
È da qui che nasce la formula "50% di miglioramento": riguarda questo benchmark interno, non la programmazione in generale. E la prudenza è d'obbligo, perché dati, criteri di voto e ambiente di prova sono tutti in mano al produttore. Z.ai sostiene che, essendo privato, il test sia meno esposto alla contaminazione (il rischio che le soluzioni siano finite nei dati di addestramento). È possibile, ma non sostituisce una replica fatta da altri.
Sicurezza informatica: il progresso più delicato#
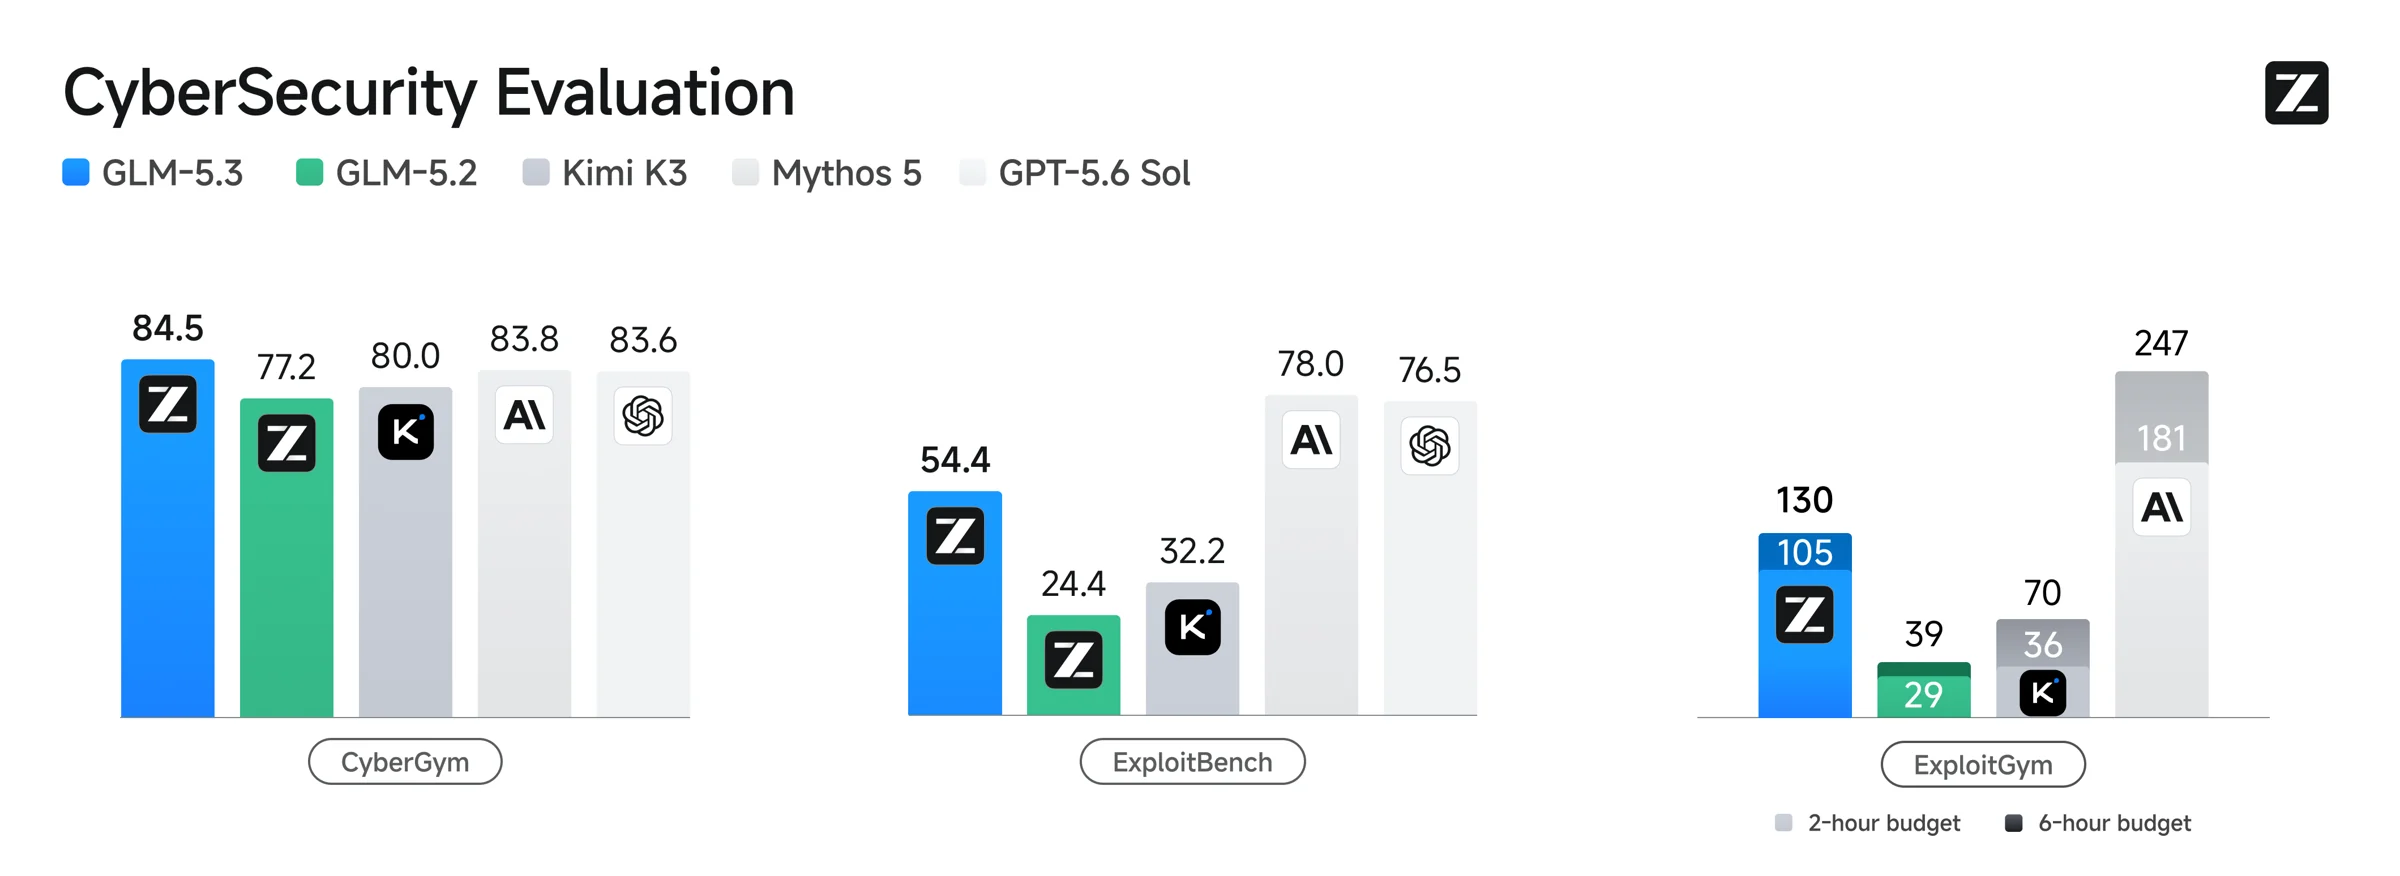
È la parte più sensibile dell'annuncio. Z.ai ha misurato GLM-5.3 su tre prove che salgono di difficoltà lungo la "catena" di un attacco: trovare una vulnerabilità, confermarla, costruire l'exploit che la sfrutta.
Trovare e sfruttare vulnerabilità
Percentuale di successo
- GLM-5.3
- GLM-5.2
- Mythos 5
- GPT-5.6 Sol
Fonte: valutazione di sicurezza pubblicata da Z.ai, agosto 2026
CyberGym fornisce il codice sorgente e chiede di individuare e confermare le vulnerabilità: qui GLM-5.3 è addirittura primo, di un soffio. Su ExploitBench, più vicino alla costruzione vera e propria dell'attacco, più che raddoppia il predecessore ma resta oltre venti punti sotto Mythos 5 e GPT-5.6 Sol.
La terza prova, ExploitGym, conta quante attività vengono portate a termine con un budget di tempo reso comparabile tra modelli diversi:
Budget | GLM-5.3 | GLM-5.2 | Mythos 5 |
|---|---|---|---|
2 ore | 105 | 29 | 181 |
6 ore | 130 | 39 | 247 |
ExploitGym: attività completate
Numero di attività portate a termine entro il budget di tempo
- GLM-5.3
- GLM-5.2
- Mythos 5
Fonte: valutazione di sicurezza pubblicata da Z.ai, agosto 2026
Il quadro che ne esce ha due facce. Più ci si avvicina all'exploit completo, più cresce il vantaggio di GLM-5.3 sul predecessore; ma cresce anche la distanza dai migliori modelli chiusi.
Z.ai racconta poi un risultato sul campo: insieme a team di sicurezza cinesi, dopo revisione, filtraggio ed eliminazione dei doppioni, avrebbe individuato 2.436 vulnerabilità in 269 progetti, di cui 1.097 di gravità medio-alta. È un'affermazione del produttore, non una verifica indipendente. C'è però un registro pubblico, il Security Disclosure Ledger, che permette di seguire almeno la parte entrata nel percorso di segnalazione responsabile.
Ragionamento sempre acceso: attenzione se state migrando#
Con GLM-5.3 il ragionamento non si spegne più. I livelli sono tre:
max, il predefinito, consigliato per programmare;
high, un po' meno intenso;
low, che ragiona comunque, ma in modo leggero.
Chi oggi manda nelle richieste thinking.type impostato a "disabled" deve correggerle prima di cambiare modello. Secondo l'annuncio, nell'API aggiornare solo il nome del modello senza sistemare quel parametro fa fallire la richiesta. Una richiesta valida contiene questi campi:
{
  "reasoning_effort": "max",
  "thinking": { "type": "enabled" },
  "model": "glm-5.3"
}
La guida per gli agenti è più tollerante: Claude Code e Codex convertono valori come disabled, minimal, medium o xhigh in uno dei tre livelli reali. Attenzione però: è un adattamento fatto dal Coding Plan, e nulla garantisce che l'API generale capisca gli stessi valori.
Usarlo in Claude Code con un milione di token#
Z.ai indica un endpoint diverso a seconda dello strumento:
Strumento | Endpoint |
|---|---|
Claude Code e Goose (compatibile Anthropic) |
|
Codex |
|
Altri strumenti compatibili OpenAI |
|
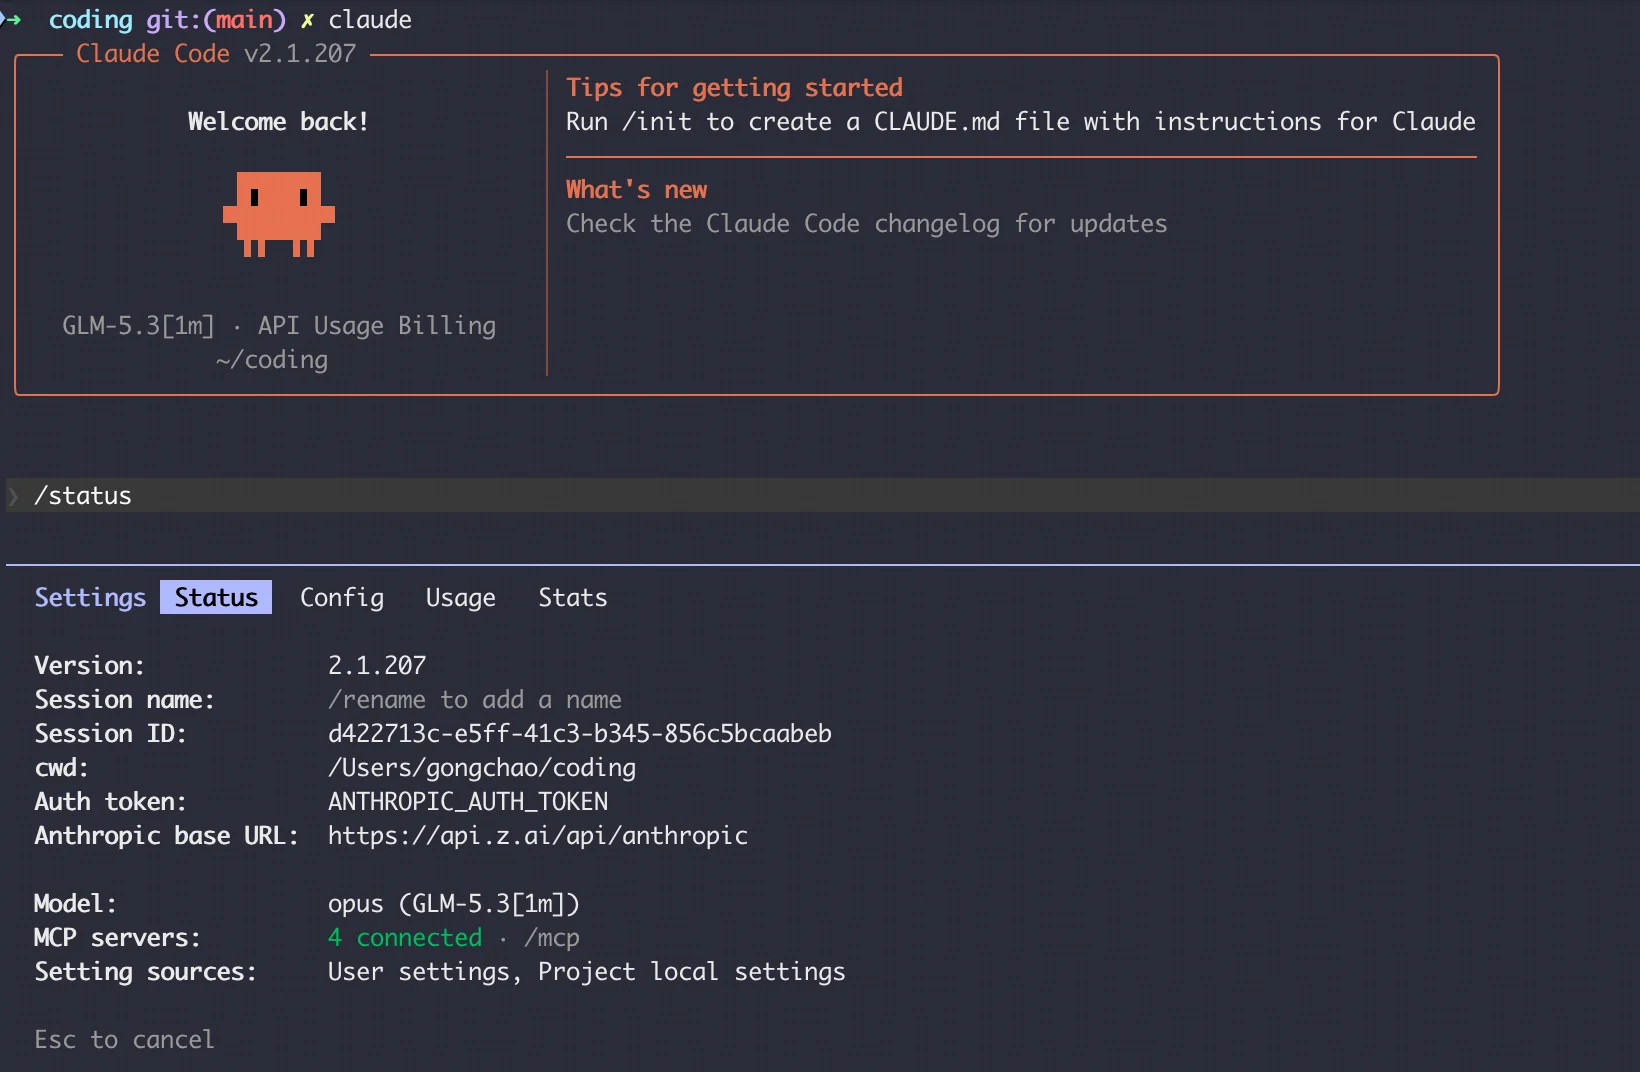
In tutti i casi la chiave è una Z.AI API key. Per Claude Code la configurazione ufficiale imposta queste variabili d'ambiente; il suffisso [1m] è quello che sblocca il contesto da un milione:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "LA_TUA_CHIAVE_ZAI",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000"
  }
}
Cline e gli altri agenti#
In Cline si sceglie il provider "OpenAI Compatible", si inserisce l'endpoint del Coding Plan, il model ID glm-5.3 e una finestra di contesto di 1.000.000, e si toglie la spunta a "Support Images", visto che il modello legge solo testo. Tra gli strumenti supportati la documentazione nomina pure ZCode e OpenCode, oltre ad altri agenti.
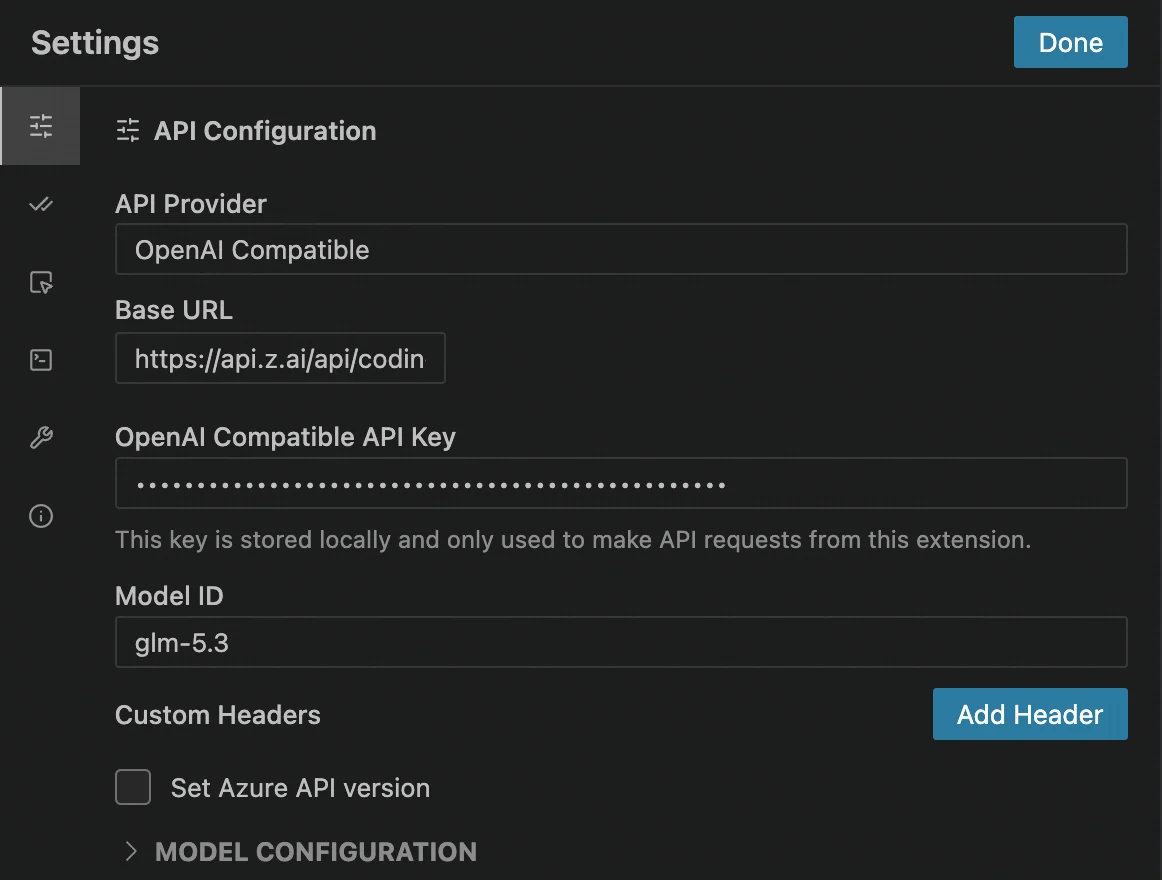
Un dettaglio che conta: non basta che uno strumento accetti un endpoint personalizzato. Il GLM Coding Plan vale solo per gli strumenti supportati ufficialmente, e la quota è una sola, condivisa tra tutti.
Piani, quote e prezzi al lancio#
I piani che includono GLM-5.3 sono tre: Lite, Pro e Max. Sulla pagina ufficiale si legge un prezzo di partenza di 18 $ al mese, ma nel codice pubblico della pagina i prezzi aggiornati di ciascun piano non si leggono in modo verificabile. Per questo non li ricostruisco da screenshot o da siti terzi.
Piano | Crediti ogni 5 ore | Crediti a settimana | Stima di Z.ai (con il 90,9% di cache) |
|---|---|---|---|
Lite | 2.000 | 10.000 | da 43 a 87 milioni di token a settimana |
Pro | 12.000 | 60.000 | da 263 a 526 milioni di token a settimana |
Max | 28.000 | 140.000 | da 613 a 1.226 milioni di token a settimana |
GLM Coding Plan: i crediti per piano
Crediti disponibili ogni 5 ore e ogni settimana
- Ogni 5 ore
- A settimana
Fonte: pagina del GLM Coding Plan di Z.ai, agosto 2026
Il consumo dei crediti dipende dal tipo di token. Per GLM-5.3 i moltiplicatori sono:
6,9 per i token in ingresso;
1,7 per quelli in ingresso già in cache;
24 per quelli in uscita.
Fuori dalle ore di punta i crediti consumati si dimezzano. Z.ai considera ore di punta la fascia 14:00–18:00 del fuso UTC+8, dal lunedì al venerdì: in Italia, con l'ora legale estiva, vuol dire dalle 8 a mezzogiorno. Sera, pomeriggio e fine settimana costano la metà.
Cosa ancora non c'è#
Al momento del lancio mancavano diversi pezzi:
API generale: la scheda del modello la dà come "coming soon", anche se dentro il Coding Plan GLM-5.3 funziona già tramite endpoint dedicati.
Prezzo a consumo: GLM-5.3 non compare ancora nel listino ufficiale per milione di token.
Pesi: promessi due settimane dopo il lancio, dopo le valutazioni di sicurezza e l'irrobustimento.
Model card e licenza: non ancora pubblicate sulla pagina Hugging Face ufficiale.
Modalità senza ragionamento: non prevista.
Immagini in ingresso: la scheda indica solo testo; la visione, nel Coding Plan, arriva da un MCP separato.
Per ora, quindi, chiamarlo "open weights" richiede il futuro: il produttore ha annunciato l'intenzione di rilasciare i pesi; nel giorno del lancio, però, mancano sia un download verificabile sia una licenza da leggere. Se l'interesse è far girare un modello sui propri server, ne parlo nella guida all'AI locale in azienda.
Dove GLM-5.3 può avere senso#
Il suo terreno sono i lavori in cui bisogna leggere repository molto grandi, ricordare lo stato per decine di azioni di fila e produrre modifiche verificate:
migrazioni e refactoring estesi;
debugging che attraversa più servizi;
automazione dei rilasci;
analisi di vulnerabilità in ambienti autorizzati;
attività sull'infrastruttura per il machine learning.
Per compiti brevi o ripetuti in grandi volumi, il livello max può essere sprecato. Conviene confrontare low, high e max su accuratezza, token, tempi e interventi umani.
Sulla sicurezza informatica il perimetro conta ancora di più. Saper trovare e sfruttare vulnerabilità aiuta chi difende e chi segnala in modo responsabile, ma è una capacità a doppio uso. Repository isolati, autorizzazione esplicita, registri di ogni azione, uscita verso internet limitata e controllo umano non sono optional.
Come metterlo alla prova senza farsi ingannare dai benchmark#
Un test utile parte da 20–50 compiti reali e ripetibili presi dal proprio codice: bug con test che falliscono, refactoring, migrazioni, domande che richiedono di capire più servizi insieme, revisioni di sicurezza autorizzate.
Le regole del confronto:
ogni modello riceve la stessa copia del codice, gli stessi strumenti, lo stesso tempo e un limite di output simile;
il risultato non si giudica dal testo finale ma da test automatici, qualità delle modifiche, regressioni, interventi umani e capacità di riprendersi dopo un comando fallito;
per GLM-5.3 servono almeno tre gruppi di prove separati, con
low,highemax.
La misura principale dovrebbe essere il completamento dall'inizio alla fine entro il budget. Poi, in ordine: token totali, tempo reale, costo stimato, quanti passi compie l'agente, quanti errori non rimediabili commette e quante modifiche vengono accettate senza ritocchi. Il confronto con GLM-5.2 è particolarmente istruttivo, perché con la stessa base isola il contributo del post-training. E se l'ambiente di prova riassume il contesto o usa meccanismi di ripiego, va annotato: può spostare il risultato quanto il modello stesso.
Il milione di token merita una prova a parte. Caricare un repository enorme e fare una domanda generica dice poco. Meglio sparpagliare le dipendenze importanti in file lontani tra loro, inserire informazioni in contraddizione, chiedere citazioni precise e controllare se, dopo molte azioni, il modello rispetta ancora i vincoli iniziali. Solo così il numero della scheda tecnica diventa una capacità misurata.
Il mio parere#
Dal punto di vista tecnico GLM-5.3 mi interessa perché fa vedere quanto si possa spostare con il solo post-training e con ambienti di allenamento verificabili, senza toccare il modello di base. Nei dati del produttore il salto su GLM-5.2 è solido. Il confronto con gli altri, invece, è a luci e ombre: sulle prove più difficili i modelli chiusi (GPT-5.6 Sol, Mythos 5 e Fable 5) mantengono un vantaggio, a volte ampio.
Il mio giudizio provvisorio, basato su documentazione e numeri pubblicati e non su una prova pratica, è molto positivo sul piano tecnico ma con riserva. Lo frenano le assenze del lancio: niente pesi, niente model card, niente licenza, niente prezzo dell'API e nessuna replica indipendente dei risultati.
Il lato positivo è che, essendo già disponibile nel Coding Plan, lo si può provare subito con metodo: stessa serie di compiti, tre livelli di ragionamento, budget fisso, e poi completamento, token, tempi, errori e qualità delle modifiche. Se vi serve una mano a impostare un confronto del genere sul vostro codice, possiamo parlarne.
Domande frequenti#
GLM-5.3 è già open source?
No, non nel senso pratico di pesi scaricabili e licenza da leggere. Z.ai ha promesso di pubblicare i pesi due settimane dopo il lancio.
Qual è il nome del modello da usare?
glm-5.3. Nel Coding Plan, con Claude Code, si usa glm-5.3[1m] per attivare il contesto da un milione di token.
Si può spegnere il ragionamento?
No. Si sceglie tra low, high e max, e se non si indica nulla vale max.
Quanto costa l'API?
Al lancio il prezzo a consumo di GLM-5.3 non compare ancora nel listino ufficiale. Il Coding Plan parte da 18 $ al mese.
Può leggere immagini?
Non direttamente: la scheda indica solo testo e la guida di Cline chiede di togliere "Support Images". Nel Coding Plan la visione è offerta da un MCP separato.
Il mio verdetto
Sul piano tecnico il salto rispetto a GLM-5.2 è ampio e mostra quanto si può ottenere lavorando solo sul post-training. Il giudizio però è provvisorio: si basa su documentazione e benchmark del produttore, e al lancio mancano ancora pesi, licenza, prezzo dell'API e repliche indipendenti.
Cosa mi convince
- Fino a un milione di token di contesto
- Risposte lunghe fino a 128K token
- Tre livelli di ragionamento per dosare lo sforzo
- Nei dati del produttore, grande passo avanti su GLM-5.2 nel coding con agenti
- Si usa da subito nel GLM Coding Plan
- Capacità di sicurezza accompagnate da un registro pubblico delle segnalazioni
Cosa non mi convince
- Pesi e licenza non ancora pubblicati
- Nessun prezzo API a consumo al lancio
- I benchmark principali vengono dal produttore
- Il ragionamento non si può spegnere
- Legge solo testo: niente immagini in ingresso
- Capacità offensive che si prestano a un doppio uso
Chiedi all’articolo
Risponde solo con quello che c’è scritto qui.
Risponde un’intelligenza artificiale, solo con il testo di questo articolo, e può sbagliare. Non inserire dati personali.
Fonti
10- 1.
- 2.Z.ai Docs — scheda di GLM-5.3docs.z.ai
- 3.
- 4.Z.ai Docs — come cambiare modello negli agenti di programmazionedocs.z.ai
Claude Code, Codex, Cline, Goose
- 5.Z.ai Docs — prezzidocs.z.ai
- 6.
- 7.
- 8.
- 9.
- 10.
Continua a leggere.
 NewsDisponibile in podcast
Mistral Large 4 a pesi aperti: 1.000 miliardi di parametri, primo nel codice tra gli open
Mistral AI ha pubblicato i pesi di Mistral Large 4: circa 1.000 miliardi di parametri, 52 miliardi attivi, contesto da 1 milione di token. Primo tra i modelli aperti su FrontierCode secondo Mistral, ma con margini piccoli e 8 GPU negli esempi ufficiali.
8 min NewsDisponibile in podcast
Genie 4: il world model di Google DeepMind che crea mondi interattivi con l'audio
Google DeepMind ha presentato Genie 4, un world model che genera ambienti interattivi in tempo reale con audio nativo, fisica più credibile e Gemini a guidare la scena. Oggi è un'anteprima per tester scelti: novità, limiti e accesso.
8 min NewsDisponibile in podcast
Gemini 4 Carbon: il modello più forte di Google, per ora solo ai difensori informatici
Google DeepMind ha presentato Gemini 4 Carbon, il suo modello più forte: primo nell'Intelligence Index v5.0 con 59 punti, allo stato dell'arte in cybersicurezza. Per ora va solo a difensori informatici scelti via Fairwind.
8 min
Raccontami cosa vuoi migliorare.
Una call di 30 minuti per capire il contesto e valutare insieme se e come posso esserti utile. Senza impegno.
Discussione
Hai un’opinione o un’esperienza da aggiungere? Scrivila qui.
Nessun commento, per ora. Il primo può essere il tuo.